
Início rápido
Este guia abrange todos os recursos do Web Scraper:
- Começando — Criar conta e configuração básica
- Como usar a interface de apontar e clicar — Crie scrapers visualmente sem escrever nenhum código
- Como usar a função Extrair Dados — Extrair dados estruturados de qualquer página de um site
- Como usar o Handle JavaScript em sites — Extrair dados de páginas dinâmicas que carregam conteúdo com JS
- Como usar a opção Personalizar dados — Ajuste e limpe as linhas raspadas antes de exportar.
- Como usar os dados de exportação — Salvar resultados como um arquivo CSV, XLSX ou JSON
Tempo necessário: 5 minutos por filme
Neste guia também: Dicas profissionais | Erros comuns | Solução de problemas | Preços | Alternativas
Por que confiar neste guia?
Utilizei o Web Scraper por mais de seis meses e testei todos os recursos deste tutorial. Este artigo é baseado em experiência prática real — não em propaganda enganosa.

O Web Scraper é uma das ferramentas de guia mais fáceis de usar para iniciantes em navegadores. dados extração.
Mas a maioria dos usuários apenas arranha a superfície do que ele pode fazer.
Este guia mostra como usar o web scraper passo a passo.
Cada funcionalidade é abordada com capturas de tela e dicas úteis.
Tutorial de Web Scraping
Este tutorial completo sobre como usar o Web Scraper orienta você passo a passo em cada recurso, desde a configuração inicial até os métodos avançados que o tornarão um usuário experiente.
Extrator de dados da web
Extraia dados de sites diretamente do seu navegador, sem precisar escrever uma única linha de código. O Web Scraper permite extrair dados de qualquer site e exportá-los como CSV, XLSX ou JSON. Comece gratuitamente — sem necessidade de cartão de crédito.
Introdução ao Web Scraper
Antes de usar qualquer recurso, conclua esta configuração única.
Leva cerca de 3 minutos.
Veja primeiro esta breve visão geral:
Agora vamos analisar cada etapa.
Passo 1: Crie sua conta
Acesse o site do Web Scraper em https://webscraper.io/ no seu navegador.
Clique em “Inscrever-se” ou “Iniciar teste gratuito”.
Insira seu e-mail e crie uma senha para configurar sua conta.
✓ Ponto de verificação: Verifique o seu caixa de entrada para um e-mail de confirmação.
Passo 2: Instale a extensão do navegador
Abra a Chrome Web Store e pesquise por "Web Scraper" para encontrar a extensão.
Clique em "Adicionar ao Chrome" e confirme o download.
A extensão também funciona em desktops Windows, macOS e Linux.
Eis como o painel de controle se parece:
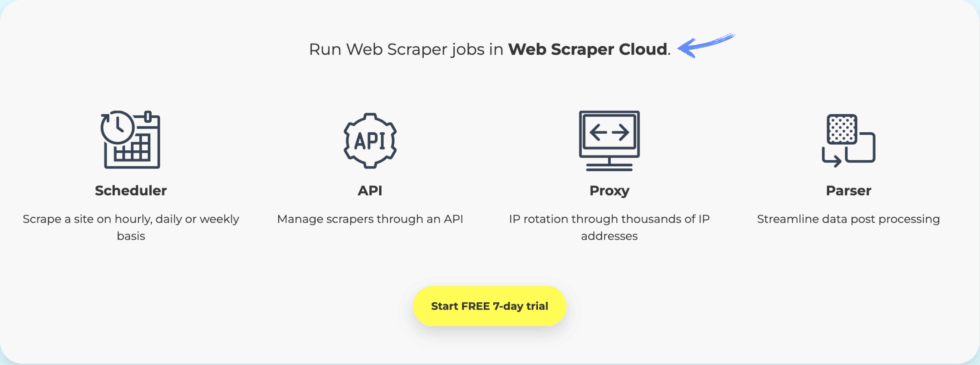
✓ Ponto de verificação: Você deverá ver a aba Web Scraper nas Ferramentas de Desenvolvedor.
Etapa 3: Conclua a configuração inicial
Abra as Ferramentas de Desenvolvedor (F12) e clique na aba Web Scraper para carregar a interface.
Crie seu primeiro sitemap colando a URL do site que você deseja extrair dados.
✅ Concluído: Você está pronto para usar qualquer recurso abaixo.
Como usar a interface de apontar e clicar do Web Scraper
Interface de apontar e clicar Permite criar um extrator visual selecionando os elementos corretos na página.
Veja como usá-lo passo a passo.
Passo 1: Abra o Editor de Sitemap
Acesse o site que deseja extrair dados no seu navegador.
Abra as Ferramentas de Desenvolvedor e clique na aba Web Scraper para começar.
Etapa 2: Selecione os elementos visualmente
Clique em “Adicionar novo seletor” e escolha o tipo de seletor.
Clique diretamente nos elementos da página que você deseja extrair.
O Web Scraper destaca os elementos corretos e sugere seletores CSS para você.
Por exemplo, clicar no título de um produto gera automaticamente o seletor correspondente.
Eis como isso se parece:
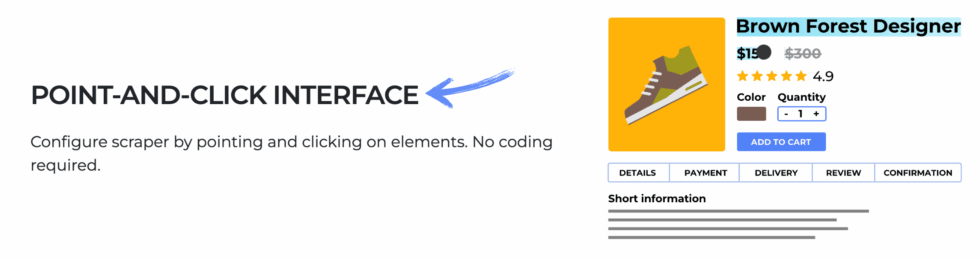
✓ Ponto de verificação: Você deverá ver os elementos selecionados destacados em verde.
Passo 3: Salve seu seletor
Clique em “Seleção concluída” e, em seguida, pressione “Salvar seletor” para confirmar.
O programa de extração de dados armazena o padrão de seletores CSS para encontrar elementos em todas as páginas.
✅ Resultado: Seu extrator visual está pronto para extrair dados sem código.
💡 Dica profissional: Use a "pré-visualização do elemento" para verificar se seus seletores capturam os dados corretos antes de executar a extração completa.
Como usar um web scraper para extrair dados
Extrair dados Permite extrair dados estruturados de qualquer página da web automaticamente.
Veja como usá-lo passo a passo.
Passo 1: Configure seus seletores
Configure os seletores para cada ponto de dados — texto, link, imagem ou cabeçalho HTML.
Utilize a árvore de seletores para navegar entre elementos aninhados na estrutura da página.
Etapa 2: Execute a raspagem
Clique em "Rastrear" e defina o intervalo de requisição e o atraso de carregamento da página.
O programa de extração de dados envia solicitações para cada URL e inicia o processo de extração de dados.
Eis como isso se parece:
✓ Ponto de verificação: Você deverá ver as linhas de dados extraídos aparecerem na pré-visualização.
Etapa 3: Analise seus resultados
Clique em 8220;Navegar” para inspecionar os dados extraídos em uma visualização de tabela.
Verifique se cada coluna corresponde aos dados que você deseja coletar.
✅ Resultado: Você tem dados limpos e estruturados, prontos para exportação.
💡 Dica profissional: Defina um atraso de 2 segundos entre as solicitações para evitar o acionamento dos limites de taxa no site de destino.
Como usar um Web Scraper para lidar com sites JavaScript
Gerenciar sites JavaScript Permite extrair dados de páginas dinâmicas que carregam conteúdo usando JavaScript.
Veja como usá-lo passo a passo.
Etapa 1: Identificar conteúdo dinâmico
Verifique se a página carrega dados após o HTML inicial, observando a árvore de nós.
Pode ser necessário navegar manualmente pelos elementos HTML para confirmar quais deles carregam com atraso.
Se o conteúdo só aparece depois da execução do JavaScript, você precisa dessa funcionalidade.
Passo 2: Habilitar a renderização de JavaScript
No Web Scraper Cloud, selecione "Renderização completa de JavaScript" nas configurações do seu sitemap.
Defina o tempo de espera para o carregamento da página para que todos os elementos sejam totalmente renderizados antes do início da extração de dados.
Eis como isso se parece:
✓ Ponto de verificação: A pré-visualização deve mostrar o conteúdo carregado dinamicamente.
Etapa 3: Teste e execute
Execute um teste de extração de dados em uma única página para confirmar se o script captura todos os elementos.
Após a verificação, execute a extração completa em todas as páginas de destino do site.
✅ Resultado: Agora você pode extrair dados de sites com uso intensivo de JavaScript como um profissional.
💡 Dica profissional: Se um site usa rolagem infinita, adicione um seletor 'Rolar para baixo' para carregar todo o conteúdo antes do início da extração de dados.
Como usar o Web Scraper para personalizar dados
Personalizar dados Permite ajustar, limpar e modificar os dados extraídos antes de salvá-los.
Veja como usá-lo passo a passo.
Passo 1: Abra a Pré-visualização de Dados
Após a conclusão da extração, clique em "Procurar" para visualizar a tabela de dados brutos.
Analise cada coluna e anote as linhas que precisam ser limpas.
Etapa 2: Aplicar Expressões Regulares ou Filtros de Texto
Use a opção "Regex" no seu seletor para analisar e remover texto indesejado.
Trata-se essencialmente de uma correspondência de padrões flexível que limpa os dados no próprio local.
Eis como isso se parece:
✓ Ponto de verificação: Suas colunas de dados agora devem mostrar apenas os valores limpos.
Etapa 3: Renomear e Reordenar as Colunas
Edite os nomes dos seletores para atribuir a cada coluna um rótulo de cabeçalho claro e familiar.
Reordene os seletores no mapa do site para que correspondam à estrutura de saída final.
✅ Resultado: Seus dados estão limpos, etiquetados e prontos para exportação ou análise.
💡 Dica profissional: Use a caixa de seleção "Múltiplos" em um seletor para capturar todos os elementos correspondentes como linhas separadas na saída.
Como usar o Web Scraper para exportar dados
Exportar dados Permite salvar os resultados extraídos como um arquivo CSV, XLSX ou JSON.
Veja como usá-lo passo a passo.
Passo 1: Finalize sua raspagem
Aguarde a conclusão da extração de dados e clique em "Procurar" para visualizar os dados.
Confirme se todas as linhas e colunas contêm os valores esperados.
Etapa 2: Escolha o formato de exportação
Clique no botão de exportação e selecione CSV, XLSX ou JSON na lista de formatos.
Para a maioria dos usuários, o formato CSV é a opção mais flexível e amplamente suportada.
Eis como isso se parece:
✓ Ponto de verificação: Você deverá ver uma mensagem de download no seu navegador.
Passo 3: Salvar o arquivo
Selecione uma pasta no seu computador e salve o arquivo exportado.
Abra o arquivo no Excel, no Google Sheets ou em qualquer ferramenta que leia arquivos CSV para verificar e imprimir os dados.
✅ Resultado: Os dados extraídos são salvos localmente e estão prontos para uso.
💡 Dica profissional: No Web Scraper Cloud, use a API ou o webhook para enviar automaticamente os dados exportados para o Dropbox ou o Google Drive.
Dicas e Atalhos Profissionais para Extração de Dados da Web
Após testar o Web Scraper por mais de seis meses, aqui estão minhas melhores dicas.
O feedback dos usuários em fóruns confirma que esses atalhos são os que mais economizam tempo.
Atalhos de teclado
| Ação | Atalho |
|---|---|
| Abra as Ferramentas de Desenvolvedor | F12 |
| Inspecionar elemento | Ctrl + Shift + C |
| Alternar console | Esc |
| Recarregar página | Ctrl + R |
Características ocultas que a maioria das pessoas não percebe
- Importar/Exportar Sitemap: Copie e cole um sitemap JSON para clonar rapidamente um scraper ou compartilhá-lo com sua equipe como uma publicação na pasta do seu projeto.
- Seletor de paginação: Adicione um seletor de links para botões "Próximo" para navegar automaticamente pelos resultados de pesquisa em várias páginas e extrair dados de todas as páginas.
- Extração agendada: Use o Web Scraper Cloud para executar extrações de dados em uma programação definida e receber dados atualizados diretamente na sua caixa de entrada ou no webhook do serviço.
Erros comuns a evitar ao usar web scraping
Erro nº 1: Extrair dados muito rapidamente sem pausas.
❌ Errado: Executar consultas (scraping) sem atraso, o que aciona bloqueios de IP e respostas de erro do servidor.
✅ Direita: Defina um atraso mínimo de 2000 ms entre as solicitações para simular os padrões de navegação humana.
Erro nº 2: Usar o tipo de seletor errado
❌ Errado: Utilize o seletor 'Texto' quando precisar extrair valores de links href ou URLs de imagens de elementos.
✅ Direita: Associe o tipo de seletor aos seus dados — use “Link” para URLs e “Image” para imagens.
Erro nº 3: Ignorar as regras do robots.txt
❌ Errado: Extrair dados de páginas bloqueadas pelo arquivo robots.txt pode acarretar problemas legais para as empresas.
✅ Direita: Sempre verifique o arquivo robots.txt antes de realizar a coleta de dados para garantir a conformidade e evitar problemas.
Solução de problemas do Web Scraper
Problema: O Scraper retorna dados vazios
Causa: Os seletores CSS estão direcionando elementos que não existem mais na página.
Consertar: Inspecione novamente a página no seu navegador, atualize seus seletores e execute um teste de raspagem.
Problema: Conteúdo JavaScript não está carregando
Causa: A extensão gratuita para navegador não consegue executar JavaScript em páginas que precisam dele.
Consertar: Mude para o Web Scraper Cloud, que oferece suporte à renderização completa de JavaScript para sites dinâmicos.
Problema: o endereço IP é bloqueado durante a coleta de dados.
Causa: O envio de muitas solicitações muito rapidamente aciona a proteção anti-bot do site de destino.
Consertar: Aumente o tempo de atraso para pelo menos 3 segundos e use a rotação de proxy, se disponível.
📌 Observação: Se nenhuma dessas soluções resolver o seu problema, entre em contato com o suporte do Web Scraper para obter uma resposta específica.
O que é um Web Scraper?
Extrator de dados da web é uma web ferramenta de raspagem Isso permite extrair dados de qualquer site usando seu navegador.
Imagine uma ferramenta inteligente de copiar e colar para toda a web, que organiza os dados em linhas e colunas.
Veja esta breve visão geral:
Inclui estas características principais:
- Interface de apontar e clicar: Crie scrapers visualmente sem escrever Python ou qualquer outro código.
- Extrair dados: Extraia automaticamente textos, links e URLs de imagens de qualquer página da web.
- Gerenciar sites JavaScript: Extrair conteúdo dinâmico carregado via JS ou requisições Ajax
- Personalizar dados: Limpe, filtre e modifique os dados coletados antes de salvar.
- Exportar dados: Baixe seus resultados em formato CSV, XLSX ou JSON com um único clique.
Para uma análise completa, consulte nosso artigo. Análise do Web Scraper.
Preços de Web Scraper
Eis o custo do Web Scraper em 2026:
| Plano | Preço | Ideal para |
|---|---|---|
| Livre | Livre | Usuários casuais testando pequenas tarefas de raspagem de dados |
| Projeto | US$ 40/mês | Freelancers executar tarefas regulares de raspagem |
| Profissional | US$ 80/mês | Equipes que precisam de vários scrapers simultâneos |
| Escala | US$ 167/mês | Agências que lidam com extração de dados em grande volume |
| Empresa | Personalizado | Grandes empresas com necessidades de raspagem personalizadas |
Nível gratuito: Sim, a extensão do navegador é totalmente gratuita e sem limite de tempo.
Garantia de reembolso: Contate o suporte em até 14 dias para obter um reembolso dos planos pagos.
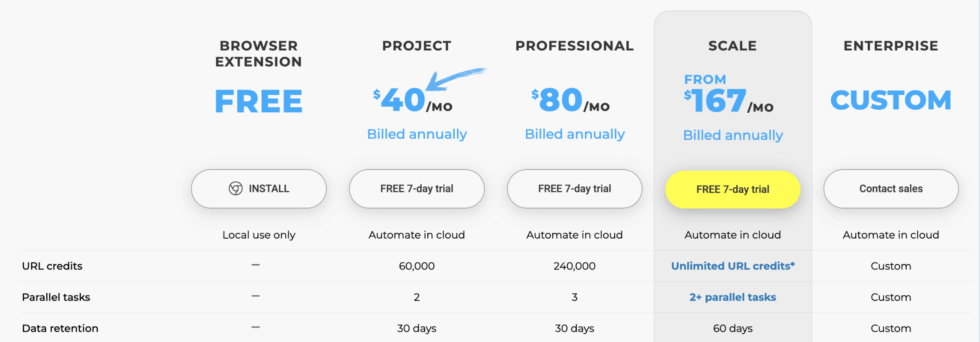
💰 Melhor custo-benefício: Plano de projeto — oferece extração de dados da nuvem e execuções agendadas pelo menor preço.
Web Scraper vs. Alternativas
Como o Web Scraper se compara? Aqui está o panorama competitivo:
| Ferramenta | Ideal para | Preço | Avaliação |
|---|---|---|---|
| Extrator de dados da web | Extração de dados baseada em navegador | Grátis+ | ⭐ 3,5 |
| Octoparse | Extração visual sem código | US$ 89/mês | ⭐ 4,3 |
| ParseHub | raspagens complexas em vários níveis | US$ 189/mês | ⭐ 4,2 |
| Scrapy | Desenvolvedores Python em escala | Livre | ⭐ 4,5 |
| Apify | Extração de dados da nuvem com atores | US$ 49/mês | ⭐ 4,4 |
Escolhas rápidas:
- Melhor no geral: Web Scraper — versão gratuita e extensão de navegador fácil de usar para a maioria dos usuários
- Melhor orçamento: Scrapy — totalmente gratuito e de código aberto para desenvolvedores Python.
- Ideal para iniciantes: Octoparse — interface de arrastar e soltar com modelos integrados
- Melhor para extração de dados da nuvem: Apify — atores poderosos e acesso à API no mundo da extração de dados da web
🎯 Alternativas para Web Scraper
Procurando alternativas ao Web Scraper? Aqui estão as melhores opções:
- 🚀 Octoparse: Um scraper sem código com fluxo de trabalho visual. construtorModelos pré-construídos e serviço em nuvem para empresas de todos os portes.
- 💰 ParseHub: Lida com sites complexos com navegação multinível e carregamento AJAX, ideal para usuários que precisam de extração de dados avançada sem código.
- 🔧 Scrapy: Um framework Python de código aberto criado para desenvolvedores que desejam controle total, integração perfeita com o Soup e extração de dados em larga escala.
- ⚡ Apify: Uma plataforma em nuvem com um mercado de ferramentas de extração de dados prontas para uso e uma API flexível para desenvolvedores e equipes em todo o mundo.
Para ver a lista completa, consulte nosso Alternativas ao Web Scraper guia.
⚔️ Comparação de Web Scrapers
Veja como o Web Scraper se compara a cada concorrente:
- Web Scraper vs Octoparse: O Web Scraper é gratuito e nativo do navegador; o Octoparse oferece mais recursos com seu aplicativo para desktop e ferramentas em nuvem para projetos maiores.
- Web Scraper vs ParseHub: O ParseHub lida com navegação mais complexa no site; o Web Scraper se destaca pelo preço e simplicidade para extrações rápidas de uma única página.
- Web Scraper vs Scrapy: O Scrapy oferece aos desenvolvedores controle total por meio de scripts em Python; o Web Scraper é mais adequado para quem não programa e prefere uma abordagem visual.
- Web Scraper vs Apify: A Apify se destaca em soluções baseadas em nuvem. automação e acesso à API; o Web Scraper é mais simples para usuários que acessam pelo navegador e começam a usar.
Comece a usar o Web Scraper agora mesmo
Você aprendeu a usar todos os principais recursos do Web Scraper:
- ✅ Interface de apontar e clicar
- ✅ Extrair dados
- ✅ Gerenciar sites JavaScript
- ✅ Personalizar dados
- ✅ Exportar dados
Próximo passo: Escolha uma funcionalidade e experimente agora mesmo.
A maioria das pessoas começa com a interface de apontar e clicar.
Leva menos de 5 minutos.
Perguntas frequentes
O Web Scraper é gratuito?
Sim. A extensão Web Scraper para navegador é gratuita. Os planos pagos na nuvem começam em US$ 40/mês para coletas agendadas e acesso à API.
O Web Scraper consegue lidar com páginas renderizadas em JavaScript?
Sim, mas apenas no Web Scraper Cloud. A extensão gratuita para navegador não executa JavaScript. Os planos Cloud oferecem suporte à renderização completa de JS.
Em que formatos o Web Scraper pode exportar dados?
O Web Scraper permite exportar dados em formatos CSV, XLSX ou JSON. Usuários da nuvem também podem acessar os dados via API ou webhook.
Preciso de conhecimentos de programação para usar o Web Scraper?
Não. O Web Scraper usa uma interface de apontar e clicar. Você seleciona os elementos visualmente — sem necessidade de Python, Beautiful Soup ou qualquer outro código.
A extração de dados da web é legal?
Em geral, sim, para dados disponíveis publicamente. Sempre verifique o arquivo robots.txt e os termos de serviço do site. Evite extrair dados pessoais ou privados.













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
