
Inicio rápido
Esta guía cubre todas las funciones de Web Scraper:
- Empezando — Crear cuenta y configuración básica
- Cómo usar la interfaz de apuntar y hacer clic — Crea rastreadores web visualmente sin escribir código.
- Cómo utilizar la función Extraer datos — Extrae datos estructurados de cualquier página de un sitio web.
- Cómo usar y manejar sitios con JavaScript — Extraer contenido de páginas dinámicas que cargan con JavaScript
- Cómo usar la personalización de datos — Ajusta y limpia las filas raspadas antes de exportar.
- Cómo utilizar la exportación de datos — Guarda los resultados como un archivo CSV, XLSX o JSON.
Tiempo necesario: 5 minutos por función
También en esta guía: Consejos profesionales | Errores comunes | Solución de problemas | Precios | Alternativas
¿Por qué confiar en esta guía?
He usado Web Scraper durante más de seis meses y he probado todas las funciones de este tutorial. Este artículo se basa en mi experiencia práctica real, no en publicidad engañosa.

Web Scraper es una de las herramientas de guía más fáciles de usar para principiantes en navegadores web. datos extracción.
Pero la mayoría de los usuarios solo aprovechan una pequeña parte de lo que puede hacer.
Esta guía te muestra cómo usar un programa de extracción de datos web paso a paso.
Cada función se explica con capturas de pantalla y consejos útiles.
Tutorial de extracción de datos web
Este completo tutorial sobre cómo usar Web Scraper te guía paso a paso a través de todas las funciones, desde la configuración inicial hasta los métodos avanzados que te convertirán en un usuario experto.
Raspador web
Extrae datos de sitios web directamente desde tu navegador sin necesidad de programar. Web Scraper te permite extraer datos de cualquier sitio web y exportarlos como CSV, XLSX o JSON. Empieza gratis, sin necesidad de tarjeta de crédito.
Primeros pasos con el raspador web
Antes de utilizar cualquier función, complete esta configuración inicial.
Tarda unos 3 minutos.
Vea primero este breve resumen:
Ahora vamos a repasar cada paso.
Paso 1: Crea tu cuenta
Acceda al sitio web de Web Scraper en https://webscraper.io/ en su navegador.
Haz clic en "Registrarse" o "Comenzar prueba gratuita".
Introduce tu correo electrónico y crea una contraseña para configurar tu cuenta.
✓ Control: Comprueba tu bandeja de entrada para recibir un correo electrónico de confirmación.
Paso 2: Instalar la extensión del navegador
Abre la Chrome Web Store y busca "Web Scraper" para encontrar la extensión.
Haz clic en "Añadir a Chrome" y confirma la descarga.
La extensión también funciona en ordenadores de escritorio Windows, macOS y Linux.
Así es como se ve el panel de control:
✓ Control: Deberías ver la pestaña "Web Scraper" en las herramientas para desarrolladores.
Paso 3: Completar la configuración inicial
Abra las herramientas para desarrolladores (F12) y haga clic en la pestaña Web Scraper para cargar la interfaz.
Crea tu primer mapa del sitio pegando la URL del sitio que deseas extraer.
✅ Hecho: Estás listo para usar cualquiera de las funciones a continuación.
Cómo usar la interfaz de apuntar y hacer clic del raspador web
Interfaz de apuntar y hacer clic Te permite crear un extractor de datos visualmente seleccionando los elementos correctos en la página.
Aquí te mostramos cómo usarlo paso a paso.
Paso 1: Abra el editor de mapas del sitio.
Navega en tu navegador hasta el sitio web que deseas analizar.
Abre las herramientas para desarrolladores y haz clic en la pestaña "Web Scraper" para comenzar.
Paso 2: Seleccionar elementos visualmente
Haz clic en "Agregar nuevo selector" y elige el tipo de selector.
Haz clic directamente en los elementos de la página que deseas extraer.
Web Scraper resalta los elementos correctos y sugiere selectores CSS.
Por ejemplo, al hacer clic en el título de un producto, se genera automáticamente el selector correspondiente.
Así es como se ve:
✓ Control: Deberías ver resaltados verdes en los elementos seleccionados.
Paso 3: Guarda tu selector
Haga clic en "Selección finalizada" y luego presione "Guardar selector" para confirmar.
El programa de extracción de datos almacena el patrón de selectores CSS para encontrar elementos en cada página.
✅ Resultado: Tu herramienta visual de extracción de datos está lista para extraer información sin necesidad de código.
💡 Consejo profesional: Utilice la "Vista previa del elemento" para verificar que sus selectores obtengan los datos correctos antes de ejecutar el web scraping completo.
Cómo usar un raspador web para extraer datos
Extraer datos Te permite extraer automáticamente datos estructurados de cualquier página web.
Aquí te mostramos cómo usarlo paso a paso.
Paso 1: Configure sus selectores
Configurar selectores para cada punto de datos — texto, enlace, imagen o encabezado HTML.
Utilice el árbol de selección para navegar por los elementos anidados en la estructura de la página.
Paso 2: Ejecutar el raspado
Haz clic en "Extraer" y configura el intervalo de solicitud y el retraso de carga de la página.
El programa de extracción de datos envía solicitudes a cada URL e inicia el proceso de extracción de datos.
Así es como se ve:
✓ Control: Deberías ver filas con los datos extraídos en la vista previa.
Paso 3: Revisa tus resultados
Haga clic en “Navegar️ para inspeccionar los datos extraídos en una vista de tabla.
Verifique que cada columna coincida con los datos que desea recopilar.
✅ Resultado: Dispones de datos limpios y estructurados, listos para su exportación.
💡 Consejo profesional: Establezca un retraso de 2 segundos entre las solicitudes para evitar que se activen los límites de velocidad del sitio web de destino.
Cómo usar un programa de extracción de datos web para manejar sitios JavaScript
Gestionar sitios web con JavaScript Te permite extraer información de páginas dinámicas que cargan contenido mediante JavaScript.
Aquí te mostramos cómo usarlo paso a paso.
Paso 1: Identificar el contenido dinámico
Comprueba si la página carga datos después del HTML inicial observando el árbol de nodos.
Es posible que deba navegar manualmente por los elementos HTML para confirmar cuáles se cargan con retraso.
Si el contenido solo aparece después de que se ejecuta JavaScript, necesita esta función.
Paso 2: Habilitar la representación de JavaScript
En Web Scraper Cloud, seleccione "Renderizado completo de JavaScript" en la configuración de su mapa del sitio.
Configura el tiempo de espera de carga de la página para que todos los elementos se rendericen completamente antes de que comience el rastreo web.
Así es como se ve:
✓ Control: La vista previa debería mostrar el contenido cargado dinámicamente.
Paso 3: Probar y ejecutar
Ejecuta una prueba de extracción de datos en una sola página para confirmar que el script captura todos los elementos.
Una vez verificada la información, ejecute el rastreo completo en todas las páginas objetivo del sitio.
✅ Resultado: Ahora puedes extraer datos de sitios con mucho JavaScript como un profesional.
💡 Consejo profesional: Si un sitio utiliza desplazamiento infinito, agregue un selector "Desplazarse hacia abajo" para cargar todo el contenido antes de que comience el rastreo.
Cómo usar un raspador web y personalizar los datos.
Personalizar datos Te permite ajustar, limpiar y modificar los datos extraídos antes de guardarlos.
Aquí te mostramos cómo usarlo paso a paso.
Paso 1: Abra la vista previa de datos.
Una vez finalizado el proceso de extracción de datos, haga clic en "Examinar" para ver la tabla de datos sin procesar.
Revise cada columna y anote las filas que necesiten limpieza.
Paso 2: Aplicar expresiones regulares o filtros de texto.
Utilice la opción "Regex" en su selector para analizar y recortar el texto no deseado.
Se trata esencialmente de una coincidencia de patrones flexible que limpia los datos directamente en el sitio.
Así es como se ve:
✓ Control: Ahora, las columnas de datos deberían mostrar únicamente los valores limpios.
Paso 3: Cambiar el nombre y reordenar las columnas
Edita los nombres de los selectores para asignar a cada columna una etiqueta de encabezado clara y familiar.
Reordena los selectores en el mapa del sitio para que coincidan con la estructura de salida final.
✅ Resultado: Sus datos están limpios, etiquetados y listos para su exportación o análisis.
💡 Consejo profesional: Utilice la casilla de verificación "Múltiple" en un selector para capturar todos los elementos coincidentes como filas separadas en la salida.
Cómo usar el extractor web para exportar datos
Exportar datos Te permite guardar los resultados extraídos como un archivo CSV, XLSX o JSON.
Aquí te mostramos cómo usarlo paso a paso.
Paso 1: Termina tu raspado
Espere a que finalice el proceso de extracción de datos y, a continuación, haga clic en "Examinar" para previsualizar los datos.
Confirme que todas las filas y columnas contengan los valores que espera ver.
Paso 2: Elija su formato de exportación
Haz clic en el botón de exportación y elige CSV, XLSX o JSON de la lista de formatos.
Para la mayoría de los usuarios, el formato CSV es la opción más flexible y con mayor soporte.
Así es como se ve:
✓ Control: Debería aparecer un aviso de descarga en su navegador.
Paso 3: Guardar el archivo
Seleccione una carpeta en su ordenador y guarde el archivo exportado.
Ábrelo en Excel, Google Sheets o cualquier herramienta que lea archivos CSV para verificar e imprimir los datos.
✅ Resultado: Los datos extraídos se guardan localmente y están listos para su uso.
💡 Consejo profesional: En Web Scraper Cloud, utilice la API o el webhook para enviar automáticamente los datos exportados a Dropbox o Google Drive.
Consejos y atajos profesionales para la extracción de datos web
Tras probar Web Scraper durante más de seis meses, aquí están mis mejores consejos.
Los comentarios de los usuarios en los foros confirman que estos atajos son los que más tiempo ahorran.
Atajos de teclado
| Acción | Atajo |
|---|---|
| Herramientas de desarrollo abiertas | F12 |
| Inspeccionar elemento | Ctrl + Shift + C |
| Alternar consola | Esc |
| Recargar página | Ctrl + R |
Características ocultas que la mayoría de la gente pasa por alto
- Importación/Exportación del mapa del sitio: Copia y pega un mapa del sitio JSON para clonar rápidamente un extractor de datos o compártelo con tu equipo como una publicación en la carpeta de tu proyecto.
- Selector de paginación: Agregue un selector de enlaces para los botones "Siguiente" para navegar automáticamente por los resultados de búsqueda de varias páginas y extraer información de cada página.
- Extracción programada de datos: Utilice Web Scraper Cloud para realizar extracciones de datos según un cronograma establecido y recibir datos actualizados en su bandeja de entrada o webhook de servicio.
Errores comunes que debes evitar al usar programas de extracción de datos web
Error n.° 1: Rastrear demasiado rápido sin demoras
❌ Incorrecto: Se realizan rastreos sin demora, lo que provoca bloqueos de IP y respuestas de error por parte del servidor.
✅ Derecha: Establezca un retraso mínimo de 2000 ms entre solicitudes para imitar los patrones de navegación humanos.
Error n.° 2: Usar el tipo de selector incorrecto
❌ Incorrecto: Utilice un selector “Text” cuando necesite extraer valores de enlaces href o URL de imágenes de elementos.
✅ Derecha: Adapta el tipo de selector a tus datos: usa "Link" para las URL y "Image" para las imágenes.
Error n.º 3: Ignorar las reglas de robots.txt
❌ Incorrecto: Extraer información de páginas bloqueadas por robots.txt puede acarrear problemas legales para las empresas.
✅ Derecha: Siempre revise el archivo robots.txt antes de realizar el web scraping para cumplir con las normativas y evitar problemas.
Solución de problemas de extracción de datos web
Problema: El programa de extracción de datos devuelve datos vacíos.
Causa: Los selectores CSS están apuntando a elementos que ya no existen en la página.
Arreglar: Vuelve a inspeccionar la página en tu navegador, actualiza tus selectores y ejecuta una prueba de extracción de datos.
Problema: El contenido de JavaScript no se carga.
Causa: La extensión gratuita para navegadores no puede ejecutar JavaScript en las páginas que lo necesitan.
Arreglar: Cambia a Web Scraper Cloud, que admite la renderización completa de JavaScript para sitios dinámicos.
Problema: La IP se bloquea durante el proceso de extracción de datos.
Causa: El envío de demasiadas solicitudes demasiado rápido activa la protección antibot del sitio de destino.
Arreglar: Aumente la configuración de retardo a al menos 3 segundos y utilice la rotación de proxy si está disponible.
📌 Nota: Si ninguna de estas soluciones resuelve su problema, póngase en contacto con el soporte técnico de Web Scraper para obtener una respuesta a su problema específico.
¿Qué es un raspador web?
Raspador web es una web herramienta de raspado que te permite extraer datos de cualquier sitio web usando tu navegador.
Imagínalo como una herramienta inteligente de copiar y pegar para toda la web que organiza los datos en filas y columnas.
Mira este breve resumen:
Incluye estas características clave:
- Interfaz de apuntar y hacer clic: Crea rastreadores web visualmente sin escribir Python ni ningún otro código.
- Extraer datos: Extrae automáticamente texto, enlaces y URL de imágenes de cualquier página web.
- Gestionar sitios web con JavaScript: Extrae contenido dinámico que se carga mediante solicitudes JS o Ajax.
- Personalizar datos: Limpiar, filtrar y modificar la salida obtenida antes de guardarla.
- Exportar datos: Descarga tus resultados en formato CSV, XLSX o JSON con un solo clic.
Para una revisión completa, consulte nuestra Reseña de Web Scraper.
Precios de los extractores de datos web
Esto es lo que cuesta Web Scraper en 2026:
| Plan | Precio | Mejor para |
|---|---|---|
| Gratis | Gratis | Usuarios ocasionales probando pequeñas tareas de extracción de datos. |
| Proyecto | $40/mes | Trabajadores autónomos ejecutar tareas de raspado regulares |
| Profesional | $80/mes | Equipos que necesitan varios rastreadores simultáneos |
| Escala | $167/mes | Agencias que gestionan la extracción de grandes volúmenes de datos |
| Empresa | Costumbre | Grandes empresas con necesidades de web scraping personalizadas |
Nivel gratuito: Sí, la extensión para el navegador es totalmente gratuita y sin límite de tiempo.
Garantía de devolución de dinero: Para obtener un reembolso por planes de pago, póngase en contacto con el servicio de asistencia en un plazo de 14 días.
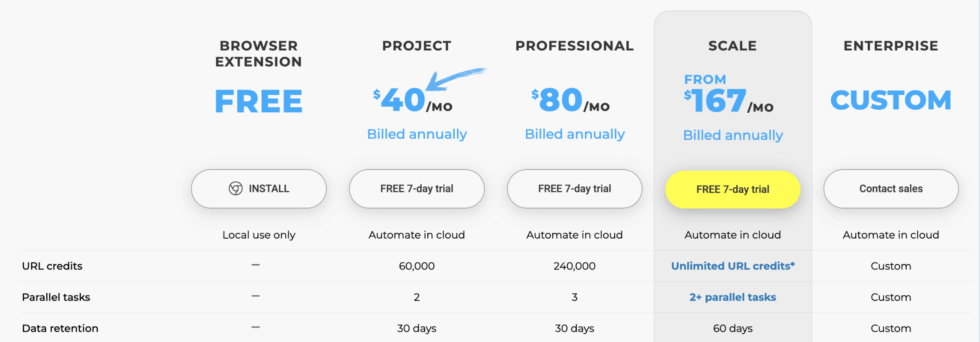
💰 Mejor relación calidad-precio: Plan de proyecto: te ofrece extracción de datos en la nube y ejecuciones programadas al precio más bajo.
Rastreador web vs. alternativas
¿Cómo se compara Web Scraper? Este es el panorama competitivo:
| Herramienta | Mejor para | Precio | Clasificación |
|---|---|---|---|
| Raspador web | Extracción de datos basada en el navegador | Gratis+ | ⭐ 3.5 |
| Octoparse | Extracción visual de datos sin código | $89/mes | ⭐ 4.3 |
| ParseHub | Raspados complejos de varios niveles | $189/mes | ⭐ 4.2 |
| Scrapy | Desarrolladores de Python a gran escala | Gratis | ⭐ 4.5 |
| Apificar | Extracción de datos en la nube con actores | $49/mes | ⭐ 4.4 |
Selecciones rápidas:
- Mejor en general: Web Scraper: versión gratuita y extensión de navegador fácil de usar para la mayoría de los usuarios.
- Mejor presupuesto: Scrapy: completamente gratuito y de código abierto para desarrolladores de Python.
- Ideal para principiantes: Octoparse: interfaz de arrastrar y soltar con plantillas integradas.
- Ideal para el web scraping en la nube: Apify: potentes herramientas y acceso a API en el mundo del web scraping.
🎯 Alternativas a los extractores de datos web
¿Buscas alternativas a los extractores de datos web? Aquí tienes las mejores opciones:
- 🚀 Octoparse: Un programa de extracción de datos sin código con un flujo de trabajo visual. constructorPlantillas prediseñadas y servicio en la nube para empresas de todos los tamaños.
- 💰 ParseHub: Gestiona sitios complejos con navegación multinivel y carga AJAX, ideal para usuarios que necesitan extracción de datos avanzada sin necesidad de código.
- 🔧 Scrapy: Un framework de Python de código abierto diseñado para desarrolladores que desean un control total, una hermosa integración con Soup y extracción de datos a gran escala.
- ⚡ Apify: Una plataforma en la nube con un mercado de herramientas de extracción de datos preconfiguradas y una API flexible para desarrolladores y equipos de todo el mundo.
Para ver la lista completa, consulte nuestra Alternativas a los extractores de datos web guía.
⚔️ Comparativa de raspadores web
Así es como Web Scraper se compara con cada uno de sus competidores:
- Web Scraper vs Octoparse: Web Scraper es gratuito y funciona directamente en el navegador; Octoparse ofrece mayor potencia con su aplicación de escritorio y herramientas en la nube para proyectos de mayor envergadura.
- Web Scraper vs ParseHub: ParseHub gestiona la navegación más profunda del sitio; Web Scraper destaca por su precio y simplicidad para extracciones rápidas de una sola página.
- Web Scraper vs Scrapy: Scrapy ofrece a los desarrolladores un control total mediante un script de Python; Web Scraper es mejor para quienes no son programadores y prefieren un enfoque visual.
- Web Scraper vs Apify: Apify destaca en soluciones basadas en la nube. automatización y acceso a la API; Web Scraper es más sencillo para los usuarios que inician sesión en su navegador y acceden a él.
Empiece a usar Web Scraper ahora
Aprendiste a utilizar todas las funciones principales de Web Scraper:
- ✅ Interfaz de apuntar y hacer clic
- ✅ Extraer datos
- ✅ Gestionar sitios web con JavaScript
- ✅ Personalizar datos
- ✅ Exportar datos
Siguiente paso: Elige una función y pruébala ahora.
La mayoría de la gente empieza con la interfaz de apuntar y hacer clic.
Tarda menos de 5 minutos.
Preguntas frecuentes
¿Es Web Scraper de uso gratuito?
Sí. La extensión de navegador Web Scraper es gratuita. Los planes de pago en la nube comienzan en $40 al mes e incluyen extracciones programadas y acceso a la API.
¿Puede Web Scraper procesar páginas renderizadas con JavaScript?
Sí, pero solo en Web Scraper Cloud. La extensión gratuita para navegador no ejecuta JavaScript. Los planes en la nube admiten la renderización completa de JavaScript.
¿En qué formatos puede exportar datos Web Scraper?
Web Scraper permite exportar datos en formato CSV, XLSX o JSON. Los usuarios de la nube también pueden acceder a los datos mediante API o webhook.
¿Necesito conocimientos de programación para usar Web Scraper?
No. Web Scraper utiliza una interfaz de apuntar y hacer clic. Seleccionas los elementos visualmente; no necesitas Python, Beautiful Soup ni ningún otro código.
¿Es legal el web scraping?
En general, sí, para datos disponibles públicamente. Consulta siempre el archivo robots.txt y los términos de servicio del sitio web. Evita extraer datos personales o privados.













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
