
Démarrage rapide
Ce guide couvre toutes les fonctionnalités de Web Scraper :
- Commencer — Créer un compte et effectuer la configuration de base
- Comment utiliser l'interface pointer-cliquer — Créez des scrapers visuellement, sans écrire une seule ligne de code.
- Comment utiliser l'extraction de données — Extraire des données structurées de n'importe quelle page d'un site
- Comment utiliser Handle JavaScript Sites — Extraire le contenu des pages dynamiques qui se chargent avec JS
- Comment utiliser la personnalisation des données — Ajustez et nettoyez vos lignes extraites avant l'exportation
- Comment utiliser l'exportation de données — Enregistrez les résultats au format CSV, XLSX ou JSON
Temps nécessaire : 5 minutes par fonctionnalité
Vous trouverez également dans ce guide : Conseils de pro | Erreurs courantes | Dépannage | Tarification | Alternatives
Pourquoi faire confiance à ce guide ?
J'utilise Web Scraper depuis plus de six mois et j'ai testé toutes les fonctionnalités présentées dans ce tutoriel. Cet article est basé sur une véritable expérience pratique, et non sur du marketing pur et simple.

Web Scraper est l'un des outils les plus faciles à utiliser pour les débutants souhaitant extraire des données via un navigateur. données extraction.
Mais la plupart des utilisateurs n'exploitent qu'une infime partie de ses possibilités.
Ce guide vous montre comment utiliser un outil d'extraction de données web étape par étape.
Chaque fonctionnalité est présentée avec des captures d'écran et des conseils utiles.
Tutoriel sur l'extraction de données Web
Ce tutoriel complet sur l'utilisation de Web Scraper vous guide pas à pas à travers chaque fonctionnalité, de la configuration initiale aux méthodes avancées qui feront de vous un utilisateur expert.
Extracteur de données Web
Récupérez des données directement depuis votre navigateur, sans écrire une seule ligne de code. Web Scraper vous permet d'extraire des données de n'importe quel site web et de les exporter aux formats CSV, XLSX ou JSON. Essayez gratuitement, sans carte bancaire.
Premiers pas avec un outil d'extraction de données Web
Avant d'utiliser toute fonctionnalité, veuillez effectuer cette configuration unique.
Cela prend environ 3 minutes.
Regardez d'abord ce bref aperçu :
Passons maintenant en revue chaque étape.
Étape 1 : Créez votre compte
Rendez-vous sur le site Web Scraper à l'adresse https://webscraper.io/ dans votre navigateur.
Cliquez sur « S’inscrire » ou « Démarrer l’essai gratuit ».
Saisissez votre adresse e-mail et créez un mot de passe pour configurer votre compte.
✓ Point de contrôle: Vérifiez votre boîte de réception pour recevoir un courriel de confirmation.
Étape 2 : Installez l’extension de navigateur
Ouvrez le Chrome Web Store et recherchez « Web Scraper » pour trouver l’extension.
Cliquez sur « Ajouter à Chrome » et confirmez le téléchargement.
L'extension fonctionne également sur les ordinateurs de bureau Windows, macOS et Linux.
Voici à quoi ressemble le tableau de bord :
✓ Point de contrôle: Vous devriez voir l'onglet Web Scraper dans les outils de développement.
Étape 3 : Terminer la configuration initiale
Ouvrez DevTools (F12) et cliquez sur l'onglet Web Scraper pour charger l'interface.
Créez votre premier sitemap en collant l'URL du site que vous souhaitez analyser.
✅ Terminé : Vous êtes prêt à utiliser n'importe quelle fonctionnalité ci-dessous.
Comment utiliser l'interface pointer-cliquer du Web Scraper
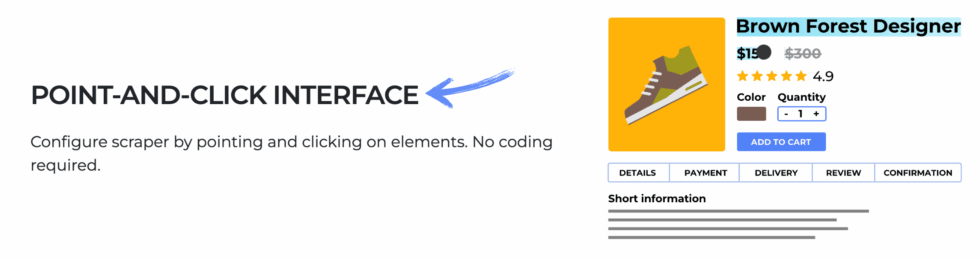
Interface pointer-cliquer permet de créer visuellement un scraper en sélectionnant les éléments appropriés sur la page.
Voici comment l'utiliser étape par étape.
Étape 1 : Ouvrir l’éditeur de plan de site
Accédez au site dont vous souhaitez extraire les données dans votre navigateur.
Ouvrez les outils de développement et cliquez sur l'onglet Web Scraper pour commencer.
Étape 2 : Sélectionner les éléments visuellement
Cliquez sur « Ajouter un nouveau sélecteur » et choisissez votre type de sélecteur.
Cliquez directement sur les éléments de la page que vous souhaitez extraire.
Web Scraper met en évidence les éléments pertinents et vous suggère les sélecteurs CSS.
Par exemple, cliquer sur le titre d'un produit génère automatiquement le sélecteur correspondant.
Voici à quoi cela ressemble :
✓ Point de contrôle: Vous devriez voir des surlignages verts sur les éléments sélectionnés.
Étape 3 : Enregistrez votre sélecteur
Cliquez sur « Terminé la sélection » puis appuyez sur « Enregistrer la sélection » pour confirmer.
Le scraper stocke le modèle de sélecteurs CSS permettant de trouver les éléments sur chaque page.
✅ Résultat : Votre outil d'extraction visuelle est prêt à extraire des données sans code.
💡 Conseil de pro : Utilisez l'« aperçu de l'élément » pour vérifier que vos sélecteurs récupèrent les données correctes avant d'exécuter la récupération complète.
Comment utiliser un outil d'extraction de données Web ?
Extraire les données permet d'extraire automatiquement des données structurées de n'importe quelle page Web.
Voici comment l'utiliser étape par étape.
Étape 1 : Configurez vos sélecteurs
Configurez des sélecteurs pour chaque point de données — texte, lien, image ou en-tête HTML.
Utilisez l'arborescence de sélection pour naviguer dans les éléments imbriqués de la structure de la page.
Étape 2 : Exécuter le scraping
Cliquez sur « Scrape » et définissez votre intervalle de requêtes et votre délai de chargement de page.
Le programme d'extraction envoie des requêtes à chaque URL et lance le processus d'extraction de données.
Voici à quoi cela ressemble :
✓ Point de contrôle: Vous devriez voir apparaître des lignes de données extraites dans l'aperçu.
Étape 3 : Examinez vos résultats
Cliquez “Parcourir” pour examiner les données extraites dans une vue de tableau.
Vérifiez que chaque colonne correspond aux données que vous souhaitez collecter.
✅ Résultat : Vous disposez de données propres et structurées, prêtes à être exportées.
💡 Conseil de pro : Définissez un délai de 2 secondes entre les requêtes afin d'éviter de déclencher les limites de débit sur le site web cible.
Comment utiliser un outil d'extraction de données Web pour gérer les sites JavaScript
Gérer les sites JavaScript permet d'extraire des données de pages dynamiques qui chargent du contenu à l'aide de JavaScript.
Voici comment l'utiliser étape par étape.
Étape 1 : Identifier le contenu dynamique
Vérifiez si la page charge des données après le code HTML initial en observant l'arborescence des nœuds.
Il vous faudra peut-être parcourir manuellement les éléments HTML pour confirmer lesquels se chargent en retard.
Si le contenu n'apparaît qu'après l'exécution de JavaScript, cette fonctionnalité est nécessaire.
Étape 2 : Activer le rendu JavaScript
Dans Web Scraper Cloud, sélectionnez « Rendu JavaScript complet » dans les paramètres de votre sitemap.
Configurez le délai de chargement de la page afin que tous les éléments soient entièrement affichés avant le début de l'extraction.
Voici à quoi cela ressemble :
✓ Point de contrôle: L'aperçu doit afficher le contenu chargé dynamiquement.
Étape 3 : Tester et exécuter
Effectuez un test de récupération sur une seule page pour confirmer que le script capture bien tous les éléments.
Une fois la vérification effectuée, exécutez la procédure d'extraction complète sur toutes les pages cibles du site.
✅ Résultat : Vous pouvez désormais extraire des données de sites utilisant beaucoup de JavaScript comme un pro.
💡 Conseil de pro : Si un site utilise le défilement infini, ajoutez un sélecteur “Défilement vers le bas” pour charger tout le contenu avant que le scraping ne commence.
Comment utiliser un outil d'extraction de données Web : personnaliser les données
Personnaliser les données vous permet d'ajuster, de nettoyer et de modifier vos données extraites avant de les enregistrer.
Voici comment l'utiliser étape par étape.
Étape 1 : Ouvrir l’aperçu des données
Une fois votre extraction terminée, cliquez sur « Parcourir » pour afficher le tableau de données brutes.
Examinez chaque colonne et notez les lignes qui nécessitent un nettoyage.
Étape 2 : Appliquer des filtres Regex ou de texte
Utilisez l'option “Regex” dans votre sélecteur pour analyser et supprimer le texte indésirable.
Il s'agit essentiellement d'une correspondance de modèles flexible qui nettoie les données sur place.
Voici à quoi cela ressemble :
✓ Point de contrôle: Vos colonnes de données ne devraient plus afficher que les valeurs corrigées.
Étape 3 : Renommer et réorganiser les colonnes
Modifiez les noms des sélecteurs pour donner à chaque colonne une étiquette d'en-tête claire et familière.
Réorganisez les sélecteurs dans le plan du site pour qu'ils correspondent à la structure de sortie finale.
✅ Résultat : Vos données sont propres, étiquetées et prêtes à être exportées ou analysées.
💡 Conseil de pro : Utilisez la case à cocher « Multiple » sur un sélecteur pour capturer tous les éléments correspondants sous forme de lignes distinctes dans la sortie.
Comment utiliser l'exportation de données Web Scraper
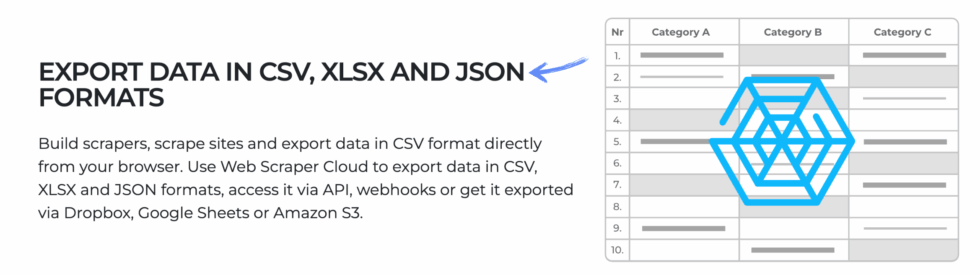
Données d'exportation vous permet d'enregistrer vos résultats extraits sous forme de fichier csv, XLSX ou JSON.
Voici comment l'utiliser étape par étape.
Étape 1 : Terminez votre grattage
Attendez que l'extraction soit terminée, puis cliquez sur « Parcourir » pour prévisualiser les données.
Vérifiez que toutes les lignes et colonnes contiennent les valeurs attendues.
Étape 2 : Choisissez votre format d’exportation
Cliquez sur le bouton Exporter et choisissez CSV, XLSX ou JSON dans la liste des formats.
Pour la plupart des utilisateurs, le format CSV est l'option la plus flexible et la plus largement prise en charge.
Voici à quoi cela ressemble :
✓ Point de contrôle: Vous devriez voir une invite de téléchargement dans votre navigateur.
Étape 3 : Enregistrer le fichier
Choisissez un dossier sur votre ordinateur et enregistrez-y le fichier exporté.
Ouvrez-le dans Excel, Google Sheets ou tout autre outil capable de lire les fichiers CSV pour vérifier et imprimer les données.
✅ Résultat : Vos données collectées sont enregistrées localement et prêtes à être utilisées.
💡 Conseil de pro : Sur Web Scraper Cloud, utilisez l'API ou le webhook pour envoyer automatiquement les données exportées vers Dropbox ou Google Drive.
Astuces et raccourcis pour les pros du web scraping
Après avoir testé Web Scraper pendant plus de six mois, voici mes meilleurs conseils.
Les retours des utilisateurs sur les forums confirment que ces raccourcis permettent de gagner un temps précieux.
Raccourcis clavier
| Action | Raccourci |
|---|---|
| Ouvrir les outils de développement | F12 |
| Inspecter l'élément | Ctrl + Maj + C |
| Basculer la console | Échap |
| Recharger la page | Ctrl + R |
Fonctionnalités cachées que la plupart des gens ignorent
- Importation/Exportation du plan du site : Copiez et collez un sitemap JSON pour cloner rapidement un scraper ou le partager avec votre équipe sous forme de publication dans le dossier de votre projet.
- Sélecteur de pagination : Ajoutez un sélecteur de lien pour les boutons « Suivant » afin de naviguer automatiquement à travers les résultats de recherche multipages et d'extraire les données de chaque page.
- Extraction de données programmée : Utilisez Web Scraper Cloud pour exécuter des extractions de données selon un calendrier défini et recevoir des données actualisées directement dans votre boîte de réception ou via un webhook de service.
Erreurs courantes à éviter lors de l'extraction de données Web
Erreur n° 1 : Gratter trop vite sans s'arrêter
❌ Faux : L'exécution de requêtes de récupération de données sans délai déclenche des blocages d'adresses IP et des réponses d'erreur du serveur.
✅ À droite : Définissez un délai minimum de 2000 ms entre les requêtes afin d'imiter les habitudes de navigation humaine.
Erreur n° 2 : Utilisation du mauvais type de sélecteur
❌ Faux : Utilisez un sélecteur “Text” lorsque vous devez extraire les valeurs des liens href ou les URL des images à partir d'éléments.
✅ À droite : Faites correspondre le type de sélecteur à vos données — utilisez “Link” pour les URL et “Image” pour les images.
Erreur n° 3 : Ignorer les règles du fichier robots.txt
❌ Faux : Le scraping de pages bloquées par le fichier robots.txt peut entraîner des problèmes juridiques pour les entreprises.
✅ À droite : Vérifiez toujours le fichier robots.txt avant de procéder au scraping afin de rester conforme à la réglementation et d'éviter les problèmes.
Dépannage des outils d'extraction de données Web
Problème : Le scraper renvoie des données vides
Cause: Les sélecteurs CSS ciblent des éléments qui n'existent plus sur la page.
Réparer: Réexaminez la page dans votre navigateur, mettez à jour vos sélecteurs et effectuez un test de récupération de données.
Problème : le contenu JavaScript ne se charge pas.
Cause: L'extension gratuite pour navigateur ne peut pas exécuter JavaScript sur les pages qui en ont besoin.
Réparer: Passez à Web Scraper Cloud, qui prend en charge le rendu JavaScript complet pour les sites dynamiques.
Problème : L'adresse IP est bloquée en cours de récupération de données.
Cause: L'envoi d'un trop grand nombre de requêtes trop rapidement déclenche la protection anti-bot du site cible.
Réparer: Augmentez votre délai à au moins 3 secondes et utilisez la rotation des proxys si disponible.
📌 Note: Si aucune de ces solutions ne résout votre problème, contactez le support de Web Scraper pour obtenir une réponse à votre problème spécifique.
Qu'est-ce qu'un outil d'extraction de données Web ?
Extracteur de données Web est un site web outil de grattage qui vous permet d'extraire des données de n'importe quel site web à l'aide de votre navigateur.
Imaginez un outil de copier-coller intelligent pour l'ensemble du web, qui organise les données en lignes et en colonnes.
Regardez ce bref aperçu :
Il comprend les fonctionnalités clés suivantes :
- Interface pointer-cliquer : Créez des scrapers visuellement, sans écrire de code Python ni aucun autre code.
- Extraire les données : Extraire automatiquement le texte, les liens et les URL des images de n'importe quelle page Web
- Gérer les sites JavaScript : Extraire le contenu dynamique chargé via des requêtes JS ou Ajax
- Personnaliser les données : Nettoyer, filtrer et modifier les données extraites avant de les enregistrer
- Exporter les données : Téléchargez vos résultats au format CSV, XLSX ou JSON en un seul clic
Pour une analyse complète, consultez notre Avis sur Web Scraper.
Tarification des outils d'extraction de données Web
Voici le prix de Web Scraper en 2026 :
| Plan | Prix | Idéal pour |
|---|---|---|
| Gratuit | Gratuit | Des utilisateurs occasionnels testent de petites tâches de scraping. |
| Projet | 40 $/mois | travailleurs indépendants exécution de tâches de scraping régulières |
| Professionnel | 80 $/mois | Équipes ayant besoin de plusieurs scrapers simultanés |
| Échelle | 167 $/mois | Agences chargées de l'extraction de données à grande échelle |
| Entreprise | Coutume | Grandes entreprises ayant des besoins de grattage personnalisés |
Niveau gratuit : Oui, l'extension pour navigateur est entièrement gratuite et sans limite de temps.
Garantie de remboursement : Contactez le service client dans les 14 jours pour obtenir un remboursement sur les abonnements payants.
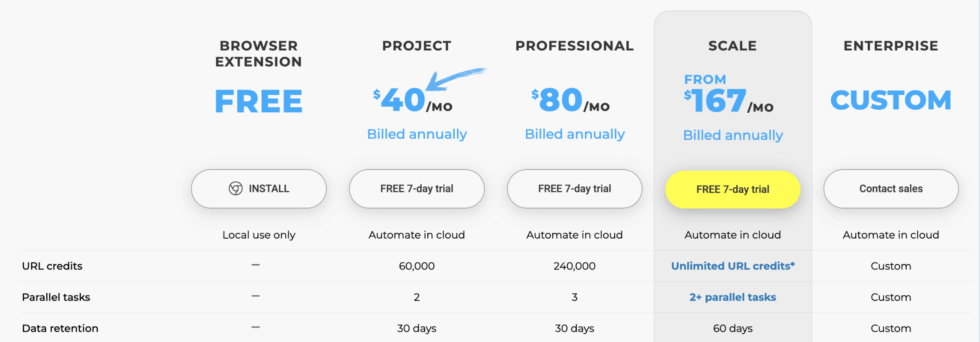
💰 Meilleur rapport qualité-prix : Plan de projet — vous offre le web scraping dans le cloud et des exécutions planifiées au prix le plus bas.
Web Scraper vs Alternatives
Comment Web Scraper se compare-t-il aux autres ? Voici un aperçu du paysage concurrentiel :
| Outil | Idéal pour | Prix | Notation |
|---|---|---|---|
| Extracteur de données Web | Extraction de données via navigateur | Gratuit+ | ⭐ 3,5 |
| Octoparse | Extraction visuelle sans code | 89 $/mois | ⭐ 4,3 |
| ParseHub | Extraction de données complexes à plusieurs niveaux | 189 $/mois | ⭐ 4.2 |
| Scrapy | Développeurs Python à grande échelle | Gratuit | ⭐ 4,5 |
| Apify | Extraction de données du cloud avec des acteurs | 49 $/mois | ⭐ 4,4 |
Sélection rapide :
- Meilleur résultat global : Web Scraper — extension de navigateur gratuite et facile à utiliser pour la plupart des utilisateurs
- Meilleur budget : Scrapy — entièrement gratuit et open source pour les développeurs Python
- Idéal pour les débutants : Octoparse — interface glisser-déposer avec modèles intégrés
- Idéal pour le web scraping : Apify — des acteurs puissants et un accès API dans le monde du web scraping
🎯 Alternatives aux outils d'extraction de données Web
Vous cherchez des alternatives à Web Scraper ? Voici les meilleures options :
- 🚀 Octoparse : Un scraper sans code avec un flux de travail visuel constructeur, des modèles préconfigurés et un service cloud pour les entreprises de toutes tailles.
- 💰 ParseHub : Gère les sites complexes avec navigation multiniveaux et chargement AJAX, idéal pour les utilisateurs ayant besoin d'une extraction de données avancée sans coder.
- 🔧 Scrapy : Un framework Python open-source conçu pour les développeurs qui souhaitent un contrôle total, une intégration simplifiée et un scraping à grande échelle.
- ⚡ Apify : Une plateforme cloud dotée d'une place de marché de scrapers prêts à l'emploi et d'une API flexible pour les développeurs et les équipes du monde entier.
Pour la liste complète, consultez notre Alternatives aux outils d'extraction de données Web guide.
⚔️ Comparaison des outils d'extraction de données Web
Voici comment Web Scraper se compare à chacun de ses concurrents :
- Comparaison entre Web Scraper et Octoparse : Web Scraper est gratuit et fonctionne nativement dans les navigateurs ; Octoparse offre plus de puissance grâce à son application de bureau et ses outils cloud pour les projets de plus grande envergure.
- Web Scraper vs ParseHub : ParseHub gère la navigation plus approfondie du site ; Web Scraper l'emporte sur le prix et la simplicité pour les extractions rapides de données d'une seule page.
- Web Scraper vs Scrapy : Scrapy offre aux développeurs un contrôle total via un script Python ; Web Scraper est mieux adapté aux non-programmeurs qui préfèrent une approche visuelle.
- Web Scraper vs Apify : Apify excelle dans le domaine du cloud. automation et l'accès API ; Web Scraper est plus simple pour les utilisateurs qui se connectent à leur navigateur et c'est parti.
Commencez à utiliser Web Scraper dès maintenant
Vous avez appris à utiliser toutes les principales fonctionnalités d'un outil d'extraction de données Web :
- ✅ Interface pointer-cliquer
- ✅ Extraire les données
- ✅ Gérer les sites JavaScript
- ✅ Personnaliser les données
- ✅ Exporter les données
Étape suivante : Choisissez une fonctionnalité et essayez-la dès maintenant.
La plupart des gens commencent par une interface pointer-cliquer.
Cela prend moins de 5 minutes.
Foire aux questions
L'utilisation de Web Scraper est-elle gratuite ?
Oui. L'extension de navigateur Web Scraper est gratuite. Les abonnements cloud payants commencent à 40 $/mois pour les extractions de données programmées et l'accès à l'API.
Un outil d'extraction de données Web peut-il traiter les pages rendues en JavaScript ?
Oui, mais uniquement sur Web Scraper Cloud. L'extension gratuite pour navigateur n'exécute pas de JavaScript. Les abonnements Cloud prennent en charge le rendu JavaScript complet.
Dans quels formats Web Scraper peut-il exporter les données ?
Web Scraper vous permet d'exporter des données aux formats CSV, XLSX ou JSON. Les utilisateurs du cloud peuvent également accéder aux données via une API ou un webhook.
Ai-je besoin de compétences en programmation pour utiliser un outil d'extraction de données Web ?
Non. Web Scraper utilise une interface pointer-cliquer. Vous sélectionnez les éléments visuellement ; aucun code Python, Beautiful Soup ou autre n’est nécessaire.
Le web scraping est-il légal ?
En règle générale, oui, pour les données publiques. Consultez toujours le fichier robots.txt et les conditions d'utilisation du site. Évitez de collecter des données personnelles ou privées.













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
