
Snelstart
Deze handleiding behandelt alle functies van Web Scraper:
- Aan de slag — Account aanmaken en basisinstellingen
- Hoe gebruik je een point-and-click-interface? — Bouw webscrapers visueel, zonder code te schrijven
- Hoe gebruik je Extract Data? — Gestructureerde gegevens ophalen van elke pagina op een website
- Hoe JavaScript-sites te beheren — Schraap dynamische pagina's die content laden met JavaScript.
- Hoe u aangepaste gegevens kunt gebruiken — Pas de verzamelde rijen aan en maak ze schoon voordat u ze exporteert.
- Hoe exportgegevens te gebruiken — Sla de resultaten op als een CSV-, XLSX- of JSON-bestand.
Benodigde tijd: 5 minuten per film
Ook in deze handleiding: Professionele tips | Veelgemaakte fouten | Probleemoplossing | Prijzen | Alternatieven
Waarom zou je deze gids vertrouwen?
Ik gebruik Web Scraper al meer dan zes maanden en heb elke functie in deze handleiding getest. Dit artikel is gebaseerd op echte praktijkervaring – geen marketingpraatjes.

Web Scraper is een van de meest gebruiksvriendelijke handleidingen voor beginners voor browsergebaseerde webscrapers. gegevens extractie.
Maar de meeste gebruikers benutten slechts een fractie van de mogelijkheden.
Deze handleiding laat je stap voor stap zien hoe je een webscraper gebruikt.
Elke functie wordt toegelicht met schermafbeeldingen en handige tips.
Handleiding voor webscrapers
Deze complete handleiding voor het gebruik van Web Scraper leidt je stap voor stap door alle functies, van de eerste installatie tot geavanceerde methoden waarmee je een gevorderde gebruiker wordt.
Webscraper
Schraap rechtstreeks vanuit je browser gegevens van websites, zonder te programmeren. Met Web Scraper kun je data van elke website extraheren en exporteren als CSV, XLSX of JSON. Begin gratis – geen creditcard nodig.
Aan de slag met webscraper
Voordat u een functie kunt gebruiken, moet u deze eenmalige installatie voltooien.
Het duurt ongeveer 3 minuten.
Bekijk eerst dit korte overzicht:
Laten we nu elke stap eens doornemen.
Stap 1: Maak uw account aan
Ga in uw browser naar de website van Web Scraper op https://webscraper.io/.
Klik op 'Aanmelden' of 'Start gratis proefperiode'.
Voer je e-mailadres in en maak een wachtwoord aan om je account in te stellen.
✓ Controlepunt: Controleer uw inbox voor een bevestigingsmail.
Stap 2: Installeer de browserextensie
Open de Chrome Web Store en zoek naar 'Web Scraper' om de extensie te vinden.
Klik op 'Toevoegen aan Chrome' en bevestig de download.
De extensie werkt ook op Windows-, macOS- en Linux-desktops.
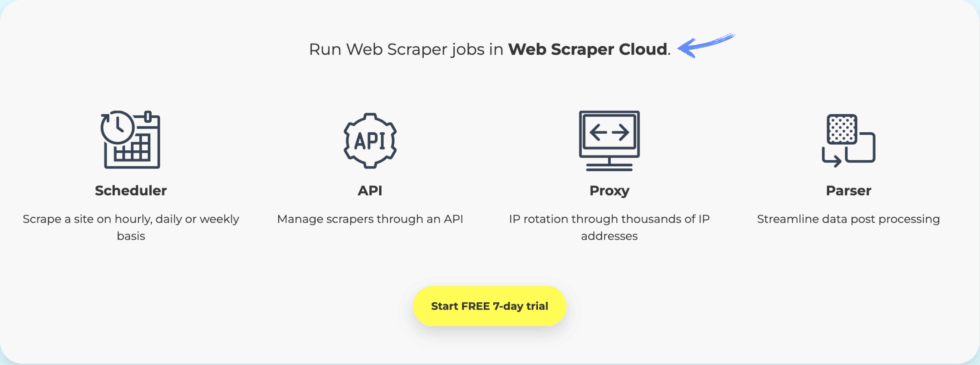
Zo ziet het dashboard eruit:
✓ Controlepunt: Je zou het tabblad Web Scraper in de ontwikkelaarstools moeten zien.
Stap 3: Voltooi de eerste installatie
Open de ontwikkelaarstools (F12) en klik op het tabblad Web Scraper om de interface te laden.
Maak je eerste sitemap door de URL van de website die je wilt scrapen te plakken.
✅ Klaar: Je bent klaar om een van de onderstaande functies te gebruiken.
Hoe gebruik je de point-and-click-interface van een webscraper?
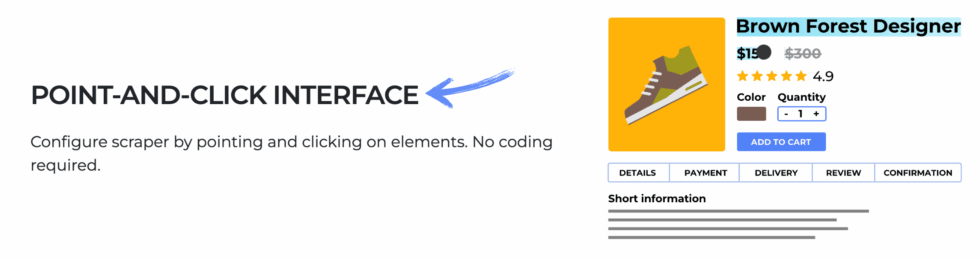
Point-and-click interface Hiermee kun je visueel een scraper maken door de juiste elementen op de pagina te selecteren.
Hieronder leggen we stap voor stap uit hoe je het gebruikt.
Stap 1: Open de sitemap-editor
Navigeer in je browser naar de website waarvan je de gegevens wilt scrapen.
Open DevTools en klik op het tabblad Web Scraper om te beginnen.
Stap 2: Elementen visueel selecteren
Klik op 'Nieuwe selector toevoegen' en kies het gewenste selectortype.
Klik direct op de pagina-elementen die u wilt scrapen.
Web Scraper markeert de juiste elementen en stelt CSS-selectors voor.
Als je bijvoorbeeld op een producttitel klikt, wordt automatisch de bijbehorende selector gegenereerd.
Zo ziet het eruit:
✓ Controlepunt: Je zou groene markeringen moeten zien bij de elementen die je hebt geselecteerd.
Stap 3: Sla je selectie op
Klik op 'Selectie voltooid' en druk vervolgens op 'Selectie opslaan' om te bevestigen.
De scraper slaat het CSS-selectorpatroon op waarmee elementen op elke pagina kunnen worden gevonden.
✅ Resultaat: Uw visuele scraper is klaar om gegevens te extraheren zonder code.
💡 Pro-tip: Gebruik de 'Elementpreview' om te controleren of uw selectors de juiste gegevens ophalen voordat u de volledige scraping uitvoert.
Hoe gebruik je een webscraper om gegevens te extraheren?
Gegevens extraheren Hiermee kunt u automatisch gestructureerde gegevens van elke webpagina ophalen.
Hieronder leggen we stap voor stap uit hoe je het gebruikt.
Stap 1: Configureer uw selectors
Stel selectoren in voor elk datapunt — tekst, link, afbeelding of HTML-header.
Gebruik de selectorstructuur om door geneste elementen in de paginastructuur te navigeren.
Stap 2: Voer de scrape uit.
Klik op 'Scrape' en stel uw aanvraaginterval en laadvertraging van de pagina in.
De scraper verstuurt verzoeken naar elke URL en start het data-extractieproces.
Zo ziet het eruit:
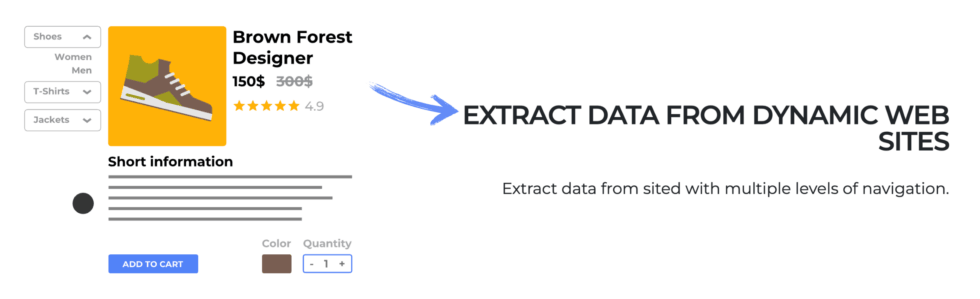
✓ Controlepunt: In de preview zou u rijen met geëxtraheerde gegevens moeten zien verschijnen.
Stap 3: Bekijk je resultaten
Klikken →Bladeren→ om de geëxtraheerde gegevens in een tabelweergave te bekijken.
Controleer of elke kolom overeenkomt met de gegevens die u wilt verzamelen.
✅ Resultaat: Je hebt schone, gestructureerde gegevens die klaar zijn voor export.
💡 Pro-tip: Stel een vertraging van 2 seconden in tussen verzoeken om te voorkomen dat de snelheidslimieten van de doelwebsite worden overschreden.
Hoe gebruik je een webscraper om JavaScript-sites te verwerken?
Beheer JavaScript-sites Hiermee kun je dynamische pagina's scrapen die content laden met behulp van JavaScript.
Hieronder leggen we stap voor stap uit hoe je het gebruikt.
Stap 1: Dynamische inhoud identificeren
Controleer of de pagina gegevens laadt na de initiële HTML door de knooppuntstructuur te bekijken.
Mogelijk moet u handmatig door de HTML-elementen navigeren om te controleren welke elementen traag laden.
Als de inhoud pas verschijnt nadat JavaScript is uitgevoerd, hebt u deze functie nodig.
Stap 2: JavaScript-rendering inschakelen
In Web Scraper Cloud selecteert u 'Volledige JavaScript-weergave' in uw sitemapinstellingen.
Stel de wachttijd voor het laden van de pagina zo in dat alle elementen volledig zijn weergegeven voordat het scrapen begint.
Zo ziet het eruit:
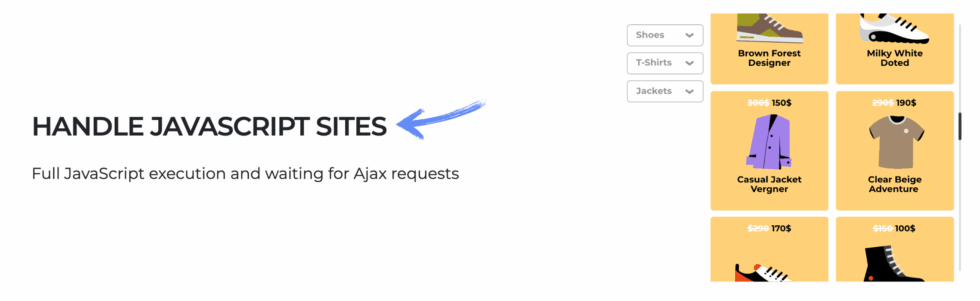
✓ Controlepunt: De preview moet de dynamisch geladen inhoud weergeven.
Stap 3: Testen en uitvoeren
Voer een test-scrape uit op één pagina om te bevestigen dat het script alle elementen vastlegt.
Zodra de verificatie is voltooid, voert u de volledige scraping uit op alle doelpagina's van de site.
✅ Resultaat: Je kunt nu als een professional gegevens extraheren uit websites die veel JavaScript gebruiken.
💡 Pro-tip: Als een site oneindig scrollen gebruikt, voeg dan een selector 'Scroll omlaag' toe om alle inhoud te laden voordat het scrapen begint.
Hoe gebruik je een webscraper? Gegevens aanpassen
Gegevens aanpassen Hiermee kunt u uw verzamelde gegevens aanpassen, opschonen en wijzigen voordat u ze opslaat.
Hieronder leggen we stap voor stap uit hoe je het gebruikt.
Stap 1: Open de gegevensvoorvertoning.
Nadat het scrapen is voltooid, klikt u op 'Bladeren' om de tabel met ruwe gegevens te bekijken.
Bekijk elke kolom en noteer welke rijen opgeschoond moeten worden.
Stap 2: Reguliere expressies of tekstfilters toepassen
Gebruik de optie 'Regex' in uw selector om ongewenste tekst te parseren en te verwijderen.
Dit is in feite een flexibele patroonherkenning die gegevens ter plekke opschoont.
Zo ziet het eruit:
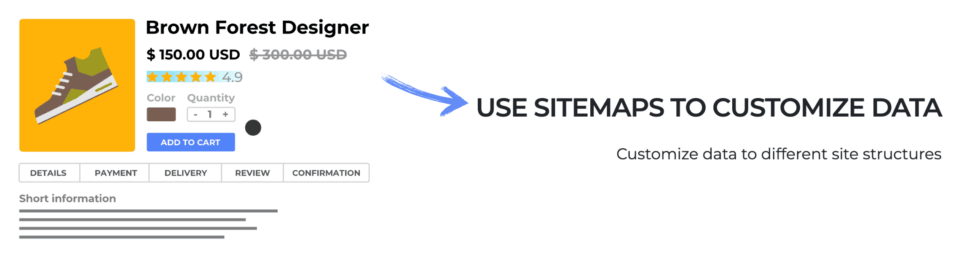
✓ Controlepunt: Uw gegevenskolommen zouden nu alleen de schone waarden moeten weergeven.
Stap 3: Kolommen hernoemen en opnieuw rangschikken
Bewerk de namen van de selectiecriteria om elke kolom een duidelijke, herkenbare koptekst te geven.
Herschik de selectors in de sitemap zodat ze overeenkomen met de structuur van uw uiteindelijke output.
✅ Resultaat: Uw gegevens zijn schoon, gelabeld en klaar voor export of analyse.
💡 Pro-tip: Gebruik het selectievakje 'Meerdere' bij een selector om alle overeenkomende elementen als aparte rijen in de uitvoer weer te geven.
Hoe gebruik je een webscraper om gegevens te exporteren?
Exporteer gegevens Hiermee kunt u uw verzamelde resultaten opslaan als een csv-, XLSX- of JSON-bestand.
Hieronder leggen we stap voor stap uit hoe je het gebruikt.
Stap 1: Maak je schraapwerk af.
Wacht tot het scrapen is voltooid en klik vervolgens op 'Bladeren' om de gegevens te bekijken.
Controleer of alle rijen en kolommen de waarden bevatten die u verwacht te zien.
Stap 2: Kies uw exportformaat
Klik op de exportknop en kies CSV, XLSX of JSON uit de lijst met formaten.
Voor de meeste gebruikers is csv de meest flexibele en breed ondersteunde optie.
Zo ziet het eruit:
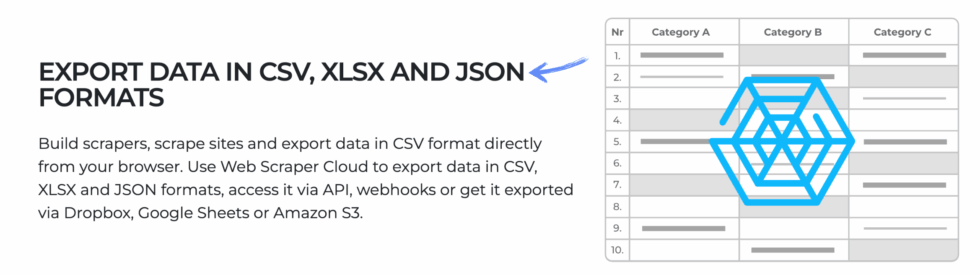
✓ Controlepunt: Je zou een melding moeten zien dat er gedownload wordt in je browser.
Stap 3: Sla het bestand op
Kies een map op uw computer en sla het geëxporteerde bestand daar op.
Open het bestand in Excel, Google Sheets of een ander programma dat CSV-bestanden kan lezen om de gegevens te controleren en af te drukken.
✅ Resultaat: De door u verzamelde gegevens worden lokaal opgeslagen en zijn direct klaar voor gebruik.
💡 Pro-tip: Op Web Scraper Cloud kun je de API of webhook gebruiken om geëxporteerde gegevens automatisch naar Dropbox of Google Drive te verzenden.
Tips en sneltoetsen voor webscrapers
Na Web Scraper meer dan zes maanden te hebben getest, deel ik hier mijn beste tips.
Gebruikersfeedback op forums bevestigt dat deze sneltoetsen de meeste tijd besparen.
Toetsenbord sneltoetsen
| Actie | Snelkoppeling |
|---|---|
| Open DevTools | F12 |
| Inspecteer element | Ctrl + Shift + C |
| Console in-/uitschakelen | Esc |
| Pagina opnieuw laden | Ctrl + R |
Verborgen functies die de meeste mensen over het hoofd zien
- Sitemap importeren/exporteren: Kopieer en plak een JSON-sitemap om snel een scraper te klonen of deel deze met je team als een bericht in je projectmap.
- Paginatiekiezer: Voeg een linkselector toe voor de "Volgende"-knoppen om automatisch door zoekresultaten met meerdere pagina's te navigeren en elke pagina te scrapen.
- Geplande scraping: Gebruik Web Scraper Cloud om op een vast schema webscrapers uit te voeren en ontvang actuele gegevens in uw inbox of via een service-webhook.
Veelvoorkomende fouten bij webscraping die je moet vermijden
Fout nr. 1: Te snel scrapen zonder vertraging
❌ Fout: Het uitvoeren van scraping zonder vertraging, wat leidt tot IP-blokkeringen en foutmeldingen van de server.
✅ Rechts: Stel een minimale vertraging van 2000 ms in tussen verzoeken om het surfgedrag van mensen na te bootsen.
Fout nr. 2: Het verkeerde selectietype gebruiken
❌ Fout: Gebruik een 'Tekst'-selector wanneer je href-linkwaarden of afbeeldings-URL's uit elementen wilt extraheren.
✅ Rechts: Stem het selectietype af op uw gegevens: gebruik 'Link' voor URL's en 'Image' voor afbeeldingen.
Fout nr. 3: De regels van robots.txt negeren.
❌ Fout: Het scrapen van pagina's die geblokkeerd zijn door robots.txt kan leiden tot juridische problemen voor bedrijven.
✅ Rechts: Controleer altijd het robots.txt-bestand voordat je gegevens schraapt om aan de regels te voldoen en problemen te voorkomen.
Probleemoplossing voor webscrapers
Probleem: Scraper retourneert lege gegevens
Oorzaak: De CSS-selectors zijn gericht op elementen die niet langer op de pagina aanwezig zijn.
Repareren: Controleer de pagina opnieuw in je browser, werk je selectors bij en voer een test-scrape uit.
Probleem: JavaScript-inhoud wordt niet geladen
Oorzaak: De gratis browserextensie kan geen JavaScript uitvoeren op pagina's die dit vereisen.
Repareren: Schakel over naar Web Scraper Cloud, dat volledige JavaScript-weergave voor dynamische websites ondersteunt.
Probleem: IP-adres wordt geblokkeerd tijdens scraping
Oorzaak: Het te snel versturen van te veel verzoeken activeert de antibotbeveiliging van de doelsite.
Repareren: Verhoog de vertragingsinstelling naar minimaal 3 seconden en gebruik proxyrotatie indien beschikbaar.
📌 Opmerking: Als geen van deze oplossingen uw probleem verhelpt, neem dan contact op met de ondersteuning van Web Scraper voor een antwoord op uw specifieke probleem.
Wat is een webscraper?
Webscraper is een web schraapgereedschap Daarmee kunt u via uw browser gegevens van elke website extraheren.
Zie het als een slimme kopieer- en plakfunctie voor het hele web, die gegevens in rijen en kolommen organiseert.
Bekijk dit korte overzicht:
Het omvat de volgende belangrijke kenmerken:
- Point-and-click-interface: Bouw webscrapers visueel, zonder Python of andere code te schrijven.
- Gegevens extraheren: Haal automatisch tekst, links en afbeeldings-URL's van elke webpagina op.
- JavaScript-sites beheren: Schraap dynamische content die wordt geladen via JavaScript- of Ajax-verzoeken.
- Gegevens aanpassen: Reinig, filter en bewerk de verzamelde uitvoer voordat u deze opslaat.
- Exportgegevens: Download uw resultaten als CSV, XLSX of JSON met één klik.
Voor een volledige recensie, zie onze Web Scraper review.
Prijzen voor webscrapers
Dit zijn de kosten van Web Scraper in 2026:
| Plan | Prijs | Het beste voor |
|---|---|---|
| Vrij | Vrij | Gewone gebruikers testen kleine scrapingtaken. |
| Project | $40/maand | Freelancers Het uitvoeren van reguliere scrapingtaken |
| Professioneel | $80/maand | Teams die meerdere webscrapers tegelijk nodig hebben |
| Schaal | $167/maand | Bureau's die zich bezighouden met het extraheren van grote hoeveelheden data. |
| Onderneming | Aangepast | Grote bedrijven met specifieke behoeften op het gebied van webscraping. |
Gratis niveau: Ja, de browserextensie is volledig gratis en kent geen tijdslimiet.
Geld-terug-garantie: Neem binnen 14 dagen contact op met de klantenservice voor een terugbetaling van betaalde abonnementen.
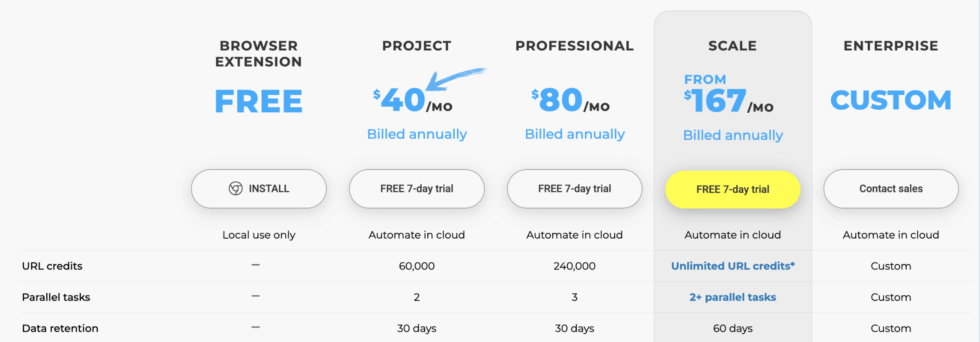
💰 Beste prijs-kwaliteitverhouding: Projectplan — biedt u cloud scraping en geplande uitvoeringen tegen de laagste prijs.
Webscraper versus alternatieven
Hoe verhoudt Web Scraper zich tot andere platforms? Hier is een overzicht van de concurrentie:
| Hulpmiddel | Het beste voor | Prijs | Beoordeling |
|---|---|---|---|
| Webscraper | Browsergebaseerd scrapen | Gratis+ | ⭐ 3,5 |
| Octoparse | Visueel scrapen zonder code | $89/maand | ⭐ 4.3 |
| ParseHub | Complexe meerlaagse scrapes | $189/maand | ⭐ 4.2 |
| Scrapy | Python-ontwikkelaars op grote schaal | Vrij | ⭐ 4,5 |
| Apify | Cloud scraping met acteurs | $49/maand | ⭐ 4.4 |
Snelle keuzes:
- Beste overall: Web Scraper — gratis versie en gebruiksvriendelijke browserextensie voor de meeste gebruikers
- Beste budget: Scrapy — volledig gratis en open-source voor Python-ontwikkelaars
- Het meest geschikt voor beginners: Octoparse — een interface met slepen en neerzetten en ingebouwde sjablonen
- Het meest geschikt voor cloud scraping: Apify — krachtige spelers en API-toegang in de wereld van webscraping
🎯 Alternatieven voor webscrapers
Op zoek naar alternatieven voor webscraper? Hier zijn de beste opties:
- 🚀 Octoparse: Een scraper zonder code met een visuele workflow. bouwer, vooraf gebouwde sjablonen en een cloudservice voor bedrijven van elke omvang.
- 💰 ParseHub: Kan complexe websites met navigatie op meerdere niveaus en AJAX-laden aan, ideaal voor gebruikers die geavanceerde gegevensextractie zonder code nodig hebben.
- 🔧 Scrapy: Een open-source Python-framework, speciaal ontwikkeld voor programmeurs die volledige controle, een soepele integratie met Soup en grootschalige webscraping willen.
- ⚡ Apify: Een cloudplatform met een marktplaats voor kant-en-klare scrapers en een flexibele API voor ontwikkelaars en teams wereldwijd.
Voor de volledige lijst, zie onze Alternatieven voor webscrapers gids.
⚔️ Webscraper vergeleken
Hieronder een vergelijking van Web Scraper met de concurrenten:
- Webscraper versus Octoparse: Web Scraper is gratis en browser-native; Octoparse biedt meer mogelijkheden met zijn desktop-app en cloudtools voor grotere projecten.
- Webscraper versus ParseHub: ParseHub biedt uitgebreidere sitenavigatie; Web Scraper wint het op prijs en eenvoud voor snelle scraping van één pagina.
- Webscraper versus Scrapy: Scrapy geeft ontwikkelaars volledige controle via Python-scripts; Web Scraper is beter geschikt voor niet-programmeurs die de voorkeur geven aan een visuele aanpak.
- Webscraper versus Apify: Apify blinkt uit in cloudgebaseerde oplossingen. automatisering en API-toegang; Web Scraper is eenvoudiger voor gebruikers die inloggen via hun browser en direct aan de slag kunnen.
Begin nu met het gebruik van Web Scraper.
Je hebt geleerd hoe je alle belangrijke functies van Web Scraper kunt gebruiken:
- ✅ Point-and-click-interface
- ✅ Gegevens extraheren
- ✅ JavaScript-sites ondersteunen
- ✅ Gegevens aanpassen
- ✅ Gegevens exporteren
Volgende stap: Kies één functie en probeer die nu uit.
De meeste mensen beginnen met een point-and-click-interface.
Het duurt minder dan 5 minuten.
Veelgestelde vragen
Is Web Scraper gratis te gebruiken?
Ja. De Web Scraper-browserextensie is gratis. Betaalde cloudabonnementen beginnen bij $40 per maand voor geplande webscraping en API-toegang.
Kan Web Scraper pagina's verwerken die met JavaScript worden weergegeven?
Ja, maar alleen op Web Scraper Cloud. De gratis browserextensie voert geen JavaScript uit. Cloudabonnementen ondersteunen volledige JS-rendering.
In welke formaten kan Web Scraper gegevens exporteren?
Met Web Scraper kunt u gegevens exporteren als CSV, XLSX of JSON. Cloudgebruikers hebben ook toegang tot gegevens via een API of webhook.
Heb ik programmeervaardigheden nodig om Web Scraper te gebruiken?
Nee. Web Scraper gebruikt een point-and-click-interface. Je selecteert elementen visueel – geen Python, Beautiful Soup of andere code nodig.
Is webscraping legaal?
Over het algemeen wel, voor openbaar beschikbare gegevens. Controleer altijd het robots.txt-bestand en de gebruiksvoorwaarden van de website. Vermijd het scrapen van persoonlijke of vertrouwelijke gegevens.













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
