
Szybki start
W tym przewodniku omówiono wszystkie funkcje Web Scrapera:
- Rozpoczęcie pracy — Utwórz konto i wykonaj podstawową konfigurację
- Jak korzystać z interfejsu „wskaż i kliknij” — Twórz scrapery wizualnie, bez pisania kodu
- Jak korzystać z funkcji Ekstrakcji danych — Pobieraj ustrukturyzowane dane z dowolnej strony witryny
- Jak korzystać z witryn z obsługą JavaScript — Zbieraj dynamiczne strony, które ładują zawartość za pomocą JS
- Jak korzystać z funkcji dostosowywania danych — Przed eksportem dostosuj i wyczyść zeskrobane rzędy
- Jak korzystać z eksportu danych — Zapisz wyniki jako plik CSV, XLSX lub JSON
Czas potrzebny: 5 minut na każdy film
Również w tym przewodniku: Profesjonalne porady | Typowe błędy | Rozwiązywanie problemów | Wycena | Alternatywy
Dlaczego warto zaufać temu przewodnikowi
Używam Web Scrapera od ponad sześciu miesięcy i przetestowałem każdą funkcję opisaną w tym samouczku. Ten artykuł jest oparty na prawdziwych doświadczeniach, a nie na marketingowym bełkocie.

Web Scraper to jedno z najbardziej przyjaznych dla początkujących narzędzi do tworzenia stron internetowych opartych na przeglądarce. dane ekstrakcja.
Jednak większość użytkowników wykorzystuje zaledwie ułamek jego możliwości.
W tym przewodniku znajdziesz instrukcje krok po kroku dotyczące korzystania z webscrapera.
Każda funkcja jest opisana zrzutami ekranu i przydatnymi wskazówkami.
Samouczek Web Scraper
Ten kompletny samouczek dotyczący korzystania z Web Scrapera przeprowadzi Cię przez wszystkie funkcje krok po kroku, od początkowej konfiguracji po zaawansowane metody, które uczynią z Ciebie zaawansowanego użytkownika.
Web Scraper
Scrapinguj strony internetowe bezpośrednio z przeglądarki bez konieczności pisania kodu. Web Scraper pozwala wyodrębnić dane z dowolnej strony internetowej i wyeksportować je do formatu CSV, XLSX lub JSON. Zacznij za darmo — nie potrzebujesz karty kredytowej.
Wprowadzenie do Web Scrapera
Przed użyciem jakiejkolwiek funkcji należy wykonać jednorazową konfigurację.
Zajmie to około 3 minuty.
Obejrzyj najpierw ten krótki przegląd:
Przyjrzyjmy się teraz każdemu krokowi.
Krok 1: Utwórz swoje konto
Wejdź na stronę internetową Web Scraper pod adresem https://webscraper.io/ w swojej przeglądarce.
Kliknij „Zarejestruj się” lub „Rozpocznij bezpłatny okres próbny”.
Podaj swój adres e-mail i utwórz hasło, aby utworzyć konto.
✓ Punkt kontrolny: Sprawdź swoje skrzynka odbiorcza aby otrzymać e-mail z potwierdzeniem.
Krok 2: Zainstaluj rozszerzenie przeglądarki
Otwórz Chrome Web Store i wyszukaj „Web Scraper”, aby znaleźć rozszerzenie.
Kliknij „Dodaj do Chrome” i potwierdź pobieranie.
Rozszerzenie działa również na komputerach z systemami Windows, macOS i Linux.
Oto jak wygląda pulpit nawigacyjny:
✓ Punkt kontrolny: Powinna zostać wyświetlona zakładka Web Scraper w DevTools.
Krok 3: Zakończ konfigurację początkową
Otwórz DevTools (F12) i kliknij kartę Web Scraper, aby załadować interfejs.
Utwórz pierwszą mapę witryny, wklejając adres URL witryny, którą chcesz zeskrobać.
✅ Zrobione: Możesz już używać dowolnej funkcji poniżej.
Jak korzystać z interfejsu „wskaż i kliknij” w Web Scraper
Interfejs typu „wskaż i kliknij” umożliwia wizualne utworzenie skrobaka poprzez wybranie odpowiednich elementów na stronie.
Oto instrukcja krok po kroku, jak z niego korzystać.
Krok 1: Otwórz Edytor mapy witryny
Przejdź do witryny, którą chcesz zeskrobać w swojej przeglądarce.
Otwórz DevTools i kliknij kartę Web Scraper, aby rozpocząć.
Krok 2: Wybierz elementy wizualnie
Kliknij „Dodaj nowy selektor” i wybierz typ selektora.
Kliknij bezpośrednio na elementy strony, które chcesz zeskrobać.
Web Scraper podświetla odpowiednie elementy i sugeruje selektory CSS.
Na przykład kliknięcie tytułu produktu automatycznie generuje pasujący selektor.
Oto jak to wygląda:
✓ Punkt kontrolny: Powinny pojawić się zielone podświetlenia na wybranych elementach.
Krok 3: Zapisz swój selektor
Kliknij „Zakończ wybieranie”, a następnie naciśnij „Zapisz selektor”, aby potwierdzić.
Narzędzie do skrobania przechowuje wzorzec selektorów CSS służący do znajdowania elementów na każdej stronie.
✅ Wynik: Twój wizualny scraper jest gotowy do wyodrębniania danych bez konieczności pisania kodu.
💡 Wskazówka: Użyj „Podglądu elementu”, aby sprawdzić, czy selektory pobierają właściwe dane przed uruchomieniem pełnego skanowania.
Jak korzystać z Web Scrapera do ekstrakcji danych
Wyodrębnij dane umożliwia automatyczne pobieranie ustrukturyzowanych danych z dowolnej strony internetowej.
Oto instrukcja krok po kroku, jak z niego korzystać.
Krok 1: Skonfiguruj swoje selektory
Skonfiguruj selektory dla każdego punktu danych — tekst, link, obraz lub nagłówek html.
Użyj drzewa selektora, aby poruszać się po zagnieżdżonych elementach w strukturze strony.
Krok 2: Uruchom Scrape
Kliknij „Scrape” i ustaw interwał żądań oraz opóźnienie ładowania strony.
Narzędzie do skrobania danych wysyła żądania do każdego adresu URL i rozpoczyna proces ekstrakcji danych.
Oto jak to wygląda:
✓ Punkt kontrolny: Powinny pojawić się wiersze wyodrębnionych danych w podglądzie.
Krok 3: Przejrzyj swoje wyniki
Kliknij „„Przeglądać” aby sprawdzić wyodrębnione dane w widoku tabeli.
Sprawdź, czy każda kolumna odpowiada danym, które chcesz zebrać.
✅ Wynik: Masz czyste, ustrukturyzowane dane gotowe do eksportu.
💡 Wskazówka: Ustaw 2-sekundowe opóźnienie między żądaniami, aby uniknąć wywoływania ograniczeń przepustowości na stronie docelowej.
Jak korzystać z Web Scrapera do obsługi witryn JavaScript
Obsługa witryn JavaScript umożliwia scrapowanie dynamicznych stron, których zawartość ładuje się za pomocą JavaScript.
Oto instrukcja krok po kroku, jak z niego korzystać.
Krok 1: Zidentyfikuj dynamiczną zawartość
Sprawdź, czy strona ładuje dane po początkowym kodzie HTML, obserwując drzewo węzłów.
Może być konieczne ręczne przeglądanie elementów HTML w celu potwierdzenia, które z nich ładują się późno.
Ta funkcja jest potrzebna, jeśli treść pojawia się dopiero po uruchomieniu JavaScript.
Krok 2: Włącz renderowanie JavaScript
W Web Scraper Cloud wybierz opcję „Pełne renderowanie JavaScript” w ustawieniach mapy witryny.
Ustaw czas ładowania strony tak, aby wszystkie elementy zostały w pełni wyrenderowane przed rozpoczęciem scrapowania.
Oto jak to wygląda:
✓ Punkt kontrolny: Podgląd powinien pokazywać dynamicznie ładowaną zawartość.
Krok 3: Przetestuj i uruchom
Uruchom test scrapowania na jednej stronie, aby upewnić się, że skrypt przechwytuje każdy element.
Po weryfikacji przeprowadź pełne skanowanie wszystkich stron docelowych witryny.
✅ Wynik: Teraz możesz wyodrębniać dane ze stron zawierających dużo JS jak profesjonalista.
💡 Wskazówka: Jeśli witryna korzysta z przewijania w nieskończoność, dodaj selektor „Przewiń w dół”, aby załadować całą zawartość przed rozpoczęciem skrobania.
Jak korzystać z Web Scrapera i dostosowywać dane
Dostosuj dane umożliwia dostosowanie, wyczyszczenie i modyfikację zebranych danych przed ich zapisaniem.
Oto instrukcja krok po kroku, jak z niego korzystać.
Krok 1: Otwórz podgląd danych
Po zakończeniu skrobania kliknij „Przeglądaj”, aby wyświetlić tabelę z nieprzetworzonymi danymi.
Przejrzyj każdą kolumnę i zanotuj wszystkie wiersze, które wymagają czyszczenia.
Krok 2: Zastosuj filtry wyrażeń regularnych lub tekstu
Użyj opcji „Regex” w selektorze, aby przeanalizować i przyciąć niepożądany tekst.
W zasadzie jest to elastyczne dopasowywanie wzorców, które oczyszcza dane na miejscu.
Oto jak to wygląda:
✓ Punkt kontrolny: Kolumny danych powinny teraz pokazywać tylko czyste wartości.
Krok 3: Zmień nazwy i kolejność kolumn
Edytuj nazwy selektorów, aby nadać każdej kolumnie czytelną, znajomą etykietę nagłówka.
Zmień kolejność selektorów na mapie witryny, aby odpowiadała ostatecznej strukturze wyjściowej.
✅ Wynik: Twoje dane są czyste, oznaczone i gotowe do eksportu lub analizy.
💡 Wskazówka: Zaznacz pole wyboru „Wielokrotne” w selektorze, aby przechwycić wszystkie pasujące elementy jako osobne wiersze w wynikach.
Jak korzystać z eksportu danych Web Scraper
Eksport danych umożliwia zapisanie zebranych wyników w pliku csv, XLSX lub JSON.
Oto instrukcja krok po kroku, jak z niego korzystać.
Krok 1: Zakończ skrobanie
Poczekaj na zakończenie zbierania danych, a następnie kliknij „Przeglądaj”, aby wyświetlić podgląd danych.
Sprawdź, czy wszystkie wiersze i kolumny zawierają oczekiwane wartości.
Krok 2: Wybierz format eksportu
Kliknij przycisk eksportu i wybierz CSV, XLSX lub JSON z listy formatów.
Dla większości użytkowników CSV jest najbardziej elastyczną i najszerzej wspieraną opcją.
Oto jak to wygląda:
✓ Punkt kontrolny: W przeglądarce powinien pojawić się monit pobierania.
Krok 3: Zapisz plik
Wybierz folder na swoim komputerze i zapisz wyeksportowany plik.
Otwórz plik w programie Excel, Arkuszach Google lub dowolnym innym narzędziu odczytującym pliki CSV, aby zweryfikować i wydrukować dane.
✅ Wynik: Zebrane dane zostaną zapisane lokalnie i będą gotowe do użycia.
💡 Wskazówka: W Web Scraper Cloud użyj interfejsu API lub webhooka, aby automatycznie wysłać wyeksportowane dane do Dropbox lub Google Drive.
Porady i skróty dotyczące Web Scraper Pro
Oto moje najlepsze wskazówki po ponad sześciomiesięcznym testowaniu Web Scrapera.
Opinie użytkowników na forach potwierdzają, że te skróty pozwalają zaoszczędzić najwięcej czasu.
Skróty klawiaturowe
| Działanie | Skrót |
|---|---|
| Otwórz narzędzia programistyczne | F12 |
| Sprawdź element | Ctrl + Shift + C |
| Przełącz konsolę | Esc |
| Odśwież stronę | Ctrl + R |
Ukryte funkcje, których większość ludzi nie dostrzega
- Import/eksport mapy witryny: Skopiuj i wklej mapę witryny JSON, aby szybko sklonować narzędzie do scrapowania lub udostępnić ją swojemu zespołowi jako wpis w folderze projektu.
- Selektor paginacji: Dodaj selektor linków dla przycisków „Dalej”, aby automatycznie nawigować po wielostronicowych wynikach wyszukiwania i przeszukiwać każdą stronę.
- Zaplanowane scrapowanie: Użyj Web Scraper Cloud, aby przeprowadzać scrapowanie według ustalonego harmonogramu i otrzymywać najnowsze dane do skrzynki odbiorczej lub webhooka usługi.
Najczęstsze błędy w Web Scraperze, których należy unikać
Błąd nr 1: Zbyt szybkie zbieranie danych bez opóźnień
❌ Źle: Uruchamianie scrapowania bez opóźnień, co powoduje blokowanie adresów IP i odpowiedzi błędów z serwera.
✅ Po prawej: Ustaw minimalne opóźnienie 2000 ms między żądaniami, aby naśladować ludzkie wzorce przeglądania.
Błąd nr 2: Użycie niewłaściwego typu selektora
❌ Źle: Użycie selektora „Tekst” w celu wyodrębnienia wartości linków href lub adresów URL obrazów z elementów.
✅ Po prawej: Dopasuj typ selektora do swoich danych — użyj „Link” w przypadku adresów URL i „Obraz” w przypadku obrazów.
Błąd nr 3: Ignorowanie zasad pliku robots.txt
❌ Źle: Zeskrobywanie stron zablokowanych przez plik robots.txt, co może prowadzić do problemów prawnych dla firm.
✅ Po prawej: Zawsze sprawdzaj plik robots.txt przed rozpoczęciem scrapowania, aby zachować zgodność z przepisami i uniknąć problemów.
Rozwiązywanie problemów z Web Scraperem
Problem: Scraper zwraca puste dane
Przyczyna: Selektory CSS odnoszą się do elementów, które już nie istnieją na stronie.
Naprawić: Ponownie sprawdź stronę w przeglądarce, zaktualizuj selektory i uruchom testowe skanowanie.
Problem: Zawartość JavaScript nie ładuje się
Przyczyna: Bezpłatne rozszerzenie przeglądarki nie może wykonywać JavaScript na stronach, które tego wymagają.
Naprawić: Przejdź na Web Scraper Cloud, który obsługuje pełne renderowanie JavaScript dla witryn dynamicznych.
Problem: adres IP zostaje zablokowany w trakcie pobierania
Przyczyna: Wysyłanie zbyt wielu żądań w zbyt krótkim czasie uruchamia ochronę anty-botową witryny docelowej.
Naprawić: Zwiększ ustawienie opóźnienia do co najmniej 3 sekund i użyj rotacji proxy, jeśli jest dostępna.
📌 Notatka: Jeśli żadna z powyższych metod nie pomoże Ci rozwiązać problemu, skontaktuj się z pomocą techniczną Web Scraper, aby uzyskać odpowiedź na swój konkretny problem.
Czym jest Web Scraper?
Web Scraper jest siecią narzędzie do skrobania która umożliwia wyodrębnianie danych z dowolnej witryny internetowej przy użyciu przeglądarki.
Można to sobie wyobrazić jako inteligentne narzędzie do kopiowania i wklejania dla całej sieci, które organizuje dane w wierszach i kolumnach.
Obejrzyj ten krótki przegląd:
Zawiera następujące kluczowe funkcje:
- Interfejs typu „wskaż i kliknij”: Twórz scrapery wizualnie, bez pisania Pythona ani żadnego kodu
- Wyodrębnij dane: Automatycznie pobieraj tekst, linki i adresy URL obrazów z dowolnej strony internetowej
- Obsługa witryn JavaScript: Zbieraj dynamiczną zawartość ładowaną za pomocą żądań JS lub Ajax
- Dostosuj dane: Wyczyść, przefiltruj i zmodyfikuj zeskrobane dane wyjściowe przed zapisaniem
- Eksport danych: Pobierz wyniki w formacie CSV, XLSX lub JSON jednym kliknięciem
Aby zapoznać się z pełną recenzją, zobacz naszą Recenzja Web Scrapera.
Cennik Web Scraper
Oto, ile kosztuje Web Scraper w 2026 roku:
| Plan | Cena | Najlepsze dla |
|---|---|---|
| Bezpłatny | Bezpłatny | Przeciętni użytkownicy testujący małe zadania scrapowania |
| Projekt | 40 USD/miesiąc | Freelancerzy uruchamianie regularnych zadań scrapowania |
| Profesjonalny | 80 USD/miesiąc | Zespoły potrzebujące wielu jednoczesnych scraperów |
| Skala | 167 USD/miesiąc | Agencje zajmujące się ekstrakcją dużych ilości danych |
| Przedsiębiorstwo | Zwyczaj | Duże firmy z niestandardowymi potrzebami scrapowania |
Poziom bezpłatny: Tak — rozszerzenie przeglądarki jest całkowicie bezpłatne i nie ma ograniczeń czasowych.
Gwarancja zwrotu pieniędzy: Aby uzyskać zwrot pieniędzy za plany płatne, skontaktuj się z pomocą techniczną w ciągu 14 dni.
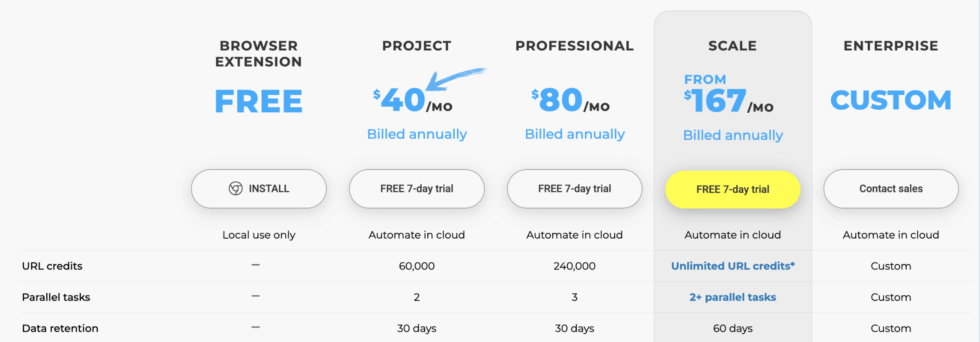
💰 Najlepszy stosunek jakości do ceny: Plan projektu — zapewnia scrapowanie danych w chmurze i zaplanowane przebiegi w najniższej cenie.
Web Scraper kontra alternatywy
Jak wypada Web Scraper na tle konkurencji? Oto konkurencyjna sytuacja:
| Narzędzie | Najlepsze dla | Cena | Ocena |
|---|---|---|---|
| Web Scraper | Scraping oparty na przeglądarce | Bezpłatny+ | ⭐ 3,5 |
| Ośmiornica | Scraping wizualny bez kodu | 89 USD/mies. | ⭐ 4.3 |
| ParseHub | Złożone wielopoziomowe skrobanie | 189 USD/mies. | ⭐ 4.2 |
| Scrapy | Programiści Pythona na dużą skalę | Bezpłatny | ⭐ 4,5 |
| Apify | Przeszukiwanie chmur z udziałem aktorów | 49 USD/mies. | ⭐ 4.4 |
Szybkie typy:
- Najlepszy ogółem: Web Scraper — bezpłatna wersja i łatwe rozszerzenie przeglądarki dla większości użytkowników
- Najlepszy budżet: Scrapy — całkowicie darmowy i otwarty kod źródłowy dla programistów Pythona
- Najlepsze dla początkujących: Octoparse — interfejs typu „przeciągnij i upuść” z wbudowanymi szablonami
- Najlepsze do scrapowania chmur: Apify — potężni aktorzy i dostęp do API w świecie scrapowania stron internetowych
🎯 Alternatywy dla Web Scrapera
Szukasz alternatyw dla Web Scrapera? Oto najlepsze opcje:
- 🚀 Ośmiornica: Scraper bez kodu z wizualnym przepływem pracy budowniczy, gotowe szablony i usługi w chmurze dla firm każdej wielkości.
- 💰 ParseHub: Obsługuje złożone witryny z wielopoziomową nawigacją i ładowaniem AJAX, co jest świetnym rozwiązaniem dla użytkowników potrzebujących zaawansowanego wyodrębniania danych bez konieczności pisania kodu.
- 🔧 Scrapy: Otwartoźródłowy framework Pythona przeznaczony dla programistów, którzy chcą mieć pełną kontrolę, płynną integrację z innymi systemami i możliwość scrapowania na dużą skalę.
- ⚡ Apify: Platforma w chmurze oferująca rynek gotowych scraperów i elastyczny interfejs API dla programistów i zespołów na całym świecie.
Aby zobaczyć pełną listę, zobacz naszą Alternatywy dla Web Scrapera przewodnik.
⚔️ Porównanie Web Scraperów
Oto jak Web Scraper wypada na tle konkurencji:
- Web Scraper kontra Octoparse: Web Scraper jest darmowy i wbudowany w przeglądarkę; Octoparse oferuje większą moc dzięki aplikacji na komputery stacjonarne i narzędziom chmurowym przeznaczonym do większych projektów.
- Web Scraper kontra ParseHub: ParseHub obsługuje głębszą nawigację w witrynie; Web Scraper wygrywa ceną i prostotą przy szybkim scrapowaniu pojedynczych stron.
- Web Scraper kontra Scrapy: Scrapy daje programistom pełną kontrolę za pośrednictwem skryptów Python; Web Scraper jest lepszy dla osób niebędących programistami, które preferują podejście wizualne.
- Web Scraper kontra Apify: Apify wyróżnia się w rozwiązaniach opartych na chmurze automatyzacja i dostęp do API; Web Scraper jest prostszy dla użytkowników, którzy logują się do przeglądarki i przechodzą do niej.
Zacznij korzystać z Web Scraper już teraz
Nauczyłeś się, jak korzystać ze wszystkich głównych funkcji Web Scrapera:
- ✅ Interfejs typu „wskaż i kliknij”
- ✅ Wyodrębnij dane
- ✅ Obsługa witryn JavaScript
- ✅ Dostosuj dane
- ✅ Eksport danych
Następny krok: Wybierz jedną funkcję i wypróbuj ją teraz.
Większość osób zaczyna od interfejsu typu „wskaż i kliknij”.
Zajmie to mniej niż 5 minut.
Często zadawane pytania
Czy korzystanie z Web Scraper jest darmowe?
Tak. Rozszerzenie przeglądarki Web Scraper jest bezpłatne. Płatne plany w chmurze zaczynają się od 40 USD miesięcznie za zaplanowane scrapowanie i dostęp do API.
Czy Web Scraper obsługuje strony renderowane za pomocą JavaScript?
Tak, ale tylko w Web Scraper Cloud. Darmowe rozszerzenie przeglądarki nie obsługuje JavaScript. Plany w chmurze obsługują pełne renderowanie JS.
W jakich formatach Web Scraper może eksportować dane?
Web Scraper umożliwia eksportowanie danych w formatach CSV, XLSX lub JSON. Użytkownicy chmury mogą również uzyskać dostęp do danych za pośrednictwem interfejsu API lub webhooka.
Czy do korzystania z Web Scrapera potrzebne są umiejętności kodowania?
Nie. Web Scraper korzysta z interfejsu typu „wskaż i kliknij”. Elementy wybiera się wizualnie — bez konieczności używania Pythona, Beautiful Soup ani innego kodu.
Czy scrapowanie stron internetowych jest legalne?
Generalnie tak, w przypadku danych publicznie dostępnych. Zawsze sprawdzaj plik robots.txt witryny i warunki korzystania z usługi. Unikaj scrapowania danych osobowych lub prywatnych.













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
