
Início rápido
Este guia sobre como usar o ScrapingBee abrange todos os recursos:
- Começando — Crie sua conta e obtenha sua chave de API
- Como usar a extração de dados da web com IA — extrair informações estruturadas complexas de páginas da web usando linguagem simples
- Como usar a API de pesquisa do Google — Extraia resultados de pesquisa do Google sem precisar gerenciar IPs de proxy.
- Como usar o Google Shopping Scraper — coletar listas de produtos e o preço extraído para qualquer termo de pesquisa
- Como usar o JavaScript para extrair dados da web — Gerenciar a renderização de JavaScript em páginas da web criadas com React ou Vue
- Como usar o ChatGPT Scraper — capturar respostas e código-fonte da página a partir de páginas de bate-papo dinâmicas com IA
- Como usar a API do Google News Scraper — Obtenha títulos e artigos completos por meio de solicitações de API simples
- Como usar a extração rápida de dados — Execute extração de dados rápida enquanto o ScrapingBee rotaciona proxies para você.
- Como usar a API de captura de tela programática — capturar uma captura de tela da página inteira de qualquer URL programaticamente
- Como usar o recurso de extração de dados do Google Jobs — reunir anúncios de emprego como informações estruturadas complexas
Tempo necessário: 5 minutos por filme
Neste guia também: Dicas profissionais | Erros comuns | Solução de problemas | Preços | Alternativas
Por que confiar neste guia?
Utilizo o ScrapingBee há mais de um ano e testei todos os seus recursos. Este tutorial é baseado em experiência prática real de scraping, não em capturas de tela fornecidas pelo fabricante.

O ScrapingBee é baseado na nuvem. ferramenta de raspagem que lida com as partes mais difíceis da extração de dados da web.
Ele gerencia navegadores sem interface gráfica e alterna proxies para você.
Este guia mostra como usar cada uma das principais funcionalidades passo a passo.
Com capturas de tela, um exemplo simples e dicas profissionais ao longo do texto.
Tutorial do ScrapingBee
Este tutorial completo do ScrapingBee explica todos os recursos, desde sua primeira requisição à API até truques avançados de JavaScript.
ScrapingBee
Extraia dados de qualquer site sem precisar gerenciar IPs de proxy ou navegadores sem interface gráfica. O ScrapingBee cuida da renderização de JavaScript por meio de uma API REST simples. Obtenha 1000 chamadas de API gratuitas para começar — sem necessidade de cartão de crédito.
Primeiros passos com o ScrapingBee
Antes de usar qualquer recurso, conclua esta configuração única.
Leva cerca de três minutos.
Segue um breve resumo do fluxo de trabalho:
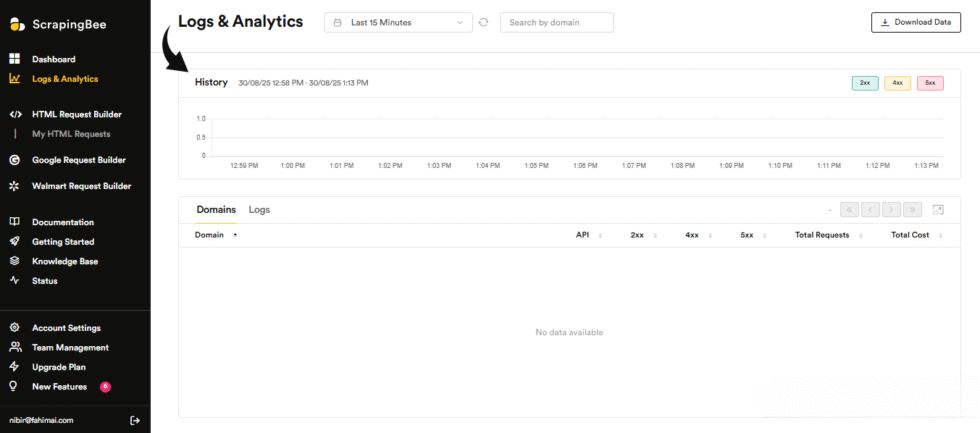
Agora vamos analisar cada etapa.
Passo 1: Crie sua conta
Acesse o site da ScrapingBee e clique em "Cadastrar-se".
Insira o código promocional ADNAN através do link de indicação para obter crédito extra na API.
✓ Ponto de verificação: Seu painel de controle exibe sua chave de API exclusiva.
Passo 2: Configure seu código
Em Python, execute `pip install scrapingbee` ou simplesmente importe `requests`.
A biblioteca requests permite que você chame a API a partir de qualquer linguagem de programação.
✓ Ponto de verificação: Seu ambiente está pronto para enviar solicitações de API.
Passo 3: Faça sua primeira ligação
Envie uma solicitação para o endpoint https://app.scrapingbee.com/api/v1/ com sua chave de API e URL.
Este exemplo simples permite extrair dados de páginas da web com apenas algumas linhas de código.
✅ Concluído: Você está pronto para usar qualquer um dos recursos abaixo.
Como usar o ScrapingBee AI para extração de dados da web
Extração de dados da web com IA Permite extrair informações estruturadas complexas de páginas da web usando linguagem simples.
Veja aqui como usá-lo passo a passo.
Passo 1: Obtenha sua chave de API
Cadastre-se e copie sua chave de API do painel de controle.
Etapa 2: Descreva os dados
Adicione a URL de destino e escreva uma consulta em linguagem simples.
Eis como isso se parece:
✓ Ponto de verificação: Um objeto JSON limpo é exibido com seus campos.
Etapa 3: Definir regras de extração
Ajuste suas regras de extração para capturar cada campo com exatidão.
✅ Resultado: JSON estruturado sem a necessidade de escrever seletores CSS manualmente.
💡 Dica profissional: Combine a extração por IA com seletores CSS quando precisar de controle preciso.
Como usar a API de pesquisa do Google do ScrapingBee
API de pesquisa do Google Permite extrair resultados de pesquisa do Google sem precisar gerenciar IPs de proxy.
Veja aqui como usá-lo passo a passo.
Passo 1: Escolha o ponto final
Direcione sua solicitação para a API de Busca do Google.
Etapa 2: Defina a consulta
Adicione sua palavra-chave e um país aleatório para obter resultados locais.
Eis como isso se parece:
✓ Ponto de verificação: Os resultados classificados são retornados como dados estruturados.
Etapa 3: Leia o JSON
Analise a resposta com a biblioteca requests em Python.
✅ Resultado: Pesquise dados através de uma simples chamada à API REST.
💡 Dica profissional: Use o código do país para geolocalização de proxy premium em todas as consultas.
Como usar o ScrapingBee Google Shopping Scraper
Extrator de dados do Google Shopping Permite coletar listas de produtos e o preço extraído para qualquer termo de pesquisa.
Veja aqui como usá-lo passo a passo.
Passo 1: Enviar um pedido de compras
Acesse o endpoint de compras com sua consulta de produto.
Etapa 2: Analisar a resposta
Mapeie cada anúncio com seu título, link e preço extraído.
Eis como isso se parece:
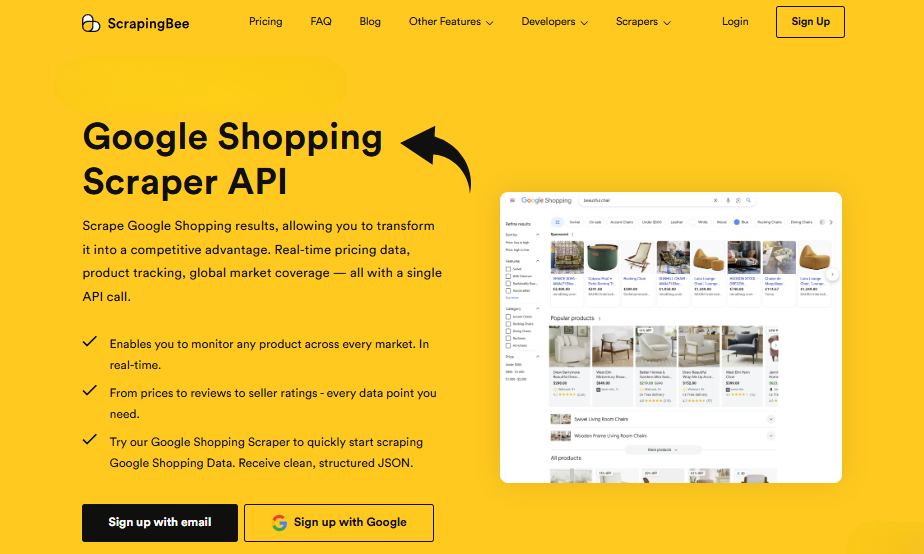
✓ Ponto de verificação: As linhas de produtos são retornadas como JSON limpo.
Etapa 3: Exportar os resultados
Salve os dados em formato CSV para análises posteriores.
✅ Resultado: Dados de preços em tempo real, prontos para qualquer planilha.
💡 Dica profissional: O cronograma é executado para acompanhar o preço extraído ao longo do tempo.
Como usar o ScrapingBee para extrair dados da web com JavaScript
Web Scraping em JavaScript Permite controlar a renderização de JavaScript em páginas web criadas com React ou Vue.
Veja aqui como usá-lo passo a passo.
Passo 1: Ative o render_js
Defina render_js=true para que o ScrapingBee utilize navegadores sem interface gráfica.
Passo 2: Aguarde um elemento
Diga para o programa esperar que um elemento específico seja carregado.
Eis como isso se parece:
✓ Ponto de verificação: A página inteira é exibida antes da extração.
Etapa 3: Capturar o HTML
Retorna o HTML original ou o código-fonte bruto da página após a renderização.
✅ Resultado: Páginas web totalmente renderizadas, sem necessidade de gerenciar drivers da web.
💡 Dica profissional: Adicione um cenário em JavaScript para clicar, rolar ou preencher formulários.
Como usar o Scraper ChatGPT do ScrapingBee
ChatGPT Raspador Permite capturar respostas e o código-fonte de páginas de bate-papo com IA dinâmica.
Veja aqui como usá-lo passo a passo.
Passo 1: Selecione a página
Envie a URL da página com o render_js ativado.
Etapa 2: Renderizar e Extrair
Deixe que o processo de raspagem sem interface gráfica carregue a resposta e, em seguida, capture-a. texto.
Eis como isso se parece:
✓ Ponto de verificação: A resposta renderizada é exibida no código-fonte da página.
Passo 3: Salvar o resultado
Armazene o HTML analisado para processamento posterior.
✅ Resultado: Texto limpo extraído de uma página totalmente dinâmica.
💡 Dica profissional: Encadeie um cenário em JavaScript para percorrer instruções com várias etapas.
Como usar a API de extração de notícias do Google do ScrapingBee
API de extração de notícias do Google Permite obter títulos e artigos completos através de simples solicitações de API.
Veja aqui como usá-lo passo a passo.
Passo 1: Defina o endpoint de notícias
Direcione sua solicitação para a API do Google Notícias.
Passo 2: Adicionar filtros
Filtre por tópico, idioma ou país aleatório.
Eis como isso se parece:
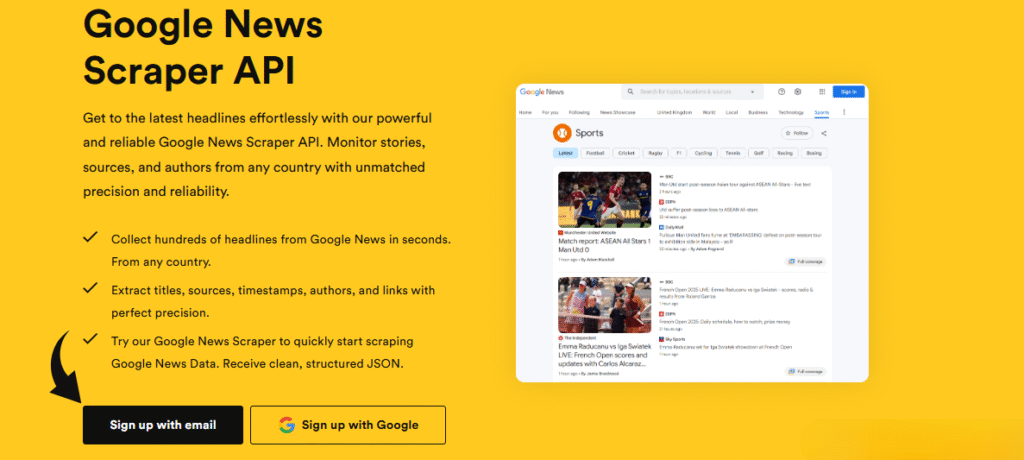
✓ Ponto de verificação: Os títulos correspondentes são retornados como dados estruturados.
Etapa 3: Coletar artigos
Percorra os resultados para reunir cada história.
✅ Resultado: Notícias atualizadas diretamente da API do Scrapingbee.
💡 Dica profissional: Gire o código do país para comparar a cobertura regional.
Como usar o ScrapingBee para extração rápida de dados
Extração rápida de dados Permite que você execute extração de dados rápida enquanto o ScrapingBee alterna os proxies para você.
Veja aqui como usá-lo passo a passo.
Passo 1: Elabore sua solicitação
Reúna a URL, a chave da API e os parâmetros apenas uma vez.
Etapa 2: Executar chamadas simultâneas
Dispare várias requisições de API ao mesmo tempo.
Eis como isso se parece:
✓ Ponto de verificação: As respostas são enviadas em paralelo.
Etapa 3: Verificar códigos de status
Confirme o código HTTP 200 para cada código de status retornado.
✅ Resultado: High-volume scraping handled on remote machines.
💡 Dica profissional: O ThreadPoolExecutor acelera drasticamente a extração de dados de páginas da web.
Como usar a API de captura de tela programática do ScrapingBee
API de Captura de Tela Programática Permite capturar uma captura de tela completa de qualquer URL programaticamente.
Veja aqui como usá-lo passo a passo.
Passo 1: Adicione a flag de captura de tela
Adicione screenshot=true à sua solicitação de API.
Passo 2: Selecione Página Inteira
Defina full_page=true para capturar todo o layout.
Eis como isso se parece:
✓ Ponto de verificação: Uma imagem de página inteira é exibida de ponta a ponta.
Passo 3: Baixe a imagem
Salve o arquivo retornado no disco.
✅ Resultado: Capturas com qualidade de pixel geradas sob demanda.
💡 Dica profissional: O parâmetro full_page garante que a página inteira seja renderizada primeiro.
Como usar o ScrapingBee para extrair dados do Google Jobs
Extrair dados do Google Jobs Permite reunir anúncios de emprego como informações estruturadas complexas.
Veja aqui como usá-lo passo a passo.
Etapa 1: Ligue para o ponto final de tarefas
Envie sua função e localização para a API de vagas.
Etapa 2: Filtrar resultados
Refine os resultados por título, empresa ou cidade.
Eis como isso se parece:
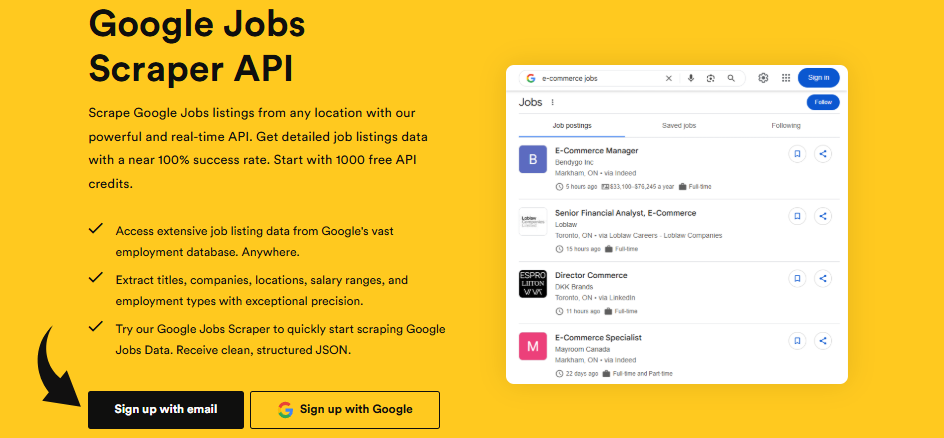
✓ Ponto de verificação: As linhas de tarefas são retornadas como JSON limpo.
Etapa 3: Estruturar os dados
Analise os campos HTML e transforme-os em uma tabela organizada.
✅ Resultado: Dados do trabalho prontos para serem analisados e armazenados.
💡 Dica profissional: Combine com seletores CSS para exibir campos personalizados.
Dicas e Atalhos Profissionais do ScrapingBee
Após testar o ScrapingBee por mais de um ano, aqui estão minhas melhores dicas para extrair dados de sites.
Parâmetros-chave da API
| Parâmetro | O que faz |
|---|---|
| render_js | Renderiza JavaScript em navegadores sem interface gráfica. |
| proxy premium | Alterna para IPs de proxy residenciais |
| código_do_país | Define a geolocalização do proxy premium por país aleatório. |
| bloquear_anúncios | Permite bloquear anúncios para acelerar as solicitações. |
Características ocultas que a maioria das pessoas não percebe
- ID da sessão: Encaminha as solicitações de API através do mesmo endereço IP por cinco minutos, mantendo assim o mesmo código HTTP e sessão.
- return_page_source: Retorna o HTML original e o código-fonte completo da página antes da execução de qualquer script JavaScript.
- Cabeçalhos e cookies personalizados: Envie seus próprios cabeçalhos e cookies personalizados ou utilize os cabeçalhos padrão gerados pelo ScrapingBee.
- Controle do cabeçalho: Substituir um cabeçalho existente por um novo, exibir os cabeçalhos gerados automaticamente e, em seguida, manter apenas cabeçalhos específicos e descartar os demais.
Erros comuns a evitar no ScrapingBee
Erro nº 1: Ignorar o arquivo robots.txt antes de realizar a coleta de dados.
❌ Errado: Disparar requisições em qualquer site que você queira extrair dados sem verificar as regras primeiro.
✅ Direita: Verifique o arquivo robots.txt e os termos de serviço antes de extrair dados de páginas da web.
Erro nº 2: Esquecer de ativar a renderização em JavaScript.
❌ Errado: Esperava conteúdo dinâmico, mas recebia sempre um código-fonte vazio.
✅ Direita: Defina render_js=true para que navegadores sem interface gráfica carreguem a página completa primeiro.
Erro nº 3: Enviar apenas os cabeçalhos padrão
❌ Errado: Confiar apenas nos cabeçalhos padrão, que alguns sites sinalizam e bloqueiam.
✅ Direita: Envie seus próprios cabeçalhos personalizados e um parâmetro de agente do usuário real quando quiser realizar a extração de dados.
Solução de problemas do ScrapingBee
Problema: Fonte da página vazia ou parcial
Causa: O código JavaScript na página nunca foi renderizado, então o HTML retornou em branco.
Consertar: Defina render_js=true e aguarde até que um elemento específico carregue a página inteira.
Problema: As solicitações continuam sendo bloqueadas.
Causa: Os endereços IP padrão do proxy do datacenter foram sinalizados pelo site de destino.
Consertar: Habilite os proxies premium para alternar entre endereços IP de países aleatórios.
Problema: Você vê um código HTTP 401 ou 403.
Causa: Sua chave de API está incorreta ou você não tem mais créditos de API.
Consertar: Confirme a chave da API, verifique seu código de status e adicione créditos, se necessário.
📌 Observação: Se nenhuma dessas soluções resolver o seu problema, entre em contato com o suporte do ScrapingBee.
O que é o ScrapingBee?
ScrapingBee É uma ferramenta de raspagem de dados baseada na nuvem que lida com navegadores sem interface gráfica e alterna proxies para você.
Pense nisso como um navegador hospedado que você controla por meio de uma API REST.
Veja esta breve visão geral:
Inclui estas características principais:
- Extração de dados da web com IA: Permite extrair informações estruturadas complexas de páginas da web usando linguagem simples.
- API de pesquisa do Google: Permite extrair resultados de pesquisa do Google sem precisar gerenciar IPs de proxy.
- Extrator de dados do Google Shopping: Permite coletar listas de produtos e o preço extraído para qualquer termo de pesquisa.
- Web Scraping com JavaScript: Permite controlar a renderização de JavaScript em páginas web criadas com React ou Vue.
- Raspador ChatGPT: Permite capturar respostas e o código-fonte de páginas de bate-papo com IA dinâmica.
- API do Google News Scraper: Permite obter títulos e artigos completos através de simples solicitações de API.
- Extração rápida de dados: Permite que você execute extração de dados rápida enquanto o ScrapingBee alterna os proxies para você.
- API programática de captura de tela: Permite capturar uma captura de tela completa de qualquer URL programaticamente.
- Extrair dados de vagas do Google: Permite reunir anúncios de emprego como informações estruturadas complexas.
Para uma análise completa, consulte nosso artigo. Análise do ScrapingBee.
Preços do ScrapingBee
Eis o custo do ScrapingBee em 2026:
| Plano | Preço | Ideal para |
|---|---|---|
| Freelance | US$ 49/mês | Desenvolvedores individuais e projetos pequenos |
| Comece | US$ 99/mês | Equipes em crescimento escalando solicitações de API |
| Negócios | US$ 249/mês | Cargas de trabalho de extração de dados da web em grande volume |
| Negócios+ | US$ 599/mês | Equipes empresariais em máquinas remotas |
Teste grátis: Sim — 1000 chamadas de API gratuitas, sem necessidade de cartão de crédito.
Garantia de reembolso: Cancele quando quiser; a cobrança é mensal, sem fidelização.
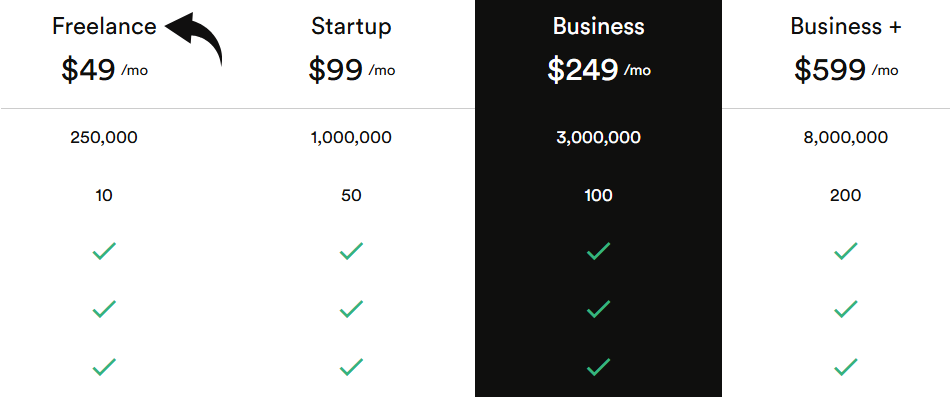
💰 Melhor custo-benefício: Startup — o melhor equilíbrio entre crédito de API e preço para a maioria das equipes.
ScrapingBee vs. Alternativas
Como o ScrapingBee se compara? Aqui está o panorama da concorrência:
Veja esta comparação:
| Ferramenta | Ideal para | Preço | Avaliação |
|---|---|---|---|
| ScrapingBee | Renderização de JavaScript por meio de uma API REST | US$ 49/mês | ⭐ 4,5 |
| Apify | atores de raspagem prontos | Varia | ⭐ — |
| ScrapeGraphAI | regras de extração orientadas por IA | Varia | ⭐ — |
| Dados brilhantes | IPs de proxy corporativo | Varia | ⭐ — |
| Navegar IA | Aponte e clique sem código | Varia | ⭐ — |
| Oxylabs | Proxies empresariais premium | Varia | ⭐ — |
| ThorData | Rede proxy de orçamento | Varia | ⭐ — |
| Zyte | API de extração de dados para desenvolvedores | Varia | ⭐ — |
| Webscraper.io | captura de extensão do navegador | Varia | ⭐ — |
| Raspador de Hélio | Mapeamento do site para desktop | Varia | ⭐ — |
| Firecrawl | Markdown pronto para LLM | Varia | ⭐ — |
Escolhas rápidas:
- Melhor no geral: ScrapingBee — uma API REST para renderização, busca e capturas de tela.
- Melhor orçamento: ThorData — IPs de proxy baratos para fins simples de raspagem de dados.
- Ideal para iniciantes: Navegue pela IA — sem necessidade de código ou linguagem de programação.
- Melhor opção para empresas: Bright Data — desenvolvido para operações de extração de dados em larga escala e em conformidade com as normas.
🎯 Alternativas ao ScrapingBee
Procurando alternativas ao ScrapingBee? Aqui estão as melhores opções:
- 🚀 Apify: Uma plataforma completa de scraping com atores prontos para uso e um generoso plano gratuito para testar ideias rapidamente.
- 🧠 ScrapeGraphAI: Um scraper com inteligência artificial que transforma prompts simples em regras de extração para informações estruturadas complexas.
- 🏢 Dados brilhantes: IPs de proxy e conjuntos de dados de nível empresarial, criados para operações de extração de dados em larga escala e com requisitos de conformidade rigorosos.
- 👶 Navegar na IA: Uma ferramenta sem código que registra seus cliques para criar scrapers sem escrever uma única linha de código.
- 🔒 Oxylabs: Um provedor de API premium para proxy e scraping, com alta confiabilidade para cargas de trabalho empresariais exigentes.
- 💰 ThorData: Uma rede de proxies econômica que abrange IPs de proxy residenciais e de data center para tarefas de coleta de dados do dia a dia.
- 🔧 Zyte: Uma API de scraping voltada para desenvolvedores, anteriormente conhecida como Scrapinghub, com gerenciamento inteligente de bloqueios e código-fonte limpo.
- 🎨 Webscraper.io: Uma extensão para navegador que cria sitemaps visualmente dentro do Chrome para captura de dados com um simples clique.
- 💼 Raspador de hélio: Um aplicativo para desktop Windows que extrai dados de sites complexos sem depender da nuvem.
- ⚡ Firecrawl: Um rastreador de IA que converte sites inteiros em Markdown limpo para alimentar grandes modelos de linguagem.
Para ver a lista completa, consulte nosso Alternativas ao ScrapingBee guia.
⚔️ Comparação do ScrapingBee
Veja como o ScrapingBee se compara a cada concorrente:
- ScrapingBee vs Apify: A Apify oferece um mercado de scrapers; a ScrapingBee se destaca pelo acesso simplificado à API REST e pela configuração mais rápida.
- ScrapingBee vs ScrapeGraphAI: O ScrapeGraphAI depende totalmente de IA; o ScrapingBee oferece extração por IA e seletores CSS brutos.
- ScrapingBee vs Bright Data: A Bright Data é escalável para empresas; a ScrapingBee é mais barata e simples para equipes pequenas e médias.
- ScrapingBee vs Browse AI: O Browse AI é ideal para quem não programa; o ScrapingBee é perfeito para desenvolvedores que desejam uma API REST e controle total.
- ScrapingBee vs Oxylabs: A Oxylabs tem como alvo grandes empresas; a ScrapingBee oferece preços de entrada mais baixos e uma curva de aprendizado mais fácil.
- ScrapingBee vs ThorData: A ThorData compete com base no preço dos serviços de proxy; a ScrapingBee reúne renderização, capturas de tela e IA em uma única API.
- ScrapingBee vs Zyte: O Zyte tem raízes profundas no desenvolvimento de software; o ScrapingBee é mais amigável para projetos rápidos e equipes pequenas.
- ScrapingBee vs Webscraper.io: O Webscraper.io funciona no navegador; o ScrapingBee lida com a renderização de javascript no lado do servidor em escala real.
- ScrapingBee vs Raspador de Hélio: O Helium Scraper funciona apenas em desktops; o ScrapingBee roda na nuvem, dispensando completamente os drivers da web.
- ScrapingBee vs Firecrawl: O Firecrawl tem como alvo pipelines LLM; o ScrapingBee abrange a extração de dados de forma mais ampla, com capturas de tela e APIs de pesquisa.
Comece a usar o ScrapingBee agora mesmo
Você aprendeu a usar todos os principais recursos do ScrapingBee:
- ✅ Extração de dados da Web com IA
- ✅ API de pesquisa do Google
- ✅ Extrator de dados do Google Shopping
- ✅ Web Scraping em JavaScript
- ✅ Extrator de dados ChatGPT
- ✅ API de Extração de Notícias do Google
- ✅ Extração rápida de dados
- ✅ API de captura de tela programática
- ✅ Extrair dados do Google Jobs
Próximo passo: Escolha uma funcionalidade e experimente agora mesmo.
A maioria das pessoas começa com Web Scraping com IA.
Um primeiro projeto popular é a criação de um programa para extrair anúncios do OLX.
Durante o desenvolvimento, o ScrapingBee executa o navegador em máquinas remotas para você.
Explore mais funcionalidades assim que seu primeiro scraper do OLX estiver funcionando.
Leva menos de cinco minutos para extrair dados da sua primeira página.
Perguntas frequentes
Como funciona o ScrapingBee?
O ScrapingBee é uma ferramenta de extração de dados baseada na nuvem. Você envia uma solicitação com sua chave de API e uma URL, e ele retorna a página usando navegadores sem interface gráfica, enquanto alterna os proxies para você.
Qual o preço do ScrapingBee?
Os planos começam em US$ 49/mês para Freelance, seguidos por US$ 99 para Startup, US$ 249 para Business e US$ 599 para Business+. Um período de teste gratuito oferece 1000 chamadas de API para testes de extração de dados.
Extrair dados da web é ilegal?
Extrair dados de páginas web públicas geralmente é legal. Sempre verifique o arquivo robots.txt e os termos de uso de um site primeiro, evite coletar dados pessoais e respeite os limites de taxa para garantir sua segurança.
O ScrapingBee suporta renderização em JavaScript?
Sim. Defina `render_js=true` e o ScrapingBee carregará páginas da web em navegadores sem interface gráfica. Essa renderização em JavaScript funciona imediatamente em sites criados com React ou Vue.
Quais linguagens de programação o ScrapingBee suporta?
Qualquer. O ScrapingBee é uma API REST, então você pode chamá-la a partir de Python, Node, PHP ou qualquer outra linguagem. Em Python, basta importar a biblioteca requests e enviar suas requisições à API.













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
