
Snelstart
Deze handleiding voor het gebruik van ScrapingBee behandelt alle functies:
- Aan de slag — Maak een account aan en ontvang je API-sleutel
- Hoe AI-webscraping te gebruiken — Complexe, gestructureerde informatie van webpagina's halen en deze in begrijpelijke taal weergeven
- Hoe gebruik je de Google Search API? — Schraap Google-zoekresultaten zonder zelf proxy-IP's te hoeven beheren
- Hoe gebruik je de Google Shopping Scraper? — verzamel productvermeldingen en de bijbehorende prijs voor elke zoekterm
- Hoe gebruik je JavaScript voor webscraping? — Verwerk de weergave van JavaScript op webpagina's die zijn gebouwd met React of Vue
- Hoe gebruik je de ChatGPT-scraper? — Leg reacties en paginabron vast van dynamische AI-chatpagina's
- Hoe gebruik je de Google News Scraper API? — Haal koppen en volledige artikelen op via eenvoudige API-verzoeken
- Hoe gebruik je Fast Data Scraping? — Voer snelle data-scraping uit terwijl ScrapingBee de proxy's voor je wisselt.
- Hoe gebruik je de Programmatic Screenshot API? — maak programmatisch een schermafbeelding van de volledige pagina van een willekeurige URL
- Hoe je Google Jobs kunt scrapen — vacatures verzamelen als complexe, gestructureerde informatie
Benodigde tijd: 5 minuten per film
Ook in deze handleiding: Professionele tips | Veelgemaakte fouten | Probleemoplossing | Prijzen | Alternatieven
Waarom zou je deze gids vertrouwen?
Ik gebruik ScrapingBee al meer dan een jaar en heb alle functies getest. Deze handleiding is gebaseerd op mijn eigen ervaringen met scraping, niet op screenshots van leveranciers.

ScrapingBee is een cloudgebaseerd platform. schraapgereedschap dat de lastige onderdelen van webscraping voor u afhandelt.
Het beheert headless browsers en wisselt automatisch tussen proxy's.
Deze handleiding laat je stap voor stap zien hoe je alle belangrijke functies kunt gebruiken.
Met screenshots, een eenvoudig voorbeeld en professionele tips.
ScrapingBee-handleiding
Deze complete ScrapingBee-handleiding leidt je door alle functies, van je eerste API-verzoek tot geavanceerde JavaScript-scenario's.
Schraperbij
Schraap elke website zonder proxy-IP's of headless browsers te hoeven beheren. ScrapingBee verzorgt de JavaScript-rendering via één simpele REST API. Begin met 1000 gratis API-aanroepen – geen creditcard nodig.
Aan de slag met ScrapingBee
Voordat u een functie kunt gebruiken, moet u deze eenmalige installatie voltooien.
Het duurt ongeveer drie minuten.
Hier volgt een kort overzicht van de workflow:
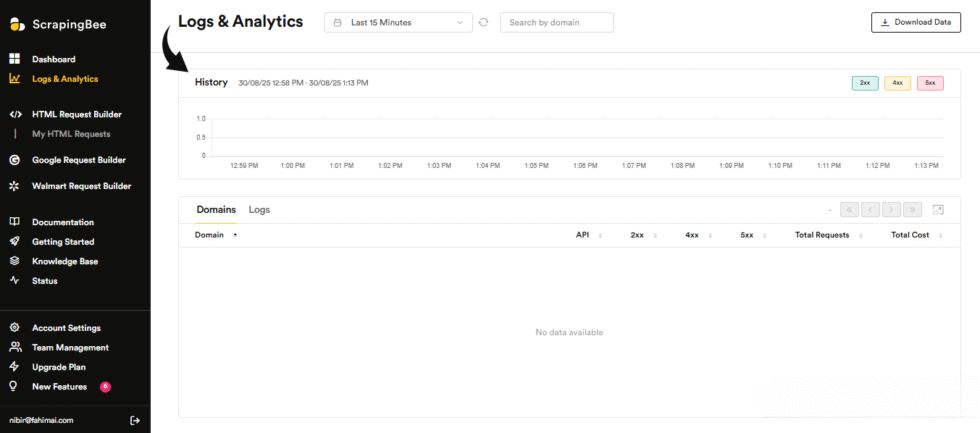
Laten we nu elke stap eens doornemen.
Stap 1: Maak uw account aan
Ga naar de ScrapingBee-website en klik op 'Aanmelden'.
Voer de promotiecode ADNAN in via de verwijzingslink voor extra API-tegoed.
✓ Controlepunt: Op je dashboard zie je je unieke API-sleutel.
Stap 2: Stel je code in
In Python kun je `pip install scrapingbee` uitvoeren of `import requests` importeren.
Met de requests-bibliotheek kun je de API vanuit elke programmeertaal aanroepen.
✓ Controlepunt: Je omgeving is klaar om API-verzoeken te verzenden.
Stap 3: Maak je eerste telefoongesprek
Stuur een verzoek naar het eindpunt https://app.scrapingbee.com/api/v1/ met uw API-sleutel en URL.
Met dit eenvoudige voorbeeld kunt u webpagina's scrapen met slechts een paar regels code.
✅ Klaar: Je bent klaar om een van de onderstaande functies te gebruiken.
Hoe ScrapingBee AI webscraping te gebruiken
AI-webscraping Hiermee kunt u complexe, gestructureerde informatie van webpagina's ophalen met behulp van eenvoudige taal.
Hieronder leggen we stap voor stap uit hoe je het gebruikt.
Stap 1: Verkrijg uw API-sleutel
Meld je aan en kopieer je API-sleutel vanuit het dashboard.
Step 2: Describe the Data
Voeg de doel-URL toe en schrijf een zoekopdracht in begrijpelijke taal.
Zo ziet het eruit:
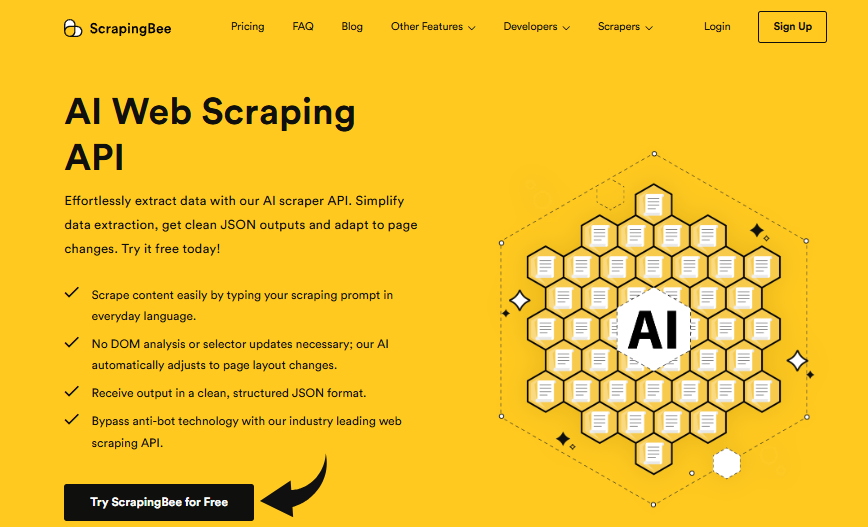
✓ Controlepunt: Er verschijnt een overzichtelijk JSON-object met uw velden.
Stap 3: Extractieregels instellen
Pas uw extractieregels aan om elk veld exact vast te leggen.
✅ Resultaat: Gestructureerde JSON zonder handmatig CSS-selectors te hoeven schrijven.
💡 Pro-tip: Combineer AI-extractie met CSS-selectors wanneer je nauwkeurige controle nodig hebt.
Hoe gebruik je de ScrapingBee Google Search API?
Google Search API Hiermee kunt u Google-zoekresultaten scrapen zonder zelf proxy-IP-adressen te hoeven beheren.
Hieronder leggen we stap voor stap uit hoe je het gebruikt.
Stap 1: Kies het eindpunt
Richt je verzoek aan de Google Search API.
Stap 2: Stel de query in
Voeg uw zoekwoord en een willekeurig land toe voor lokale resultaten.
Zo ziet het eruit:
✓ Controlepunt: De gerangschikte resultaten worden als gestructureerde data geretourneerd.
Stap 3: Lees de JSON
Verwerk het antwoord met de `requests`-bibliotheek in Python.
✅ Resultaat: Zoek gegevens met één simpele REST API-aanroep.
💡 Pro-tip: Gebruik de landcode voor premium proxy-geolocatie bij elke zoekopdracht.
Hoe gebruik je de ScrapingBee Google Shopping-scraper?
Google Shopping Scraper Hiermee kunt u productvermeldingen en de bijbehorende prijs voor elke zoekterm verzamelen.
Hieronder leggen we stap voor stap uit hoe je het gebruikt.
Stap 1: Een winkelverzoek versturen
Roep het shopping-eindpunt aan met uw productaanvraag.
Stap 2: Het antwoord parseren
Koppel elke vermelding aan de titel, link en de weergegeven prijs.
Zo ziet het eruit:
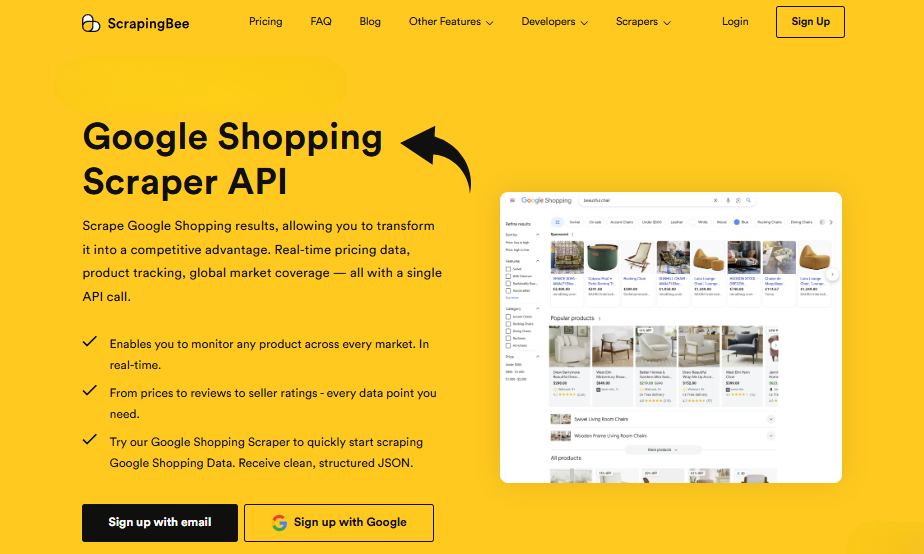
✓ Controlepunt: De productrijen worden als schone JSON geretourneerd.
Stap 3: Exporteer de resultaten
Sla de gegevens op als CSV-bestand voor verdere analyse.
✅ Resultaat: Actuele prijsgegevens, direct te gebruiken in elke spreadsheet.
💡 Pro-tip: Plan runs in om de geëxtraheerde prijs in de loop van de tijd te volgen.
Hoe ScrapingBee te gebruiken voor JavaScript-webscraping
JavaScript webscraping Hiermee kun je de weergave van JavaScript op webpagina's die met React of Vue zijn gebouwd, beheren.
Hieronder leggen we stap voor stap uit hoe je het gebruikt.
Stap 1: Schakel render_js in
Stel render_js=true in zodat ScrapingBee headless browsers gebruikt.
Stap 2: Wacht op een element
Geef de opdracht om te wachten tot een bepaald element is geladen.
Zo ziet het eruit:
✓ Controlepunt: De volledige pagina wordt weergegeven vóór extractie.
Stap 3: Leg de HTML vast
Geef na het renderen de originele HTML of de onbewerkte paginabron terug.
✅ Resultaat: Volledig gerenderde webpagina's zonder dat er webstuurprogramma's beheerd hoeven te worden.
💡 Pro-tip: Voeg een JavaScript-scenario toe voor klikken, scrollen of het invullen van formulieren.
Hoe gebruik je de ScrapingBee ChatGPT-scraper?
ChatGPT Schraper Hiermee kun je reacties en paginabrongegevens vastleggen van dynamische AI-chatpagina's.
Hieronder leggen we stap voor stap uit hoe je het gebruikt.
Stap 1: Selecteer de pagina
Stuur de pagina-URL met render_js ingeschakeld.
Stap 2: Renderen en extraheren
Laat headless scraping het antwoord laden en pak het vervolgens op. tekst.
Zo ziet het eruit:
✓ Controlepunt: Het gegenereerde antwoord wordt weergegeven in de broncode van de pagina.
Stap 3: Sla de uitvoer op
Sla de geparseerde HTML op voor latere verwerking.
✅ Resultaat: Schone tekst afkomstig van een volledig dynamische pagina.
💡 Pro-tip: Koppel een JavaScript-scenario aan een reeks stappen om door prompts te navigeren.
Hoe gebruik je de ScrapingBee Google News Scraper API?
Google News Scraper API Hiermee kun je via eenvoudige API-verzoeken koppen en volledige artikelen ophalen.
Hieronder leggen we stap voor stap uit hoe je het gebruikt.
Stap 1: Stel het nieuws-eindpunt in.
Richt je verzoek aan de Google News API.
Stap 2: Filters toevoegen
Filter op onderwerp, taal of willekeurig land.
Zo ziet het eruit:
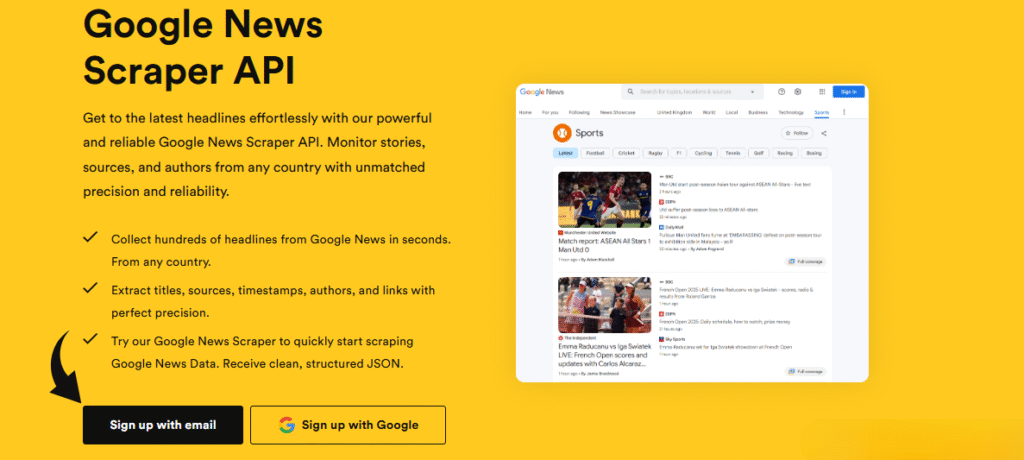
✓ Controlepunt: Overeenkomende krantenkoppen worden als gestructureerde data geretourneerd.
Stap 3: Artikelen verzamelen
Doorloop de resultaten om elk verhaal te verzamelen.
✅ Resultaat: Actuele nieuwsgegevens rechtstreeks van de ScrapingBee API.
💡 Pro-tip: Draai de landcode om de regionale dekking te vergelijken.
Hoe gebruik je ScrapingBee voor snel data scrapen?
Snel gegevens verzamelen Hiermee kunt u snel gegevens verzamelen terwijl ScrapingBee de proxy's voor u roteert.
Hieronder leggen we stap voor stap uit hoe je het gebruikt.
Stap 1: Stel uw verzoek samen
Stel de URL, API-sleutel en parameters één keer samen.
Stap 2: Gelijktijdige aanroepen uitvoeren
Verstuur meerdere API-verzoeken tegelijk.
Zo ziet het eruit:
✓ Controlepunt: De reacties stromen parallel terug.
Stap 3: Controleer de statuscodes
Controleer of elke geretourneerde statuscode een HTTP-code 200 heeft.
✅ Resultaat: High-volume scraping handled on remote machines.
💡 Pro-tip: ThreadPoolExecutor versnelt het scrapen van webpagina's aanzienlijk.
Hoe gebruik je de ScrapingBee Programmatic Screenshot API?
Programmatische screenshot-API Hiermee kunt u programmatisch een volledige paginascreenshot maken van elke URL.
Hieronder leggen we stap voor stap uit hoe je het gebruikt.
Stap 1: Voeg de schermafbeeldingvlag toe
Voeg screenshot=true toe aan je API-verzoek.
Stap 2: Kies 'Volledige pagina'
Stel full_page=true in om de volledige lay-out vast te leggen.
Zo ziet het eruit:
✓ Controlepunt: Een afbeelding die de hele pagina vult, wordt van rand tot rand weergegeven.
Stap 3: Download de afbeelding
Sla het geretourneerde bestand op de schijf op.
✅ Resultaat: Pixelperfecte opnames, op aanvraag gegenereerd.
💡 Pro-tip: De parameter full_page zorgt ervoor dat de hele pagina eerst wordt weergegeven.
Hoe je ScrapingBee gebruikt om vacatures van Google te schrapen
Schraap vacatures van Google Jobs Hiermee kunt u vacatures verzamelen als complexe, gestructureerde informatie.
Hieronder leggen we stap voor stap uit hoe je het gebruikt.
Stap 1: Roep het Jobs-eindpunt aan.
Stuur je functie en locatie naar de vacature-API.
Stap 2: Filter de advertenties
Verfijn de resultaten op titel, bedrijf of stad.
Zo ziet het eruit:
✓ Controlepunt: De rijen met de taakgegevens worden als schone JSON geretourneerd.
Stap 3: De gegevens structureren
Zet HTML-velden om in een overzichtelijke tabel.
✅ Resultaat: Jobgegevens zijn klaar om te worden verwerkt en opgeslagen.
💡 Pro-tip: Combineer met CSS-selectors om aangepaste velden op te halen.
ScrapingBee Pro-tips en sneltoetsen
Na ScrapingBee meer dan een jaar te hebben getest, deel ik hier mijn beste tips voor het scrapen van websites.
Belangrijke API-parameters
| Parameter | Wat het doet |
|---|---|
| render_js | Geeft JavaScript weer in headless browsers. |
| premium_proxy | Schakelt over naar residentiële proxy-IP-adressen. |
| landcode | Stelt de geolocatie van de premium proxy in op basis van een willekeurig land. |
| block_ads | Hiermee kun je advertenties blokkeren om verzoeken te versnellen. |
Verborgen functies die de meeste mensen over het hoofd zien
- sessie-ID: API-verzoeken worden gedurende vijf minuten via hetzelfde IP-adres geleid, zodat dezelfde HTTP-code en sessie behouden blijven.
- return_page_source: Geeft de originele HTML en de volledige paginabron terug voordat er JavaScript wordt uitgevoerd.
- Aangepaste headers en cookies: Verstuur je eigen aangepaste headers en cookies, of gebruik de standaardheaders die ScrapingBee genereert.
- Koptekstbesturing: Vervang een bestaande koptekst door een nieuwe, toon de automatisch gegenereerde kopteksten en behoud vervolgens alleen bepaalde kopteksten en verwijder de overige.
Veelvoorkomende fouten bij ScrapingBee die je moet vermijden
Fout nr. 1: Het negeren van robots.txt voordat je gaat scrapen.
❌ Fout: Verzoeken versturen naar elke site die je wilt scrapen, zonder eerst de regels te controleren.
✅ Rechts: Controleer het robots.txt-bestand en de gebruiksvoorwaarden voordat je webpagina's scrapt.
Fout nr. 2: Vergeten JavaScript-rendering in te schakelen
❌ Fout: Ik verwacht dynamische content, maar krijg telkens een lege paginabron te zien.
✅ Rechts: Stel render_js=true in, zodat headless browsers eerst de volledige pagina laden.
Fout nr. 3: Alleen de standaardheaders verzenden
❌ Fout: Door uitsluitend te vertrouwen op standaard headers, worden deze door sommige sites als verdacht aangemerkt en geblokkeerd.
✅ Rechts: Verstuur je eigen aangepaste headers en een echte user agent-parameter wanneer je gegevens wilt scrapen.
Probleemoplossing voor ScrapingBee
Probleem: Lege of gedeeltelijke paginabron
Oorzaak: De JavaScript-code op de pagina werd niet weergegeven, waardoor de HTML-pagina leeg bleef.
Repareren: Stel render_js=true in en wacht tot een specifiek element de volledige pagina heeft geladen.
Problem: Requests keep getting blocked
Oorzaak: De IP-adressen van de standaard datacenterproxy werden door de doelsite als verdacht aangemerkt.
Repareren: Schakel premium proxies in om een nieuw IP-adres uit een willekeurig land te verkrijgen.
Probleem: Je ziet een HTTP-code 401 of 403.
Oorzaak: Je API-sleutel is onjuist of je hebt geen API-tegoed meer.
Repareren: Bevestig de API-sleutel, controleer je statuscode en vul je tegoed aan indien nodig.
📌 Opmerking: Als geen van deze oplossingen uw probleem verhelpt, neem dan contact op met de supportafdeling van ScrapingBee.
Wat is ScrapingBee?
Schraperbij is een cloudgebaseerde scrapingtool die headless browsers ondersteunt en automatisch proxy's voor je roteert.
Zie het als een gehoste browser die je via een REST API beheert.
Bekijk dit korte overzicht:
Het omvat de volgende belangrijke kenmerken:
- AI-webscraping: Hiermee kunt u complexe, gestructureerde informatie van webpagina's ophalen met behulp van eenvoudige taal.
- Google Search API: Hiermee kunt u Google-zoekresultaten scrapen zonder zelf proxy-IP-adressen te hoeven beheren.
- Google Shopping-scraper: Hiermee kunt u productvermeldingen en de bijbehorende prijs voor elke zoekterm verzamelen.
- JavaScript-webscraping: Hiermee kun je de weergave van JavaScript op webpagina's die met React of Vue zijn gebouwd, beheren.
- ChatGPT-scraper: Hiermee kunt u reacties en paginabrongegevens vastleggen van dynamische AI-chatpagina's.
- Google News Scraper API: Hiermee kunt u via eenvoudige API-verzoeken koppen en volledige artikelen ophalen.
- Snel gegevens verzamelen: Hiermee kunt u snel gegevens verzamelen terwijl ScrapingBee de proxy's voor u wisselt.
- Programmatische screenshot-API: Hiermee kunt u programmatisch een volledige schermafbeelding van elke URL maken.
- Google Jobs scrapen: Hiermee kunt u vacatures verzamelen als complexe, gestructureerde informatie.
Voor een volledige recensie, zie onze ScrapingBee recensie.
ScrapingBee-prijzen
Dit zijn de kosten van ScrapingBee in 2026:
| Plan | Prijs | Het beste voor |
|---|---|---|
| Freelance | $49/maand | Solo-ontwikkelaars en kleine projecten |
| Start-up | $99/maand | Groeiende teams schalen API-aanvragen op |
| Bedrijf | $249/maand | Webscraping-workloads met een hoog volume |
| Zakelijk+ | $599/maand | Bedrijfsteams werken op afstand. |
Gratis proefperiode: Ja, 1000 gratis API-aanroepen, geen creditcard vereist.
Geld-terug-garantie: U kunt op elk moment opzeggen; de facturering is maandelijks zonder contractverplichting.
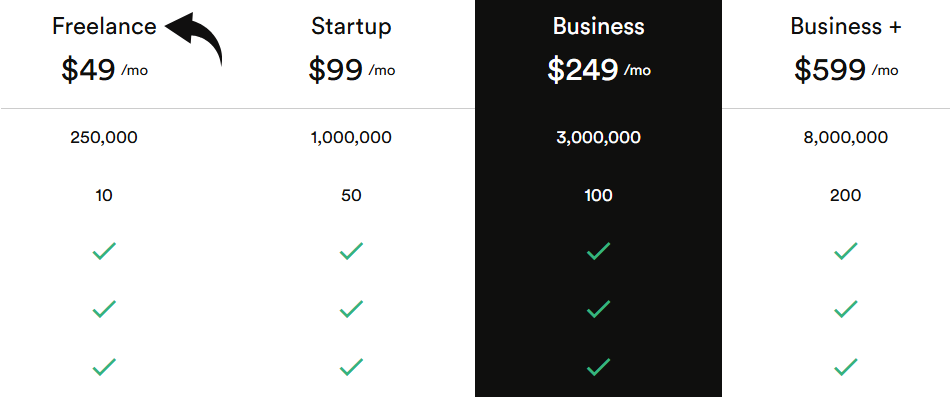
💰 Beste prijs-kwaliteitverhouding: Startup — de beste balans tussen API-tegoed en prijs voor de meeste teams.
ScrapingBee versus alternatieven
Hoe verhoudt ScrapingBee zich tot de concurrentie? Hier volgt een overzicht van de concurrenten:
Bekijk deze vergelijking:
| Hulpmiddel | Het beste voor | Prijs | Beoordeling |
|---|---|---|---|
| Schraperbij | JavaScript-rendering via één REST API | $49/maand | ⭐ 4,5 |
| Apify | Kant-en-klare scraper-acteurs | Variabel | ⭐ — |
| ScrapeGraphAI | AI-gestuurde extractieregels | Variabel | ⭐ — |
| Bright Data | IP-adressen van bedrijfsproxy's | Variabel | ⭐ — |
| Bladeren AI | Geen code nodig, aanwijzen en klikken. | Variabel | ⭐ — |
| Oxylabs | Premium bedrijfsproxy's | Variabel | ⭐ — |
| ThorData | Budget proxy netwerk | Variabel | ⭐ — |
| Zyte | Developer scraping API | Variabel | ⭐ — |
| Webscraper.io | Browser-extensie vastleggen | Variabel | ⭐ — |
| Heliumschraper | Desktop-site-mapping | Variabel | ⭐ — |
| Brandweerkruipen | Markdown geschikt voor LLM-opleidingen | Variabel | ⭐ — |
Snelle keuzes:
- Beste overall: ScrapingBee — één REST API voor rendering, zoeken en screenshots.
- Beste budget: ThorData — goedkope proxy-IP's voor eenvoudige webscraping.
- Het meest geschikt voor beginners: Browse AI — geen code of programmeertaal nodig.
- Het meest geschikt voor bedrijven: Bright Data — ontwikkeld voor grootschalige, conforme scraping-operaties.
🎯 Alternatieven voor ScrapingBee
Op zoek naar alternatieven voor ScrapingBee? Dit zijn de beste opties:
- 🚀 Apify: Een compleet scrapingplatform met kant-en-klare actors en een royale gratis versie om ideeën snel te testen.
- 🧠 ScrapeGraphAI: Een AI-gedreven scraper die eenvoudige prompts omzet in extractieregels voor complexe, gestructureerde informatie.
- 🏢 Heldere gegevens: Proxy-IP-adressen en datasets van enterprise-kwaliteit, speciaal ontworpen voor zeer grootschalige scraping-operaties en strikte naleving van regelgeving.
- 👶 Blader door AI: Een no-code tool die je muisklikken registreert om webscrapers te bouwen zonder code te schrijven.
- 🔒 Oxylabs: Een hoogwaardige proxy- en scraper-API-provider met een hoge betrouwbaarheid voor veeleisende bedrijfsworkloads.
- 💰 ThorData: Een budgetvriendelijk proxynetwerk met IP-adressen van zowel particuliere gebruikers als datacenters voor dagelijkse webscrapingtaken.
- 🔧 Zyte: Een scraping-API gericht op ontwikkelaars, voorheen Scrapinghub, met slimme afhandeling van blokkeringen en een schone paginabroncode.
- 🎨 Webscraper.io: Een browserextensie voor het visueel genereren van sitemaps in Chrome, waarmee gegevens met een muisklik kunnen worden vastgelegd.
- 💼 Heliumschraper: Een desktop-scraping-app voor Windows die complexe websites in kaart brengt zonder afhankelijkheid van de cloud.
- ⚡ Firecrawl: Een AI-crawler die complete websites omzet in overzichtelijke markdown voor gebruik met grote taalmodellen.
Voor de volledige lijst, zie onze Alternatieven voor ScrapingBee gids.
⚔️ ScrapingBee vergeleken
Hieronder een vergelijking van ScrapingBee met de concurrenten:
- ScrapingBee versus Apify: Apify biedt een marktplaats voor webscrapers; ScrapingBee wint het op het gebied van eenvoudige REST API-toegang en snellere installatie.
- ScrapingBee versus ScrapeGraphAI: ScrapeGraphAI is volledig gebaseerd op AI; ScrapingBee biedt zowel AI-extractie als pure CSS-selectors.
- ScrapingBee versus Bright Data: Bright Data is geschikt voor grote bedrijven; ScrapingBee is goedkoper en eenvoudiger voor kleine tot middelgrote teams.
- ScrapingBee versus Browse AI: Browse AI is geschikt voor mensen zonder programmeerkennis; ScrapingBee is meer geschikt voor ontwikkelaars die een REST API en volledige controle willen.
- ScrapingBee versus Oxylabs: Oxylabs richt zich op grote bedrijven; ScrapingBee biedt lagere instapprijzen en een eenvoudigere leercurve.
- ScrapingBee versus ThorData: ThorData concurreert op proxy-prijs; ScrapingBee bundelt rendering, screenshots en AI in één API.
- ScrapingBee versus Zyte: Zyte heeft diepe wortels in de ontwikkelaarswereld; ScrapingBee is gebruiksvriendelijker voor snelle projecten en kleine teams.
- ScrapingBee versus Webscraper.io: Webscraper.io draait in de browser; ScrapingBee verzorgt de JavaScript-rendering aan de serverzijde op grote schaal.
- ScrapingBee versus Helium Scraper: Helium Scraper is alleen voor desktopgebruik; ScrapingBee draait in de cloud, waardoor je webstuurprogramma's volledig overslaat.
- ScrapingBee versus Firecrawl: Firecrawl richt zich op LLM-pipelines; ScrapingBee bestrijkt een breder scala aan scraping-mogelijkheden met screenshots en zoek-API's.
Begin nu met het gebruik van ScrapingBee.
Je hebt geleerd hoe je alle belangrijke functies van ScrapingBee kunt gebruiken:
- ✅ AI-webscraping
- ✅ Google Zoek-API
- ✅ Google Shopping Scraper
- ✅ JavaScript-webscraping
- ✅ ChatGPT-scraper
- ✅ Google News Scraper API
- ✅ Snelle data-scraping
- ✅ Programmatische screenshot-API
- ✅ Google Jobs scrapen
Volgende stap: Kies één functie en probeer die nu uit.
De meeste mensen beginnen met webscraping met behulp van AI.
Een populair eerste project is het maken van een OLX-scraper om advertenties op te halen.
Tijdens de ontwikkelingsfase voert ScrapingBee de browser voor u uit op externe machines.
Ontdek meer functies zodra je eerste OLX-scraper werkt.
Het duurt minder dan vijf minuten om je eerste pagina te scrapen.
Veelgestelde vragen
Hoe werkt ScrapingBee?
ScrapingBee is een cloudgebaseerde webscrapingtool. Je stuurt een verzoek met je API-sleutel en een URL, en de tool retourneert de pagina met behulp van headless browsers, terwijl hij automatisch proxy's voor je wisselt.
Wat zijn de kosten van ScrapingBee?
De abonnementen beginnen bij $49 per maand voor Freelance, daarna $99 voor Startup, $249 voor Business en $599 voor Business+. Met een gratis proefperiode krijg je 1000 API-aanroepen om de scraping-functionaliteit te testen.
Is webscraping illegaal?
Het scrapen van openbare webpagina's is over het algemeen legaal. Controleer altijd eerst het robots.txt-bestand en de gebruiksvoorwaarden van een site, vermijd het verzamelen van persoonlijke gegevens en respecteer de limieten voor het aantal aanvragen om aan de veilige kant te blijven.
Ondersteunt ScrapingBee JavaScript-rendering?
Ja. Stel render_js=true in en ScrapingBee laadt webpagina's in headless browsers. Deze JavaScript-rendering werkt direct op sites die gebouwd zijn met React of Vue.
Welke programmeertaal ondersteunt ScrapingBee?
ScrapingBee is een REST API, dus je kunt hem aanroepen vanuit Python, Node, PHP of elke andere programmeertaal. In Python hoef je alleen maar `requests` te importeren en je API-verzoeken te versturen.













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
