
Hướng dẫn nhanh
Hướng dẫn sử dụng ScrapingBee này bao gồm mọi tính năng:
- Bắt đầu — Tạo tài khoản và nhận mã API của bạn
- Cách sử dụng AI để thu thập dữ liệu web — Trích xuất thông tin có cấu trúc phức tạp từ các trang web bằng ngôn ngữ đơn giản.
- Cách sử dụng API tìm kiếm của Google — Thu thập kết quả tìm kiếm của Google mà không cần tự quản lý địa chỉ IP proxy.
- Cách sử dụng công cụ trích xuất dữ liệu Google Shopping — Thu thập danh sách sản phẩm và giá đã trích xuất cho bất kỳ từ khóa tìm kiếm nào
- Cách sử dụng JavaScript để trích xuất dữ liệu từ web — Xử lý việc hiển thị JavaScript trên các trang web được xây dựng bằng React hoặc Vue
- Hướng dẫn sử dụng ChatGPT Scraper — Thu thập phản hồi và mã nguồn trang từ các trang trò chuyện AI động
- Hướng dẫn sử dụng API Google News Scraper — Trích xuất tiêu đề và bài viết đầy đủ thông qua các yêu cầu API đơn giản
- Cách sử dụng công cụ thu thập dữ liệu nhanh — Thực hiện thu thập dữ liệu nhanh chóng trong khi ScrapingBee tự động xoay vòng proxy cho bạn
- Hướng dẫn sử dụng API chụp ảnh màn hình lập trình — Chụp ảnh màn hình toàn trang của bất kỳ URL nào bằng lập trình.
- Hướng dẫn sử dụng công cụ Scrape Google Jobs — Thu thập danh sách việc làm dưới dạng thông tin có cấu trúc phức tạp
Thời gian cần thiết: 5 phút cho mỗi phim
Cũng trong hướng dẫn này: Mẹo chuyên nghiệp | Những lỗi thường gặp | Khắc phục sự cố | Chạy | Các lựa chọn thay thế
Tại sao nên tin tưởng hướng dẫn này?
Tôi đã sử dụng ScrapingBee hơn một năm và đã thử nghiệm mọi tính năng ở đây. Hướng dẫn này dựa trên kinh nghiệm thực tế khi thu thập dữ liệu, chứ không phải ảnh chụp màn hình của nhà cung cấp.

ScrapingBee là một dịch vụ dựa trên điện toán đám mây. công cụ cạo Nó xử lý những phần khó khăn trong việc thu thập dữ liệu từ web.
Nó quản lý các trình duyệt không giao diện người dùng và tự động xoay vòng máy chủ proxy cho bạn.
Hướng dẫn này sẽ chỉ cho bạn cách sử dụng từng tính năng chính một cách chi tiết từng bước.
Bài viết có kèm ảnh chụp màn hình, ví dụ đơn giản và những lời khuyên hữu ích.
Hướng dẫn sử dụng ScrapingBee
Hướng dẫn ScrapingBee đầy đủ này sẽ hướng dẫn bạn từng tính năng, từ yêu cầu API đầu tiên đến các thủ thuật JavaScript nâng cao.
ScrapingBee
Thu thập dữ liệu từ bất kỳ trang web nào mà không cần quản lý địa chỉ IP proxy hay trình duyệt không giao diện người dùng. ScrapingBee xử lý việc hiển thị JavaScript thông qua một API REST đơn giản. Nhận 1000 lượt gọi API miễn phí để bắt đầu — không cần thẻ tín dụng.
Hướng dẫn bắt đầu sử dụng ScrapingBee
Trước khi sử dụng bất kỳ tính năng nào, hãy hoàn tất thiết lập một lần này.
Quá trình này mất khoảng ba phút.
Dưới đây là tóm tắt nhanh về quy trình làm việc:
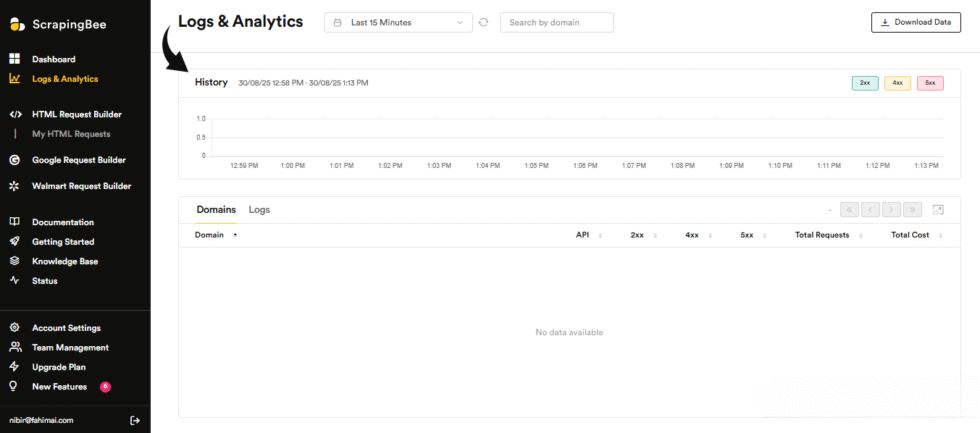
Bây giờ chúng ta hãy cùng xem xét từng bước một.
Bước 1: Tạo tài khoản của bạn
Hãy truy cập trang web ScrapingBee và nhấp vào "Đăng ký".
Nhập mã khuyến mãi ADNAN qua liên kết giới thiệu để nhận thêm điểm thưởng API.
✓ Điểm kiểm tra: Trang tổng quan hiển thị khóa API duy nhất của bạn.
Bước 2: Thiết lập mã của bạn
Trong Python, hãy chạy lệnh `pip install scrapingbee` hoặc chỉ cần nhập thư viện `requests`.
Thư viện requests cho phép bạn gọi API từ bất kỳ ngôn ngữ lập trình nào.
✓ Điểm kiểm tra: Môi trường của bạn đã sẵn sàng để gửi yêu cầu API.
Bước 3: Thực hiện cuộc gọi đầu tiên
Hãy gửi yêu cầu đến điểm cuối https://app.scrapingbee.com/api/v1/ với khóa API và URL của bạn.
Ví dụ đơn giản này cho phép bạn trích xuất dữ liệu từ các trang web chỉ với vài dòng mã hoàn chỉnh.
✅ Hoàn thành: Bạn đã sẵn sàng sử dụng bất kỳ tính năng nào bên dưới.
Hướng dẫn sử dụng ScrapingBee AI Web Scraping
Thu thập dữ liệu web bằng AI Cho phép bạn trích xuất thông tin có cấu trúc phức tạp từ các trang web bằng ngôn ngữ thông thường.
Dưới đây là hướng dẫn sử dụng từng bước.
Bước 1: Lấy mã API của bạn
Đăng ký và sao chép khóa API của bạn từ bảng điều khiển.
Bước 2: Mô tả dữ liệu
Thêm URL mục tiêu và viết truy vấn bằng ngôn ngữ dễ hiểu.
Đây là hình ảnh minh họa:
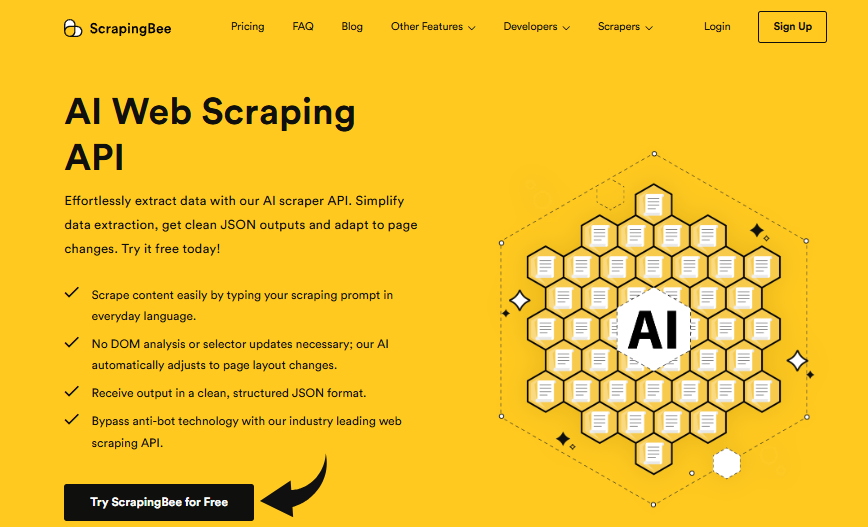
✓ Điểm kiểm tra: Một đối tượng JSON sạch sẽ xuất hiện với các trường thông tin của bạn.
Bước 3: Thiết lập quy tắc trích xuất
Hãy điều chỉnh các quy tắc trích xuất của bạn để thu thập chính xác từng trường dữ liệu.
✅ Kết quả: Tạo JSON có cấu trúc mà không cần tự viết các bộ chọn CSS.
💡 Mẹo hay: Kết hợp trích xuất AI với bộ chọn CSS khi bạn cần kiểm soát chính xác.
Hướng dẫn sử dụng API tìm kiếm Google của ScrapingBee
API tìm kiếm của Google Cho phép bạn thu thập kết quả tìm kiếm của Google mà không cần tự quản lý địa chỉ IP proxy.
Dưới đây là hướng dẫn sử dụng từng bước.
Bước 1: Chọn điểm cuối
Hãy hướng yêu cầu của bạn đến API Tìm kiếm của Google.
Bước 2: Thiết lập truy vấn
Thêm từ khóa và một quốc gia ngẫu nhiên để hiển thị kết quả tìm kiếm địa phương.
Đây là hình ảnh minh họa:
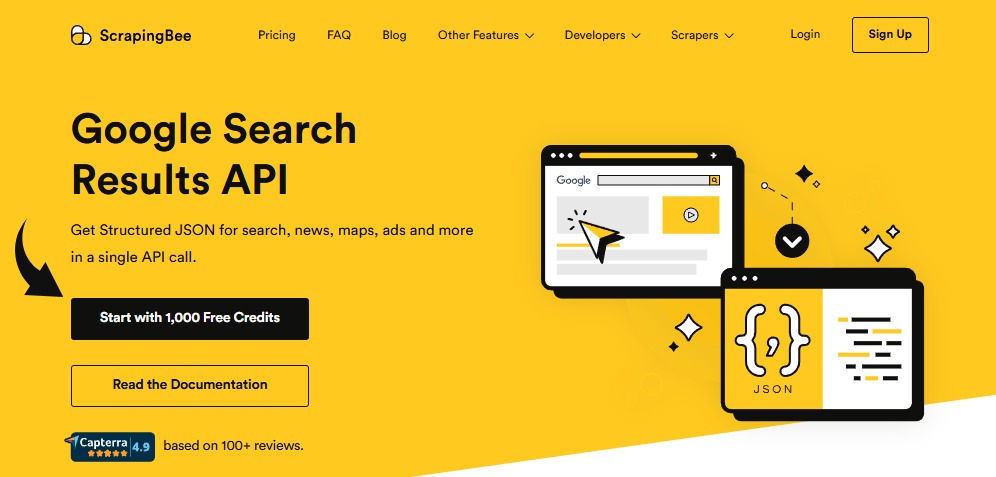
✓ Điểm kiểm tra: Kết quả xếp hạng được trả về dưới dạng dữ liệu có cấu trúc.
Bước 3: Đọc dữ liệu JSON
Phân tích phản hồi bằng thư viện requests trong Python.
✅ Kết quả: Tìm kiếm dữ liệu chỉ bằng một lệnh gọi API REST đơn giản.
💡 Mẹo hay: Hãy sử dụng country_code để định vị địa lý bằng proxy cao cấp trong mọi truy vấn.
Hướng dẫn sử dụng công cụ thu thập dữ liệu Google Shopping của ScrapingBee
Google Shopping Scraper Cho phép bạn thu thập danh sách sản phẩm và giá bán được trích xuất cho bất kỳ từ khóa tìm kiếm nào.
Dưới đây là hướng dẫn sử dụng từng bước.
Bước 1: Gửi yêu cầu mua hàng
Hãy gọi đến điểm cuối mua sắm với truy vấn sản phẩm của bạn.
Bước 2: Phân tích phản hồi
Hãy đối chiếu từng tin đăng với tiêu đề, liên kết và giá đã trích xuất.
Đây là hình ảnh minh họa:
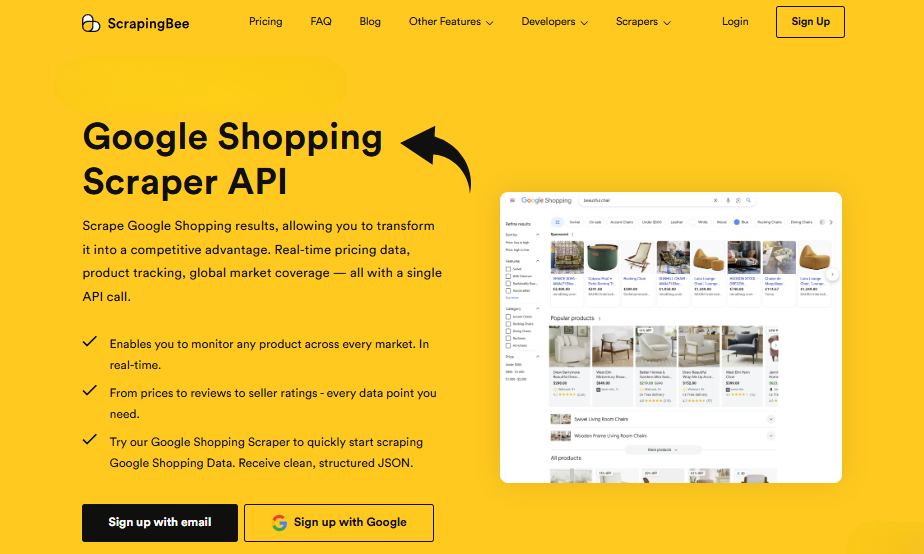
✓ Điểm kiểm tra: Các dòng sản phẩm được trả về dưới dạng JSON sạch.
Bước 3: Xuất kết quả
Lưu dữ liệu vào file CSV để phân tích thêm.
✅ Kết quả: Dữ liệu giá trực tiếp sẵn sàng cho bất kỳ bảng tính nào.
💡 Mẹo hay: Lên lịch chạy chương trình để theo dõi giá đã trích xuất theo thời gian.
Hướng dẫn sử dụng ScrapingBee JavaScript để thu thập dữ liệu web
Thu thập dữ liệu web bằng JavaScript Cho phép bạn xử lý việc hiển thị JavaScript trên các trang web được xây dựng bằng React hoặc Vue.
Dưới đây là hướng dẫn sử dụng từng bước.
Bước 1: Kích hoạt render_js
Đặt render_js=true để ScrapingBee sử dụng trình duyệt không giao diện người dùng (headless browser).
Bước 2: Chờ đợi một phần tử
Hãy yêu cầu nó chờ cho đến khi một phần tử cụ thể được tải xong.
Đây là hình ảnh minh họa:
✓ Điểm kiểm tra: Toàn bộ trang được hiển thị trước khi trích xuất.
Bước 3: Thu thập mã HTML
Trả về mã HTML gốc hoặc mã nguồn trang thô sau khi hiển thị.
✅ Kết quả: Các trang web được hiển thị hoàn chỉnh mà không cần quản lý trình điều khiển web.
💡 Mẹo hay: Thêm kịch bản JavaScript cho các thao tác nhấp chuột, cuộn trang hoặc điền biểu mẫu.
Hướng dẫn sử dụng công cụ thu thập dữ liệu ChatGPT của ScrapingBee
ChatGPT Sổ tay Cho phép bạn thu thập phản hồi và mã nguồn trang từ các trang trò chuyện động sử dụng trí tuệ nhân tạo.
Dưới đây là hướng dẫn sử dụng từng bước.
Bước 1: Chọn trang
Hãy gửi URL của trang với hàm render_js được bật.
Bước 2: Kết xuất và trích xuất
Hãy để công cụ headless scraping tải phản hồi, sau đó lấy thông tin. chữ.
Đây là hình ảnh minh họa:
✓ Điểm kiểm tra: Kết quả trả về được hiển thị trong mã nguồn trang.
Bước 3: Lưu kết quả
Lưu trữ mã HTML đã được phân tích cú pháp để xử lý sau này.
✅ Kết quả: Văn bản sạch được trích từ một trang hoàn toàn động.
💡 Mẹo hay: Kết hợp một kịch bản JavaScript để thực hiện các bước hướng dẫn phức tạp.
Hướng dẫn sử dụng API ScrapingBee Google News Scraper
API thu thập tin tức của Google Cho phép bạn lấy tiêu đề và toàn bộ bài viết thông qua các yêu cầu API đơn giản.
Dưới đây là hướng dẫn sử dụng từng bước.
Bước 1: Thiết lập điểm cuối tin tức
Hãy gửi yêu cầu của bạn đến API Tin tức của Google.
Bước 2: Thêm bộ lọc
Lọc theo chủ đề, ngôn ngữ hoặc quốc gia ngẫu nhiên.
Đây là hình ảnh minh họa:
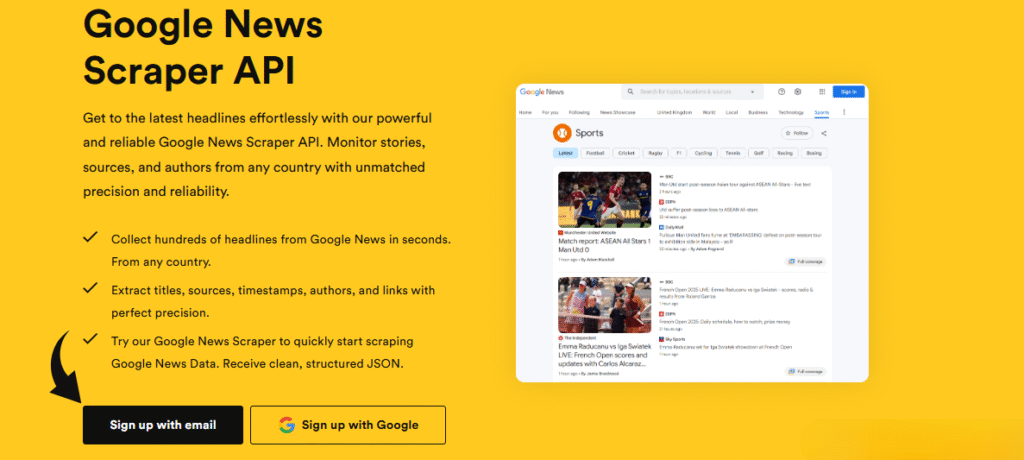
✓ Điểm kiểm tra: Các tiêu đề trùng khớp được trả về dưới dạng dữ liệu có cấu trúc.
Bước 3: Thu thập bài viết
Lặp lại quá trình tìm kiếm để thu thập từng câu chuyện.
✅ Kết quả: Dữ liệu tin tức mới nhất được lấy trực tiếp từ API của Scrapingbee.
💡 Mẹo hay: Xoay mã quốc gia để so sánh phạm vi phủ sóng theo khu vực.
Hướng dẫn sử dụng ScrapingBee để thu thập dữ liệu nhanh chóng
Thu thập dữ liệu nhanh Cho phép bạn thực hiện thu thập dữ liệu nhanh chóng trong khi ScrapingBee tự động xoay vòng proxy cho bạn.
Dưới đây là hướng dẫn sử dụng từng bước.
Bước 1: Xây dựng yêu cầu của bạn
Chỉ cần tập hợp URL, khóa API và các tham số lại một lần.
Bước 2: Thực hiện các cuộc gọi đồng thời
Gửi nhiều yêu cầu API cùng một lúc.
Đây là hình ảnh minh họa:
✓ Điểm kiểm tra: Các phản hồi được gửi về song song.
Bước 3: Kiểm tra mã trạng thái
Xác nhận mã HTTP 200 cho mỗi mã trạng thái được trả về.
✅ Kết quả: High-volume scraping handled on remote machines.
💡 Mẹo hay: ThreadPoolExecutor giúp tăng tốc độ thu thập dữ liệu từ các trang web một cách đáng kể.
Hướng dẫn sử dụng API chụp ảnh màn hình lập trình của ScrapingBee
API chụp ảnh màn hình theo lập trình Cho phép bạn chụp ảnh màn hình toàn trang của bất kỳ URL nào bằng lập trình.
Dưới đây là hướng dẫn sử dụng từng bước.
Bước 1: Thêm cờ chụp màn hình
Thêm screenshot=true vào yêu cầu API của bạn.
Bước 2: Chọn Toàn trang
Đặt full_page=true để chụp toàn bộ bố cục.
Đây là hình ảnh minh họa:
✓ Điểm kiểm tra: Hình ảnh toàn trang sẽ hiển thị tràn viền.
Bước 3: Tải xuống hình ảnh
Lưu tập tin đã trả về vào ổ đĩa.
✅ Kết quả: Ảnh chụp hoàn hảo đến từng pixel được tạo ra theo yêu cầu.
💡 Mẹo hay: Tham số full_page đảm bảo toàn bộ trang được hiển thị trước.
Hướng dẫn sử dụng ScrapingBee để thu thập dữ liệu việc làm trên Google.
Thu thập dữ liệu từ Google Jobs Cho phép bạn thu thập danh sách việc làm dưới dạng thông tin có cấu trúc phức tạp.
Dưới đây là hướng dẫn sử dụng từng bước.
Bước 1: Gọi đến điểm cuối Jobs
Hãy gửi thông tin về chức vụ và địa điểm của bạn đến API việc làm.
Bước 2: Lọc danh sách
Thu hẹp kết quả tìm kiếm theo chức danh, công ty hoặc thành phố.
Đây là hình ảnh minh họa:
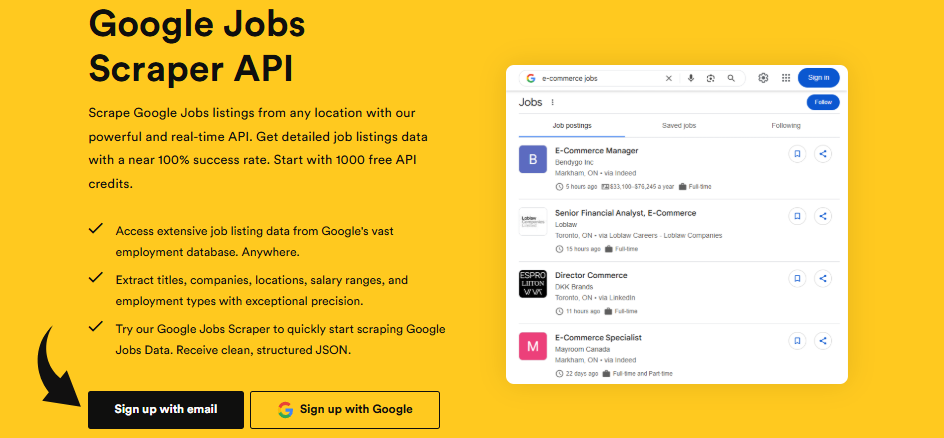
✓ Điểm kiểm tra: Các dòng thông tin việc làm được trả về dưới dạng JSON sạch.
Bước 3: Cấu trúc dữ liệu
Phân tích các trường HTML thành một bảng gọn gàng.
✅ Kết quả: Dữ liệu công việc đã sẵn sàng để phân tích và lưu trữ.
💡 Mẹo hay: Kết hợp với bộ chọn CSS để lấy các trường tùy chỉnh.
Mẹo và phím tắt hữu ích cho ScrapingBee Pro
Sau hơn một năm thử nghiệm ScrapingBee, đây là những lời khuyên hữu ích nhất của tôi để thu thập dữ liệu từ các trang web.
Các tham số API chính
| Tham số | Chức năng của nó |
|---|---|
| render_js | Hiển thị Javascript trong trình duyệt không giao diện người dùng |
| proxy cao cấp | Chuyển sang sử dụng địa chỉ IP proxy dân cư |
| mã quốc gia | Thiết lập vị trí địa lý proxy cao cấp theo quốc gia ngẫu nhiên |
| chặn quảng cáo | Cho phép bạn chặn quảng cáo để tăng tốc độ xử lý yêu cầu. |
Những tính năng ẩn mà hầu hết mọi người bỏ lỡ
- session_id: Chức năng này định tuyến các yêu cầu API thông qua cùng một địa chỉ IP trong năm phút, nhờ đó bạn giữ nguyên mã HTTP và phiên làm việc.
- return_page_source: Trả về mã HTML gốc và toàn bộ mã nguồn trang trước khi bất kỳ mã JavaScript nào được thực thi.
- Tiêu đề và cookie tùy chỉnh: Bạn có thể gửi các tiêu đề và cookie tùy chỉnh của riêng mình, hoặc sử dụng các tiêu đề mặc định mà ScrapingBee tạo ra.
- Điều khiển tiêu đề: Thay thế tiêu đề hiện có bằng tiêu đề mới, hiển thị các tiêu đề được tạo tự động, sau đó chỉ giữ lại một số tiêu đề nhất định và loại bỏ các tiêu đề khác.
Những lỗi thường gặp cần tránh khi sử dụng ScrapingBee
Sai lầm số 1: Bỏ qua tệp robots.txt trước khi thu thập dữ liệu.
❌ Sai: Gửi yêu cầu đến bất kỳ trang web nào bạn muốn thu thập dữ liệu mà không cần kiểm tra các quy tắc trước.
✅ Bên phải: Hãy kiểm tra tệp robots.txt và điều khoản dịch vụ trước khi thu thập dữ liệu từ các trang web.
Lỗi #2: Quên bật tính năng hiển thị JavaScript
❌ Sai: Tôi mong đợi nội dung động nhưng mỗi lần truy cập đều nhận được mã nguồn trang trống.
✅ Bên phải: Đặt render_js=true để các trình duyệt không giao diện người dùng tải toàn bộ trang trước.
Lỗi số 3: Chỉ gửi các tiêu đề mặc định
❌ Sai: Chỉ dựa vào các tiêu đề mặc định, điều mà một số trang web gắn cờ và chặn.
✅ Bên phải: Khi muốn thu thập dữ liệu, hãy gửi các tiêu đề tùy chỉnh của riêng bạn và tham số user agent thực.
Khắc phục sự cố ScrapingBee
Vấn đề: Mã nguồn trang trống hoặc không đầy đủ.
Gây ra: Mã JavaScript trên trang không được thực thi, do đó mã HTML trả về trống.
Sửa chữa: Đặt render_js=true và chờ cho đến khi một phần tử cụ thể được tải toàn bộ trang.
Vấn đề: Các yêu cầu liên tục bị chặn.
Gây ra: Các địa chỉ IP proxy trung tâm dữ liệu mặc định đã bị trang web mục tiêu gắn cờ.
Sửa chữa: Kích hoạt proxy cao cấp để tự động thay đổi địa chỉ IP từ một quốc gia ngẫu nhiên.
Vấn đề: Bạn thấy mã HTTP 401 hoặc 403.
Gây ra: Khóa API của bạn không chính xác hoặc bạn đã hết hạn mức sử dụng API.
Sửa chữa: Xác nhận khóa API, kiểm tra mã trạng thái và nạp thêm tiền nếu cần.
📌 Ghi chú: Nếu không có giải pháp nào trong số này khắc phục được sự cố, hãy liên hệ với bộ phận hỗ trợ của ScrapingBee.
ScrapingBee là gì?
ScrapingBee Đây là một công cụ thu thập dữ liệu dựa trên đám mây, hỗ trợ trình duyệt không giao diện người dùng và tự động xoay vòng proxy.
Hãy coi nó như một trình duyệt được lưu trữ mà bạn điều khiển thông qua API REST.
Hãy xem đoạn video tổng quan ngắn này:
Nó bao gồm các tính năng chính sau:
- Thu thập dữ liệu web bằng AI: Cho phép bạn trích xuất thông tin có cấu trúc phức tạp từ các trang web bằng ngôn ngữ thông thường.
- API tìm kiếm của Google: Cho phép bạn thu thập kết quả tìm kiếm của Google mà không cần tự quản lý địa chỉ IP proxy.
- Công cụ thu thập dữ liệu Google Shopping: Cho phép bạn thu thập danh sách sản phẩm và giá bán được trích xuất cho bất kỳ từ khóa tìm kiếm nào.
- Thu thập dữ liệu web bằng JavaScript: Cho phép bạn xử lý việc hiển thị JavaScript trên các trang web được xây dựng bằng React hoặc Vue.
- ChatGPT Scraper: Cho phép bạn thu thập phản hồi và mã nguồn trang từ các trang trò chuyện động sử dụng trí tuệ nhân tạo.
- API thu thập tin tức của Google: Cho phép bạn lấy tiêu đề và toàn bộ bài viết thông qua các yêu cầu API đơn giản.
- Thu thập dữ liệu nhanh chóng: Cho phép bạn thực hiện thu thập dữ liệu nhanh chóng trong khi ScrapingBee tự động xoay vòng proxy.
- API chụp ảnh màn hình theo lập trình: Cho phép bạn chụp ảnh màn hình toàn trang của bất kỳ URL nào bằng lập trình.
- Thu thập dữ liệu từ Google Jobs: Cho phép bạn thu thập danh sách việc làm dưới dạng thông tin có cấu trúc phức tạp.
Để xem đánh giá đầy đủ, hãy xem bài viết của chúng tôi. Đánh giá ScrapingBee.
Bảng giá ScrapingBee
Đây là giá của ScrapingBee vào năm 2026:
| Kế hoạch | Giá | Tốt nhất cho |
|---|---|---|
| Làm việc tự do | 49 đô la/tháng | Các nhà phát triển cá nhân và các dự án nhỏ |
| Công ty khởi nghiệp | 99 đô la/tháng | Các nhóm đang phát triển mở rộng quy mô yêu cầu API |
| Việc kinh doanh | 249 đô la/tháng | Khối lượng công việc thu thập dữ liệu web lớn |
| Doanh nghiệp+ | 599 đô la/tháng | Các nhóm doanh nghiệp làm việc từ xa |
Dùng thử miễn phí: Đúng vậy — 1000 lượt gọi API miễn phí, không cần thẻ tín dụng.
Đảm bảo hoàn tiền: Bạn có thể hủy bất cứ lúc nào; thanh toán được thực hiện hàng tháng và không ràng buộc hợp đồng.
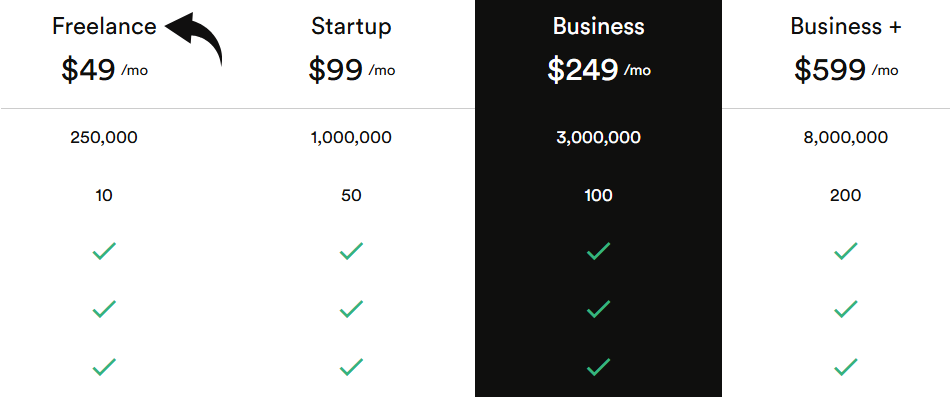
💰 Giá trị tốt nhất: Startup — sự cân bằng tốt nhất giữa dung lượng API và giá cả dành cho hầu hết các nhóm.
So sánh ScrapingBee với các ứng dụng thay thế
So với ScrapingBee thì sao? Dưới đây là bức tranh cạnh tranh:
Hãy xem sự so sánh này:
| Dụng cụ | Tốt nhất cho | Giá | Xếp hạng |
|---|---|---|---|
| ScrapingBee | Hiển thị JavaScript thông qua một API REST | 49 đô la/tháng | ⭐ 4.5 |
| Ứng dụng | Diễn viên cào sẵn có | Tùy thuộc vào từng trường hợp | ⭐ — |
| ScrapeGraphAI | Quy tắc trích xuất dựa trên AI | Tùy thuộc vào từng trường hợp | ⭐ — |
| Dữ liệu sáng | Địa chỉ IP proxy doanh nghiệp | Tùy thuộc vào từng trường hợp | ⭐ — |
| Duyệt Trí tuệ nhân tạo | Không cần lập trình, thao tác trỏ và nhấp chuột. | Tùy thuộc vào từng trường hợp | ⭐ — |
| Oxylabs | Proxy doanh nghiệp cao cấp | Tùy thuộc vào từng trường hợp | ⭐ — |
| ThorData | Mạng proxy giá rẻ | Tùy thuộc vào từng trường hợp | ⭐ — |
| Zyte | API thu thập dữ liệu dành cho nhà phát triển | Tùy thuộc vào từng trường hợp | ⭐ — |
| Trình thu thập dữ liệu web.io | Chụp ảnh tiện ích mở rộng trình duyệt | Tùy thuộc vào từng trường hợp | ⭐ — |
| Máy cạo khí heli | Lập bản đồ trang web trên máy tính để bàn | Tùy thuộc vào từng trường hợp | ⭐ — |
| Bò trườn trên lửa | markdown sẵn sàng cho chương trình LLM | Tùy thuộc vào từng trường hợp | ⭐ — |
Lựa chọn nhanh:
- Tốt nhất tổng thể: ScrapingBee — một API REST duy nhất dành cho việc hiển thị, tìm kiếm và chụp ảnh màn hình.
- Ngân sách tốt nhất: ThorData — địa chỉ IP proxy giá rẻ cho mục đích thu thập dữ liệu đơn giản.
- Phù hợp nhất cho người mới bắt đầu: Tìm kiếm bằng AI — không cần mã lập trình hay ngôn ngữ lập trình nào.
- Phù hợp nhất cho doanh nghiệp: Bright Data — được xây dựng cho các hoạt động thu thập dữ liệu quy mô lớn và tuân thủ các quy định.
🎯 Các lựa chọn thay thế cho ScrapingBee
Bạn đang tìm kiếm các lựa chọn thay thế cho ScrapingBee? Dưới đây là những lựa chọn hàng đầu:
- 🚀 Apify: Một nền tảng thu thập dữ liệu tự động hoàn chỉnh với các actor có sẵn và gói miễn phí hào phóng để thử nghiệm ý tưởng nhanh chóng.
- 🧠 ScrapeGraphAI: Một công cụ trích xuất dữ liệu ưu tiên trí tuệ nhân tạo, chuyển đổi các lời nhắc đơn giản thành các quy tắc trích xuất thông tin có cấu trúc phức tạp.
- 🏢 Bright Data: Các địa chỉ IP proxy và bộ dữ liệu cấp doanh nghiệp được xây dựng cho các hoạt động thu thập dữ liệu quy mô rất lớn và tuân thủ nghiêm ngặt các quy định.
- 👶 Tìm kiếm AI: Một công cụ không cần lập trình, ghi lại các lần nhấp chuột của bạn để xây dựng trình thu thập dữ liệu mà không cần viết bất kỳ mã nào.
- 🔒 Oxylabs: Một nhà cung cấp API proxy và scraper cao cấp với độ tin cậy cao, đáp ứng nhu cầu khối lượng công việc doanh nghiệp đòi hỏi cao.
- 💰 ThorData: Một mạng lưới proxy giá cả phải chăng bao gồm các địa chỉ IP proxy dân cư và trung tâm dữ liệu cho các công việc thu thập dữ liệu hàng ngày.
- 🔧 Zyte: Một API thu thập dữ liệu tập trung vào nhà phát triển, trước đây là Scrapinghub, với khả năng xử lý lệnh cấm thông minh và mã nguồn trang sạch.
- 🎨 Webscraper.io: Một công cụ trích xuất dữ liệu dạng tiện ích mở rộng trình duyệt, tạo sơ đồ trang web trực quan ngay trong Chrome để thu thập dữ liệu chỉ bằng thao tác nhấp chuột.
- 💼 Dụng cụ cạo khí heli: Một ứng dụng thu thập dữ liệu trên máy tính để bàn dành cho Windows, có khả năng lập bản đồ các trang web phức tạp mà không cần phụ thuộc vào điện toán đám mây.
- ⚡ Bò trườn trên lửa: Một trình thu thập dữ liệu AI chuyển đổi toàn bộ trang web thành định dạng Markdown sạch để cung cấp dữ liệu cho các mô hình ngôn ngữ lớn.
Để xem danh sách đầy đủ, vui lòng xem trang của chúng tôi. Các lựa chọn thay thế cho ScrapingBee hướng dẫn.
⚔️ So sánh ScrapingBee
Dưới đây là cách ScrapingBee so sánh với từng đối thủ cạnh tranh:
- So sánh ScrapingBee và Apify: Apify cung cấp một chợ các công cụ thu thập dữ liệu; ScrapingBee nổi bật nhờ khả năng truy cập API REST đơn giản và thiết lập nhanh hơn.
- So sánh ScrapingBee và ScrapeGraphAI: ScrapeGraphAI hoàn toàn dựa vào trí tuệ nhân tạo; ScrapingBee cung cấp cho bạn cả khả năng trích xuất bằng AI và các bộ chọn CSS thô.
- So sánh ScrapingBee và Bright Data: Bright Data có khả năng mở rộng quy mô cho doanh nghiệp lớn; ScrapingBee thì rẻ hơn và đơn giản hơn cho các nhóm nhỏ và vừa.
- So sánh ScrapingBee và Browse AI: Browse AI phù hợp với người không biết lập trình; ScrapingBee phù hợp với các nhà phát triển muốn có API REST và toàn quyền kiểm soát.
- So sánh ScrapingBee và Oxylabs: Oxylabs nhắm đến các doanh nghiệp lớn; ScrapingBee cung cấp mức giá khởi điểm thấp hơn và đường cong học tập dễ dàng hơn.
- So sánh ScrapingBee và ThorData: ThorData cạnh tranh về giá cả; ScrapingBee tích hợp việc dựng hình, chụp ảnh màn hình và trí tuệ nhân tạo vào một API duy nhất.
- So sánh ScrapingBee và Zyte: Zyte có nền tảng vững chắc dành cho các nhà phát triển; ScrapingBee thì thân thiện hơn với các dự án ngắn hạn và các nhóm nhỏ.
- So sánh ScrapingBee và Webscraper.io: Webscraper.io hoạt động trên trình duyệt; ScrapingBee xử lý việc hiển thị JavaScript ở phía máy chủ với quy mô thực tế.
- So sánh ScrapingBee và Helium Scraper: Helium Scraper chỉ chạy trên máy tính để bàn; ScrapingBee chạy trên nền tảng đám mây nên bạn hoàn toàn không cần cài đặt trình điều khiển web.
- So sánh ScrapingBee và Firecrawl: Firecrawl nhắm mục tiêu vào các quy trình LLM; ScrapingBee bao gồm phạm vi thu thập dữ liệu rộng hơn với ảnh chụp màn hình và API tìm kiếm.
Hãy bắt đầu sử dụng ScrapingBee ngay bây giờ!
Bạn đã học cách sử dụng mọi tính năng chính của ScrapingBee:
- ✅ Thu thập dữ liệu web bằng AI
- ✅ API tìm kiếm của Google
- ✅ Công cụ trích xuất dữ liệu Google Shopping
- ✅ Trích xuất dữ liệu web bằng JavaScript
- ✅ Công cụ thu thập dữ liệu ChatGPT
- ✅ API thu thập tin tức của Google
- ✅ Thu thập dữ liệu nhanh chóng
- ✅ API chụp ảnh màn hình tự động
- ✅ Thu thập dữ liệu việc làm từ Google
Bước tiếp theo: Hãy chọn một tính năng và thử ngay bây giờ.
Hầu hết mọi người bắt đầu với việc thu thập dữ liệu web bằng AI.
Một dự án đầu tiên phổ biến là tạo một công cụ thu thập dữ liệu từ OLX để lấy thông tin rao bán.
Trong quá trình phát triển, ScrapingBee sẽ chạy trình duyệt trên các máy từ xa thay cho bạn.
Khám phá thêm các tính năng khác sau khi bạn đã có công cụ thu thập dữ liệu OLX đầu tiên hoạt động.
Chỉ mất chưa đến năm phút để thu thập dữ liệu từ trang đầu tiên.
Câu hỏi thường gặp
ScrapingBee hoạt động như thế nào?
ScrapingBee là một công cụ thu thập dữ liệu dựa trên nền tảng đám mây. Bạn gửi yêu cầu kèm theo khóa API và URL, và nó sẽ trả về trang bằng trình duyệt không giao diện người dùng (headless browser) trong khi tự động xoay vòng proxy cho bạn.
ScrapingBee có giá bao nhiêu?
Các gói dịch vụ bắt đầu từ 49 đô la/tháng cho Freelance, sau đó là 99 đô la cho Startup, 249 đô la cho Business và 599 đô la cho Business+. Bản dùng thử miễn phí cung cấp cho bạn 1000 lượt gọi API để thử nghiệm mục đích thu thập dữ liệu.
Việc thu thập dữ liệu từ web có phải là bất hợp pháp không?
Việc thu thập dữ liệu từ các trang web công cộng nhìn chung là hợp pháp. Luôn kiểm tra tệp robots.txt và điều khoản sử dụng của trang web trước, tránh thu thập dữ liệu cá nhân và tôn trọng giới hạn số lượt truy cập để đảm bảo an toàn.
ScrapingBee có hỗ trợ hiển thị JavaScript không?
Đúng vậy. Hãy đặt render_js=true và ScrapingBee sẽ tải các trang web trong trình duyệt không giao diện người dùng (headless browser). Việc hiển thị bằng JavaScript này hoạt động trên các trang web được xây dựng bằng React hoặc Vue mà không cần chỉnh sửa gì thêm.
ScrapingBee hỗ trợ những ngôn ngữ lập trình nào?
Bất kỳ ngôn ngữ nào cũng được. ScrapingBee là một API REST, vì vậy bạn có thể gọi nó từ Python, Node, PHP hoặc bất kỳ ngôn ngữ nào khác. Trong Python, chỉ cần nhập thư viện requests và gửi yêu cầu API của bạn.













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
