
クイックスタート
ScrapingBeeの使い方に関するこのガイドでは、すべての機能について解説しています。
- はじめる アカウントを作成してAPIキーを取得してください。
- AIウェブスクレイピングの使い方 — 平易な英語を使ってウェブページから複雑な構造化情報を抽出する
- Google検索APIの使い方 プロキシIPを自分で管理することなく、Google検索結果をスクレイピングする
- Googleショッピングスクレイパーの使い方 — 任意の検索語句に対応する商品リストと抽出された価格を収集する
- JavaScriptを使ったWebスクレイピングの方法 — ReactまたはVueで構築されたWebページでのJavaScriptレンダリングを処理する
- ChatGPTスクレイパーの使い方 — 動的なAIチャットページから応答とページソースを取得する
- GoogleニューススクレイパーAPIの使い方 — シンプルなAPIリクエストで見出しと記事全文を取得する
- 高速データスクレイピングの使い方 ScrapingBeeがプロキシをローテーションしてくれるので、高速なデータスクレイピングを実行できます。
- プログラムによるスクリーンショットAPIの使い方 — 任意のURLのページ全体のスクリーンショットをプログラムで取得する
- Google求人情報をスクレイピングする方法 ―求人情報を複雑な構造化情報として収集する
所要時間: 各作品につき5分
このガイドには以下の内容も含まれています。 プロのヒント | よくある間違い | トラブルシューティング | 価格 | 代替案
このガイドを信頼する理由
私はScrapingBeeを1年以上使用し、ここに掲載されているすべての機能をテストしました。このチュートリアルは、ベンダーのスクリーンショットではなく、実際のスクレイピング作業に基づいています。

ScrapingBeeはクラウドベースの 削り取りツール ウェブスクレイピングの難しい部分を処理してくれる。
ヘッドレスブラウザを管理し、プロキシをローテーションしてくれます。
このガイドでは、主要な機能の使い方をステップバイステップで解説します。
スクリーンショット、簡単な例、そして随所にプロのアドバイスを交えながら解説します。
ScrapingBeeチュートリアル
このScrapingBeeの完全チュートリアルでは、最初のAPIリクエストから高度なJavaScriptシナリオテクニックまで、すべての機能を詳しく解説します。
スクレイピングビー
プロキシIPやヘッドレスブラウザを管理することなく、あらゆるウェブサイトをスクレイピングできます。ScrapingBeeは、シンプルなREST APIを通じてJavaScriptのレンダリングを処理します。まずは1000回の無料APIコールから始めましょう。クレジットカードは不要です。
ScrapingBee入門
いずれかの機能を使用する前に、この初回設定を完了してください。
約3分かかります。
ワークフローの概要は以下のとおりです。
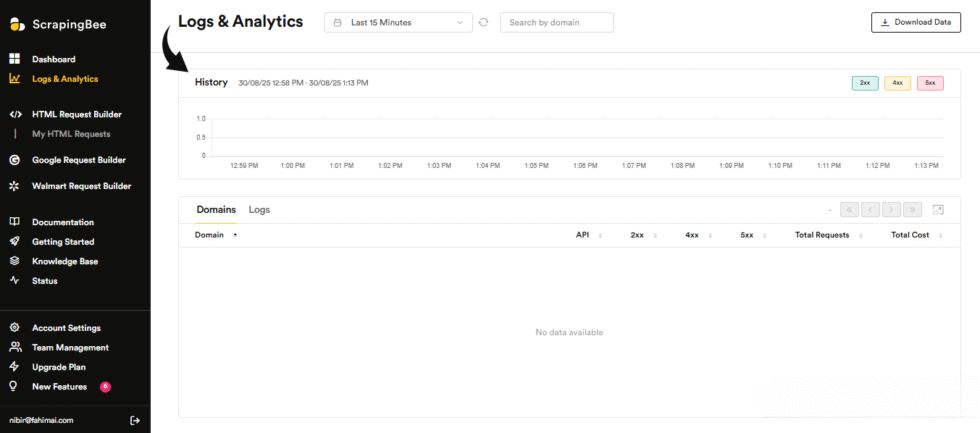
それでは、各ステップを順を追って見ていきましょう。
ステップ1:アカウントを作成する
ScrapingBeeのウェブサイトにアクセスして、「サインアップ」をクリックしてください。
紹介リンクからプロモーションコード「ADNAN」を入力すると、追加のAPIクレジットを獲得できます。
✓ チェックポイント: ダッシュボードには、お客様固有のAPIキーが表示されます。
ステップ2:コードを設定する
Pythonでは、`pip install scrapingbee`を実行するか、`import requests`を実行するだけで済みます。
requestsライブラリを使えば、どのプログラミング言語からでもAPIを呼び出すことができます。
✓ チェックポイント: APIリクエストを送信する準備が整いました。
ステップ3:最初の電話をかける
APIキーとURLを使用して、https://app.scrapingbee.com/api/v1/ エンドポイントにリクエストを送信してください。
この簡単な例では、わずか数行のコードでウェブページをスクレイピングできます。
✅ 完了: 以下の機能はすべてご利用いただけます。
ScrapingBee AI Webスクレイピングの使い方
AIウェブスクレイピング 平易な英語を使って、ウェブページから複雑な構造化情報を抽出できます。
以下に、その使用方法をステップごとに説明します。
ステップ1:APIキーを取得する
サインアップして、ダッシュボードからAPIキーをコピーしてください。
ステップ2:データの記述
対象のURLを追加し、平易な英語でクエリを記述してください。
これは以下のようなものです。
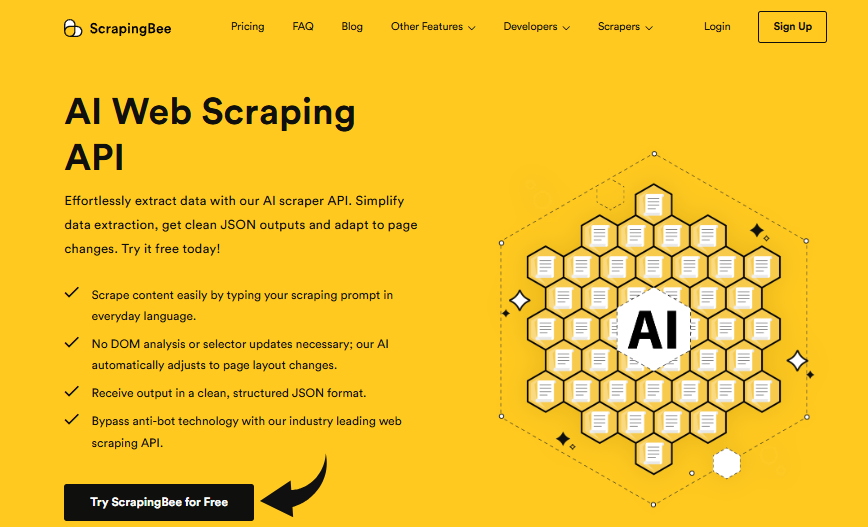
✓ チェックポイント: 入力したフィールドを含む、整理されたJSONオブジェクトが表示されます。
ステップ3:抽出ルールを設定する
各フィールドを正確に抽出するように、抽出ルールを調整してください。
✅ 結果: CSSセレクタを手作業で記述することなく、構造化されたJSONを作成します。
💡 プロのヒント: より精密な制御が必要な場合は、AI抽出とCSSセレクタを組み合わせて使用してください。
ScrapingBeeのGoogle検索APIの使い方
Google 検索 API プロキシIPを自分で管理することなく、Google検索結果をスクレイピングできます。
以下に、その使用方法をステップごとに説明します。
ステップ1:エンドポイントを選択する
Google検索APIにリクエストを送信してください。
ステップ2:クエリを設定する
キーワードとランダムな国名を入力すると、地域別の検索結果が表示されます。
これは以下のようなものです。
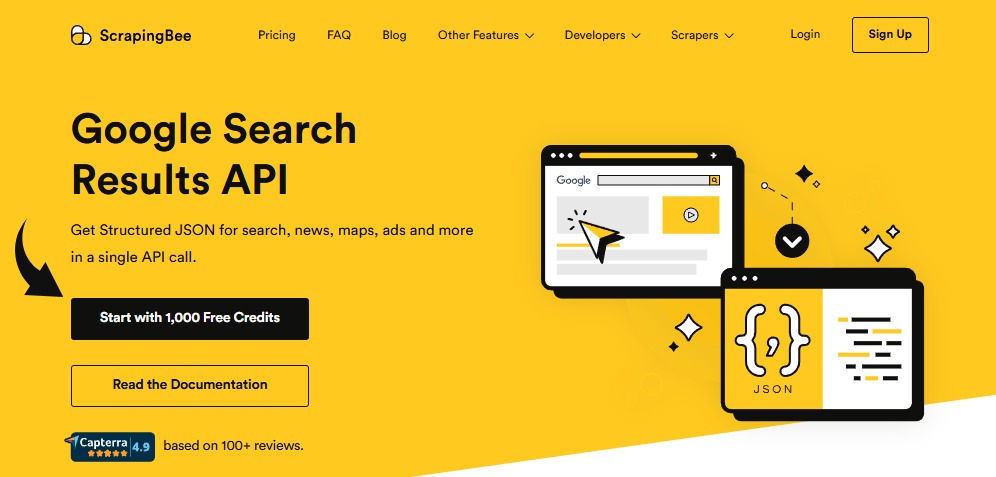
✓ チェックポイント: ランキング結果は構造化データとして返されます。
ステップ3:JSONを読み込む
Pythonのrequestsライブラリを使ってレスポンスを解析します。
✅ 結果: シンプルなREST API呼び出し1回でデータを検索できます。
💡 プロのヒント: プレミアムプロキシによる位置情報特定には、すべてのクエリでcountry_codeを使用してください。
ScrapingBee Googleショッピングスクレイパーの使い方
Googleショッピングスクレイパー 任意の検索語句に対応する商品リストと抽出された価格を収集できます。
以下に、その使用方法をステップごとに説明します。
ステップ1:ショッピングリクエストを送信する
商品に関するクエリを使用して、ショッピングエンドポイントを呼び出してください。
ステップ2:レスポンスを解析する
各リストをタイトル、リンク、および抽出した価格にマッピングします。
これは以下のようなものです。
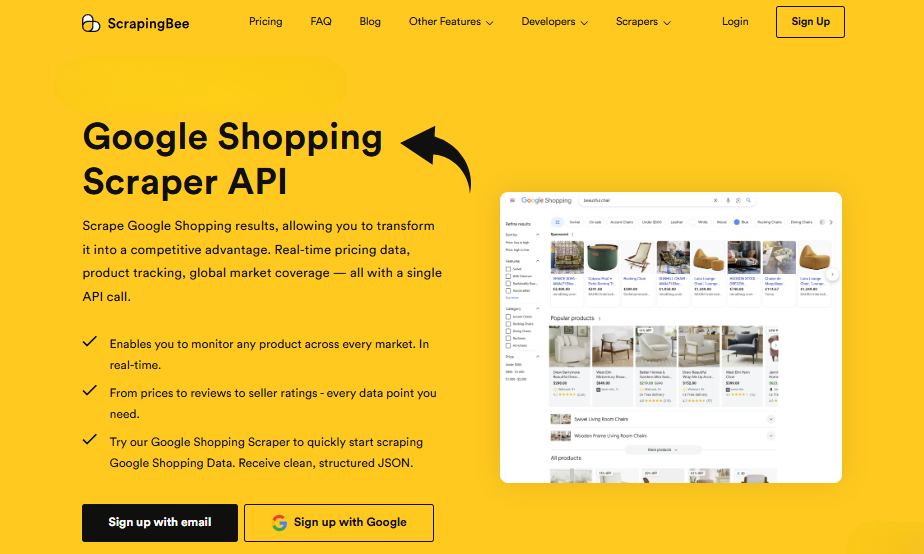
✓ チェックポイント: 商品行は、クリーンなJSON形式で返されます。
ステップ3:結果をエクスポートする
さらなる分析のためにデータをCSV形式で保存してください。
✅ 結果: あらゆるスプレッドシートに対応したリアルタイム価格データ。
💡 プロのヒント: 抽出された価格を時系列で追跡するための実行スケジュールを設定します。
ScrapingBee JavaScript Webスクレイピングの使い方
JavaScriptによるウェブスクレイピング ReactまたはVueで構築されたWebページ上のJavaScriptレンダリングを処理できます。
以下に、その使用方法をステップごとに説明します。
ステップ1:render_jsを有効にする
ScrapingBeeがヘッドレスブラウザを使用するように、render_js=trueを設定してください。
ステップ2:要素を待つ
特定の要素が読み込まれるまで待機するように指示します。
これは以下のようなものです。
✓ チェックポイント: 抽出前にページ全体がレンダリングされます。
ステップ3:HTMLをキャプチャする
レンダリング後に元のHTMLまたは生のページソースを返します。
✅ 結果: 管理すべきウェブドライバが不要な、完全にレンダリングされたウェブページ。
💡 プロのヒント: クリック、スクロール、フォーム入力などの操作に対応するJavaScriptシナリオを追加します。
ScrapingBee ChatGPT Scraperの使い方
チャットGPT スクレーパー 動的なAIチャットページからの応答とページソースを取得できます。
以下に、その使用方法をステップごとに説明します。
ステップ1:ページをターゲットにする
render_jsを有効にした状態で、ページURLを送信してください。
ステップ2:レンダリングと抽出
ヘッドレススクレイピングで応答を読み込んでから、 文章.
これは以下のようなものです。
✓ チェックポイント: レンダリングされた回答はページソースに表示されます。
ステップ3:出力を保存する
解析したHTMLを保存し、後で処理できるようにする。
✅ 結果: 完全に動的なページから抽出された、きれいなテキスト。
💡 プロのヒント: JavaScriptシナリオを連結して、複数ステップのプロンプトを順に実行します。
ScrapingBeeのGoogleニューススクレイパーAPIの使い方
GoogleニューススクレイパーAPI 簡単なAPIリクエストで、見出しや記事全文を取得できます。
以下に、その使用方法をステップごとに説明します。
ステップ1:ニュースエンドポイントを設定する
Google News API にリクエストを送信してください。
ステップ2:フィルターを追加する
トピック、言語、またはランダムな国で絞り込む。
これは以下のようなものです。
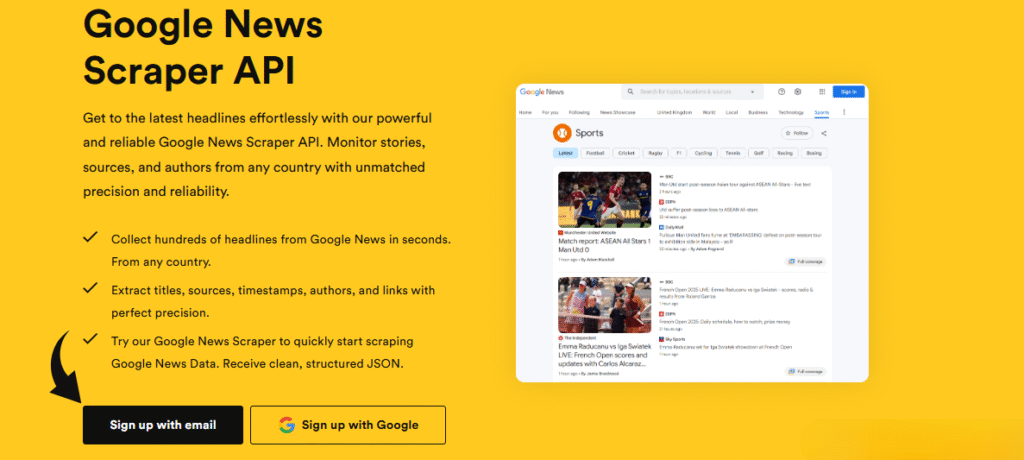
✓ チェックポイント: 一致する見出しは構造化データとして返されます。
ステップ3:記事を集める
結果をループ処理して、各ストーリーを収集する。
✅ 結果: Scrapingbee APIから直接取得した最新ニュースデータ。
💡 プロのヒント: 国コードを回転させて、地域ごとのカバー範囲を比較してください。
ScrapingBeeを使った高速データスクレイピングの方法
高速データスクレイピング ScrapingBeeがプロキシを自動的に切り替えてくれるので、高速なデータスクレイピングを実行できます。
以下に、その使用方法をステップごとに説明します。
ステップ1:リクエストを作成する
URL、APIキー、およびパラメータを一度だけ組み立ててください。
ステップ2:同時呼び出しを実行する
複数のAPIリクエストを同時に送信する。
これは以下のようなものです。
✓ チェックポイント: 回答は並行して次々と返ってくる。
ステップ3:ステータスコードを確認する
返されたすべてのステータスコードについて、HTTPコード200であることを確認してください。
✅ 結果: High-volume scraping handled on remote machines.
💡 プロのヒント: ThreadPoolExecutorは、ウェブページのスクレイピング速度を劇的に向上させます。
ScrapingBeeのプログラムによるスクリーンショットAPIの使い方
プログラムによるスクリーンショットAPI 任意のURLのページ全体のスクリーンショットをプログラムで取得できます。
以下に、その使用方法をステップごとに説明します。
ステップ1:スクリーンショットフラグを追加する
APIリクエストにscreenshot=trueを追加してください。
ステップ2:フルページを選択
レイアウト全体をキャプチャするには、full_page=trueを設定してください。
これは以下のようなものです。
✓ チェックポイント: フルページ画像は、ページの端から端まで表示されます。
ステップ3:画像をダウンロードする
返されたファイルをディスクに保存します。
✅ 結果: ピクセル単位で完璧な画像をオンデマンドで生成します。
💡 プロのヒント: full_page パラメータを指定すると、ページ全体が最初にレンダリングされます。
ScrapingBeeを使ってGoogle求人情報をスクレイピングする方法
Google求人情報をスクレイピングする 求人情報を複雑な構造化情報として収集できます。
以下に、その使用方法をステップごとに説明します。
ステップ1:ジョブエンドポイントを呼び出す
職務内容と勤務地を求人APIに送信してください。
ステップ2:リストを絞り込む
役職、企業名、または都市で検索結果を絞り込む。
これは以下のようなものです。
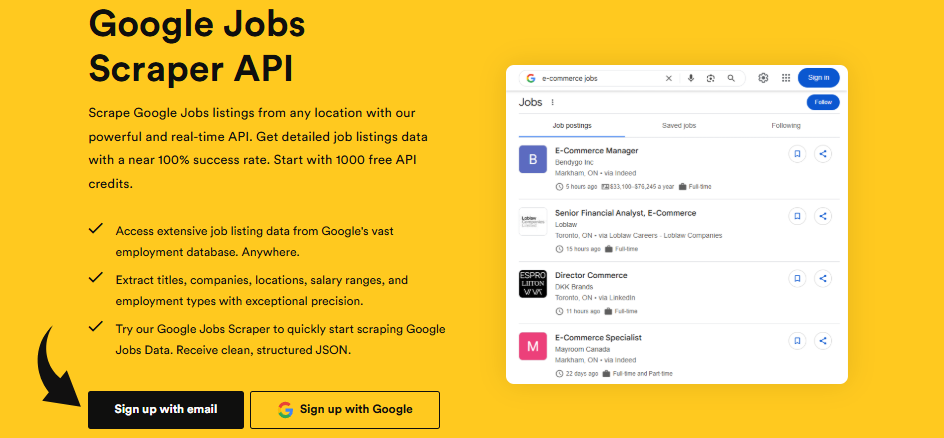
✓ チェックポイント: ジョブ行は、クリーンなJSON形式で返されます。
ステップ3:データの構造化
HTMLフィールドを解析して、整然としたテーブルに変換する。
✅ 結果: 解析および保存準備が整ったジョブデータ。
💡 プロのヒント: CSSセレクタと組み合わせて、カスタムフィールドを取得します。
ScrapingBeeのプロ向けヒントとショートカット
ScrapingBeeを1年以上テストした結果、ウェブサイトをスクレイピングするための私のおすすめのヒントをご紹介します。
主要APIパラメータ
| パラメータ | その機能 |
|---|---|
| render_js | ヘッドレスブラウザでJavaScriptをレンダリングします。 |
| プレミアムプロキシ | 住宅用プロキシIPアドレスに切り替える |
| 国コード | プレミアムプロキシの地理的位置情報をランダムな国に設定します |
| 広告ブロック | 広告をブロックしてリクエストを高速化できます |
ほとんどの人が見逃す隠れた機能
- セッションID: APIリクエストを5分間同じIPアドレス経由でルーティングすることで、同じHTTPコードとセッションを維持します。
- return_page_source: JavaScriptが実行される前の、元のHTMLとページ全体のソースコードを返します。
- カスタムヘッダーとクッキー: 独自のカスタムヘッダーとカスタムクッキーを送信するか、ScrapingBeeが生成するデフォルトのヘッダーを使用するかを選択できます。
- ヘッダーコントロール: 既存のヘッダーを新しいヘッダーに置き換え、自動生成されたヘッダーを表示し、特定のヘッダーのみを保持して他のヘッダーを削除します。
ScrapingBeeでよくある間違いを避ける方法
間違いその1:スクレイピング前にrobots.txtを無視する
❌ 間違い: ルールを事前に確認せずに、スクレイピングしたいサイトに対してリクエストを送信すること。
✅ 右: ウェブページをスクレイピングする前に、robots.txtファイルと利用規約を確認してください。
間違いその2:JavaScriptレンダリングを有効にするのを忘れる
❌ 間違い: 動的なコンテンツを期待しているのに、毎回空のページソースが返ってくる。
✅ 右: render_js=trueを設定すると、ヘッドレスブラウザが最初にページ全体を読み込むようになります。
間違いその3:デフォルトヘッダーのみを送信する
❌ 間違い: デフォルトヘッダーのみに依存しているため、一部のサイトではこれを問題視してブロックしている。
✅ 右: スクレイピングを行う際は、独自のカスタムヘッダーと実際のユーザーエージェントパラメータを送信してください。
ScrapingBeeのトラブルシューティング
問題: ページソースが空または不完全です
原因: ページ上のJavaScriptが正しくレンダリングされなかったため、HTMLが空白で返されました。
修理: render_js=trueを設定し、特定の要素がページ全体を読み込むまで待機します。
問題:リクエストが繰り返しブロックされる
原因: デフォルトのデータセンタープロキシIPアドレスが、ターゲットサイトによってフラグ付けされました。
修理: プレミアムプロキシで、ランダムな国の新しいIPアドレスをローテーションで使用できるようにします。
問題:HTTPコード401または403が表示される
原因: APIキーが間違っているか、APIクレジットが不足しています。
修理: APIキーを確認し、ステータスコードを確認し、必要に応じてクレジットを補充してください。
📌 注記: これらの方法で問題が解決しない場合は、ScrapingBeeのサポートにお問い合わせください。
ScrapingBeeとは何ですか?
スクレイピングビー これは、ヘッドレスブラウザを処理し、プロキシをローテーションしてくれるクラウドベースのスクレイピングツールです。
これは、REST API を介して制御するホスト型ブラウザだと考えてください。
こちらの簡単な概要をご覧ください。
主な機能は以下のとおりです。
- AIによるウェブスクレイピング: 平易な英語を使って、ウェブページから複雑な構造情報を抽出できます。
- Google検索API: プロキシIPアドレスを自分で管理することなく、Google検索結果をスクレイピングできます。
- Googleショッピングスクレイパー: 任意の検索語句に対応する商品リストと抽出された価格を収集できます。
- JavaScriptによるWebスクレイピング: ReactまたはVueで構築されたWebページ上のJavaScriptレンダリングを処理できます。
- ChatGPTスクレイパー: 動的なAIチャットページから応答とページソースを取得できます。
- GoogleニューススクレイパーAPI: 簡単なAPIリクエストで、見出しや記事全文を取得できます。
- 高速データスクレイピング: ScrapingBeeがプロキシを自動的に切り替えてくれるので、高速なデータスクレイピングを実行できます。
- プログラムによるスクリーンショットAPI: プログラムを使って、任意のURLのページ全体のスクリーンショットをキャプチャできます。
- Google求人情報をスクレイピングする: 求人情報を複雑な構造化情報として収集できます。
詳細なレビューについては、こちらをご覧ください。 ScrapingBeeのレビュー.
ScrapingBeeの価格設定
2026年におけるScrapingBeeの費用は以下のとおりです。
| プラン | 価格 | 最適な用途 |
|---|---|---|
| フリーランス | 月額49ドル | 個人開発者と小規模プロジェクト |
| 起動する | 月額99ドル | チームの規模拡大に伴い、APIリクエストも増加している。 |
| 仕事 | 月額249ドル | 大量のウェブスクレイピング作業 |
| ビジネス+ | 月額599ドル | リモートマシン上のエンタープライズチーム |
無料トライアル: はい、1000回まで無料のAPI呼び出しが可能です。クレジットカードは不要です。
返金保証: いつでも解約可能。料金は月額制で、契約期間の縛りはありません。
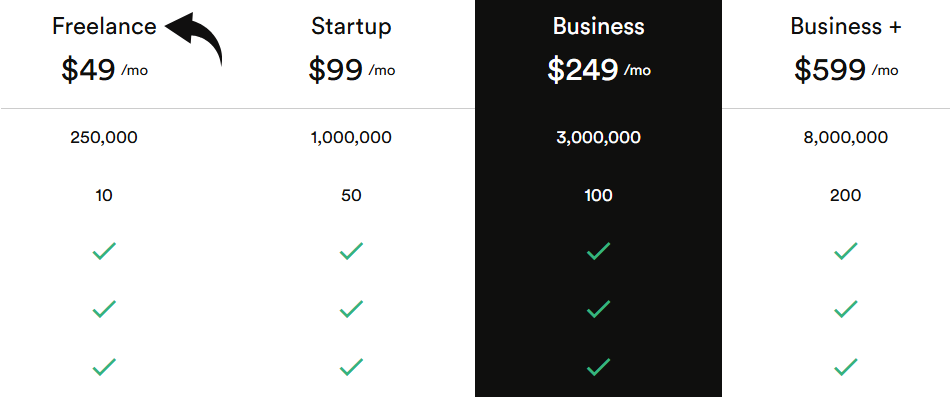
💰 最もお得な価格: スタートアップ向け – ほとんどのチームにとって、APIクレジットと価格のバランスが最も優れている。
ScrapingBeeと代替案の比較
ScrapingBeeは他社製品と比べてどうでしょうか?競合状況は以下のとおりです。
この比較をご覧ください。
| 道具 | 最適な用途 | 価格 | 評価 |
|---|---|---|---|
| スクレイピングビー | JavaScriptレンダリングは、One REST APIを介して行われます。 | 月額49ドル | ⭐ 4.5 |
| アピファイ | 既製のスクレイパーアクター | 様々 | ⭐ — |
| スクレイプグラフAI | AI駆動型抽出ルール | 様々 | ⭐ — |
| ブライトデータ | エンタープライズプロキシIP | 様々 | ⭐ — |
| ブラウズ 人工知能 | コード不要、ポイント&クリック | 様々 | ⭐ — |
| オキシラボ | プレミアムエンタープライズプロキシ | 様々 | ⭐ — |
| ソーデータ | 格安プロキシネットワーク | 様々 | ⭐ — |
| ザイト | 開発者向けスクレイピングAPI | 様々 | ⭐ — |
| ウェブスクレイパー.io | ブラウザ拡張機能のキャプチャ | 様々 | ⭐ — |
| ヘリウムスクレーパー | デスクトップサイトマッピング | 様々 | ⭐ — |
| ファイヤークロール | LLM対応マークダウン | 様々 | ⭐ — |
おすすめ商品:
- 総合ベスト: ScrapingBee ― レンダリング、検索、スクリーンショットのための単一の REST API。
- ベスト予算: ThorData ― シンプルなスクレイピング目的向けの安価なプロキシIPアドレス。
- 初心者におすすめ: ブラウジングAI ― コードもプログラミング言語も不要です。
- 企業向けに最適: Bright Data ― 大規模かつ法令遵守を徹底したスクレイピング業務向けに構築されています。
🎯 ScrapingBeeの代替案
ScrapingBeeの代替サービスをお探しですか?おすすめのサービスはこちらです。
- 🚀 Apify: すぐに使えるアクターを備えた本格的なスクレイピングプラットフォーム。アイデアを迅速にテストできる充実した無料プランも用意されています。
- 🧠 スクレイプグラフAI: AIを最優先に考えたスクレイピングツール。シンプルなプロンプトを、複雑な構造化情報を抽出するルールに変換します。
- 🏢 ブライトデータ: 大規模なスクレイピング作業と厳格なコンプライアンスに対応するために構築された、エンタープライズグレードのプロキシIPとデータセット。
- 👶 ブラウズAI: コードを一切書かずにクリックを記録し、スクレイパーを作成できるノーコードツール。
- 🔒 オキシラボ: 高度なエンタープライズワークロードに対応する、高い信頼性を誇るプレミアムプロキシおよびスクレイパーAPIプロバイダー。
- 💰 ThorData: 日常的なスクレイピング作業向けに、住宅用およびデータセンター用のプロキシIPアドレスを網羅した、予算に優しいプロキシネットワーク。
- 🔧 ザイト: 開発者向けのスクレイピングAPI(旧称:Scrapinghub)。スマートなアクセス制限処理とクリーンなページソース機能を備えています。
- 🎨 Webscraper.io: Chromeブラウザ内でサイトマップを視覚的に作成し、クリック操作でデータ収集を可能にするブラウザ拡張機能スクレイパー。
- 💼 ヘリウムスクレーパー: クラウドに依存せずに複雑なサイトをマッピングできる、Windows向けのデスクトップスクレイピングアプリ。
- ⚡ ファイヤークロール: ウェブサイト全体を、大規模な言語モデルへの入力データとして使用できるクリーンなマークダウン形式に変換するAIクローラー。
全リストについては、こちらをご覧ください。 ScrapingBeeの代替品 ガイド。
⚔️ ScrapingBeeとの比較
ScrapingBeeと各競合製品との比較は以下のとおりです。
- ScrapingBee vs Apify: Apifyはスクレイパーのマーケットプレイスを提供しているが、ScrapingBeeはシンプルなREST APIアクセスと迅速なセットアップで優れている。
- ScrapingBee vs ScrapeGraphAI: ScrapeGraphAIは完全にAIに依存していますが、ScrapingBeeはAIによる抽出と生のCSSセレクタの両方を提供します。
- ScrapingBeeとBright Dataの比較: Bright Dataはエンタープライズ規模に対応できる一方、ScrapingBeeは小規模から中規模のチーム向けに、より安価でシンプルな設計となっている。
- ScrapingBee vs Browse AI: Browse AIはプログラミングの知識がない人に適しています。ScrapingBeeは、REST APIと完全な制御機能を求める開発者に適しています。
- ScrapingBee vs Oxylabs: Oxylabsは大企業をターゲットとしている一方、ScrapingBeeはより低価格で導入しやすく、習得も容易である。
- ScrapingBee vs ThorData: ThorDataはプロキシの価格競争で優位に立っており、ScrapingBeeはレンダリング、スクリーンショット、AIを1つのAPIに統合している。
- ScrapingBee vs Zyte: Zyteは開発者にとって馴染み深い存在ですが、ScrapingBeeは小規模なプロジェクトやチームに適しています。
- ScrapingBee vs Webscraper.io: Webscraper.ioはブラウザ上で動作しますが、ScrapingBeeはJavaScriptのレンダリングをサーバー側で大規模に処理します。
- ScrapingBee vs Helium Scraper: Helium Scraperはデスクトップ専用ですが、ScrapingBeeはクラウド上で動作するため、Webドライバは一切不要です。
- ScrapingBee 対 Firecrawl: FirecrawlはLLMパイプラインを対象としており、ScrapingBeeはスクリーンショットや検索APIなど、より広範なスクレイピングに対応しています。
今すぐScrapingBeeを使い始めましょう
ScrapingBeeの主要な機能をすべて使いこなせるようになりました。
- ✅ AIによるウェブスクレイピング
- ✅ Google検索API
- ✅ Googleショッピングスクレイパー
- ✅ JavaScriptによるウェブスクレイピング
- ✅ ChatGPTスクレイパー
- ✅ GoogleニューススクレイパーAPI
- ✅ 高速データスクレイピング
- ✅ プログラムによるスクリーンショットAPI
- ✅ Google求人情報をスクレイピングする
次のステップ: どれか一つの機能を選んで、今すぐ試してみてください。
ほとんどの人はAIを使ったウェブスクレイピングから始める。
人気のある最初のプロジェクトは、OLXの出品情報を取得するスクレイパーを作成することです。
開発中は、ScrapingBeeがリモートマシン上でブラウザを実行します。
最初のOLXスクレイパーが正常に動作したら、さらに多くの機能を試してみてください。
最初のページをスクレイピングするのにかかる時間は5分未満です。
よくある質問
ScrapingBeeはどのように動作するのですか?
ScrapingBeeはクラウドベースのスクレイピングツールです。APIキーとURLをリクエストとして送信すると、ヘッドレスブラウザを使用してページを返し、プロキシをローテーションしながら自動的にページを転送します。
ScrapingBeeの価格はいくらですか?
プランは、フリーランス向けが月額49ドルから始まり、スタートアップ向けが99ドル、ビジネス向けが249ドル、ビジネスプラス向けが599ドルとなっています。無料トライアルでは、スクレイピングのテスト目的で1000回のAPI呼び出しが可能です。
ウェブスクレイピングは違法ですか?
公開されているウェブページをスクレイピングすることは、一般的に合法です。安全を確保するためには、必ず事前にサイトのrobots.txtと利用規約を確認し、個人情報の収集を避け、レート制限を遵守してください。
ScrapingBeeはJavaScriptレンダリングをサポートしていますか?
はい。render_js=trueを設定すると、ScrapingBeeはヘッドレスブラウザでウェブページを読み込みます。このJavaScriptレンダリングは、ReactまたはVueで構築されたサイトでそのまま動作します。
ScrapingBeeはどのプログラミング言語をサポートしていますか?
ScrapingBeeはREST APIなので、Python、Node、PHPなど、どの言語からでも呼び出すことができます。Pythonの場合は、requestsライブラリをインポートしてAPIリクエストを送信するだけです。













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
