
Inicio rápido
Esta guía sobre cómo usar ScrapingBee cubre todas las funciones:
- Empezando — Crea tu cuenta y obtén tu clave API.
- Cómo utilizar la extracción de datos web mediante IA — extraer información estructurada compleja de páginas web utilizando un lenguaje sencillo.
- Cómo usar la API de búsqueda de Google — Extrae resultados de búsqueda de Google sin gestionar manualmente las direcciones IP de los proxies.
- Cómo usar el extractor de datos de Google Shopping — recopilar listados de productos y el precio extraído para cualquier término de búsqueda.
- Cómo usar el web scraping con JavaScript — Gestionar la representación de JavaScript en páginas web creadas con React o Vue.
- Cómo usar ChatGPT Scraper — Capturar respuestas y código fuente de páginas de chat con IA dinámica
- Cómo usar la API de extracción de noticias de Google — Obtener titulares y artículos completos mediante sencillas solicitudes a la API.
- Cómo utilizar el web scraping rápido — Ejecuta el web scraping de datos rápidamente mientras ScrapingBee rota los proxies por ti.
- Cómo usar la API de captura de pantalla programática — Capturar una captura de pantalla de página completa de cualquier URL mediante programación.
- Cómo usar Scrape Google Jobs — recopilar ofertas de empleo como información estructurada compleja
Tiempo necesario: 5 minutos por función
También en esta guía: Consejos profesionales | Errores comunes | Solución de problemas | Precios | Alternativas
¿Por qué confiar en esta guía?
He usado ScrapingBee durante más de un año y he probado todas sus funciones. Este tutorial se basa en experiencia práctica real de extracción de datos, no en capturas de pantalla del proveedor.

ScrapingBee es una plataforma basada en la nube. herramienta de raspado que se encarga de las partes difíciles del web scraping.
Gestiona navegadores sin interfaz gráfica y rota los proxies automáticamente.
Esta guía le muestra cómo utilizar cada una de las funciones principales paso a paso.
Con capturas de pantalla, un ejemplo sencillo y consejos profesionales a lo largo del texto.
Tutorial de ScrapingBee
Este completo tutorial de ScrapingBee te guía a través de todas las funciones, desde tu primera solicitud a la API hasta trucos avanzados para escenarios con JavaScript.
Abeja raspadora
Extrae datos de cualquier sitio web sin necesidad de gestionar proxies ni navegadores sin interfaz gráfica. ScrapingBee gestiona la renderización de JavaScript mediante una sencilla API REST. Obtén 1000 llamadas a la API gratuitas para empezar; no se requiere tarjeta de crédito.
Primeros pasos con ScrapingBee
Antes de utilizar cualquier función, complete esta configuración inicial.
Tarda unos tres minutos.
Aquí les presentamos un breve resumen del flujo de trabajo:
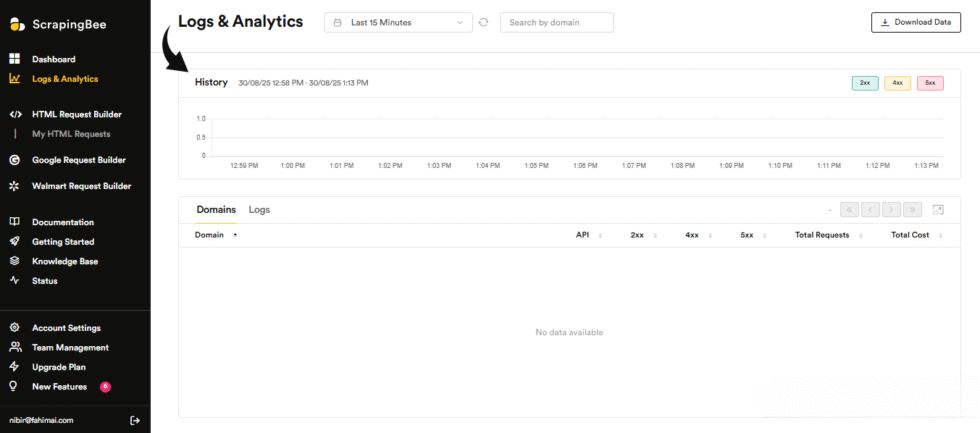
Ahora vamos a repasar cada paso.
Paso 1: Crea tu cuenta
Ve al sitio web de ScrapingBee y haz clic en "Registrarse".
Introduce el código promocional ADNAN a través del enlace de referencia para obtener crédito API adicional.
✓ Control: Tu panel de control muestra tu clave API única.
Paso 2: Configura tu código
En Python, ejecuta pip install scrapingbee o simplemente importa requests.
La biblioteca requests te permite llamar a la API desde cualquier lenguaje de programación.
✓ Control: Tu entorno está listo para enviar solicitudes a la API.
Paso 3: Haz tu primera llamada
Envía una solicitud al punto final https://app.scrapingbee.com/api/v1/ con tu clave API y URL.
Este sencillo ejemplo te permite extraer información de páginas web con tan solo unas pocas líneas de código.
✅ Hecho: Ya puedes utilizar cualquiera de las funciones que aparecen a continuación.
Cómo usar ScrapingBee AI Web Scraping
Web Scraping con IA Te permite extraer información estructurada compleja de páginas web utilizando un lenguaje sencillo.
Aquí te explicamos cómo usarlo paso a paso.
Paso 1: Obtén tu clave API
Regístrate y copia tu clave API desde el panel de control.
Paso 2: Describir los datos
Añade la URL de destino y escribe una consulta en lenguaje natural.
Así es como se ve:
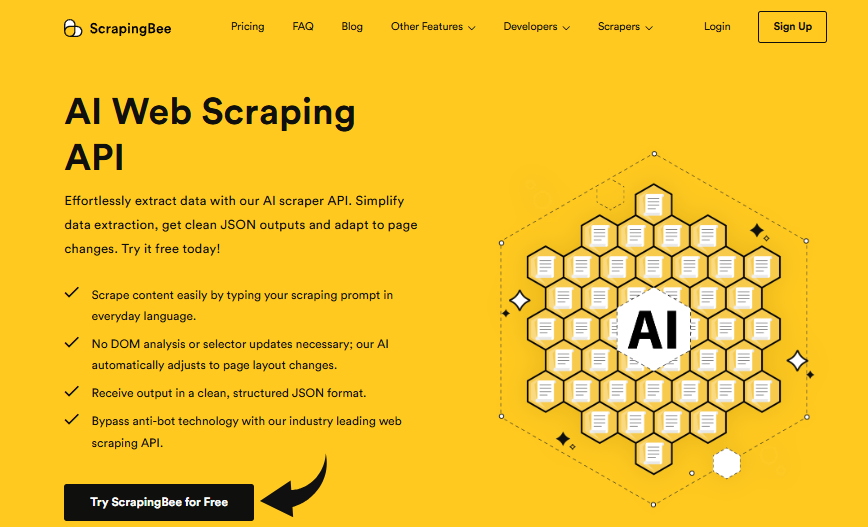
✓ Control: Aparecerá un objeto JSON limpio con tus campos.
Paso 3: Establecer reglas de extracción
Ajusta tus reglas de extracción para capturar cada campo con precisión.
✅ Resultado: JSON estructurado sin necesidad de escribir selectores CSS manualmente.
💡 Consejo profesional: Combina la extracción mediante IA con selectores CSS cuando necesites un control preciso.
Cómo usar la API de búsqueda de Google de ScrapingBee
API de búsqueda de Google Te permite extraer resultados de búsqueda de Google sin tener que gestionar tú mismo las direcciones IP de los proxies.
Aquí te explicamos cómo usarlo paso a paso.
Paso 1: Elija el punto final
Dirige tu solicitud a la API de búsqueda de Google.
Paso 2: Configurar la consulta
Añade tu palabra clave y un país al azar para obtener resultados locales.
Así es como se ve:
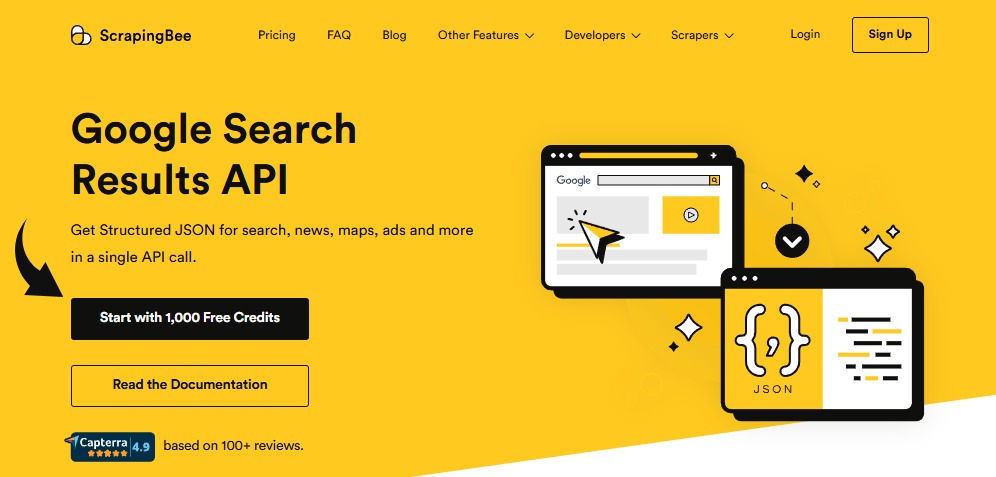
✓ Control: Los resultados clasificados se devuelven como datos estructurados.
Paso 3: Leer el JSON
Analiza la respuesta con la biblioteca requests en Python.
✅ Resultado: Busca datos mediante una sencilla llamada a la API REST.
💡 Consejo profesional: Utilice country_code para la geolocalización proxy premium en cada consulta.
Cómo usar el extractor de datos de Google Shopping de ScrapingBee
Extractor de datos de Google Shopping Te permite recopilar listados de productos y el precio extraído para cualquier término de búsqueda.
Aquí te explicamos cómo usarlo paso a paso.
Paso 1: Enviar una solicitud de compra
Llama al punto de acceso de compras con tu consulta de producto.
Paso 2: Analizar la respuesta
Asocia cada anuncio con su título, enlace y precio extraído.
Así es como se ve:
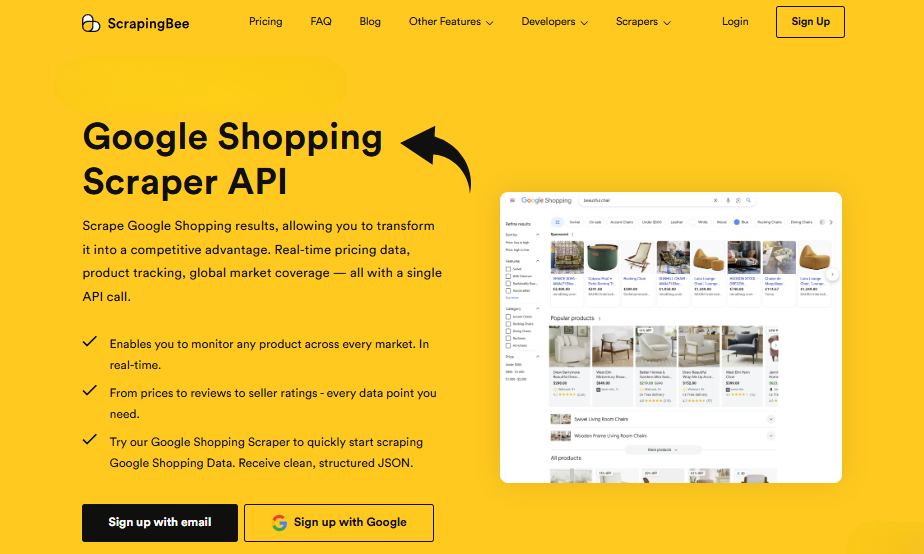
✓ Control: Las filas de productos se devuelven como JSON limpio.
Paso 3: Exportar los resultados
Guarda los datos en formato CSV para su posterior análisis.
✅ Resultado: Datos de precios en tiempo real, listos para cualquier hoja de cálculo.
💡 Consejo profesional: Ejecuta programas para realizar un seguimiento del precio extraído a lo largo del tiempo.
Cómo usar el web scraping con JavaScript de ScrapingBee
Extracción de datos web con JavaScript Te permite gestionar la representación de JavaScript en páginas web creadas con React o Vue.
Aquí te explicamos cómo usarlo paso a paso.
Paso 1: Habilitar render_js
Establece render_js=true para que ScrapingBee utilice navegadores sin interfaz gráfica.
Paso 2: Esperar a que aparezca un elemento.
Indícale que espere a que se cargue un elemento en particular.
Así es como se ve:
✓ Control: La página completa se muestra antes de la extracción.
Paso 3: Capturar el HTML
Devuelve el código HTML original o el código fuente de la página sin procesar después de la renderización.
✅ Resultado: Páginas web completamente renderizadas sin necesidad de gestionar controladores web.
💡 Consejo profesional: Agregue un escenario de JavaScript para hacer clic, desplazarse o completar formularios.
Cómo usar el raspador ChatGPT de ScrapingBee
ChatGPT Raspador Te permite capturar las respuestas y el código fuente de las páginas de chat dinámicas con IA.
Aquí te explicamos cómo usarlo paso a paso.
Paso 1: Seleccione la página
Envía la URL de la página con render_js activado.
Paso 2: Renderizar y extraer
Deja que el raspado sin cabeza cargue la respuesta, luego toma el texto.
Así es como se ve:
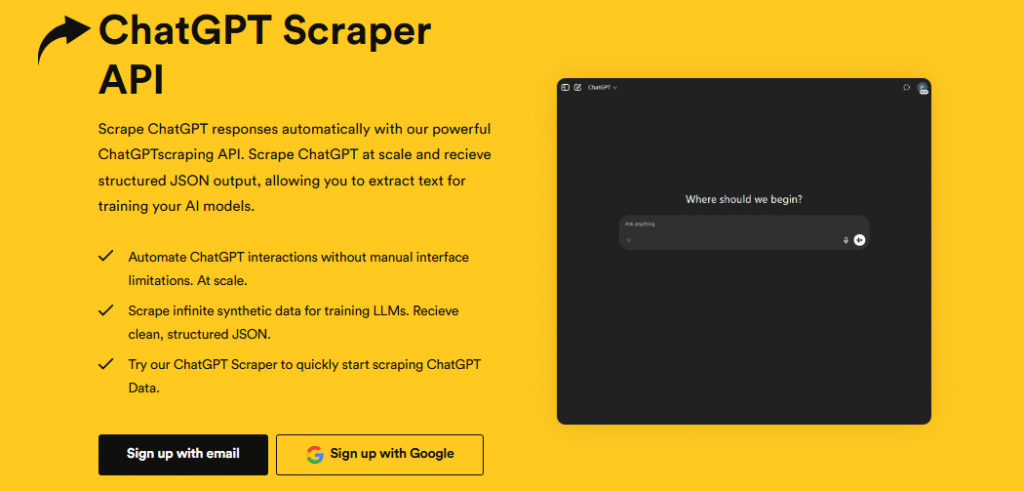
✓ Control: La respuesta generada se muestra en el código fuente de la página.
Paso 3: Guardar el resultado
Almacene el HTML analizado para su posterior procesamiento.
✅ Resultado: Texto limpio extraído de una página totalmente dinámica.
💡 Consejo profesional: Encadena un escenario de JavaScript para guiar al usuario a través de indicaciones de varios pasos.
Cómo usar la API de ScrapingBee para extraer noticias de Google.
API de extracción de noticias de Google Te permite obtener titulares y artículos completos mediante sencillas solicitudes a la API.
Aquí te explicamos cómo usarlo paso a paso.
Paso 1: Configurar el punto final de noticias
Dirige tu solicitud a la API de Google Noticias.
Paso 2: Agregar filtros
Filtra por tema, idioma o país aleatorio.
Así es como se ve:
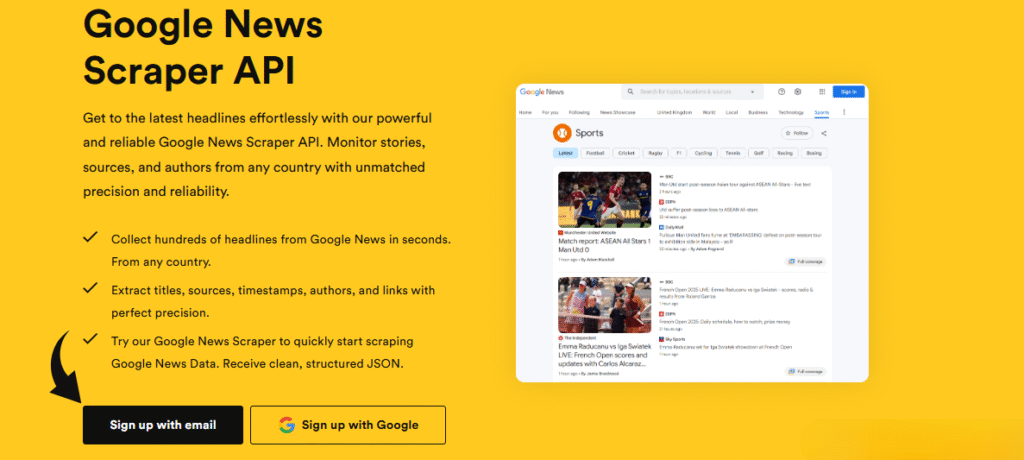
✓ Control: Los titulares coincidentes se devuelven como datos estructurados.
Paso 3: Recopilar artículos
Recorra los resultados para recopilar cada historia.
✅ Resultado: Noticias actualizadas directamente desde la API de Scrapingbee.
💡 Consejo profesional: Gire el código del país para comparar la cobertura regional.
Cómo usar ScrapingBee para la extracción rápida de datos
Extracción rápida de datos Te permite realizar un rastreo rápido de datos mientras ScrapingBee rota los proxies por ti.
Aquí te explicamos cómo usarlo paso a paso.
Paso 1: Elabore su solicitud
Reúna la URL, la clave API y los parámetros una sola vez.
Paso 2: Ejecutar llamadas simultáneas
Realizar múltiples solicitudes a la API simultáneamente.
Así es como se ve:
✓ Control: Las respuestas se reciben en paralelo.
Paso 3: Comprobar los códigos de estado
Confirme un código HTTP 200 para cada código de estado devuelto.
✅ Resultado: High-volume scraping handled on remote machines.
💡 Consejo profesional: ThreadPoolExecutor acelera drásticamente el rastreo de páginas web.
Cómo usar la API de captura de pantalla programática de ScrapingBee
API de captura de pantalla programática Te permite capturar una captura de pantalla de página completa de cualquier URL mediante programación.
Aquí te explicamos cómo usarlo paso a paso.
Paso 1: Añadir la bandera de captura de pantalla
Añade screenshot=true a tu solicitud de API.
Paso 2: Seleccione Página completa
Establezca full_page=true para capturar todo el diseño.
Así es como se ve:
✓ Control: Una imagen de página completa se muestra de borde a borde.
Paso 3: Descarga la imagen
Guarda el archivo devuelto en el disco.
✅ Resultado: Imágenes con una precisión de píxel perfecta, generadas bajo demanda.
💡 Consejo profesional: El parámetro full_page garantiza que la página completa se renderice primero.
Cómo usar ScrapingBee para extraer datos de Google Jobs
Extraer información de Google Jobs Te permite recopilar ofertas de empleo como información estructurada compleja.
Aquí te explicamos cómo usarlo paso a paso.
Paso 1: Llamar al punto final de trabajos
Envía tu puesto y ubicación a la API de empleos.
Paso 2: Filtrar los listados
Filtra los resultados por título, empresa o ciudad.
Así es como se ve:
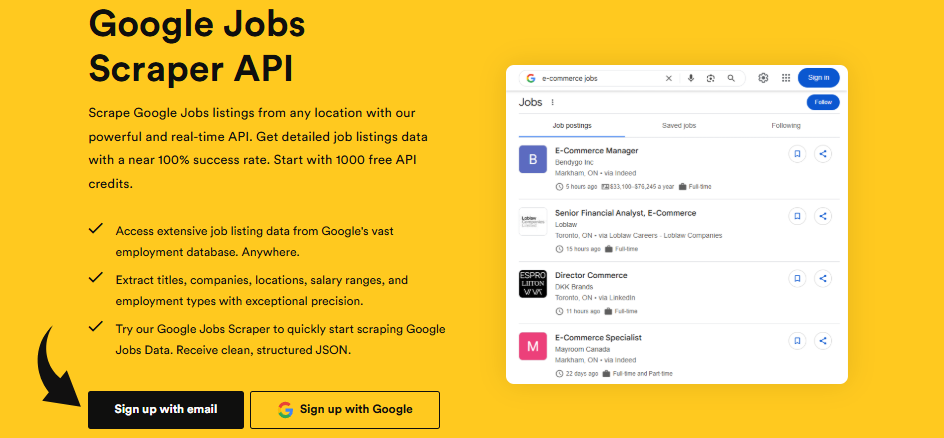
✓ Control: Las filas de trabajos se devuelven como JSON limpio.
Paso 3: Estructurar los datos
Analizar los campos HTML y convertirlos en una tabla ordenada.
✅ Resultado: Los datos del trabajo están listos para ser analizados y almacenados.
💡 Consejo profesional: Combínalo con selectores CSS para extraer campos personalizados.
Consejos y atajos profesionales de ScrapingBee
Tras probar ScrapingBee durante más de un año, aquí están mis mejores consejos para extraer información de sitios web.
Parámetros clave de la API
| Parámetro | Qué hace |
|---|---|
| render_js | Renderiza JavaScript en navegadores sin interfaz gráfica. |
| proxy premium | Cambia a direcciones IP de proxy residenciales |
| código_de_país | Establece la geolocalización del proxy premium por país aleatorio |
| bloquear anuncios | Te permite bloquear anuncios para acelerar las solicitudes. |
Características ocultas que la mayoría de la gente pasa por alto
- ID de sesión: Durante cinco minutos, las solicitudes a la API se enrutan a través de la misma dirección IP, de modo que se mantiene el mismo código HTTP y la misma sesión.
- página_de_retorno_origen: Devuelve el código HTML original y el código fuente completo de la página antes de que se ejecute cualquier JavaScript.
- Encabezados y cookies personalizados: Envía tus propios encabezados y cookies personalizados, o bien utiliza los encabezados predeterminados que genera ScrapingBee.
- Control de encabezado: Reemplaza un encabezado existente por uno nuevo, muestra los encabezados generados automáticamente y luego conserva solo algunos encabezados y descarta los demás.
Errores comunes que debes evitar en ScrapingBee
Error n.º 1: Ignorar robots.txt antes de extraer datos.
❌ Incorrecto: Realizar solicitudes a cualquier sitio que quieras rastrear sin comprobar primero las reglas.
✅ Derecha: Antes de extraer información de páginas web, revise el archivo robots.txt y los términos de servicio.
Error n.º 2: Olvidar habilitar la renderización de JavaScript
❌ Incorrecto: Espero contenido dinámico, pero siempre obtengo una página vacía.
✅ Derecha: Establece render_js=true para que los navegadores sin interfaz gráfica carguen primero la página completa.
Error n.° 3: Enviar solo los encabezados predeterminados
❌ Incorrecto: Confiar únicamente en los encabezados predeterminados, que algunos sitios marcan y bloquean.
✅ Derecha: Cuando quieras extraer datos, envía tus propios encabezados personalizados y un parámetro de agente de usuario real.
Solución de problemas de ScrapingBee
Problema: Código fuente de la página vacío o incompleto
Causa: El código JavaScript de la página nunca se procesó, por lo que el HTML apareció en blanco.
Arreglar: Establece render_js=true y espera a que un elemento en particular cargue la página completa.
Problema: Las solicitudes siguen siendo bloqueadas.
Causa: Las direcciones IP del proxy del centro de datos predeterminado fueron marcadas por el sitio de destino.
Arreglar: Habilita los proxies premium para que roten con una nueva dirección IP de un país aleatorio.
Problema: Ves un código HTTP 401 o 403.
Causa: Tu clave API es incorrecta o te has quedado sin crédito API.
Arreglar: Confirma la clave API, verifica tu código de estado y recarga tus créditos si es necesario.
📌 Nota: Si ninguna de estas soluciones resuelve su problema, póngase en contacto con el soporte técnico de ScrapingBee.
¿Qué es ScrapingBee?
Abeja raspadora Es una herramienta de web scraping basada en la nube que gestiona navegadores sin interfaz gráfica y rota los proxies automáticamente.
Imagínelo como un navegador alojado que usted controla a través de una API REST.
Mira este breve resumen:
Incluye estas características clave:
- Extracción de datos web mediante IA: Te permite extraer información estructurada compleja de páginas web utilizando un lenguaje sencillo.
- API de búsqueda de Google: Te permite extraer resultados de búsqueda de Google sin tener que gestionar manualmente las direcciones IP de los proxies.
- Extractor de datos de Google Shopping: Te permite recopilar listados de productos y el precio extraído para cualquier término de búsqueda.
- Extracción de datos web mediante JavaScript: Te permite gestionar la representación de JavaScript en páginas web creadas con React o Vue.
- Extractor de ChatGPT: Permite capturar las respuestas y el código fuente de las páginas de chat dinámicas con IA.
- API de extracción de noticias de Google: Te permite obtener titulares y artículos completos mediante sencillas solicitudes a la API.
- Extracción rápida de datos: Te permite realizar un rastreo rápido de datos mientras ScrapingBee rota los proxies por ti.
- API de captura de pantalla programática: Permite capturar mediante programación una captura de pantalla de página completa de cualquier URL.
- Extraer ofertas de empleo de Google: Te permite recopilar ofertas de empleo como información estructurada compleja.
Para una revisión completa, consulte nuestra Reseña de ScrapingBee.
Precios de ScrapingBee
Este es el precio de ScrapingBee en 2026:
| Plan | Precio | Mejor para |
|---|---|---|
| Independiente | $49/mes | Desarrolladores independientes y proyectos pequeños |
| Puesta en marcha | $99/mes | Equipos en crecimiento que escalan las solicitudes de API |
| Negocio | $249/mes | Cargas de trabajo de web scraping de alto volumen |
| Negocios+ | $599/mes | Equipos empresariales en máquinas remotas |
Prueba gratuita: Sí, 1000 llamadas a la API gratuitas, sin necesidad de tarjeta de crédito.
Garantía de devolución de dinero: Puedes cancelar cuando quieras; la facturación es mensual y sin permanencia obligatoria.
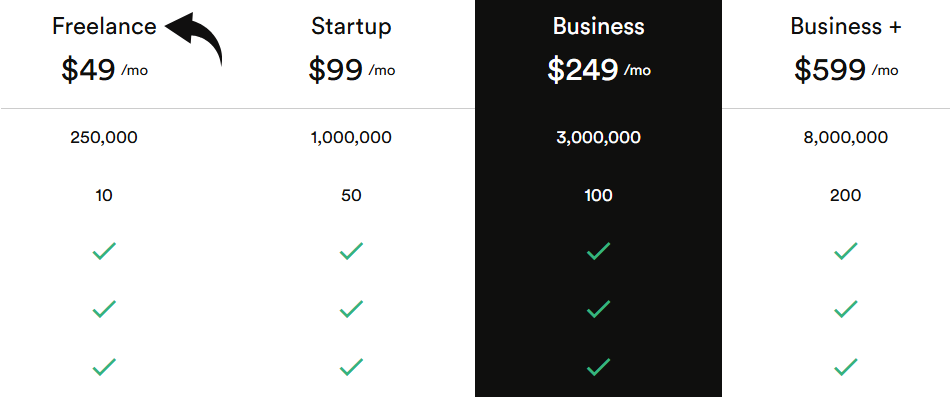
💰 Mejor relación calidad-precio: Startup: la mejor combinación de crédito de API y precio para la mayoría de los equipos.
ScrapingBee frente a alternativas
¿Cómo se compara ScrapingBee con la competencia? Este es el panorama competitivo:
Mira esta comparación:
| Herramienta | Mejor para | Precio | Clasificación |
|---|---|---|---|
| Abeja raspadora | Renderizado de JavaScript a través de una API REST | $49/mes | ⭐ 4.5 |
| Apificar | Actores raspadores prefabricados | Varía | ⭐ — |
| ScrapeGraphAI | Reglas de extracción basadas en IA | Varía | ⭐ — |
| Datos brillantes | Direcciones IP de proxy empresarial | Varía | ⭐ — |
| Navegar AI | Sin código, apuntar y hacer clic | Varía | ⭐ — |
| Oxylabs | Proxies empresariales premium | Varía | ⭐ — |
| Datos de Thor | Red proxy de presupuesto | Varía | ⭐ — |
| Zyte | API de extracción de datos para desarrolladores | Varía | ⭐ — |
| Raspador web.io | Captura de extensión del navegador | Varía | ⭐ — |
| Raspador de helio | Mapeo del sitio en escritorio | Varía | ⭐ — |
| Firecrawl | Descuento listo para LLM | Varía | ⭐ — |
Selecciones rápidas:
- Mejor en general: ScrapingBee: una API REST para renderizado, búsqueda y capturas de pantalla.
- Mejor presupuesto: ThorData: direcciones IP proxy económicas para fines sencillos de extracción de datos.
- Ideal para principiantes: Explora la IA: no se necesita código ni lenguaje de programación.
- Ideal para empresas: Bright Data: diseñado para operaciones de extracción de datos masivas y que cumplen con las normativas.
🎯 Alternativas a ScrapingBee
¿Buscas alternativas a ScrapingBee? Aquí tienes las mejores opciones:
- 🚀 Apify: Una plataforma completa de extracción de datos con actores predefinidos y un generoso plan gratuito para probar ideas rápidamente.
- 🧠 ScrapeGraphAI: Un programa de extracción de datos basado en inteligencia artificial que convierte simples indicaciones en reglas de extracción para información estructurada compleja.
- 🏢 Datos brillantes: Direcciones IP proxy y conjuntos de datos de nivel empresarial diseñados para operaciones de extracción de datos a gran escala y para el cumplimiento estricto de las normativas.
- 👶 Explorar la IA: Una herramienta sin código que registra tus clics para crear programas de extracción de datos sin necesidad de escribir código.
- 🔒 Oxylabs: Un proveedor de API de proxy y scraping de primera calidad con gran fiabilidad para cargas de trabajo empresariales exigentes.
- 💰 ThorData: Una red de proxies económica que cubre direcciones IP residenciales y de centros de datos para tareas cotidianas de extracción de datos.
- 🔧 Zyte: Una API de web scraping orientada a desarrolladores, anteriormente conocida como Scrapinghub, con gestión inteligente de bloqueos y código fuente de página limpio.
- 🎨 Webscraper.io: Una extensión de navegador que crea mapas del sitio visualmente dentro de Chrome para la captura de datos mediante clics.
- 💼 Raspador de helio: Una aplicación de escritorio para Windows que extrae datos de sitios web complejos sin depender de la nube.
- ⚡ Firecrawl: Un rastreador de IA que convierte sitios web completos en formato Markdown limpio para alimentar grandes modelos de lenguaje.
Para ver la lista completa, consulte nuestra Alternativas a ScrapingBee guía.
⚔️ Comparación de ScrapingBee
Así es como ScrapingBee se compara con cada uno de sus competidores:
- ScrapingBee vs Apify: Apify ofrece un mercado de programas para extraer datos; ScrapingBee destaca por su sencillo acceso a la API REST y una configuración más rápida.
- ScrapingBee vs ScrapeGraphAI: ScrapeGraphAI se basa completamente en la IA; ScrapingBee ofrece tanto extracción mediante IA como selectores CSS sin procesar.
- ScrapingBee vs Bright Data: Bright Data se adapta a las necesidades de las grandes empresas; ScrapingBee es más económico y sencillo para equipos pequeños y medianos.
- ScrapingBee vs Browse AI: Browse AI es ideal para personas sin conocimientos de programación; ScrapingBee es perfecto para desarrolladores que desean una API REST y control total.
- ScrapingBee vs Oxylabs: Oxylabs se dirige a grandes empresas; ScrapingBee ofrece precios de entrada más bajos y una curva de aprendizaje más sencilla.
- ScrapingBee vs ThorData: ThorData compite en precio por proxy; ScrapingBee combina renderizado, capturas de pantalla e IA en una sola API.
- ScrapingBee vs Zyte: Zyte tiene profundas raíces en el desarrollo de software; ScrapingBee es más adecuado para proyectos rápidos y equipos pequeños.
- ScrapingBee vs Webscraper.io: Webscraper.io se ejecuta en el navegador; ScrapingBee se encarga de la renderización de JavaScript en el servidor a escala real.
- ScrapingBee vs. Helium Scraper: Helium Scraper solo funciona en ordenadores de escritorio; ScrapingBee se ejecuta en la nube, por lo que no es necesario utilizar controladores web.
- ScrapingBee vs Firecrawl: Firecrawl se centra en las canalizaciones LLM; ScrapingBee abarca un rastreo más amplio con capturas de pantalla y API de búsqueda.
Empieza a usar ScrapingBee ahora
Aprendiste a usar todas las funciones principales de ScrapingBee:
- ✅ Extracción de datos web mediante IA
- ✅ API de búsqueda de Google
- ✅ Extractor de datos de Google Shopping
- ✅ Extracción de datos web con JavaScript
- ✅ Extractor de ChatGPT
- ✅ API de extracción de noticias de Google
- ✅ Extracción rápida de datos
- ✅ API de captura de pantalla programática
- ✅ Extraer ofertas de empleo de Google
Siguiente paso: Elige una función y pruébala ahora.
La mayoría de la gente empieza con el web scraping mediante IA.
Un primer proyecto popular consiste en crear un programa para extraer anuncios de OLX.
Durante el desarrollo, ScrapingBee ejecuta el navegador en máquinas remotas por usted.
Una vez que tu primer extractor de datos de OLX funcione correctamente, podrás explorar otras funciones.
Extraer la información de tu primera página lleva menos de cinco minutos.
Preguntas frecuentes
¿Cómo funciona ScrapingBee?
ScrapingBee es una herramienta de web scraping basada en la nube. Envías una solicitud con tu clave API y una URL, y te devuelve la página usando navegadores sin interfaz gráfica mientras rota los proxies automáticamente.
¿Cuánto cuesta ScrapingBee?
Los planes comienzan en $49/mes para Freelance, seguidos de $99 para Startup, $249 para Business y $599 para Business+. Una prueba gratuita te ofrece 1000 llamadas a la API para probar el web scraping.
¿Es ilegal el web scraping?
La extracción de datos de páginas web públicas es generalmente legal. Siempre revise primero el archivo robots.txt y los términos de servicio del sitio, evite recopilar datos personales y respete los límites de uso para evitar problemas.
¿ScrapingBee admite la renderización mediante JavaScript?
Sí. Si configuras render_js=true, ScrapingBee cargará las páginas web en navegadores sin interfaz gráfica. Este renderizado con JavaScript funciona sin problemas en sitios web creados con React o Vue.
¿Qué lenguajes de programación admite ScrapingBee?
Cualquiera. ScrapingBee es una API REST, así que puedes llamarla desde Python, Node, PHP o cualquier otro lenguaje. En Python, simplemente importa `requests` y envía tus solicitudes a la API.













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
