
เริ่มต้นใช้งานอย่างรวดเร็ว
คู่มือการใช้งาน ScrapingBee นี้ครอบคลุมทุกฟีเจอร์:
- เริ่มต้นใช้งาน — สร้างบัญชีของคุณและรับคีย์ API ของคุณ
- วิธีใช้งาน AI Web Scraping — ดึงข้อมูลที่มีโครงสร้างซับซ้อนจากหน้าเว็บโดยใช้ภาษาอังกฤษที่เข้าใจง่าย
- วิธีใช้งาน Google Search API — ดึงข้อมูลจากผลการค้นหาของ Google โดยไม่ต้องจัดการ IP พร็อกซีด้วยตนเอง
- วิธีใช้งาน Google Shopping Scraper — รวบรวมรายการสินค้าและราคาที่ได้จากการค้นหาคำใดๆ ก็ได้
- วิธีใช้งาน JavaScript ในการดึงข้อมูลจากเว็บไซต์ — จัดการการแสดงผล JavaScript บนหน้าเว็บที่สร้างด้วย React หรือ Vue
- วิธีใช้งาน ChatGPT Scraper — บันทึกการตอบกลับและซอร์สโค้ดของหน้าเว็บจากหน้าแชท AI แบบไดนามิก
- วิธีใช้งาน Google News Scraper API — ดึงหัวข้อข่าวและบทความฉบับเต็มได้ง่ายๆ ผ่านการร้องขอ API
- วิธีใช้งานการดึงข้อมูลอย่างรวดเร็ว — เรียกใช้การดึงข้อมูลอย่างรวดเร็วในขณะที่ ScrapingBee หมุนเวียนพร็อกซีให้คุณโดยอัตโนมัติ
- วิธีใช้งาน API การจับภาพหน้าจอแบบโปรแกรม — บันทึกภาพหน้าจอแบบเต็มหน้าของ URL ใดๆ ก็ได้โดยใช้โปรแกรม
- วิธีใช้งาน Scrape Google Jobs — รวบรวมรายการประกาศรับสมัครงานในรูปแบบข้อมูลที่มีโครงสร้างซับซ้อน
ระยะเวลาที่ใช้: แต่ละฟีเจอร์ใช้เวลา 5 นาที
นอกจากนี้ในคู่มือนี้ยังมี: เคล็ดลับสำหรับมืออาชีพ | ข้อผิดพลาดที่พบบ่อย | การแก้ไขปัญหา | ความละเอียด | ตัวเลือกต่าง ๆ
เหตุใดจึงควรเชื่อถือคู่มือนี้
ฉันใช้ ScrapingBee มานานกว่าหนึ่งปีแล้ว และได้ทดสอบฟีเจอร์ทุกอย่างในนี้แล้ว บทแนะนำนี้มาจากประสบการณ์การใช้งานจริง ไม่ใช่ภาพหน้าจอจากผู้ผลิต

ScrapingBee เป็นซอฟต์แวร์บนระบบคลาวด์ เครื่องมือขูด ซึ่งจัดการส่วนที่ยากที่สุดของการดึงข้อมูลจากเว็บไซต์
โปรแกรมนี้จัดการเบราว์เซอร์แบบไร้หน้าจอและหมุนเวียนพร็อกซีให้คุณโดยอัตโนมัติ
คู่มือนี้จะแสดงวิธีการใช้งานฟีเจอร์หลักแต่ละอย่างทีละขั้นตอน
พร้อมภาพหน้าจอ ตัวอย่างง่ายๆ และเคล็ดลับจากผู้เชี่ยวชาญตลอดทั้งบทความ
บทช่วยสอนการใช้งาน ScrapingBee
บทแนะนำการใช้งาน ScrapingBee ฉบับสมบูรณ์นี้จะพาคุณเรียนรู้ทุกฟีเจอร์ ตั้งแต่การเรียกใช้ API ครั้งแรก ไปจนถึงเทคนิคขั้นสูงเกี่ยวกับการใช้งาน JavaScript
สแครปปิ้งบี
ดึงข้อมูลจากเว็บไซต์ใดก็ได้โดยไม่ต้องจัดการ IP พร็อกซีหรือเบราว์เซอร์แบบ Headless ScrapingBee จัดการการแสดงผล JavaScript ผ่าน REST API ที่ใช้งานง่ายเพียงตัวเดียว เริ่มต้นใช้งาน API ฟรี 1000 ครั้ง โดยไม่ต้องใช้บัตรเครดิต
เริ่มต้นใช้งาน ScrapingBee
ก่อนใช้งานฟีเจอร์ใดๆ โปรดทำการตั้งค่าครั้งแรกนี้ให้เสร็จสมบูรณ์
ใช้เวลาประมาณสามนาที
ต่อไปนี้เป็นภาพรวมโดยย่อของขั้นตอนการทำงาน:
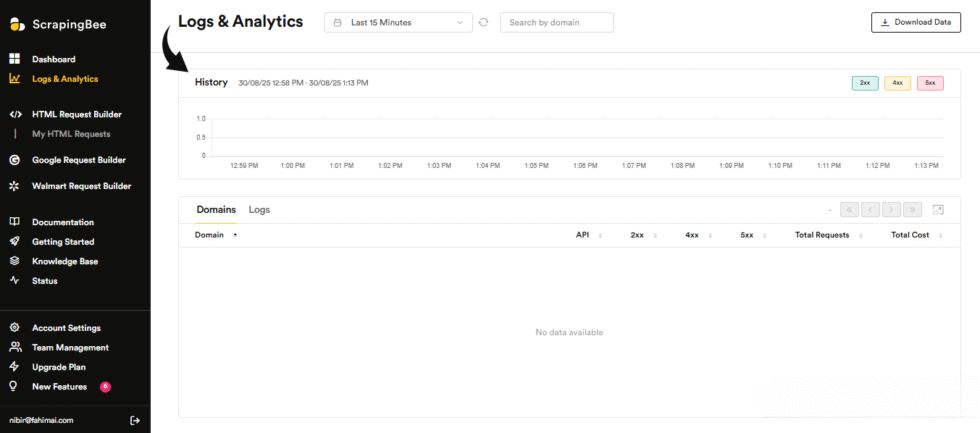
ต่อไปนี้เราจะมาดูแต่ละขั้นตอนกัน
ขั้นตอนที่ 1: สร้างบัญชีของคุณ
เข้าไปที่เว็บไซต์ ScrapingBee แล้วคลิก "ลงทะเบียน"
ใส่รหัสโปรโมชั่น ADNAN ผ่านลิงก์แนะนำเพื่อรับเครดิต API เพิ่มเติม
✓ ด่าน: หน้าแดชบอร์ดของคุณจะแสดงคีย์ API เฉพาะของคุณ
ขั้นตอนที่ 2: ตั้งค่าโค้ดของคุณ
ใน Python ให้รันคำสั่ง `pip install scrapingbee` หรือ `import requests` ก็ได้
ไลบรารี requests ช่วยให้คุณสามารถเรียกใช้ API จากภาษาโปรแกรมใดก็ได้
✓ ด่าน: สภาพแวดล้อมของคุณพร้อมสำหรับการส่งคำขอ API แล้ว
ขั้นตอนที่ 3: โทรออกครั้งแรก
ส่งคำขอไปยังเอนด์พอยต์ https://app.scrapingbee.com/api/v1/ พร้อมด้วยคีย์ API และ URL ของคุณ
ตัวอย่างง่ายๆ นี้ช่วยให้คุณสามารถดึงข้อมูลจากเว็บเพจได้ด้วยโค้ดเพียงไม่กี่บรรทัด
✅ เสร็จเรียบร้อยแล้ว: คุณพร้อมที่จะใช้งานฟีเจอร์ต่างๆ ด้านล่างแล้ว
วิธีใช้งาน ScrapingBee AI Web Scraping
การดึงข้อมูลจากเว็บไซต์ด้วย AI ช่วยให้คุณดึงข้อมูลที่มีโครงสร้างซับซ้อนจากหน้าเว็บโดยใช้ภาษาอังกฤษธรรมดาได้
นี่คือวิธีการใช้งานทีละขั้นตอน
ขั้นตอนที่ 1: รับคีย์ API ของคุณ
ลงทะเบียนและคัดลอกคีย์ API ของคุณจากแดชบอร์ด
ขั้นตอนที่ 2: อธิบายข้อมูล
เพิ่ม URL เป้าหมายและเขียนคำสั่งค้นหาเป็นภาษาอังกฤษธรรมดา
นี่คือตัวอย่าง:
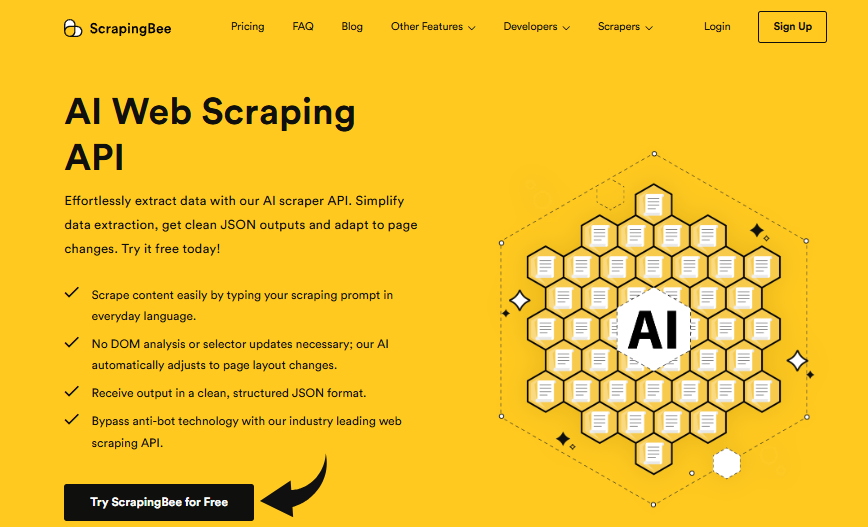
✓ ด่าน: อ็อบเจ็กต์ JSON ที่สะอาดตาจะปรากฏขึ้นพร้อมกับฟิลด์ที่คุณกำหนดไว้
ขั้นตอนที่ 3: กำหนดกฎการดึงข้อมูล
ปรับกฎการดึงข้อมูลของคุณเพื่อให้ได้ข้อมูลแต่ละฟิลด์อย่างแม่นยำ
✅ ผลลัพธ์: โครงสร้าง JSON โดยไม่ต้องเขียนตัวเลือก CSS ด้วยตนเอง
💡 เคล็ดลับสำหรับมืออาชีพ: ใช้การดึงข้อมูล AI ร่วมกับตัวเลือก CSS เมื่อคุณต้องการควบคุมอย่างแม่นยำ
วิธีใช้งาน ScrapingBee Google Search API
Google Search API ช่วยให้คุณสามารถดึงข้อมูลจากผลการค้นหาของ Google โดยไม่ต้องจัดการ IP พร็อกซีด้วยตนเอง
นี่คือวิธีการใช้งานทีละขั้นตอน
ขั้นตอนที่ 1: เลือกปลายทาง (Endpoint)
ส่งคำขอของคุณไปยัง Google Search API
ขั้นตอนที่ 2: ตั้งค่าคำสั่งค้นหา
เพิ่มคำหลักและประเทศแบบสุ่มเพื่อดูผลการค้นหาในพื้นที่ของคุณ
นี่คือตัวอย่าง:
✓ ด่าน: ผลลัพธ์ที่จัดอันดับจะแสดงในรูปแบบข้อมูลที่มีโครงสร้าง
ขั้นตอนที่ 3: อ่านไฟล์ JSON
วิเคราะห์การตอบกลับโดยใช้ไลบรารี requests ใน Python
✅ ผลลัพธ์: ค้นหาข้อมูลได้ง่ายๆ ด้วยการเรียกใช้ REST API เพียงครั้งเดียว
💡 เคล็ดลับสำหรับมืออาชีพ: ใช้ country_code สำหรับการระบุตำแหน่งทางภูมิศาสตร์ด้วยพร็อกซีระดับพรีเมียมในทุกการค้นหา
วิธีใช้งาน ScrapingBee Google Shopping Scraper
โปรแกรมดึงข้อมูลจาก Google Shopping ช่วยให้คุณรวบรวมรายการสินค้าและราคาที่ดึงมาได้สำหรับคำค้นหาใดๆ ก็ได้
นี่คือวิธีการใช้งานทีละขั้นตอน
ขั้นตอนที่ 1: ส่งคำขอซื้อสินค้า
โทรไปยังระบบช้อปปิ้งออนไลน์พร้อมระบุรายละเอียดสินค้าที่คุณต้องการค้นหา
ขั้นตอนที่ 2: วิเคราะห์คำตอบ
เชื่อมโยงข้อมูลแต่ละรายการกับชื่อเรื่อง ลิงก์ และราคาที่ดึงมาได้
นี่คือตัวอย่าง:
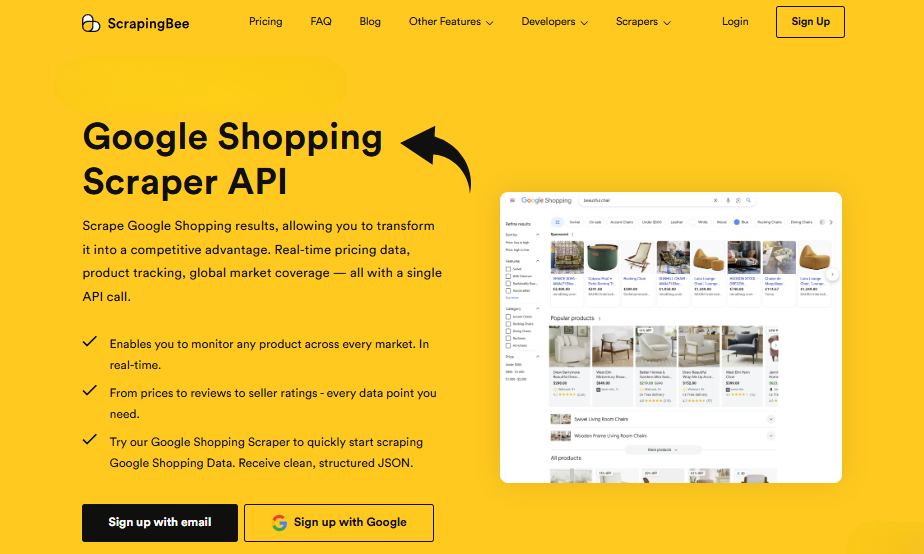
✓ ด่าน: ข้อมูลสินค้าจะถูกส่งกลับมาในรูปแบบ JSON ที่สะอาดตา
ขั้นตอนที่ 3: ส่งออกผลลัพธ์
บันทึกข้อมูลลงในไฟล์ CSV เพื่อนำไปวิเคราะห์เพิ่มเติม
✅ ผลลัพธ์: ข้อมูลราคาแบบเรียลไทม์พร้อมใช้งานสำหรับโปรแกรมสเปรดชีตทุกประเภท
💡 เคล็ดลับสำหรับมืออาชีพ: กำหนดเวลาการทำงานเพื่อติดตามราคาที่ดึงออกมาเมื่อเวลาผ่านไป
วิธีใช้งาน ScrapingBee JavaScript Web Scraping
การดึงข้อมูลจากเว็บด้วย JavaScript ช่วยให้คุณจัดการการแสดงผล JavaScript บนหน้าเว็บที่สร้างด้วย React หรือ Vue ได้
นี่คือวิธีการใช้งานทีละขั้นตอน
ขั้นตอนที่ 1: เปิดใช้งาน render_js
ตั้งค่า render_js=true เพื่อให้ ScrapingBee ใช้เบราว์เซอร์แบบ headless
ขั้นตอนที่ 2: รอองค์ประกอบ
สั่งให้รอจนกว่าองค์ประกอบที่ต้องการโหลดเสร็จสมบูรณ์
นี่คือตัวอย่าง:
✓ ด่าน: หน้าเว็บจะแสดงผลแบบเต็มก่อนที่จะทำการแยกข้อมูล
ขั้นตอนที่ 3: บันทึกโค้ด HTML
คืนค่า HTML ต้นฉบับหรือซอร์สโค้ดดิบของหน้าเว็บหลังจากแสดงผลเสร็จแล้ว
✅ ผลลัพธ์: แสดงผลเว็บเพจได้อย่างสมบูรณ์แบบโดยไม่ต้องจัดการไดรเวอร์เว็บ
💡 เคล็ดลับสำหรับมืออาชีพ: เพิ่มสถานการณ์ JavaScript สำหรับการคลิก การเลื่อน หรือการกรอกแบบฟอร์ม
วิธีใช้งาน ScrapingBee ChatGPT Scraper
แชทจีพีที สแครกเกอร์ ช่วยให้คุณสามารถบันทึกการตอบกลับและซอร์สโค้ดของหน้าแชท AI แบบไดนามิกได้
นี่คือวิธีการใช้งานทีละขั้นตอน
ขั้นตอนที่ 1: กำหนดเป้าหมายไปที่เพจ
ส่ง URL ของหน้าเว็บโดยเปิดใช้งาน render_js ไว้
ขั้นตอนที่ 2: แสดงผลและแยกข้อมูล
ปล่อยให้การดึงข้อมูลแบบไร้ส่วนหัวโหลดคำตอบ จากนั้นจึงดึงข้อมูล ข้อความ.
นี่คือตัวอย่าง:
✓ ด่าน: คำตอบที่แสดงผลจะปรากฏในซอร์สโค้ดของหน้าเว็บ
ขั้นตอนที่ 3: บันทึกผลลัพธ์
บันทึก HTML ที่แยกวิเคราะห์แล้วเพื่อนำไปประมวลผลในภายหลัง
✅ ผลลัพธ์: ข้อความที่สะอาดตา ดึงมาจากหน้าเว็บแบบไดนามิกเต็มรูปแบบ
💡 เคล็ดลับสำหรับมืออาชีพ: เชื่อมโยงสถานการณ์ JavaScript เข้าด้วยกันเพื่อดำเนินการตามขั้นตอนต่างๆ หลายขั้นตอน
วิธีใช้งาน ScrapingBee Google News Scraper API
API ดึงข้อมูลข่าวสารของ Google ช่วยให้คุณดึงหัวข้อข่าวและบทความฉบับเต็มได้ง่ายๆ ผ่านการร้องขอ API
นี่คือวิธีการใช้งานทีละขั้นตอน
ขั้นตอนที่ 1: ตั้งค่าปลายทางข่าวสาร
ส่งคำขอของคุณไปยัง Google News API
ขั้นตอนที่ 2: เพิ่มตัวกรอง
กรองตามหัวข้อ ภาษา หรือประเทศแบบสุ่ม
นี่คือตัวอย่าง:
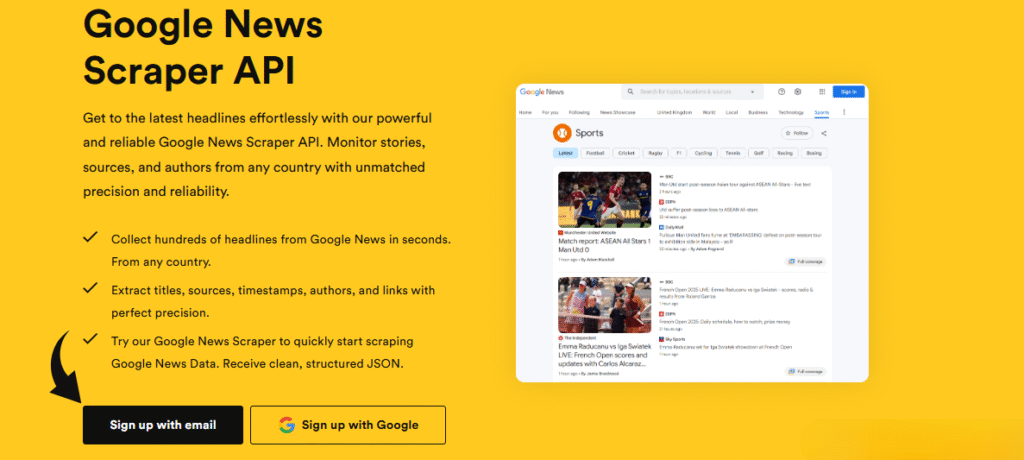
✓ ด่าน: หัวข้อข่าวที่ตรงกันจะถูกส่งกลับในรูปแบบข้อมูลที่มีโครงสร้าง
ขั้นตอนที่ 3: รวบรวมบทความ
วนลูปผ่านผลลัพธ์เพื่อรวบรวมเรื่องราวแต่ละเรื่อง
✅ ผลลัพธ์: ข้อมูลข่าวสารล่าสุดส่งตรงจาก API ของ Scrapingbee
💡 เคล็ดลับสำหรับมืออาชีพ: หมุนรหัสประเทศเพื่อเปรียบเทียบความครอบคลุมในแต่ละภูมิภาค
วิธีใช้งาน ScrapingBee เพื่อดึงข้อมูลอย่างรวดเร็ว
การดึงข้อมูลอย่างรวดเร็ว ช่วยให้คุณทำการดึงข้อมูลได้อย่างรวดเร็ว ในขณะที่ ScrapingBee จะหมุนเวียนพร็อกซีให้คุณโดยอัตโนมัติ
นี่คือวิธีการใช้งานทีละขั้นตอน
ขั้นตอนที่ 1: สร้างคำขอของคุณ
รวบรวม URL, คีย์ API และพารามิเตอร์เพียงครั้งเดียว
ขั้นตอนที่ 2: เรียกใช้การโทรพร้อมกัน
ส่งคำขอ API หลายรายการพร้อมกัน
นี่คือตัวอย่าง:
✓ ด่าน: คำตอบจะถูกส่งกลับมาพร้อมกัน
ขั้นตอนที่ 3: ตรวจสอบรหัสสถานะ
ยืนยันว่าได้รับรหัส HTTP 200 ในทุกรหัสสถานะที่ส่งคืน
✅ ผลลัพธ์: High-volume scraping handled on remote machines.
💡 เคล็ดลับสำหรับมืออาชีพ: ThreadPoolExecutor ช่วยเพิ่มความเร็วในการดึงข้อมูลจากเว็บเพจได้อย่างมาก
วิธีใช้งาน ScrapingBee Programmatic Screenshot API
API การจับภาพหน้าจอแบบโปรแกรม ช่วยให้คุณสามารถจับภาพหน้าจอแบบเต็มหน้าจาก URL ใดๆ ก็ได้โดยใช้โปรแกรม
นี่คือวิธีการใช้งานทีละขั้นตอน
ขั้นตอนที่ 1: เพิ่มแฟล็กการจับภาพหน้าจอ
เพิ่ม screenshot=true ต่อท้ายคำขอ API ของคุณ
ขั้นตอนที่ 2: เลือก "เต็มหน้า"
ตั้งค่า full_page=true เพื่อจับภาพเค้าโครงทั้งหมด
นี่คือตัวอย่าง:
✓ ด่าน: ภาพเต็มหน้าจอจะแสดงผลเต็มขอบ
ขั้นตอนที่ 3: ดาวน์โหลดรูปภาพ
บันทึกไฟล์ที่ส่งคืนลงในดิสก์
✅ ผลลัพธ์: บันทึกภาพคมชัดระดับพิกเซลตามต้องการ
💡 เคล็ดลับสำหรับมืออาชีพ: พารามิเตอร์ full_page ช่วยให้มั่นใจได้ว่าหน้าเว็บทั้งหมดจะแสดงผลก่อน
วิธีใช้ ScrapingBee เพื่อดึงข้อมูลงานจาก Google
ดึงข้อมูลจาก Google Jobs ช่วยให้คุณรวบรวมรายการประกาศรับสมัครงานในรูปแบบข้อมูลที่มีโครงสร้างซับซ้อน
นี่คือวิธีการใช้งานทีละขั้นตอน
ขั้นตอนที่ 1: เรียกใช้เอนด์พอยต์งาน
ส่งรายละเอียดตำแหน่งงานและสถานที่ทำงานของคุณไปยัง API สำหรับงานต่างๆ
ขั้นตอนที่ 2: กรองรายการ
จำกัดผลการค้นหาตามชื่อเรื่อง บริษัท หรือเมือง
นี่คือตัวอย่าง:
✓ ด่าน: ข้อมูลงานจะถูกส่งกลับในรูปแบบ JSON ที่สะอาดตา
ขั้นตอนที่ 3: จัดโครงสร้างข้อมูล
แปลงข้อมูล HTML ให้อยู่ในรูปแบบตารางที่เรียบร้อย
✅ ผลลัพธ์: ข้อมูลงานพร้อมสำหรับการวิเคราะห์และจัดเก็บ
💡 เคล็ดลับสำหรับมืออาชีพ: ใช้ร่วมกับตัวเลือก CSS เพื่อดึงข้อมูลฟิลด์ที่กำหนดเอง
เคล็ดลับและทางลัดการใช้งาน ScrapingBee Pro
หลังจากทดสอบใช้งาน ScrapingBee มานานกว่าหนึ่งปี นี่คือเคล็ดลับที่ดีที่สุดสำหรับการดึงข้อมูลจากเว็บไซต์ต่างๆ
พารามิเตอร์ API หลัก
| พารามิเตอร์ | มันทำอะไรได้บ้าง |
|---|---|
| เรนเดอร์_เจเอส | แสดงผล JavaScript ในเบราว์เซอร์แบบ Headless |
| พร็อกซีพรีเมียม | เปลี่ยนไปใช้ IP พร็อกซีที่อยู่อาศัย |
| รหัสประเทศ | ตั้งค่าตำแหน่งทางภูมิศาสตร์ของพร็อกซีระดับพรีเมียมโดยสุ่มประเทศ |
| บล็อกโฆษณา | ช่วยให้คุณบล็อกโฆษณาเพื่อเร่งความเร็วในการร้องขอ |
คุณสมบัติที่ซ่อนอยู่ซึ่งคนส่วนใหญ่มองข้ามไป
- รหัสเซสชัน: การตั้งค่านี้จะส่งคำขอ API ผ่านที่อยู่ IP เดียวกันเป็นเวลาห้านาที เพื่อให้คุณใช้รหัส HTTP และเซสชันเดิมได้
- แหล่งที่มาของหน้าเว็บ: ส่งคืนโค้ด HTML ต้นฉบับและซอร์สโค้ดของหน้าเว็บทั้งหมดก่อนที่ JavaScript จะทำงาน
- ส่วนหัวและคุกกี้แบบกำหนดเอง: ส่งส่วนหัวและคุกกี้ที่คุณกำหนดเอง หรือใช้ส่วนหัวเริ่มต้นที่ ScrapingBee สร้างขึ้นก็ได้
- การควบคุมส่วนหัว: สลับส่วนหัวที่มีอยู่กับส่วนหัวใหม่ แสดงส่วนหัวที่สร้างขึ้นโดยอัตโนมัติ จากนั้นเลือกเก็บเฉพาะส่วนหัวที่ต้องการและลบส่วนหัวอื่นๆ ออก
ข้อผิดพลาดทั่วไปที่ควรหลีกเลี่ยงในการใช้งาน ScrapingBee
ข้อผิดพลาดที่ 1: ไม่สนใจไฟล์ robots.txt ก่อนทำการดึงข้อมูล
❌ ผิด: การส่งคำขอไปยังเว็บไซต์ใดก็ได้ที่คุณต้องการดึงข้อมูลโดยไม่ต้องตรวจสอบกฎก่อน
✅ ด้านขวา: ตรวจสอบไฟล์ robots.txt และข้อกำหนดในการให้บริการก่อนทำการคัดลอกข้อมูลจากเว็บเพจ
ข้อผิดพลาดที่ 2: ลืมเปิดใช้งานการแสดงผล JavaScript
❌ ผิด: คาดหวังเนื้อหาแบบไดนามิก แต่กลับได้ซอร์สโค้ดว่างเปล่าทุกครั้ง
✅ ด้านขวา: ตั้งค่า render_js=true เพื่อให้เบราว์เซอร์แบบ headless โหลดหน้าเว็บแบบเต็มก่อน
ข้อผิดพลาดที่ 3: ส่งเฉพาะส่วนหัวเริ่มต้นเท่านั้น
❌ ผิด: การพึ่งพาเฉพาะส่วนหัวเริ่มต้นเพียงอย่างเดียว ซึ่งบางเว็บไซต์อาจตรวจจับและบล็อกได้
✅ ด้านขวา: ส่งส่วนหัวที่กำหนดเองและพารามิเตอร์ User Agent จริงเมื่อคุณต้องการดึงข้อมูล
การแก้ไขปัญหา ScrapingBee
ปัญหา: ซอร์สโค้ดของหน้าเว็บว่างเปล่าหรือมีเพียงบางส่วน
สาเหตุ: โค้ด JavaScript บนหน้าเว็บไม่แสดงผล ทำให้หน้า HTML แสดงผลว่างเปล่า
แก้ไข: ตั้งค่า render_js=true แล้วรอจนกว่าองค์ประกอบที่ต้องการโหลดหน้าเว็บเสร็จสมบูรณ์
ปัญหา: คำขอถูกบล็อกอยู่เรื่อยๆ
สาเหตุ: ที่อยู่ IP ของพร็อกซีศูนย์ข้อมูลเริ่มต้นถูกระบุโดยไซต์เป้าหมาย
แก้ไข: เปิดใช้งานพร็อกซีระดับพรีเมียมเพื่อสลับใช้ที่อยู่ IP ใหม่จากประเทศแบบสุ่ม
ปัญหา: คุณเห็นรหัส HTTP 401 หรือ 403
สาเหตุ: รหัส API ของคุณไม่ถูกต้อง หรือคุณไม่มีเครดิต API เหลือแล้ว
แก้ไข: ยืนยันรหัส API ตรวจสอบรหัสสถานะ และเติมเครดิตหากจำเป็น
📌 บันทึก: หากวิธีเหล่านี้ไม่สามารถแก้ไขปัญหาของคุณได้ โปรดติดต่อฝ่ายสนับสนุนของ ScrapingBee
ScrapingBee คืออะไร?
สแครปปิ้งบี เป็นเครื่องมือดึงข้อมูลจากเว็บไซต์บนระบบคลาวด์ที่รองรับเบราว์เซอร์แบบ Headless และหมุนเวียนพร็อกซีให้คุณโดยอัตโนมัติ
ลองนึกภาพว่าเป็นเบราว์เซอร์ที่ให้บริการโดยผู้ให้บริการ ซึ่งคุณสามารถควบคุมได้ผ่านทาง REST API
ชมภาพรวมโดยย่อนี้:
ประกอบด้วยคุณสมบัติหลักดังต่อไปนี้:
- การดึงข้อมูลจากเว็บไซต์ด้วย AI: ช่วยให้คุณดึงข้อมูลที่มีโครงสร้างซับซ้อนจากหน้าเว็บโดยใช้ภาษาอังกฤษธรรมดาได้
- Google Search API: ช่วยให้คุณดึงข้อมูลจากผลการค้นหาของ Google โดยไม่ต้องจัดการ IP พร็อกซีด้วยตนเอง
- โปรแกรมดึงข้อมูล Google Shopping: ช่วยให้คุณรวบรวมรายการสินค้าและราคาที่ดึงมาได้สำหรับคำค้นหาใดๆ ก็ได้
- การดึงข้อมูลจากเว็บไซต์ด้วย JavaScript: ช่วยให้คุณจัดการการแสดงผล JavaScript บนหน้าเว็บที่สร้างด้วย React หรือ Vue ได้
- โปรแกรมดึงข้อมูล ChatGPT: ช่วยให้คุณบันทึกการตอบกลับและซอร์สโค้ดของหน้าเว็บจากหน้าแชท AI แบบไดนามิกได้
- API สำหรับดึงข้อมูลข่าวสารจาก Google: ช่วยให้คุณดึงหัวข้อข่าวและบทความฉบับเต็มได้ง่ายๆ ผ่านการร้องขอ API
- การดึงข้อมูลอย่างรวดเร็ว: ช่วยให้คุณทำการดึงข้อมูลได้อย่างรวดเร็ว ในขณะที่ ScrapingBee จะหมุนเวียนพร็อกซีให้คุณโดยอัตโนมัติ
- API การจับภาพหน้าจอแบบโปรแกรม: ช่วยให้คุณสามารถจับภาพหน้าจอแบบเต็มหน้าจาก URL ใดๆ ก็ได้โดยใช้โปรแกรม
- ดึงข้อมูลจาก Google Jobs: ช่วยให้คุณรวบรวมรายการประกาศรับสมัครงานในรูปแบบข้อมูลที่มีโครงสร้างซับซ้อน
สำหรับรีวิวฉบับเต็ม โปรดดูที่หน้าของเรา รีวิว ScrapingBee.
ราคาของ ScrapingBee
ต่อไปนี้คือราคาของ ScrapingBee ในปี 2026:
| วางแผน | ราคา | เหมาะสำหรับ |
|---|---|---|
| ฟรีแลนซ์ | 49 ดอลลาร์/เดือน | นักพัฒนาอิสระและโครงการขนาดเล็ก |
| สตาร์ทอัพ | 99 ดอลลาร์/เดือน | ทีมที่กำลังเติบโตรองรับการรองรับคำขอ API ที่เพิ่มขึ้น |
| ธุรกิจ | 249 ดอลลาร์/เดือน | งานดึงข้อมูลจากเว็บไซต์ปริมาณมาก |
| ธุรกิจ+ | 599 ดอลลาร์/เดือน | ทีมงานระดับองค์กรที่ทำงานบนเครื่องคอมพิวเตอร์ระยะไกล |
ทดลองใช้งานฟรี: ใช่ — เรียกใช้ API ฟรี 1000 ครั้ง ไม่ต้องใช้บัตรเครดิต
รับประกันคืนเงิน: ยกเลิกได้ทุกเมื่อ คิดค่าบริการรายเดือน ไม่มีข้อผูกมัด
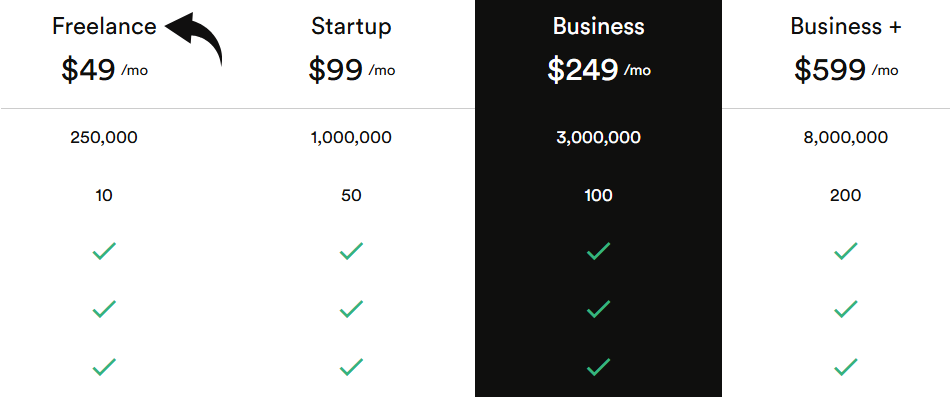
💰 คุ้มค่าที่สุด: Startup — ตัวเลือกที่ลงตัวที่สุดระหว่างเครดิต API และราคาสำหรับทีมส่วนใหญ่
ScrapingBee เทียบกับทางเลือกอื่นๆ
ScrapingBee เป็นอย่างไรเมื่อเทียบกับคู่แข่ง? นี่คือภาพรวมของคู่แข่ง:
ลองชมการเปรียบเทียบนี้:
| เครื่องมือ | เหมาะสำหรับ | ราคา | การให้คะแนน |
|---|---|---|---|
| สแครปปิ้งบี | การเรนเดอร์ JavaScript ผ่าน REST API หนึ่งตัว | 49 ดอลลาร์/เดือน | ⭐ 4.5 |
| อะพิฟาย | นักแสดงขูดสำเร็จรูป | แตกต่างกันไป | ⭐ — |
| สแครปกราฟ AI | กฎการสกัดที่ขับเคลื่อนด้วย AI | แตกต่างกันไป | ⭐ — |
| ข้อมูลสดใส | IP พร็อกซีขององค์กร | แตกต่างกันไป | ⭐ — |
| เรียกดู AI | ไม่ต้องเขียนโค้ด เพียงแค่คลิก | แตกต่างกันไป | ⭐ — |
| ออกซี่แล็บส์ | พร็อกซีระดับองค์กรพรีเมียม | แตกต่างกันไป | ⭐ — |
| ธอร์ดาต้า | เครือข่ายพร็อกซีงบประมาณ | แตกต่างกันไป | ⭐ — |
| ไซท์ | นักพัฒนาซอฟต์แวร์กำลังดึงข้อมูลจาก API | แตกต่างกันไป | ⭐ — |
| เว็บสแครปเปอร์.io | การจับภาพส่วนขยายเบราว์เซอร์ | แตกต่างกันไป | ⭐ — |
| เครื่องขูดฮีเลียม | แผนผังเว็บไซต์บนเดสก์ท็อป | แตกต่างกันไป | ⭐ — |
| ไฟร์ครอว์ล | มาร์คดาวน์พร้อมสำหรับ LLM | แตกต่างกันไป | ⭐ — |
ตัวเลือกที่น่าสนใจ:
- ดีที่สุดโดยรวม: ScrapingBee — REST API เดียวสำหรับแสดงผล ค้นหา และจับภาพหน้าจอ
- งบประมาณที่ดีที่สุด: ThorData — บริการพร็อกซี IP ราคาประหยัด สำหรับการดึงข้อมูลแบบง่ายๆ
- เหมาะสำหรับผู้เริ่มต้น: เรียกดูเว็บไซต์ด้วย AI — ไม่ต้องเขียนโค้ดหรือเรียนรู้ภาษาโปรแกรมใดๆ
- เหมาะสำหรับองค์กรธุรกิจ: Bright Data — สร้างขึ้นมาเพื่อรองรับการดำเนินการดึงข้อมูลขนาดใหญ่ที่เป็นไปตามข้อกำหนด
🎯 ทางเลือกอื่นแทน ScrapingBee
กำลังมองหาทางเลือกอื่นแทน ScrapingBee อยู่ใช่ไหม? นี่คือตัวเลือกที่ดีที่สุด:
- 🚀 อะพิฟาย: แพลตฟอร์มการดึงข้อมูลแบบครบวงจร พร้อมตัวละครสำเร็จรูป และแพ็กเกจฟรีที่เอื้อต่อการทดสอบไอเดียอย่างรวดเร็ว
- 🧠 ScrapeGraphAI: โปรแกรมดึงข้อมูลที่ใช้ AI เป็นหลัก ซึ่งแปลงข้อความแจ้งธรรมดาให้เป็นกฎการดึงข้อมูลสำหรับข้อมูลที่มีโครงสร้างซับซ้อน
- 🏢 ข้อมูลอันสดใส: IP พร็อกซีและชุดข้อมูลระดับองค์กรที่สร้างขึ้นเพื่อรองรับการดำเนินการดึงข้อมูลขนาดใหญ่มากและการปฏิบัติตามกฎระเบียบอย่างเคร่งครัด
- 👶 เรียกดู AI: เครื่องมือที่ไม่ต้องเขียนโค้ด บันทึกการคลิกของคุณเพื่อสร้างโปรแกรมดึงข้อมูลโดยไม่ต้องเขียนโค้ดใดๆ
- 🔒 ออกซีแล็บส์: ผู้ให้บริการ API พร็อกซีและสแครปเปอร์ระดับพรีเมียมที่มีความน่าเชื่อถือสูงสำหรับงานระดับองค์กรที่ต้องการประสิทธิภาพสูง
- 💰 ธอร์ดาต้า: เครือข่ายพร็อกซีราคาประหยัด ครอบคลุมทั้ง IP พร็อกซีสำหรับใช้งานในบ้านและศูนย์ข้อมูล สำหรับงานดึงข้อมูลทั่วไปในชีวิตประจำวัน
- 🔧 ไซท์: API สำหรับการดึงข้อมูลจากเว็บไซต์ที่เน้นนักพัฒนาซอฟต์แวร์ เดิมชื่อ Scrapinghub พร้อมระบบจัดการการแบนอัจฉริยะและซอร์สโค้ดที่สะอาดตา
- 🎨 Webscraper.io: ส่วนเสริมสำหรับเบราว์เซอร์ที่สร้างแผนผังเว็บไซต์แบบเห็นภาพภายใน Chrome เพื่อให้สามารถดึงข้อมูลได้ด้วยการคลิกเมาส์
- 💼 เครื่องขูดฮีเลียม: แอปพลิเคชันสำหรับเดสก์ท็อปบนระบบปฏิบัติการ Windows ที่สามารถสร้างแผนที่เว็บไซต์ที่ซับซ้อนได้โดยไม่ต้องพึ่งพาระบบคลาวด์
- ⚡ ไฟร์ครอว์ล: โปรแกรม AI สำหรับรวบรวมข้อมูลเว็บไซต์ ซึ่งแปลงเว็บไซต์ทั้งหมดให้เป็น Markdown ที่สะอาดตา เพื่อใช้เป็นข้อมูลป้อนเข้าสำหรับโมเดลภาษาขนาดใหญ่
ดูรายชื่อทั้งหมดได้ที่หน้าของเรา ทางเลือกอื่นนอกเหนือจาก ScrapingBee แนะนำ.
⚔️ เปรียบเทียบ ScrapingBee
ต่อไปนี้คือการเปรียบเทียบ ScrapingBee กับคู่แข่งแต่ละราย:
- ScrapingBee เทียบกับ Apify: Apify นำเสนอแพลตฟอร์มสำหรับรวบรวมโปรแกรมดึงข้อมูล (scraper) แต่ ScrapingBee โดดเด่นในเรื่องการเข้าถึง REST API ที่ง่ายกว่าและการตั้งค่าที่รวดเร็วกว่า
- ScrapingBee เทียบกับ ScrapeGraphAI: ScrapeGraphAI ใช้ AI อย่างเต็มรูปแบบ ในขณะที่ ScrapingBee ให้ทั้งการดึงข้อมูลด้วย AI และตัวเลือก CSS ดิบ
- ScrapingBee เทียบกับ Bright Data: Bright Data เหมาะสำหรับองค์กรขนาดใหญ่ ในขณะที่ ScrapingBee มีราคาถูกกว่าและใช้งานง่ายกว่า เหมาะสำหรับทีมขนาดเล็กถึงขนาดกลาง
- ScrapingBee เทียบกับ Browse AI: Browse AI เหมาะสำหรับผู้ที่ไม่ใช่โปรแกรมเมอร์ ในขณะที่ ScrapingBee เหมาะสำหรับนักพัฒนาที่ต้องการ REST API และการควบคุมอย่างเต็มที่
- ScrapingBee เทียบกับ Oxylabs: Oxylabs มุ่งเป้าไปที่องค์กรขนาดใหญ่ ในขณะที่ ScrapingBee มีราคาเริ่มต้นที่ต่ำกว่าและเรียนรู้ได้ง่ายกว่า
- ScrapingBee เทียบกับ ThorData: ThorData แข่งขันด้านราคาพร็อกซี ในขณะที่ ScrapingBee ผสานการแสดงผล การจับภาพหน้าจอ และ AI เข้าไว้ใน API เดียว
- ScrapingBee เทียบกับ Zyte: Zyte มีรากฐานมาจากนักพัฒนาซอฟต์แวร์ที่แข็งแกร่ง ในขณะที่ ScrapingBee เป็นมิตรกับผู้ใช้งานมากกว่าสำหรับโครงการขนาดเล็กและทีมขนาดเล็ก
- ScrapingBee เทียบกับ Webscraper.io: Webscraper.io ทำงานในเบราว์เซอร์ ในขณะที่ ScrapingBee จัดการการเรนเดอร์ JavaScript ฝั่งเซิร์ฟเวอร์ในระดับที่ใช้งานจริง
- ScrapingBee เทียบกับ Helium Scraper: Helium Scraper ใช้ได้เฉพาะบนเดสก์ท็อปเท่านั้น ส่วน ScrapingBee ทำงานบนระบบคลาวด์ จึงไม่ต้องใช้เว็บไดรเวอร์เลย
- ScrapingBee ปะทะ Firecrawl: Firecrawl มุ่งเป้าไปที่ไปป์ไลน์ LLM ในขณะที่ ScrapingBee ครอบคลุมการดึงข้อมูลที่กว้างกว่าด้วยการจับภาพหน้าจอและ API สำหรับการค้นหา
เริ่มใช้งาน ScrapingBee ได้เลย
คุณได้เรียนรู้วิธีการใช้งานฟีเจอร์หลักๆ ของ ScrapingBee แล้ว:
- ✅ การดึงข้อมูลจากเว็บไซต์ด้วย AI
- ✅ Google Search API
- ✅ โปรแกรมดึงข้อมูลจาก Google Shopping
- ✅ การดึงข้อมูลจากเว็บด้วย JavaScript
- ✅ โปรแกรมดึงข้อมูล ChatGPT
- ✅ API สำหรับดึงข้อมูลจาก Google News
- ✅ การดึงข้อมูลอย่างรวดเร็ว
- ✅ API การจับภาพหน้าจอแบบโปรแกรม
- ✅ ดึงข้อมูลจาก Google Jobs
ขั้นตอนต่อไป: เลือกฟีเจอร์หนึ่งอย่างแล้วลองใช้ดูเลย
คนส่วนใหญ่เริ่มต้นด้วยการใช้ AI ในการดึงข้อมูลจากเว็บไซต์
โปรเจกต์แรกที่นิยมทำกันคือการสร้างโปรแกรมดึงข้อมูลจากเว็บไซต์ OLX เพื่อดึงรายการสินค้ามาลงขาย
ในระหว่างการพัฒนา ScrapingBee จะเรียกใช้เบราว์เซอร์บนเครื่องระยะไกลให้คุณ
เมื่อโปรแกรมดึงข้อมูลจาก OLX ตัวแรกของคุณใช้งานได้แล้ว ลองสำรวจคุณสมบัติอื่นๆ เพิ่มเติม
การดึงข้อมูลจากหน้าแรกใช้เวลาน้อยกว่าห้านาที
ถาม บ่อย ๆ
ScrapingBee ทำงานอย่างไร?
ScrapingBee เป็นเครื่องมือดึงข้อมูลจากเว็บไซต์แบบคลาวด์ คุณส่งคำขอพร้อมคีย์ API และ URL จากนั้นมันจะส่งหน้าเว็บกลับมาโดยใช้เบราว์เซอร์แบบ Headless พร้อมทั้งหมุนเวียนพร็อกซีให้คุณโดยอัตโนมัติ
ScrapingBee มีราคาเท่าไหร่?
แพ็กเกจเริ่มต้นที่ 49 ดอลลาร์สหรัฐฯ ต่อเดือนสำหรับฟรีแลนซ์ ตามด้วย 99 ดอลลาร์สหรัฐฯ สำหรับสตาร์ทอัพ 249 ดอลลาร์สหรัฐฯ สำหรับธุรกิจ และ 599 ดอลลาร์สหรัฐฯ สำหรับธุรกิจขั้นสูงขึ้นไป ทดลองใช้งานฟรี 1,000 ครั้ง เพื่อทดสอบการดึงข้อมูล (scraping)
การดึงข้อมูลจากเว็บไซต์ (Web scraping) ผิดกฎหมายหรือไม่?
โดยทั่วไปแล้ว การคัดลอกข้อมูลจากเว็บเพจสาธารณะนั้นถูกกฎหมาย ควรตรวจสอบไฟล์ robots.txt และข้อกำหนดของเว็บไซต์ก่อนเสมอ หลีกเลี่ยงการใช้ข้อมูลส่วนบุคคล และเคารพข้อจำกัดในการใช้งาน เพื่อความปลอดภัย
ScrapingBee รองรับการแสดงผลด้วย JavaScript หรือไม่?
ใช่แล้ว ตั้งค่า render_js=true แล้ว ScrapingBee จะโหลดเว็บเพจในเบราว์เซอร์แบบ headless การแสดงผล JavaScript นี้ใช้งานได้กับเว็บไซต์ที่สร้างด้วย React หรือ Vue โดยไม่ต้องตั้งค่าเพิ่มเติม
ScrapingBee รองรับภาษาโปรแกรมใดบ้าง?
ScrapingBee เป็น REST API ดังนั้นคุณสามารถเรียกใช้ได้จาก Python, Node.js, PHP หรือภาษาใดก็ได้ ใน Python เพียงแค่ import requests และส่งคำขอ API ของคุณ













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
