
Início rápido
Este guia abrange todos os recursos do Firecrawl:
- Começando — Crie uma conta no Firecrawl e defina sua chave de API.
- Como usar o Scrape — Extrair dados prontos para LLM de páginas web individuais
- Como usar o Crawl — Analise sites inteiros e siga todos os links.
- Como usar a pesquisa — Pesquise na web dados da web em tempo real
- Como usar o mapa — Execute a descoberta de URLs em páginas individuais.
- Como usar o extrato — Extrair dados estruturados com instruções em linguagem natural
Tempo necessário: 5 minutos por filme
Neste guia também: Dicas profissionais | Erros comuns | Solução de problemas | Preços | Alternativas
Por que confiar neste guia?
Utilizo o Firecrawl há mais de um ano e testei todos os recursos abordados aqui.
Este tutorial sobre como usar o Firecrawl é baseado em experiência prática real de web scraping.

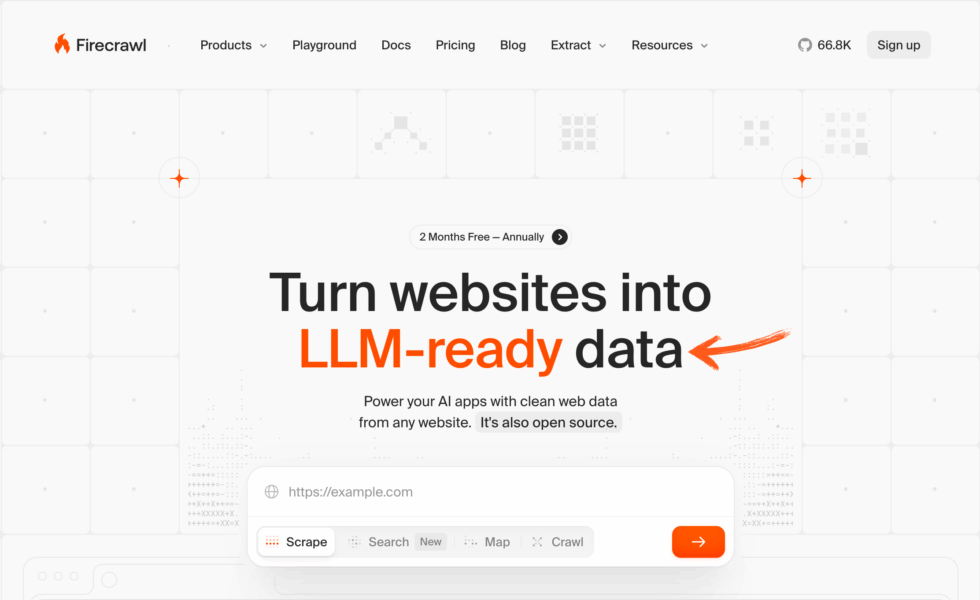
O Firecrawl é um rastreador web com inteligência artificial que transforma sites em dados limpos e prontos para o LLM (Laboratório de Gestão de Recursos).
Mas a maioria dos usuários apenas arranha a superfície do que essa ferramenta versátil pode fazer.
Este guia mostra como usar cada uma das principais funcionalidades, passo a passo, com capturas de tela.
Tutorial de Firecrawl
Este tutorial completo do Firecrawl orienta você em todos os recursos, desde sua primeira chave de API até operações em lote avançadas que o tornarão um usuário avançado.
Firecrawl
Transforme qualquer site em dados limpos e estruturados com uma única API. O Firecrawl cuida da renderização de JavaScript, dos limites de taxa e da descoberta de URLs para que você obtenha dados prontos para o LLM rapidamente. Comece com o plano gratuito — sem necessidade de cartão de crédito.
Primeiros passos com o Firecrawl
Antes de usar qualquer recurso, conclua esta configuração única.
Leva cerca de 3 minutos.
Veja primeiro esta breve visão geral:
Agora vamos analisar cada etapa.
Passo 1: Crie sua conta
Acesse o site do Firecrawl em https://www.firecrawl.dev.
Clique em "Inscrever-se" para abrir uma conta Firecrawl no plano gratuito.
Insira seu e-mail e crie uma senha.
✓ Ponto de verificação: Verifique o seu caixa de entrada para um e-mail de confirmação.
Etapa 2: Instale e configure sua chave de API
Execute o comando `pip install firecrawl-py` para adicionar o serviço de API ao seu projeto.
Copie sua chave de API e salve-a como uma variável de ambiente para segurança.
Eis como o painel de controle se parece:
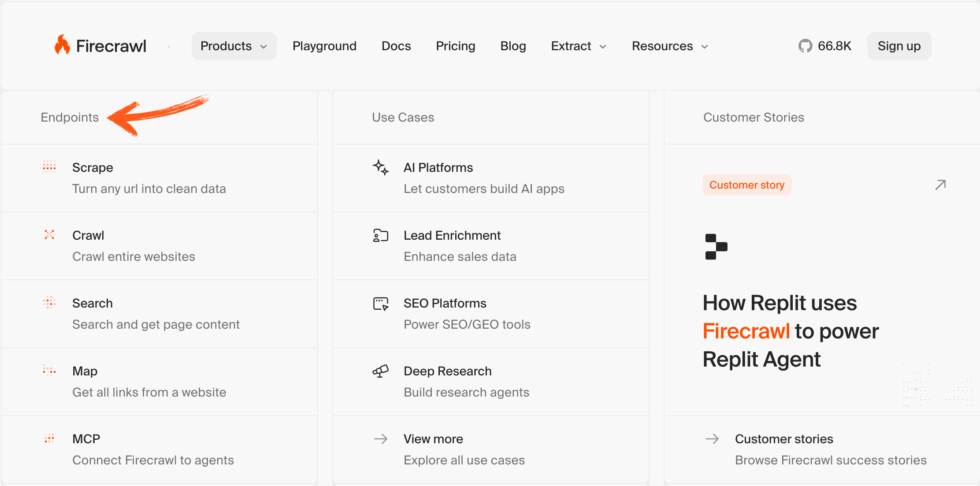
✓ Ponto de verificação: Você deverá ver o painel principal com seu histórico de uso e a chave da API.
Passo 3: Faça sua primeira ligação
Importe a classe FirecrawlApp e crie uma instância do Firecrawl com sua chave.
Cada requisição atinge o endpoint base em https://api.firecrawl.dev/v2.
✅ Concluído: Você está pronto para coletar, rastrear, pesquisar, mapear e extrair dados.
Como usar o Firecrawl Scraper
Raspar Permite extrair dados limpos e prontos para LLM de uma única página com uma única chamada de API.
O modo de raspagem permite selecionar páginas individuais e é ideal para extrair detalhes específicos rapidamente.
Veja como usá-lo passo a passo.
Agora vamos analisar cada etapa.
Passo 1: Obtenha sua chave de API
Crie uma conta no Firecrawl e, em seguida, copie sua chave de API do painel de controle.
Armazene-a como uma variável de ambiente para que sua chave de API fique fora do seu código bruto.
Etapa 2: Chame o endpoint de raspagem
Passe uma única URL para o método .scrape_url() na sua instância do Firecrawl.
Você pode solicitar o formato Markdown, HTML puro ou JSON estruturado como saída.
Eis como isso se parece:
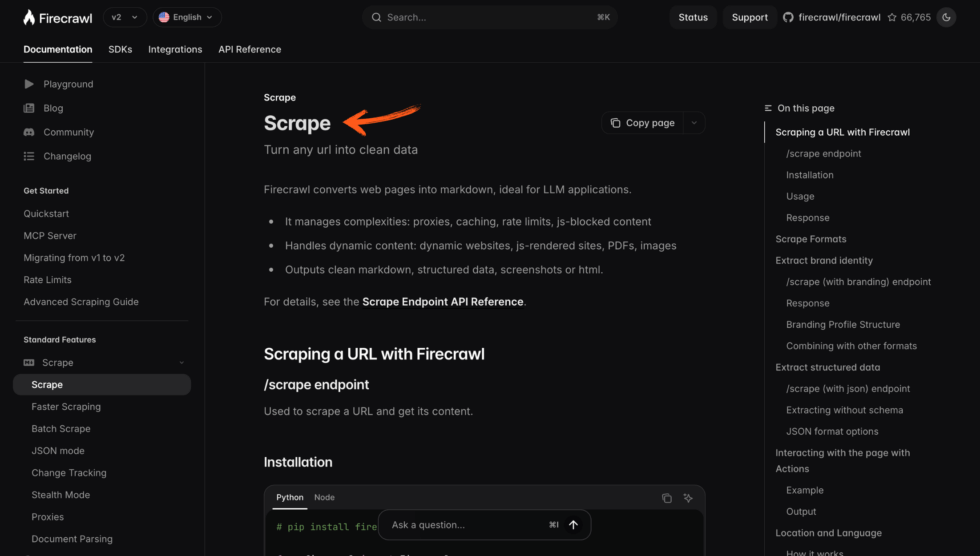
✓ Ponto de verificação: Você deverá ver um código Markdown limpo na página atual, pronto para aplicações de IA.
Etapa 3: Leia a saída limpa
O Firecrawl retorna dados limpos e legíveis. texto, sem tags HTML desnecessárias.
✅ Resultado: Você transformou uma das páginas da web em dados web estruturados com uma única API.
💡 Dica profissional: Defina o parâmetro max_age para armazenar em cache os resultados e evitar a nova busca de páginas que não foram alteradas.
Como usar o rastreador Firecrawl
Arrastar Permite rastrear sites inteiros e seguir links automaticamente sem um mapa do site.
O modo de rastreamento permite percorrer sites em várias páginas e coletar todas as páginas acessíveis.
Veja como usá-lo passo a passo.
Agora vamos analisar cada etapa.
Passo 1: Aponte para um URL raiz
Forneça ao ponto de extremidade de rastreamento um URL inicial, como https://example.com.
O Firecrawl realiza o rastreamento da web por meio de links e segue páginas automaticamente.
Etapa 2: Inicie o trabalho de rastreamento
Inicie a tarefa de rastreamento e obtenha o ID da tarefa retornado para acompanhar o progresso.
Use o ID da tarefa para consultar o status e obter os dados rastreados à medida que cada página for concluída.
Eis como isso se parece:
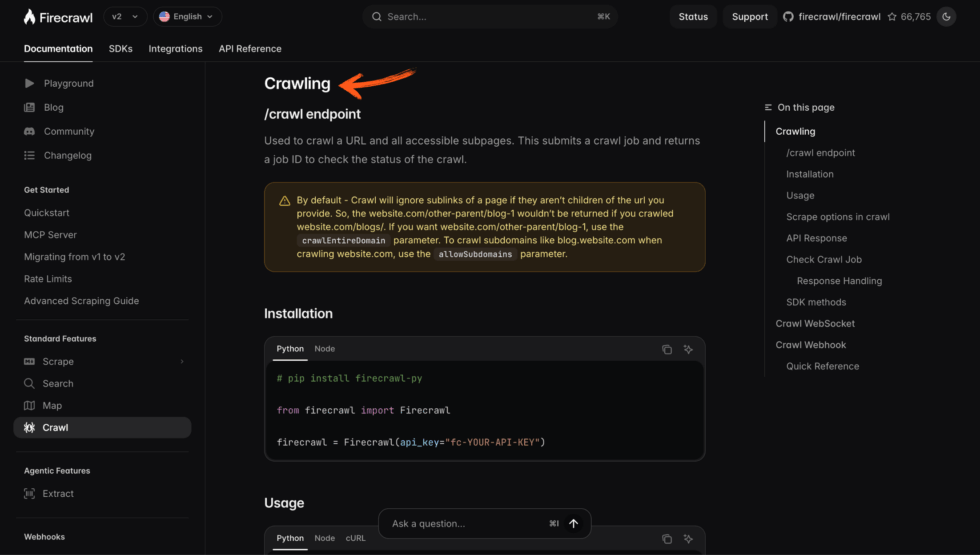
✓ Ponto de verificação: Você deverá ver páginas extraídas de todo o site sendo incorporadas aos dados da web.
Etapa 3: Exportar os resultados
Colete todas as páginas em formato Markdown ou JSON estruturado para seus fluxos de dados.
✅ Resultado: Você capturou um site inteiro, até mesmo sites complexos com conteúdo dinâmico.
💡 Dica profissional: O Firecrawl utiliza processamento em lote e navegadores simultâneos, de modo que grandes operações de rastreamento permanecem rápidas.
Como usar o mecanismo de busca Firecrawl
Procurar Permite pesquisar na web e obter resultados precisos que podem ser inseridos diretamente em agentes de IA.
A busca permite consultar a web e obter dados da web em tempo real como texto legível.
Veja como usá-lo passo a passo.
Agora vamos analisar cada etapa.
Passo 1: Enviar uma consulta
Faça a chamada para o endpoint de pesquisa com uma consulta simples em linguagem natural.
O Firecrawl consegue pesquisar na web em sites de notícias, quadros de empregos e sites de avaliação.
Etapa 2: Escolha o formato de saída
Solicite o formato Markdown ou JSON estruturado para cada resultado.
Cada resultado chega como dados limpos, não como HTML bruto e ruidoso.
Eis como isso se parece:
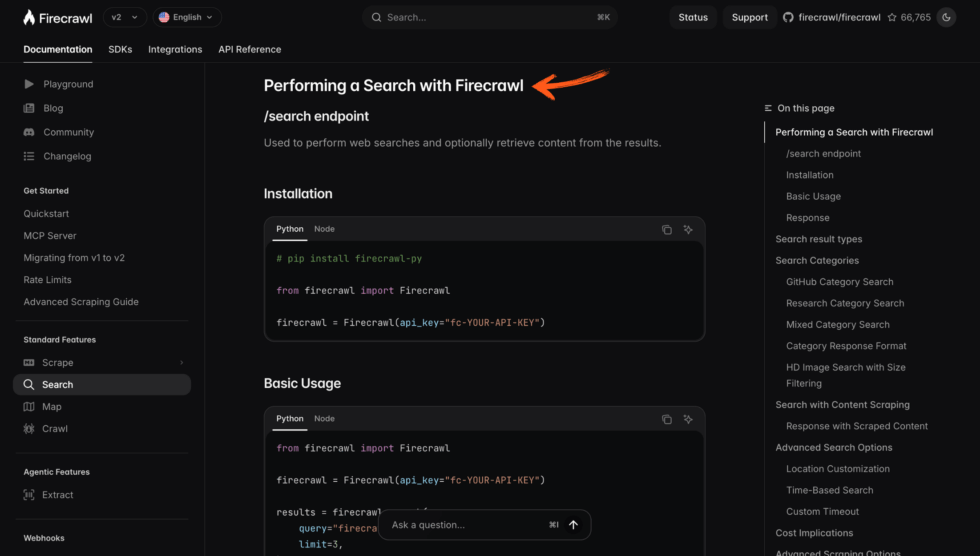
✓ Ponto de verificação: Você deverá ver as páginas da web classificadas como dados web estruturados.
Etapa 3: Conecte ao seu aplicativo
Insira os dados estruturados em assistentes de IA ou fluxos de trabalho de IA.
✅ Resultado: Você adicionou conteúdo web ao vivo aos seus aplicativos de IA com uma única chamada de API.
💡 Dica profissional: Combine a busca com a extração para reunir artigos de notícias para pesquisa de mercado ou inteligência competitiva.
Como usar o mapa avançado do Firecrawl
Mapa Permite executar a descoberta de URLs e transformar um domínio em um mapa completo de páginas individuais.
O modo mapa recupera rapidamente todos os URLs de um site, permitindo uma descoberta rápida de URLs.
Veja como usá-lo passo a passo.
Agora vamos analisar cada etapa.
Passo 1: Enviar o domínio
Passe uma única URL raiz para o endpoint do mapa.
O Firecrawl retorna todos os links sem precisar de um sitemap.
Etapa 2: Analise a lista de URLs
Analise as páginas individuais retornadas antes de extrair os dados.
Salve a lista em um arquivo CSV para planejar a extração de dados.
Eis como isso se parece:
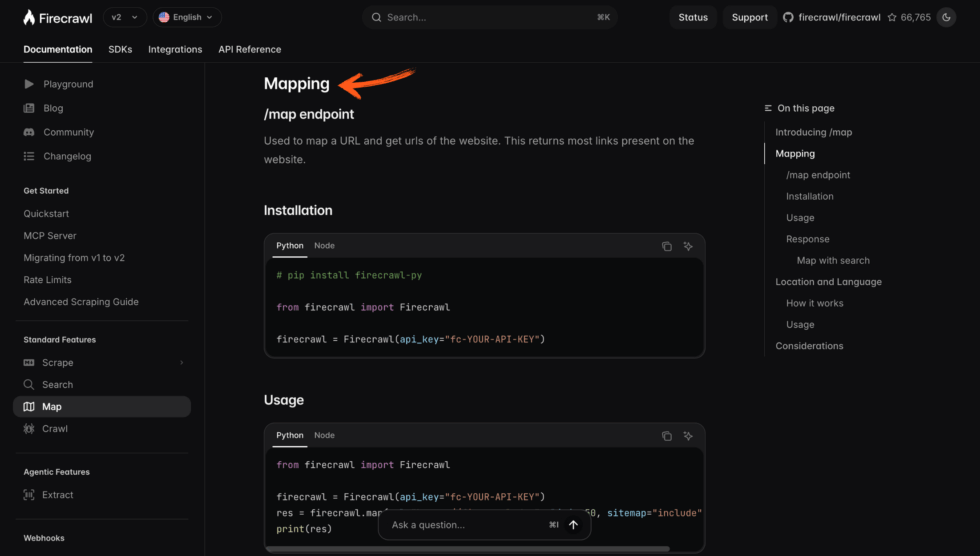
✓ Ponto de verificação: Você deverá ver um mapa completo das páginas da web a partir de um único URL.
Etapa 3: Selecione o que extrair.
Selecione as páginas desejadas e envie-as para serem extraídas ou rastreadas.
✅ Resultado: Você mapeou todo o site, preparando-o para a extração de dados da web direcionada.
💡 Dica profissional: Priorize o mapeamento em sites dinâmicos e aplicativos da web para evitar o desperdício de créditos em páginas desnecessárias.
Como usar o extrator Firecrawl
Extrair Permite extrair dados estruturados de qualquer página usando comandos em linguagem natural.
O Extract utiliza análise sintática com inteligência artificial para extrair exatamente os campos que você descreve.
Veja como usá-lo passo a passo.
Agora vamos analisar cada etapa.
Passo 1: Defina um esquema
Escreva um modelo Pydantic com: from pydantic import BaseModel.
A extração baseada em esquema informa ao Firecrawl quais campos devem ser retornados como JSON estruturado.
Etapa 2: Descreva os dados
Adicione instruções em linguagem natural para campos que um esquema não consegue capturar.
Esta é a forma de extrair dados de páginas da web sem escrever regras de análise sintática.
Eis como isso se parece:
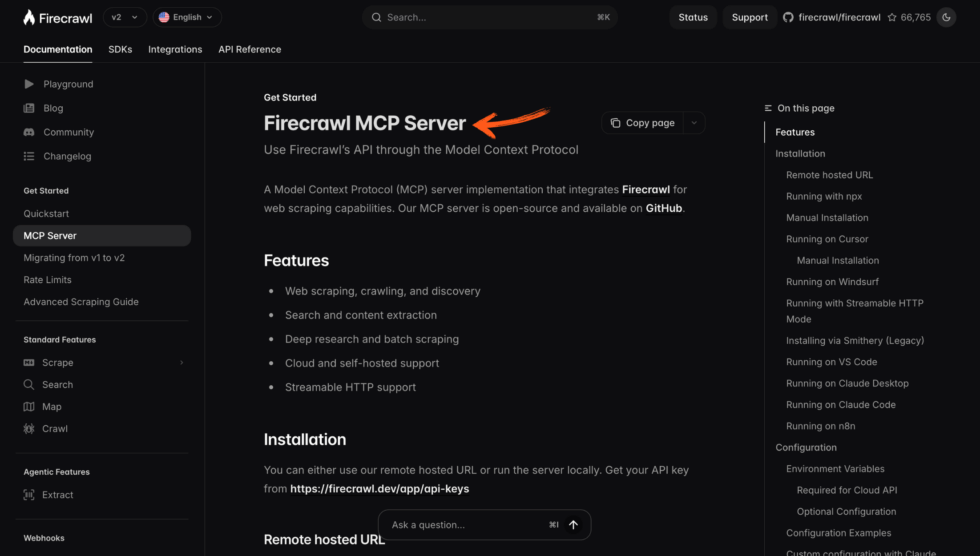
✓ Ponto de verificação: Você deverá ver dados estruturados e organizados em vez de tags HTML desorganizadas.
Etapa 3: Receber JSON estruturado
O Firecrawl retorna um JSON limpo e estruturado, pronto para uso como dados de treinamento.
✅ Resultado: Você substituiu raspadores frágeis por uma única chamada de extração e menos limpeza de dados.
💡 Dica profissional: Use only_main_content, include_tags e exclude_tags para manter os dados da web extraídos focados.
Dicas e Atalhos Profissionais do Firecrawl
Após testar o Firecrawl por mais de um ano, aqui estão minhas melhores dicas para uma extração de dados mais eficiente.
Atalhos de teclado
| Ação | Atalho |
|---|---|
| Execute o raspador no parquinho | Ctrl + Enter |
| Copiar chave de API | Ctrl + C |
| Abrir documentos | Ctrl + K |
| Alternar formato de saída | Aba |
Características ocultas que a maioria das pessoas não percebe
- Cache max_age: Reutilize dados coletados recentemente para uma coleta repetida mais rápida e barata.
- Ações do navegador: Clique, role a tela e digite para acessar o conteúdo que está oculto pela renderização em JavaScript.
- Processamento em lote assíncrono: Processe milhares de URLs em lote sem bloquear seus aplicativos da web.
Erros comuns a evitar no Firecrawl
Erro nº 1: Codificar sua chave de API diretamente no código.
❌ Errado: Colar sua chave de API diretamente no código compartilhado ou em um repositório público.
✅ Direita: Carregue a chave a partir de uma variável de ambiente para que ela permaneça privada.
Erro nº 2: Rastejar antes de mapear
❌ Errado: Analisando sites inteiros às cegas e gastando créditos em páginas inúteis.
✅ Direita: Primeiro, execute a descoberta de URLs com o mapa e, em seguida, rastreie apenas as páginas necessárias.
Erro nº 3: Analisar HTML bruto você mesmo
❌ Errado: Escrever regras complexas para limpar HTML bruto e remover tags HTML manualmente.
✅ Direita: Utilize a extração baseada em esquema para obter JSON limpo e estruturado diretamente.
Solução de problemas do Firecrawl
Problema: erros 401 (não autorizado)
Causa: Sua chave de API está ausente ou não foi carregada da variável de ambiente.
Consertar: Reexporte a chave, recrie sua instância do Firecrawl e tente novamente.
Problema: Erros de tempo limite em sites complexos
Causa: A renderização de JavaScript complexo ou conteúdo dinâmico demora mais para carregar.
Consertar: Adicione uma ação de espera para que a página atual termine de carregar antes da captura.
Problema: Atingir os limites de taxa
Causa: Muitas solicitações simultâneas no plano gratuito ou em um plano inferior.
Consertar: Operações em lote lentas ou atualização para suportar mais navegadores simultâneos.
📌 Observação: Se nenhuma dessas soluções resolver o seu problema, entre em contato com o suporte do Firecrawl.
O que é Firecrawl?
Firecrawl É uma ferramenta de extração de dados da web com inteligência artificial que transforma sites em dados limpos e estruturados.
Imagine um rastreador web que fornece aos agentes de IA texto legível em vez de HTML bruto e confuso.
O Firecrawl foi desenvolvido pela Mendable.ai para reduzir o desperdício de tokens em aplicações de IA.
Veja esta breve visão geral:
Inclui estas características principais:
- Raspar: Extrair dados de páginas web individuais em formato Markdown ou JSON estruturado.
- Arrastar: Rastrear sites inteiros e seguir links sem um mapa do site.
- Procurar: Pesquise na internet e retorne dados limpos de sites de notícias e sites de avaliação.
- Mapa: Descoberta rápida de URLs que transforma um domínio em um sitemap completo.
- Extrair: Extraia dados estruturados da web usando comandos em linguagem natural e esquemas Pydantic.
O Firecrawl supera a extração de dados da web tradicional ao lidar com proxies, limites de taxa e renderização de JavaScript para você.
Diferentemente das ferramentas tradicionais que precisam do Selenium, ela atende cientistas de dados e desenvolvedores por meio de um único serviço de API.
Para uma análise completa, consulte nosso artigo. Análise do Firecrawl.
Preços do Firecrawl
Eis o preço do Firecrawl em 2026:
| Plano | Preço | Ideal para |
|---|---|---|
| Livre | Livre | Testando a extração e o rastreamento de dados em algumas páginas. |
| Passatempo | US$ 16/mês | Desenvolvedores solo e pequenos fluxos de dados |
| Padrão | US$ 83/mês | Equipes que executam tarefas regulares de rastreamento da web |
| Crescimento | $ 333/mês | Pesquisa e monitoramento de mercado em grande volume |
Teste grátis: Sim, o plano gratuito permite extrair dados de um número limitado de páginas.
Garantia de reembolso: Não há garantia formal, mas você pode fazer o downgrade a qualquer momento.
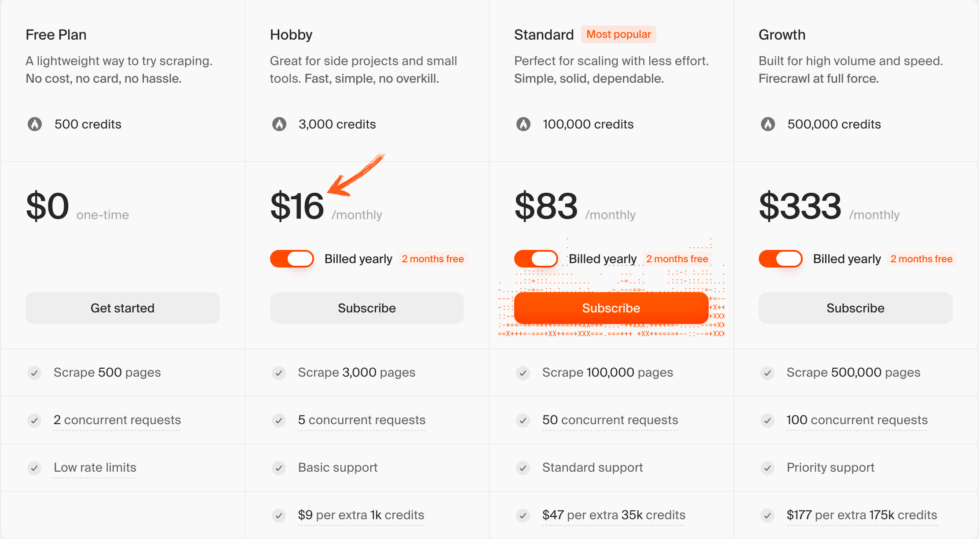
💰 Melhor custo-benefício: Padrão — o melhor equilíbrio entre créditos e navegadores simultâneos para a maioria das equipes.
Firecrawl vs Alternativas
Como o Firecrawl se compara? Aqui está o panorama competitivo:
| Ferramenta | Ideal para | Preço | Avaliação |
|---|---|---|---|
| Firecrawl | dados limpos prontos para IA | US$ 16/mês | ⭐ 3,5 |
| Apify | atores pré-fabricados | US$ 49/mês | ⭐ 4,5 |
| Dados brilhantes | Escala proxy | $ Personalizado | ⭐ 4,6 |
| Crawl4AI | Código aberto | Livre | ⭐ 4,4 |
| Scrapy | Controle Python | Livre | ⭐ 4,5 |
| ScrapeGraphAI | Extração de grafos LLM | US$ 20/mês | ⭐ 4,3 |
Escolhas rápidas:
- Melhor no geral: Firecrawl — os dados mais limpos e prontos para LLM a partir de uma única API.
- Melhor orçamento: Crawl4AI — gratuito e de código aberto para cientistas de dados que desejam colocar a mão na massa.
- Ideal para iniciantes: Firecrawl — as instruções em linguagem natural ocultam as partes difíceis.
- Melhor para escala proxy: Bright Data — enorme conjunto de proxies para sites complexos.
🎯 Alternativas ao Firecrawl
Procurando alternativas ao Firecrawl? Aqui estão as melhores opções:
- 🚀 Apify: Mercado de atores pré-construídos para web scraping, ideal quando você deseja scrapers prontos para uso em uma única API.
- 🏢 Dados brilhantes: Rede proxy empresarial para grandes tarefas de rastreamento e monitoramento de conteúdo em escala em sites dinâmicos.
- 💰 Crawl4AI: Crawler gratuito e de código aberto que gera dados prontos para LLM, ideal para fluxos de trabalho de IA com orçamento limitado e execuções locais.
- 🔧 Scrapy: Framework Python testado e comprovado que oferece aos desenvolvedores controle total sobre rastreamento, análise sintática e fluxos de dados.
- 🧠 ScrapeGraphAI: Extração baseada em grafos e com inteligência artificial que mapeia a estrutura da página para extração de dados estruturados com base em esquemas.
Para ver a lista completa, consulte nosso Alternativas ao Firecrawl guia.
⚔️ Comparação do Firecrawl
Veja como o Firecrawl se compara a cada concorrente:
- Firecrawl vs Apify: O Firecrawl se destaca pela saída limpa e pronta para LLM; o Apify se destaca por sua biblioteca de scrapers pré-construídos.
- Firecrawl vs Bright Data: Bright Data se destaca em escalabilidade de proxies; Firecrawl se destaca na extração de dados estruturados mais simples.
- Firecrawl vs Crawl4AI: O Crawl4AI se destaca pelo preço e pela hospedagem própria; o Firecrawl se destaca pelos limites de taxa gerenciados e pela confiabilidade.
- Firecrawl vs Scrapy: Scrapy vence em controle de baixo nível; Firecrawl vence em velocidade e configuração sem proxy.
- Firecrawl vs ScrapeGraphAI: Ambos utilizam inteligência artificial; o Firecrawl se destaca na abrangência da busca, enquanto o ScrapeGraphAI se sobressai na lógica de grafos.
Comece a usar o Firecrawl agora mesmo
Você aprendeu a usar todos os principais recursos do Firecrawl:
- ✅ Raspar
- ✅ Rastejar
- ✅ Pesquisar
- ✅ Mapa
- ✅ Extrato
Próximo passo: Escolha uma funcionalidade e experimente agora mesmo.
A maioria das pessoas começa com o Scrape.
Leva menos de 5 minutos.
Perguntas frequentes
Para que serve o Firecrawl?
O Firecrawl é uma ferramenta de web scraping com inteligência artificial. Ele transforma páginas da web em dados limpos e prontos para uso em sistemas de gerenciamento de linguagem natural (LLM), como agentes de IA, sistemas RAG, pesquisas de mercado e monitoramento de preços.
É possível usar o Firecrawl gratuitamente?
Sim. O plano gratuito permite que você extraia dados de um número limitado de páginas com sua chave de API, para que você possa testar a extração, o rastreamento e a coleta de dados antes de pagar.
Como faço para instalar o Firecrawl?
Execute o comando `pip install firecrawl-py`, defina sua chave de API como uma variável de ambiente e crie uma instância do Firecrawl para iniciar sua primeira chamada de API.
Em que o Firecrawl difere da raspagem de dados tradicional?
A extração de dados da web tradicional exige o Selenium e a configuração manual de proxies. O Firecrawl lida com a renderização de JavaScript, limites de taxa e limpeza de dados automaticamente por meio de um único serviço de API.
O Firecrawl consegue extrair dados estruturados?
Sim. Use comandos em linguagem natural ou um esquema Pydantic para extração baseada em esquema, e o Firecrawl retornará JSON estruturado em vez de HTML bruto.













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
