
クイックスタート
このガイドでは、Firecrawlのすべての機能を網羅しています。
- はじめる — Firecrawlアカウントを作成し、APIキーを設定します。
- Scrapeの使い方 — 単一のウェブページからLLM対応データを取得する
- Crawlの使い方 ウェブサイト全体をクロールし、すべてのリンクをたどる
- 検索機能の使い方 — ウェブ上でリアルタイムのデータを検索
- 地図の使い方 — 個々のページにわたってURL検出を実行する
- 抽出物の使い方 — 自然言語プロンプトを使用して構造化データを抽出する
所要時間: 各作品につき5分
このガイドには以下の内容も含まれています。 プロのヒント | よくある間違い | トラブルシューティング | 価格 | 代替案
このガイドを信頼する理由
私はFirecrawlを1年以上使用しており、ここで紹介されているすべての機能をテストしました。
このFirecrawlの使い方に関するチュートリアルは、実際のWebスクレイピング作業の経験に基づいています。

Firecrawlは、AIを搭載したウェブクローラーで、ウェブサイトをクリーンでLLM(法医学学習)に適したデータに変換します。
しかし、ほとんどのユーザーはこの多機能ツールの機能のごく一部しか活用していない。
このガイドでは、主要な機能の使い方を、スクリーンショット付きでステップバイステップで解説します。
ファイヤークロールチュートリアル
このFirecrawl完全チュートリアルでは、最初のAPIキーの取得から、パワーユーザーになるための高度なバッチ操作まで、すべての機能を順を追って説明します。
ファイヤークロール
単一のAPIで、あらゆるウェブサイトをクリーンで構造化されたデータに変換できます。FirecrawlはJavaScriptレンダリング、レート制限、URL検出を処理するため、LLM対応データを迅速に取得できます。無料プランから始めましょう。クレジットカードは不要です。
Firecrawl入門
いずれかの機能を使用する前に、この初回設定を完了してください。
約3分かかります。
まずはこちらの簡単な概要をご覧ください。
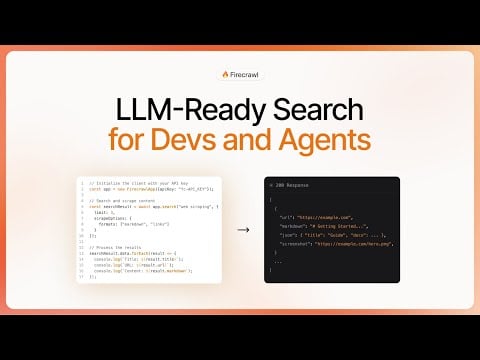
それでは、各ステップを順を追って見ていきましょう。
ステップ1:アカウントを作成する
Firecrawlのウェブサイト(https://www.firecrawl.dev)にアクセスしてください。
「サインアップ」をクリックして、無料プランでファイヤークロールアカウントを開設してください。
メールアドレスを入力し、パスワードを作成してください。
✓ チェックポイント: チェックしてください 受信トレイ 確認メールをお送りします。
ステップ2:APIキーをインストールして設定する
プロジェクトにAPIサービスを追加するには、`pip install firecrawl-py`を実行してください。
APIキーをコピーして、環境変数として保存します。 安全.
ダッシュボードの画面は以下のようになります。
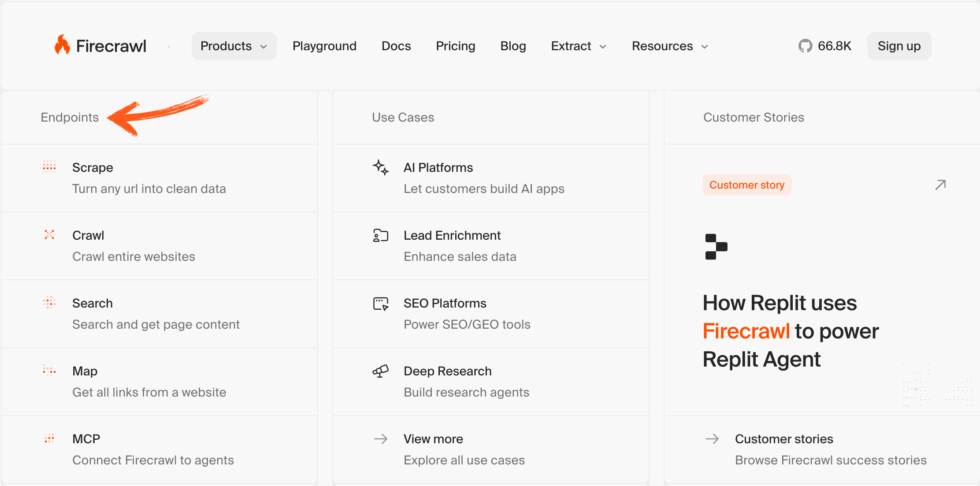
✓ チェックポイント: 使用状況とAPIキーが表示されたメインダッシュボードが表示されるはずです。
ステップ3:最初の電話をかける
FirecrawlAppクラスをインポートし、キーを使用してFirecrawlインスタンスを作成します。
すべてのリクエストは、https://api.firecrawl.dev/v2 の基本エンドポイントに到達します。
✅ 完了: データのスクレイピング、クロール、検索、マッピング、抽出を行う準備が整いました。
ファイヤークロールスクレーパーの使い方
削る 1回のAPI呼び出しで、1つのページからクリーンでLLMに対応したデータを取得できます。
スクレイピングモードは個々のページを対象とし、特定の情報を迅速に抽出するのに最適です。
以下に、その使用方法をステップごとに説明します。
それでは、各ステップを詳しく見ていきましょう。
ステップ1:APIキーを取得する
Firecrawlアカウントを作成し、ダッシュボードからAPIキーをコピーしてください。
APIキーを環境変数として保存することで、APIキーがコードに直接含まれないようにできます。
ステップ2:スクレイピングエンドポイントを呼び出す
firecrawlインスタンスの.scrape_url()メソッドに単一のURLを渡してください。
出力形式として、マークダウン形式、生のHTML形式、または構造化されたJSON形式を指定できます。
これがその様子です。
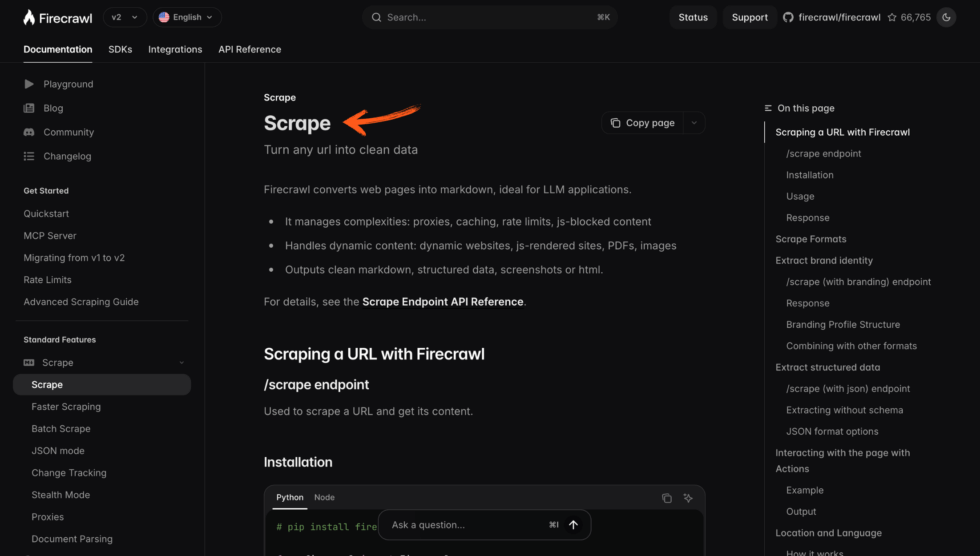
✓ チェックポイント: 現在のページには、AIアプリケーションで使用できる、整然としたマークダウンが表示されているはずです。
ステップ3:クリーンな出力を読む
Firecrawlは読みやすいクリーンなデータを返します 文章不要なHTMLタグを削除しました。
✅ 結果: あなたは単一のAPIを使って、ウェブページの1つを構造化されたウェブデータに変換しました。
💡 プロのヒント: max_age パラメータを設定すると、結果がキャッシュされ、変更されていないページを再スクレイピングすることがスキップされます。
Firecrawl Crawlerの使い方
クロール サイトマップがなくても、ウェブサイト全体をクロールしてリンクを自動的にたどることができます。
クロールモードでは、複数のページにわたってウェブサイトをクロールし、アクセス可能なすべてのページを収集できます。
以下に、その使用方法をステップごとに説明します。
それでは、各ステップを詳しく見ていきましょう。
ステップ1:ルートURLを指定する
クロールエンドポイントに、https://example.com のような開始URLを指定してください。
Firecrawlはリンクを介してウェブクローリングを行い、ページを自動的に追跡します。
ステップ2:クロールジョブを開始する
クロールジョブを開始し、返されたジョブIDを取得して進行状況を追跡します。
ジョブIDを使用してステータスをポーリングし、各ページが終了するたびにクロールされたデータを取得します。
これがその様子です。
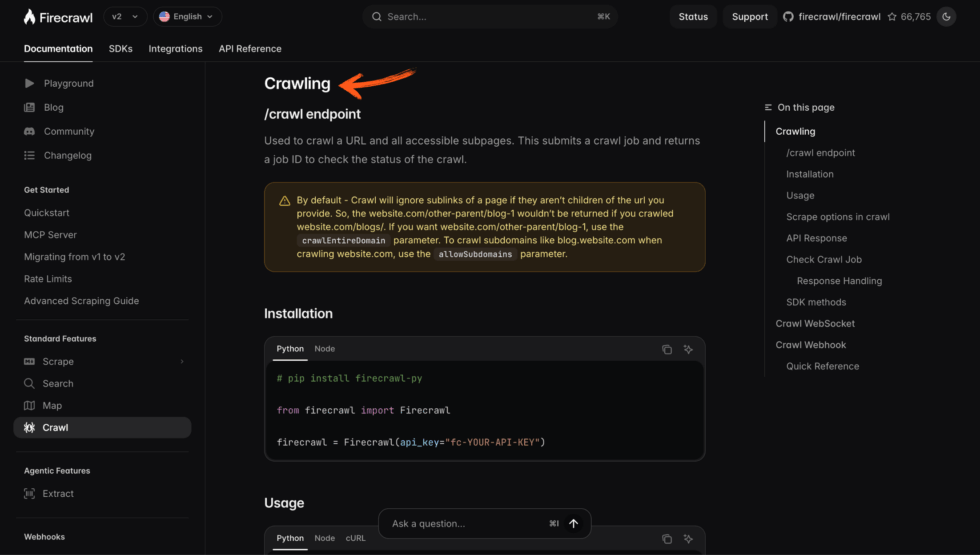
✓ チェックポイント: サイト全体からスクレイピングされたページが、ウェブデータとして構築されていく様子が確認できるはずです。
ステップ3:結果をエクスポートする
データパイプライン用に、すべてのページをマークダウンまたは構造化JSONとして収集します。
✅ 結果: あなたは、動的なコンテンツを含む複雑なウェブサイトも含め、サイト全体をキャプチャしました。
💡 プロのヒント: Firecrawlはバッチ処理と同時ブラウザを使用するため、大規模なクロール操作でも高速性を維持できます。
Firecrawl検索エンジンの使い方
検索 ウェブを検索して、AIエージェントに直接入力できるクリーンな結果を返すことができます。
検索機能を使うと、ウェブ上でクエリを実行し、リアルタイムのウェブデータを読みやすいテキストとして取得できます。
以下に、その使用方法をステップごとに説明します。
それでは、各ステップを詳しく見ていきましょう。
ステップ1:クエリを送信する
検索エンドポイントを、平易な自然言語によるクエリで呼び出してください。
Firecrawlは、ニュースサイト、求人サイト、レビューサイトなど、ウェブ上の様々なサイトを検索できます。
ステップ2:出力形式を選択する
各結果について、マークダウン形式または構造化JSON形式での提供を依頼してください。
結果はすべて、ノイズの多い生のHTMLではなく、クリーンなデータとして届きます。
これがその様子です。
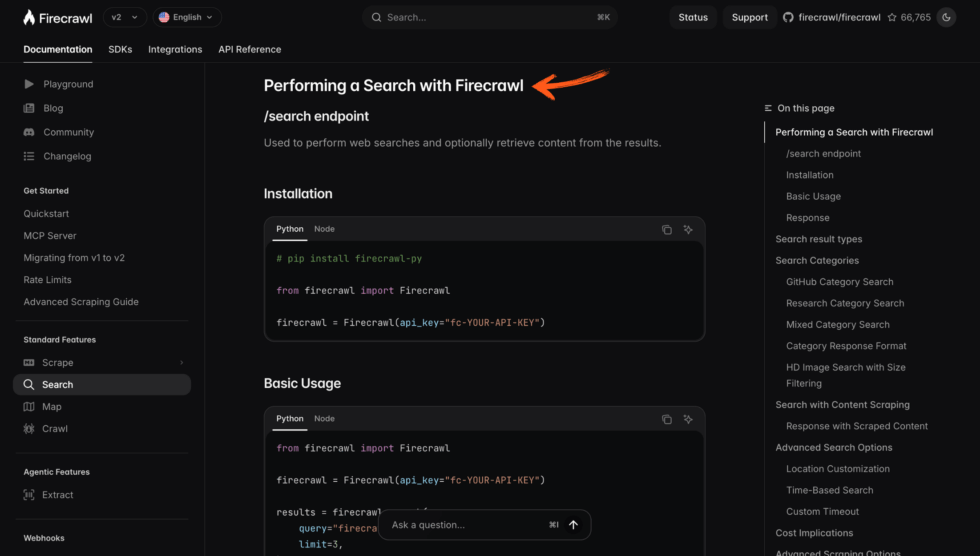
✓ チェックポイント: ランキング付けされたウェブページが構造化ウェブデータとして返されるはずです。
ステップ3:アプリにパイプする
構造化データを AIアシスタント またはAIワークフロー。
✅ 結果: たった1回のAPI呼び出しで、AIアプリケーションにライブWebコンテンツを追加しました。
💡 プロのヒント: 検索と抽出機能を組み合わせることで、市場調査や競合情報収集のためのニュース記事を収集できます。
Firecrawl Advanced Mapの使い方
地図 URL検出を実行し、1つのドメインを個々のページの完全なマップに変換できます。
マップモードでは、サイト上のすべてのURLを素早く取得し、URLを迅速に発見できます。
以下に、その使用方法をステップごとに説明します。
それでは、各ステップを詳しく見ていきましょう。
ステップ1:ドメインを送信する
マップエンドポイントに単一のルートURLを渡します。
Firecrawlはサイトマップを必要とせずにすべてのリンクを返します。
ステップ2:URLリストを確認する
スクレイピングする前に、返された個々のページをスキャンしてください。
データ抽出の計画を立てるために、リストをCSVファイルに保存してください。
これがその様子です。
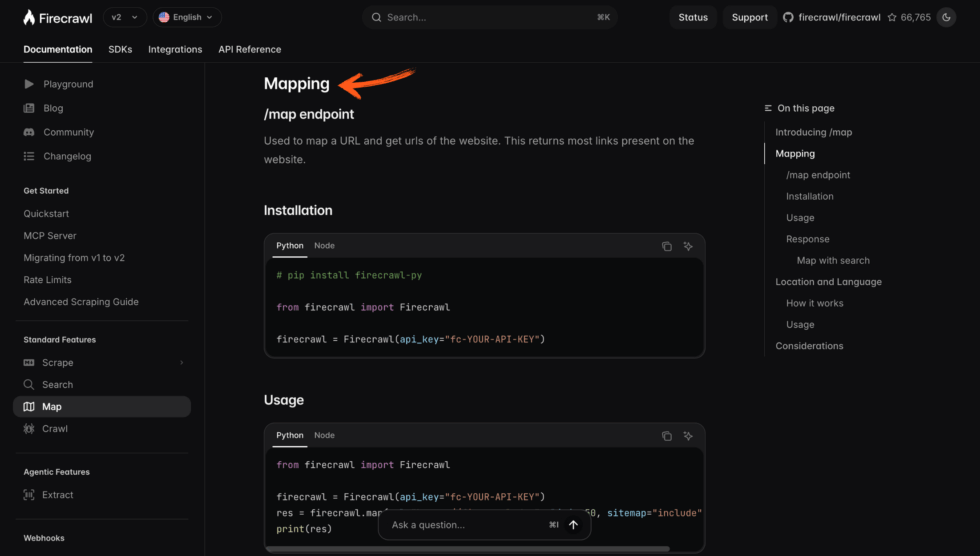
✓ チェックポイント: 1つのURLから、ウェブページの完全なサイトマップが表示されるはずです。
ステップ3:スクレイピングする対象を選択する
必要なページを選択し、スクレイピングまたはクロールに送ります。
✅ 結果: サイト全体のマッピングが完了し、ターゲットを絞ったウェブスクレイピングの準備が整いました。
💡 プロのヒント: 動的なウェブサイトやウェブアプリでは、不要なページにクレジットを無駄に消費しないよう、まず地図を表示しましょう。
Firecrawl Extractorの使い方
抽出する 自然言語によるプロンプトを使用して、あらゆるページから構造化データを抽出できます。
ExtractはAIを活用した解析機能を用いて、ユーザーが指定したフィールドを正確に抽出します。
以下に、その使用方法をステップごとに説明します。
それでは、各ステップを詳しく見ていきましょう。
ステップ1:スキーマを定義する
Pydantic モデルを次のように記述します: from pydantic import BaseModel。
スキーマベースの抽出では、Firecrawlに対して、構造化されたJSONとして返すフィールドを指定します。
ステップ2:データの記述
スキーマでは捉えられないフィールドには、自然言語によるプロンプトを追加する。
これは、解析ルールを書かずにウェブページからデータを抽出する方法です。
これがその様子です。
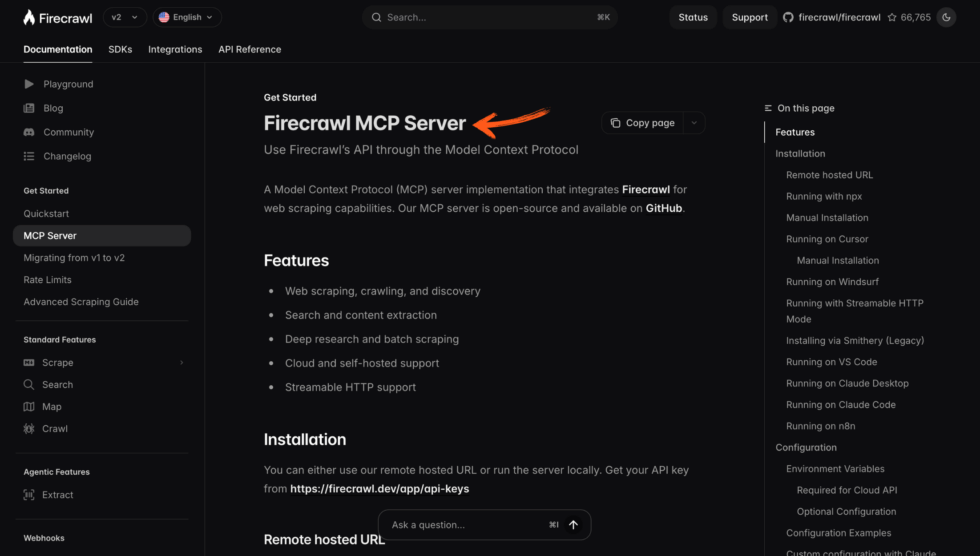
✓ チェックポイント: 乱雑なHTMLタグではなく、整然とした構造化データが表示されるはずです。
ステップ3:構造化されたJSONを受信する
Firecrawlは、トレーニングデータとして使用できる、整理された構造のJSONデータを返します。
✅ 結果: 脆弱なスクレイパーを、1回の抽出呼び出しとデータクリーニングの削減に置き換えました。
💡 プロのヒント: 抽出したウェブデータを絞り込むには、only_main_content、include_tags、exclude_tags を使用してください。
Firecrawlのプロ向けヒントとショートカット
Firecrawlを1年以上テストした結果、よりクリーンなデータ抽出のための私のおすすめのヒントをご紹介します。
キーボードショートカット
| アクション | ショートカット |
|---|---|
| 遊び場で走り回る | Ctrl + Enter |
| APIキーをコピー | Ctrl + C |
| ドキュメントを開く | Ctrl + K |
| 出力形式を切り替える | タブ |
ほとんどの人が見逃す隠れた機能
- max_age キャッシュ: 最近クロールしたデータを再利用することで、より高速かつ低コストで繰り返しスクレイピングを行うことができます。
- ブラウザ操作: クリック、スクロール、入力を行うことで、JavaScriptレンダリングの背後にあるコンテンツにアクセスできます。
- 非同期バッチ処理: ウェブアプリをブロックすることなく、バッチ処理で数千ものURLを処理できます。
ファイヤークロールでよくある間違いを避ける方法
間違いその1:APIキーをハードコーディングする
❌ 間違い: APIキーを共有コードまたは公開リポジトリに直接貼り付ける。
✅ 右: 環境変数からキーを読み込むことで、キーの機密性を維持します。
間違いその2:マッピングの前にクロールを行う
❌ 間違い: ウェブサイト全体を無差別にクロールし、不要なページにクレジットを浪費する。
✅ 右: まずマップを使ってURL探索を行い、その後必要なページだけをクロールしてください。
間違いその3:生のHTMLを自分で解析する
❌ 間違い: 生のHTMLをクリーンアップし、HTMLタグを手作業で削除するための、脆弱なルールを作成する。
✅ 右: スキーマベースの抽出を使用して、クリーンで構造化されたJSONを直接取得します。
ファイヤークロールのトラブルシューティング
問題: 401 認証エラー
原因: APIキーが指定されていないか、環境変数から読み込まれていません。
修理: キーを再エクスポートしてから、Firecrawlインスタンスを再作成し、再試行してください。
問題:複雑なウェブサイトでタイムアウトエラーが発生する
原因: JavaScriptによる重いレンダリングや動的なコンテンツは、読み込みに時間がかかります。
修理: 現在のページが読み込み完了するまで待機する処理を追加してください。
問題:レート制限に達している
原因: 無料プランまたはそれ以下のプランでは、一度にリクエストが多すぎます。
修理: 処理速度の遅いバッチ処理、または同時接続ブラウザ数を増やすためのアップグレードが必要です。
📌 注記: これらの方法で問題が解決しない場合は、Firecrawlのサポートにお問い合わせください。
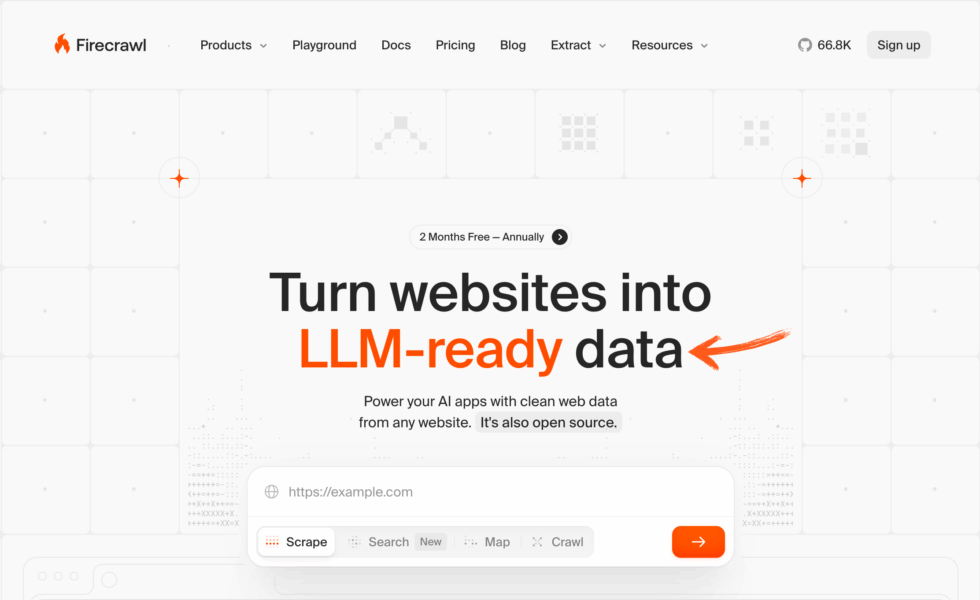
Firecrawl とは何ですか?
ファイヤークロール これは、ウェブサイトをクリーンで構造化されたデータに変換する、AI搭載のウェブスクレイピングツールです。
これは、乱雑な生のHTMLではなく、読みやすいテキストをAIエージェントに渡すウェブクローラーのようなものだと考えてください。
Firecrawlは、AIアプリケーションにおけるトークンの無駄を削減するために、Mendable.aiによって開発されました。
こちらの簡単な概要をご覧ください。
主な機能は以下のとおりです。
- スクレイピング: 単一のウェブページからデータをマークダウン形式または構造化JSON形式で抽出します。
- クロール: サイトマップなしでウェブサイト全体をクロールし、リンクをたどります。
- 検索: ウェブを検索し、ニュースサイトやレビューサイトから正確なデータを取得する。
- 地図: 1つのドメインから完全なサイトマップを作成する、高速なURL検出機能。
- 抽出する: 自然言語によるプロンプトとPydanticスキーマを使用して、構造化されたWebデータを取得します。
Firecrawlは、プロキシ、レート制限、JavaScriptレンダリングを自動的に処理することで、従来のWebスクレイピングよりも優れています。
Seleniumを必要とする従来のツールとは異なり、単一のAPIサービスを通じてデータサイエンティストと開発者にサービスを提供する。
詳細なレビューについては、こちらをご覧ください。 ファイヤークロールのレビュー.
ファイヤークロール料金
2026年のFirecrawlの費用は以下の通りです。
| プラン | 価格 | 最適な用途 |
|---|---|---|
| 無料 | 無料 | いくつかのページでスクレイピングとクロールのテストを実施 |
| 趣味 | 月額16ドル | 個人開発者と小規模なデータパイプライン |
| 標準 | 月額83ドル | 定期的なウェブクローリング作業を実行するチーム |
| 成長 | 月額333ドル | 大量市場調査およびモニタリング |
無料トライアル: はい、無料プランでは限られた数のページをスクレイピングできます。
返金保証: 正式な保証はありませんが、いつでもダウングレードできます。
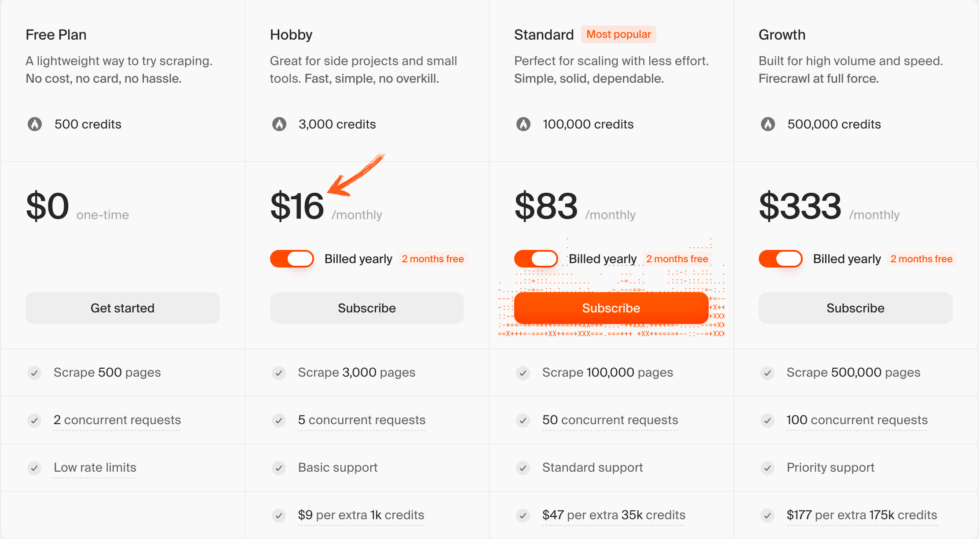
💰 最もお得な価格: スタンダード ― ほとんどのチームにとって、クレジットと同時ブラウザ数のバランスが最も良い選択肢です。
ファイヤークロール vs 代替案
Firecrawlは他社製品と比べてどうでしょうか?競合状況は以下のとおりです。
| 道具 | 最適な用途 | 価格 | 評価 |
|---|---|---|---|
| ファイヤークロール | AI対応のクリーンデータ | 月額16ドル | ⭐ 3.5 |
| アピファイ | 事前に構築されたアクター | 月額49ドル | ⭐ 4.5 |
| ブライトデータ | プロキシスケール | カスタム | ⭐ 4.6 |
| クロール4AI | オープンソース | 無料 | ⭐ 4.4 |
| スクレイピー | Python制御 | 無料 | ⭐ 4.5 |
| スクレイプグラフAI | LLMグラフスクレイピング | 月額20ドル | ⭐ 4.3 |
おすすめ商品:
- 総合ベスト: Firecrawl ― 単一のAPIから得られる、最もクリーンでLLM対応のデータ。
- ベスト予算: Crawl4AI ― 実践的なデータサイエンティストのための、無料のオープンソースソフトウェア。
- 初心者におすすめ: Firecrawl ― 自然言語による指示で難しい部分は隠されます。
- プロキシの規模に最適: Bright Data ― 複雑なウェブサイト向けの巨大なプロキシプール。
🎯 ファイヤークロールの代替案
Firecrawlの代替案をお探しですか?おすすめの選択肢はこちらです。
- 🚀 Apify: ウェブスクレイピング用の既製アクターのマーケットプレイス。単一のAPIを介してすぐに使えるスクレイパーが必要な場合に便利です。
- 🏢 ブライトデータ: 大規模なクロール作業や、動的なウェブサイト全体にわたる大規模なコンテンツ監視に対応するエンタープライズ向けプロキシネットワーク。
- 💰 クロール4AI: 無料でオープンソースのクローラーで、LLM対応データを出力するため、予算を抑えたAIワークフローやローカル環境での実行に最適です。
- 🔧 スクレイピー: 開発者がクロール、パース、データパイプラインを完全に制御できる、実績のあるPythonフレームワーク。
- 🧠 スクレイプグラフAI: グラフベースのAIを活用した抽出により、ページ構造をマッピングし、スキーマに基づいた構造化データの抽出を実現します。
全リストについては、こちらをご覧ください。 ファイヤークロールの代替案 ガイド。
⚔️ ファイヤークロールの比較
Firecrawlが各競合サービスと比べてどうなのか、以下に示します。
- Firecrawl vs Apify: Firecrawlは、クリーンでLLM対応の出力という点で優れており、Apifyは、あらかじめ構築されたスクレイパーのライブラリという点で優れている。
- Firecrawl vs Bright Data: Bright Dataはプロキシの規模で優位に立ち、Firecrawlはよりシンプルな構造化データ抽出で優位に立つ。
- Firecrawl vs Crawl4AI: Crawl4AIは価格とセルフホスティングの点で優れており、Firecrawlは管理されたレート制限と信頼性の点で優れている。
- ファイヤークロール対スクレイピー: Scrapyは低レベルの制御で優位に立ち、Firecrawlは速度とプロキシ設定不要で優位に立つ。
- Firecrawl vs ScrapeGraphAI: どちらもAIを搭載しているが、Firecrawlはクロール範囲で優れており、ScrapeGraphAIはグラフロジックで優れている。
今すぐFirecrawlを使い始めましょう
Firecrawlの主要な機能をすべて使いこなせるようになりました。
- ✅ スクレイピング
- ✅ 這う
- ✅検索
- ✅ 地図
- ✅抽出
次のステップ: どれか一つの機能を選んで、今すぐ試してみてください。
ほとんどの人はScrapeから始める。
5分もかかりません。
よくある質問
Firecrawlは何に使われるのですか?
Firecrawlは、AIを活用したウェブスクレイピングツールです。ウェブページを、AIエージェント、RAGシステム、市場調査、価格監視などに利用できる、クリーンでLLM対応のデータに変換します。
Firecrawlは無料で利用できますか?
はい。無料プランでは、APIキーを使用して限られた数のページをスクレイピングできるため、料金を支払う前にスクレイピング、クロール、抽出のテストを行うことができます。
Firecrawlはどのようにインストールすればいいですか?
pip install firecrawl-py を実行し、次に API キーを環境変数に設定して、firecrawl インスタンスを作成し、最初の API 呼び出しを開始します。
ファイヤークロールは、従来のスクレイピングとどう違うのですか?
従来のウェブスクレイピングでは、Seleniumと手動によるプロキシ設定が必要でした。Firecrawlは、単一のAPIサービスを通じて、JavaScriptのレンダリング、レート制限、データクレンジングを自動的に処理します。
Firecrawlは構造化データを抽出できますか?
はい。自然言語によるプロンプトまたはPydanticスキーマを使用してスキーマベースの抽出を行うと、Firecrawlは生のHTMLではなく構造化されたJSONを返します。













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
