
Быстрый старт
В этом руководстве описаны все функции Firecrawl:
- Начиная — Создайте учетную запись Firecrawl и укажите свой API-ключ.
- Как использовать скребок — Получение готовых к использованию данных LLM с отдельных веб-страниц
- Как использовать Crawl — Сканировать целые веб-сайты и переходить по каждой ссылке.
- Как пользоваться поиском — Ищите в интернете данные в режиме реального времени.
- Как пользоваться картой — Выполнить поиск URL-адресов на отдельных страницах
- Как использовать экстракт — Извлечение структурированных данных с помощью подсказок на естественном языке
Необходимое время: 5 минут на каждый фильм
Также в этом руководстве: Полезные советы | Распространенные ошибки | Поиск неисправностей | Цены | Альтернативы
Почему стоит доверять этому руководству?
Я пользуюсь Firecrawl уже больше года и протестировал все функции, описанные здесь.
Этот учебный материал по использованию Firecrawl основан на реальном практическом опыте веб-скрейпинга.

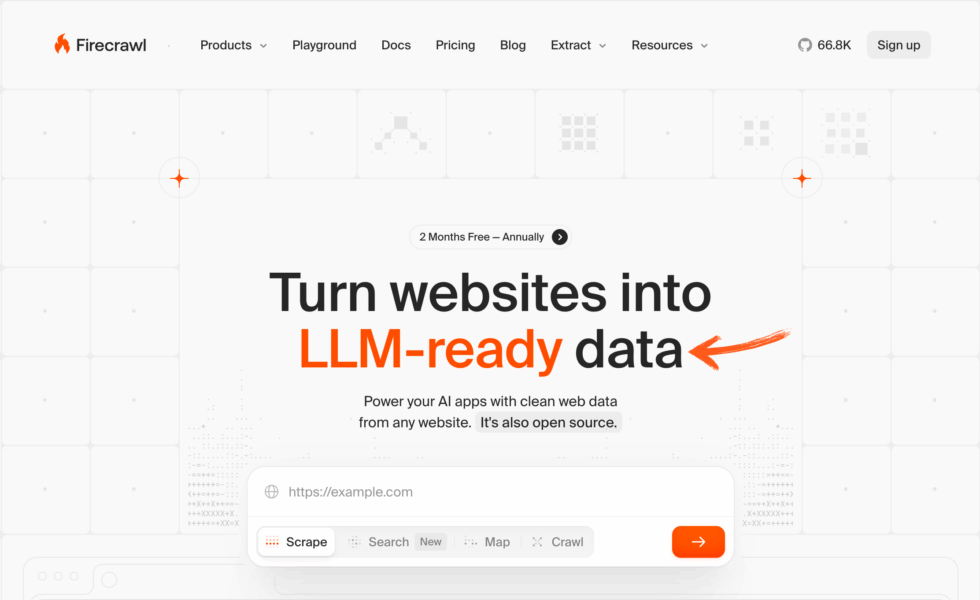
Firecrawl — это веб-краулер на основе искусственного интеллекта, который преобразует веб-сайты в чистые данные, готовые к обработке с помощью LLM.
Однако большинство пользователей лишь поверхностно знакомятся с возможностями этого универсального инструмента.
В этом руководстве пошагово, с помощью скриншотов, показано, как использовать каждую из основных функций.
Учебное пособие по Firecrawl
В этом подробном руководстве по Firecrawl вы найдете описание всех функций, от вашего первого ключа API до расширенных пакетных операций, которые сделают вас опытным пользователем.
Огненный ползунок
Превратите любой веб-сайт в чистые, структурированные данные с помощью единого API. Firecrawl обрабатывает рендеринг JavaScript, устанавливает ограничения на количество запросов и определяет URL-адреса, поэтому вы быстро получаете данные, готовые к использованию LLM. Начните с бесплатного плана — кредитная карта не требуется.
Начало работы с Firecrawl
Перед использованием любой функции выполните эту одноразовую настройку.
Это займет около 3 минут.
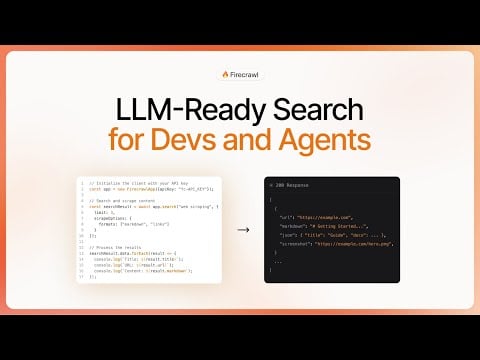
Сначала посмотрите этот краткий обзор:
Теперь давайте рассмотрим каждый шаг.
Шаг 1: Создайте свою учетную запись
Перейдите на сайт Firecrawl по адресу https://www.firecrawl.dev.
Нажмите «Зарегистрироваться», чтобы открыть аккаунт Firecrawl на бесплатном тарифе.
Введите свой адрес электронной почты и создайте пароль.
✓ Контрольная точка: Проверьте свой входящие для получения подтверждающего письма.
Шаг 2: Установите и настройте свой API-ключ.
Для добавления API-сервиса в ваш проект выполните команду `pip install firecrawl-py`.
Скопируйте свой API-ключ, затем сохраните его как переменную окружения. безопасность.
Вот как выглядит панель управления:
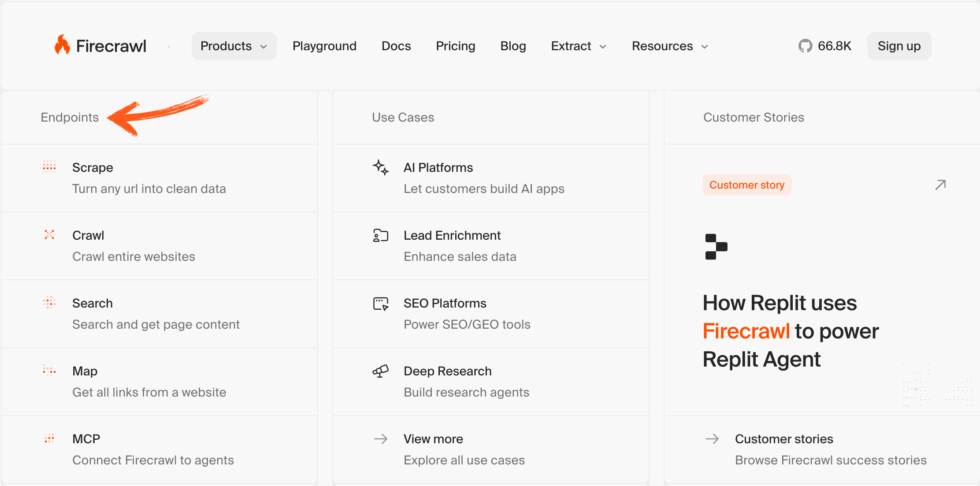
✓ Контрольная точка: Вы должны увидеть главную панель управления с информацией об использовании и ключом API.
Шаг 3: Сделайте свой первый звонок
Импортируйте класс FirecrawlApp и создайте экземпляр Firecrawl, используя свой ключ.
Каждый запрос отправляется на базовую конечную точку по адресу https://api.firecrawl.dev/v2.
✅ Готово: Вы готовы к сбору, индексированию, поиску, построению карт и извлечению данных.
Как использовать Firecrawl Scraper
Соскребок Позволяет получать чистые, готовые к использованию LLM данные с одной страницы с помощью одного единственного вызова API.
Режим парсинга нацелен на отдельные страницы и идеально подходит для быстрого извлечения конкретной информации.
Вот пошаговая инструкция по его использованию.
Теперь давайте разберем каждый шаг.
Шаг 1: Получите свой API-ключ
Создайте учетную запись Firecrawl, затем скопируйте свой API-ключ из панели управления.
Сохраните его в качестве переменной окружения, чтобы ваш API-ключ не отображался в исходном коде.
Шаг 2: Вызовите конечную точку сбора данных.
Передайте один URL-адрес методу .scrape_url() вашего экземпляра Firecrawl.
В качестве выходных данных вы можете запросить формат Markdown, необработанный HTML или структурированный JSON.
Вот как это выглядит:
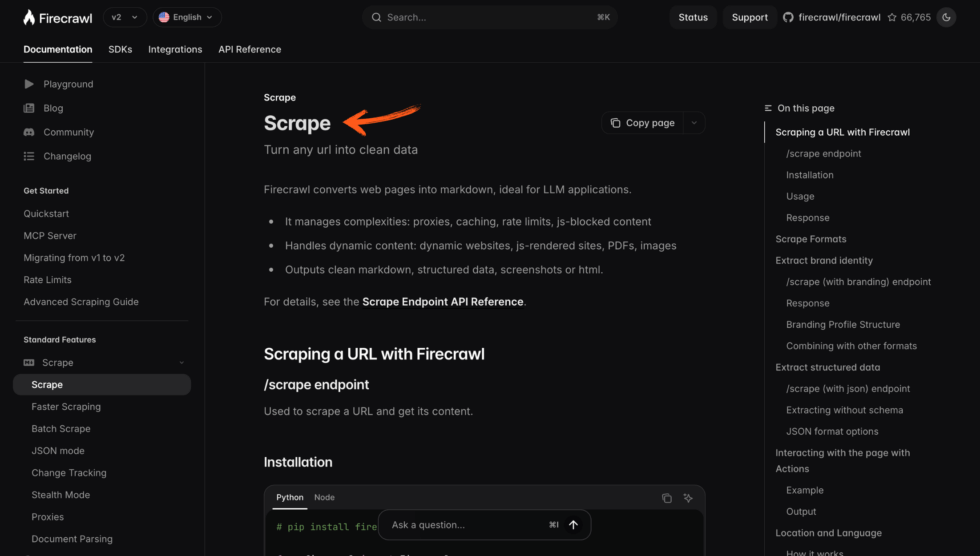
✓ Контрольная точка: На текущей странице должен отображаться чистый разметочный текст, готовый для использования в приложениях искусственного интеллекта.
Шаг 3: Прочитайте результат очистки.
Firecrawl возвращает чистые данные с возможностью чтения. текстОчищено от ненужных HTML-тегов.
✅ Результат: Вы преобразовали одну из веб-страниц в структурированные веб-данные с помощью одного API.
💡 Полезный совет: Установите параметр max_age, чтобы кэшировать результаты и пропускать повторный сбор данных со страницы, которая не изменилась.
Как использовать Firecrawl Crawler
Ползти Позволяет сканировать целые веб-сайты и автоматически переходить по ссылкам без карты сайта.
Режим сканирования позволяет сканировать веб-сайты по нескольким страницам и собирать данные со всех доступных страниц.
Вот пошаговая инструкция по его использованию.
Теперь давайте разберем каждый шаг.
Шаг 1: Укажите корневой URL-адрес
Укажите начальный URL-адрес для точки сканирования, например, https://example.com.
Firecrawl самостоятельно сканирует веб-страницы по ссылкам и отслеживает их содержимое.
Шаг 2: Запуск задачи сканирования
Запустите задачу сканирования и получите возвращенный идентификатор задачи для отслеживания хода выполнения.
Используйте идентификатор задания для проверки статуса и получения проиндексированных данных по мере завершения индексации каждой страницы.
Вот как это выглядит:
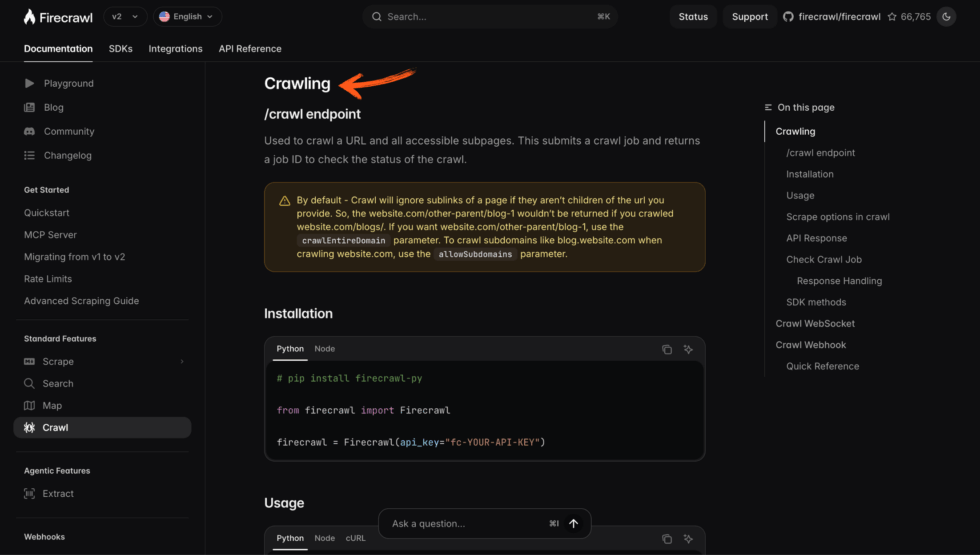
✓ Контрольная точка: Вы должны увидеть, как данные, собранные с разных страниц сайта, преобразуются в веб-данные.
Шаг 3: Экспорт результатов
Собирайте каждую страницу в формате Markdown или структурированного JSON для ваших конвейеров обработки данных.
✅ Результат: Вы захватили весь сайт целиком, включая сложные веб-сайты с динамическим контентом.
💡 Полезный совет: Firecrawl использует пакетную обработку и параллельное выполнение операций сканирования, поэтому большие объемы данных обрабатываются быстро.
Как использовать поисковую систему Firecrawl
Поиск Позволяет осуществлять поиск в интернете и получать корректные результаты, которые можно напрямую передавать агентам искусственного интеллекта.
Поиск позволяет запрашивать информацию в интернете и получать веб-данные в режиме реального времени в виде читаемого текста.
Вот пошаговая инструкция по его использованию.
Теперь давайте разберем каждый шаг.
Шаг 1: Отправьте запрос
Вызовите конечную точку поиска, используя простой запрос на естественном языке.
Firecrawl может осуществлять поиск в интернете на новостных сайтах, сайтах по поиску работы и сайтах с отзывами.
Шаг 2: Выберите формат вывода
Для каждого результата запросите формат Markdown или структурированный JSON.
Все результаты поступают в виде чистых данных, а не зашумленного необработанного HTML-кода.
Вот как это выглядит:
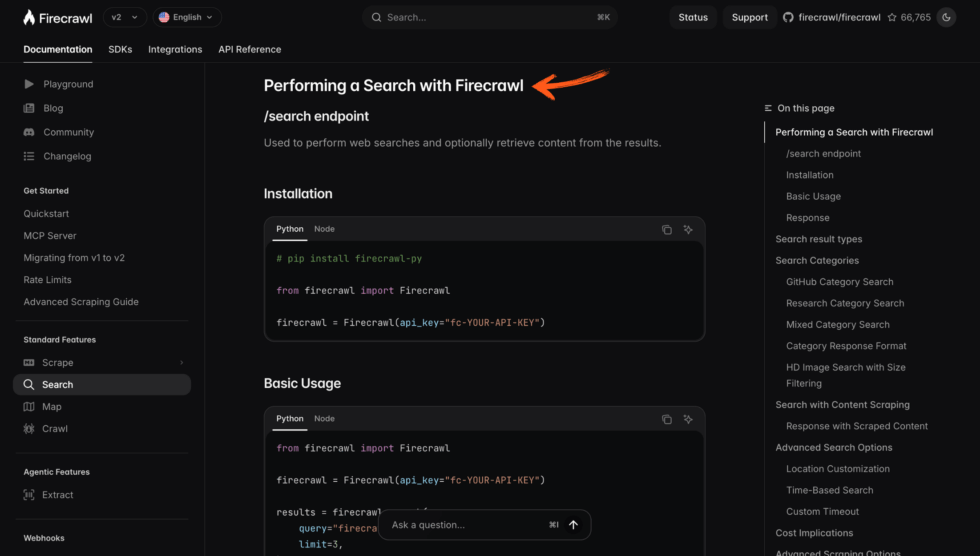
✓ Контрольная точка: В результате поиска вы должны увидеть отсортированные веб-страницы в виде структурированных веб-данных.
Шаг 3: Передайте данные в ваше приложение.
Введите структурированные данные в ИИ-помощники или рабочие процессы с использованием ИИ.
✅ Результат: Вы добавили веб-контент в реальном времени в свои приложения с использованием ИИ всего одним вызовом API.
💡 Полезный совет: Используйте поиск в паре с извлечением текста для сбора новостных статей для маркетинговых исследований или анализа конкурентной среды.
Как использовать расширенную карту Firecrawl
Карта Позволяет выполнять поиск URL-адресов и превращать один домен в полную карту отдельных страниц.
Режим карты быстро извлекает все URL-адреса на сайте для оперативного поиска URL-адресов.
Вот пошаговая инструкция по его использованию.
Теперь давайте разберем каждый шаг.
Шаг 1: Отправьте домен.
Передайте в конечную точку карты один корневой URL-адрес.
Firecrawl возвращает все ссылки без необходимости использования карты сайта.
Шаг 2: Просмотрите список URL-адресов.
Перед тем как спарсить полученные страницы, просканируйте их по отдельности.
Сохраните список в CSV-файл, чтобы спланировать извлечение данных.
Вот как это выглядит:
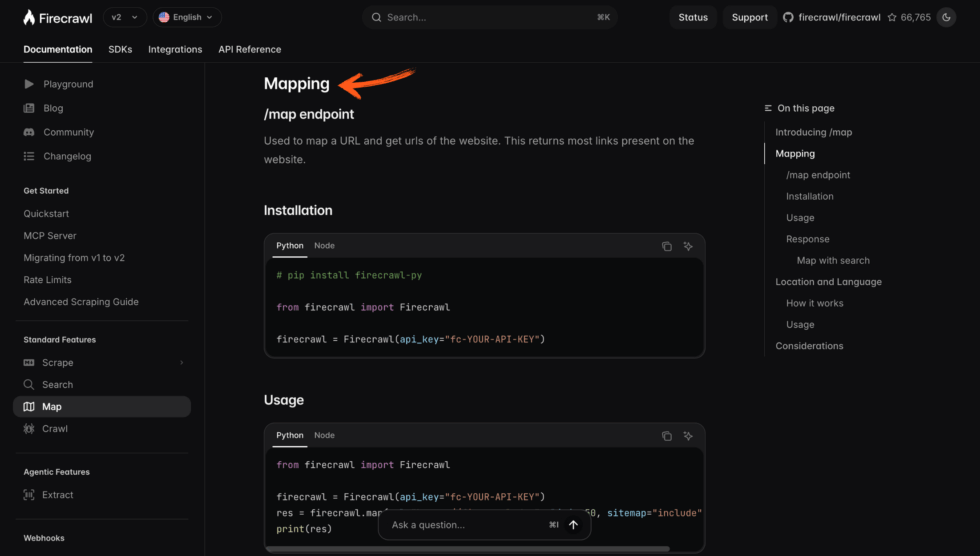
✓ Контрольная точка: По одному URL-адресу вы должны увидеть полную карту сайта со всеми веб-страницами.
Шаг 3: Выберите, что нужно скопировать.
Выберите нужные страницы, а затем отправьте их на сбор или сканирование.
✅ Результат: Вы составили карту всего сайта, подготовив его к целенаправленному веб-скрейпингу.
💡 Полезный совет: При разработке динамических веб-сайтов и веб-приложений сначала составьте карту ресурсов, чтобы избежать траты кредитов на ненужные страницы.
Как использовать Firecrawl Extractor
Извлекать Позволяет извлекать структурированные данные с любой страницы, используя подсказки на естественном языке.
Функция Extract использует интеллектуальный анализ данных с помощью искусственного интеллекта для извлечения именно тех полей, которые вы описываете.
Вот пошаговая инструкция по его использованию.
Теперь давайте разберем каждый шаг.
Шаг 1: Определение схемы
Создайте модель Pydantic, используя следующий код: `from pydantic import BaseModel.`
Извлечение на основе схемы указывает Firecrawl, какие поля следует вернуть в виде структурированного JSON.
Шаг 2: Опишите данные
Добавьте подсказки на естественном языке для полей, которые схема не может отобразить.
Вот как можно извлекать данные из веб-страниц без написания правил синтаксического анализа.
Вот как это выглядит:
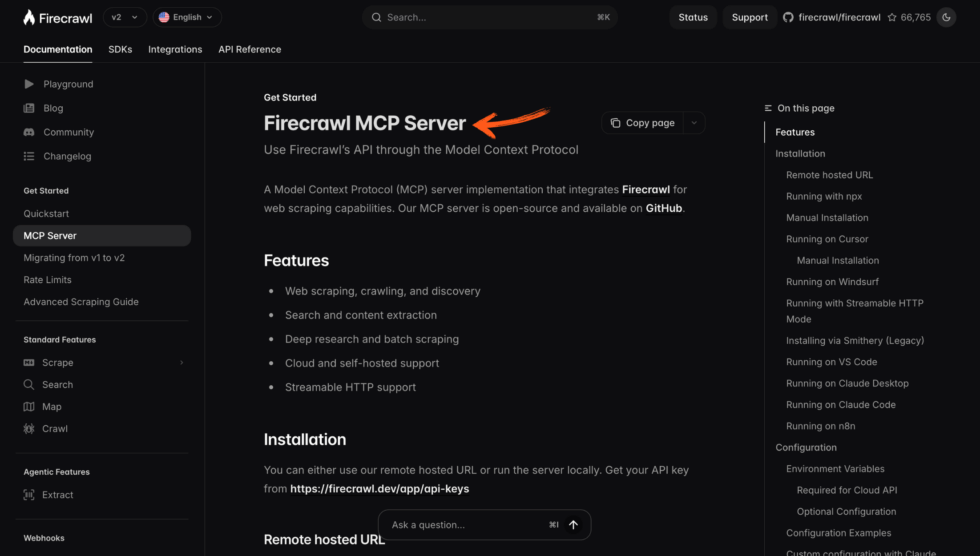
✓ Контрольная точка: Вместо неряшливых HTML-тегов вы должны видеть аккуратные структурированные данные.
Шаг 3: Получение структурированного JSON
Firecrawl возвращает чистый структурированный JSON, готовый для использования в качестве обучающих данных.
✅ Результат: Вы заменили ненадежные парсеры одним вызовом извлечения данных и сократили объем работ по очистке данных.
💡 Полезный совет: Используйте only_main_content, include_tags и exclude_tags, чтобы сохранить фокус на извлеченных веб-данных.
Советы и полезные приемы для Firecrawl Pro
После более чем года тестирования Firecrawl, вот мои лучшие советы по более качественному извлечению данных.
Клавиатурные сочетания
| Действие | Быстрый доступ |
|---|---|
| Бег, царапины на детской площадке | Ctrl + Enter |
| Скопировать ключ API | Ctrl + C |
| Открытая документация | Ctrl + K |
| Формат выходного сигнала коммутатора | Вкладка |
Скрытые функции, которые большинство людей упускают из виду.
- кэширование по максимальному возрасту: Используйте повторно недавно собранные данные для более быстрого и дешевого повторного сбора информации.
- Действия в браузере: Чтобы получить доступ к контенту, скрытому за рендерингом JavaScript, кликайте, прокручивайте и вводите текст.
- Асинхронная пакетная обработка: Обрабатывайте тысячи URL-адресов в пакетном режиме, не блокируя работу ваших веб-приложений.
Распространенные ошибки, которых следует избегать при прохождении курса Firecrawl.
Ошибка №1: Жестко прописывание ключа API.
❌ Неправильно: Вставьте свой API-ключ непосредственно в общий код или публичный репозиторий.
✅ Справа: Загрузите ключ из переменной окружения, чтобы он оставался приватным.
Ошибка №2: Сначала сканирование, а потом составление карты.
❌ Неправильно: Сканирование целых веб-сайтов вслепую и трата кредитов на ненужные страницы.
✅ Справа: Сначала выполните поиск URL-адресов с использованием карты, затем просканируйте только необходимые страницы.
Ошибка №3: Самостоятельный анализ необработанного HTML-кода.
❌ Неправильно: Разработка ненадежных правил для очистки исходного HTML-кода и удаления HTML-тегов вручную.
✅ Справа: Используйте извлечение данных на основе схемы, чтобы получить чистый структурированный JSON напрямую.
Устранение неполадок Firecrawl
Проблема: 401 несанкционированная ошибка
Причина: Ваш API-ключ отсутствует или не загружен из переменной окружения.
Исправить: Повторно экспортируйте ключ, затем создайте новый экземпляр Firecrawl и повторите попытку.
Проблема: ошибки тайм-аута на сложных веб-сайтах.
Причина: Интенсивная отрисовка JavaScript или динамический контент занимают больше времени.
Исправить: Добавьте действие ожидания, чтобы текущая страница завершила загрузку перед захватом изображения.
Проблема: Достижение лимитов скорости запросов.
Причина: Слишком много запросов одновременно на бесплатном или более низком тарифном плане.
Исправить: Для замедления пакетных операций или обновления до более производительной системы с большим количеством одновременно работающих браузеров.
📌 Примечание: Если ни один из этих способов не решит вашу проблему, обратитесь в службу поддержки Firecrawl.
Что такое Firecrawl?
Огненный ползунок Это инструмент для веб-скрейпинга на основе искусственного интеллекта, который преобразует веб-сайты в чистые, структурированные данные.
Представьте это как веб-краулер, который предоставляет агентам искусственного интеллекта читаемый текст вместо невнятного HTML-кода.
Firecrawl был разработан компанией Mendable.ai для сокращения неэффективного использования токенов в приложениях на основе искусственного интеллекта.
Посмотрите этот краткий обзор:
В его состав входят следующие ключевые особенности:
- Соскребите: Извлекайте данные с отдельных веб-страниц в формате Markdown или структурированном JSON.
- Ползти: Сканируйте целые веб-сайты и переходите по ссылкам без карты сайта.
- Поиск: Поиск в интернете и получение корректных данных с новостных сайтов и сайтов с отзывами.
- Карта: Быстрое обнаружение URL-адресов, позволяющее преобразовать один домен в полную карту сайта.
- Извлекать: Извлечение структурированных веб-данных с использованием подсказок на естественном языке и схем Pydantic.
Firecrawl превосходит традиционный веб-скрейпинг, самостоятельно обрабатывая прокси, ограничения скорости и рендеринг JavaScript.
В отличие от традиционных инструментов, требующих Selenium, он предоставляет возможности для специалистов по обработке данных и разработчиков через единый API-сервис.
Полный обзор смотрите в нашем разделе Обзор фильма «Firecrawl».
Цены на Firecrawl
Вот сколько будет стоить Firecrawl в 2026 году:
| План | Цена | Лучше всего подходит для |
|---|---|---|
| Бесплатно | Бесплатно | Тестирование парсинга и сканирования нескольких страниц. |
| Хобби | 16 долларов в месяц | Разработчики-одиночки и небольшие конвейеры обработки данных |
| Стандарт | 83 доллара в месяц | Команды, выполняющие регулярные задачи по сканированию веб-сайтов. |
| Рост | 333 доллара в месяц | Масштабные исследования и мониторинг рынка |
Бесплатная пробная версия: Да, бесплатный тарифный план позволяет парсить ограниченное количество страниц.
Гарантия возврата денег: Официальных гарантий нет, но вы можете в любой момент понизить уровень своей подписки.
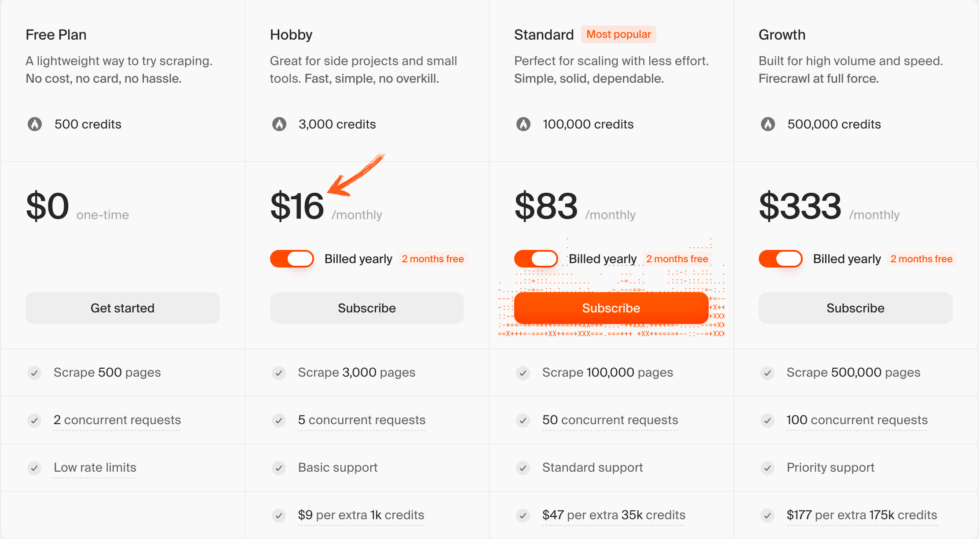
💰 Лучшее соотношение цены и качества: Стандартный режим — оптимальный баланс кредитов и количества одновременно работающих браузеров для большинства команд.
Огненный ползучий метод против альтернатив
Как Firecrawl выглядит на фоне конкурентов? Вот конкурентная ситуация:
| Инструмент | Лучше всего подходит для | Цена | Рейтинг |
|---|---|---|---|
| Огненный ползунок | Очищенные данные, готовые к использованию ИИ | 16 долларов в месяц | ⭐ 3.5 |
| Апофит | Предварительно созданные акторы | 49 долларов в месяц | ⭐ 4.5 |
| Яркие данные | Прокси-масштаб | $ Custom | ⭐ 4.6 |
| Crawl4AI | Открытый исходный код | Бесплатно | ⭐ 4.4 |
| Скребок | управление Python | Бесплатно | ⭐ 4.5 |
| ScrapGraphAI | Парсинг графиков LLM | 20 долларов в месяц | ⭐ 4.3 |
Краткий выбор:
- Лучший вариант в целом: Firecrawl — самые чистые данные, готовые к обработке с помощью LLM, из одного API.
- Оптимальный бюджет: Crawl4AI — бесплатное программное обеспечение с открытым исходным кодом для специалистов по анализу данных, имеющих практический опыт.
- Лучший вариант для начинающих: Firecrawl — подсказки на естественном языке скрывают сложные моменты.
- Лучший вариант для масштабирования с помощью прокси-сервера: Bright Data — огромный пул прокси-серверов для сложных веб-сайтов.
🎯 Альтернативы пожарному ползанию
Ищете альтернативы Firecrawl? Вот лучшие варианты:
- 🚀 Апифы: Торговая площадка готовых инструментов для веб-скрейпинга, удобна, когда вам нужны готовые парсеры для одного API.
- 🏢 Яркие данные: Корпоративная прокси-сеть для масштабных задач сканирования и мониторинга контента на динамических веб-сайтах.
- 💰 Crawl4AI: Бесплатный веб-краулер с открытым исходным кодом, который выдает данные, готовые для обработки с помощью LLM, идеально подходит для бюджетных рабочих процессов искусственного интеллекта и локальных запусков.
- 🔧 Скребок: Проверенный в боевых условиях фреймворк на Python, предоставляющий разработчикам полный контроль над процессами сбора, анализа и обработки данных.
- 🧠 ScrapeGraphAI: Графовая, основанная на искусственном интеллекте технология извлечения данных, которая сопоставляет структуру страниц для извлечения структурированных данных на основе схемы.
Полный список смотрите в нашем Альтернативы Firecrawl гид.
⚔️ Сравнение Firecrawl
Вот как Firecrawl выглядит на фоне каждого из конкурентов:
- Firecrawl против Apify: Firecrawl выигрывает за счет чистого, готового к использованию с LLM вывода; Apify выигрывает за счет своей библиотеки готовых парсеров.
- Firecrawl против Bright Data: Bright Data выигрывает по масштабируемости прокси-серверов; Firecrawl выигрывает по простоте извлечения структурированных данных.
- Firecrawl против Crawl4AI: Crawl4AI выигрывает по цене и возможности самостоятельного размещения; Firecrawl выигрывает по управляемым ограничениям скорости запросов и надежности.
- Огненный ползунок против Скрейпи: Scrapy выигрывает за счет контроля низкого уровня; Firecrawl выигрывает за счет скорости и отсутствия необходимости в настройке прокси.
- Firecrawl против ScrapeGraphAI: Обе программы работают на основе искусственного интеллекта; Firecrawl выигрывает по охвату сканирования, ScrapeGraphAI — по логике графов.
Начните использовать Firecrawl прямо сейчас!
Вы научились использовать все основные функции Firecrawl:
- ✅ Соскребите
- ✅ Ползание
- ✅ Поиск
- ✅ Карта
- ✅ Экстракт
Следующий шаг: Выберите одну функцию и попробуйте прямо сейчас.
Большинство начинают с Scrape.
Это займет меньше 5 минут.
Часто задаваемые вопросы
Для чего используется Firecrawl?
Firecrawl — это инструмент для веб-скрейпинга на основе искусственного интеллекта. Он преобразует веб-страницы в чистые, готовые к использованию данные для агентов ИИ, систем отслеживания трафика, маркетинговых исследований и мониторинга цен.
Можно ли использовать Firecrawl бесплатно?
Да. Бесплатный тариф позволяет парсить ограниченное количество страниц с помощью вашего API-ключа, поэтому вы можете протестировать парсинг, сканирование и извлечение данных перед оплатой.
Как установить Firecrawl?
Выполните команду `pip install firecrawl-py`, затем установите свой API-ключ в качестве переменной окружения и создайте экземпляр Firecrawl для выполнения первого вызова API.
Чем Firecrawl отличается от традиционного метода очистки поверхности?
Для традиционного веб-скрейпинга необходимы Selenium и ручная настройка прокси. Firecrawl же автоматически обрабатывает рендеринг JavaScript, устанавливает ограничения на количество запросов и очищает данные через единый API-сервис.
Может ли Firecrawl извлекать структурированные данные?
Да. Используйте подсказки на естественном языке или схему Pydantic для извлечения данных на основе схемы, и Firecrawl вернет структурированный JSON вместо необработанного HTML.













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
