
Szybki start
W tym przewodniku omówiono wszystkie funkcje Firecrawl:
- Rozpoczęcie pracy — Utwórz konto Firecrawl i ustaw swój klucz API
- Jak korzystać ze Scrape'a — Pobierz gotowe dane llm z pojedynczych stron internetowych
- Jak korzystać z funkcji Crawl — Przeszukuj całe witryny i śledź każdy link
- Jak korzystać z wyszukiwania — Przeszukuj sieć w celu znalezienia danych w czasie rzeczywistym
- Jak korzystać z mapy — Uruchom wykrywanie adresów URL na poszczególnych stronach
- Jak używać Extract — Wyodrębniaj ustrukturyzowane dane za pomocą podpowiedzi w języku naturalnym
Czas potrzebny: 5 minut na każdy film
Również w tym przewodniku: Profesjonalne porady | Typowe błędy | Rozwiązywanie problemów | Wycena | Alternatywy
Dlaczego warto zaufać temu przewodnikowi
Używam Firecrawl od ponad roku i przetestowałem każdą funkcję opisaną w tym artykule.
Ten samouczek dotyczący korzystania z Firecrawl powstał na podstawie rzeczywistej pracy przy scrapowaniu stron internetowych.

Firecrawl to oparty na sztucznej inteligencji program do indeksowania stron internetowych, który przekształca strony internetowe w czyste dane gotowe do odczytu maszynowego.
Jednak większość użytkowników zaledwie powierzchownie poznaje możliwości tego wszechstronnego narzędzia.
W tym przewodniku znajdziesz krok po kroku instrukcje dotyczące korzystania ze wszystkich głównych funkcji, wraz ze zrzutami ekranu.
Samouczek Firecrawl
Ten kompletny samouczek Firecrawl przeprowadzi Cię przez każdą funkcję, od pierwszego klucza API po zaawansowane operacje wsadowe, które uczynią z Ciebie zaawansowanego użytkownika.
Firecrawl
Zamień dowolną stronę internetową w czyste, ustrukturyzowane dane za pomocą jednego interfejsu API. Firecrawl obsługuje renderowanie JavaScript, limity przepustowości i wyszukiwanie adresów URL, dzięki czemu szybko uzyskasz dane gotowe do LLM. Zacznij od darmowego planu — karta kredytowa nie jest wymagana.
Pierwsze kroki z Firecrawl
Przed użyciem jakiejkolwiek funkcji należy wykonać jednorazową konfigurację.
Zajmie to około 3 minuty.
Obejrzyj najpierw ten krótki przegląd:
Przyjrzyjmy się teraz każdemu krokowi.
Krok 1: Utwórz swoje konto
Wejdź na stronę Firecrawl pod adresem https://www.firecrawl.dev.
Kliknij „Zarejestruj się”, aby założyć konto Firecrawl w ramach planu bezpłatnego.
Wprowadź swój adres e-mail i utwórz hasło.
✓ Punkt kontrolny: Sprawdź swoje skrzynka odbiorcza aby otrzymać e-mail z potwierdzeniem.
Krok 2: Zainstaluj i ustaw swój klucz API
Uruchom polecenie pip install firecrawl-py, aby dodać usługę API do swojego projektu.
Skopiuj swój klucz API, a następnie zapisz go jako zmienną środowiskową bezpieczeństwo.
Oto jak wygląda pulpit nawigacyjny:
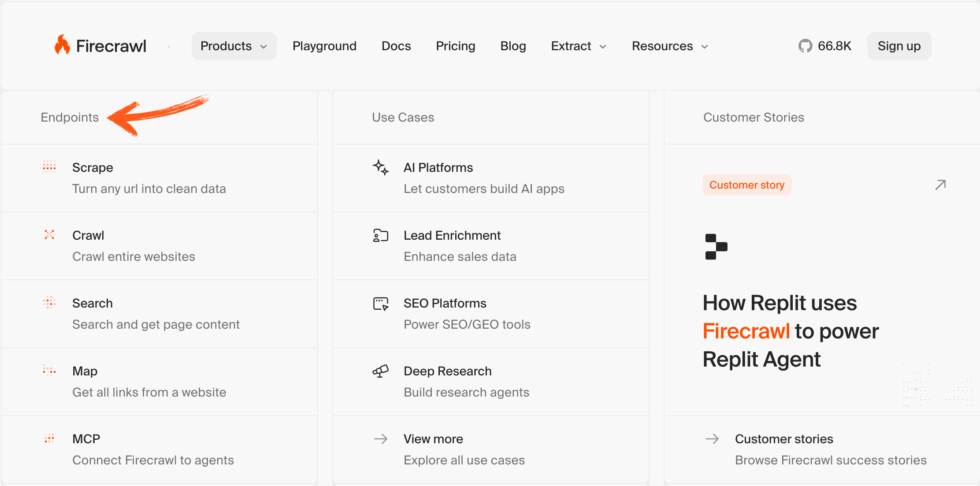
✓ Punkt kontrolny: Powinieneś zobaczyć główny panel z informacjami o użytkowaniu i kluczem API.
Krok 3: Wykonaj pierwszą rozmowę telefoniczną
Zaimportuj klasę FirecrawlApp i utwórz instancję Firecrawl przy użyciu swojego klucza.
Każde żądanie trafia do punktu końcowego bazowego pod adresem https://api.firecrawl.dev/v2.
✅ Zrobione: Jesteś gotowy do zbierania, indeksowania, wyszukiwania, mapowania i wyodrębniania danych.
Jak korzystać z Firecrawl Scraper
Zeskrobać umożliwia pobranie czystych danych gotowych do llm z jednej strony za pomocą jednego wywołania API.
Tryb scrapowania obejmuje poszczególne strony i idealnie nadaje się do szybkiego wyodrębniania określonych szczegółów.
Oto instrukcja krok po kroku, jak z niego korzystać.
Przyjrzyjmy się teraz każdemu krokowi.
Krok 1: Uzyskaj klucz API
Utwórz konto Firecrawl, a następnie skopiuj klucz API z pulpitu nawigacyjnego.
Zapisz go jako zmienną środowiskową, aby nie umieszczać klucza API w surowym kodzie.
Krok 2: Wywołanie punktu końcowego Scrape
Przekaż pojedynczy adres URL do metody .scrape_url() w swojej instancji firecrawl.
Możesz zażądać formatu Markdown, surowego kodu HTML lub ustrukturyzowanego kodu JSON jako danych wyjściowych.
Oto jak to wygląda:
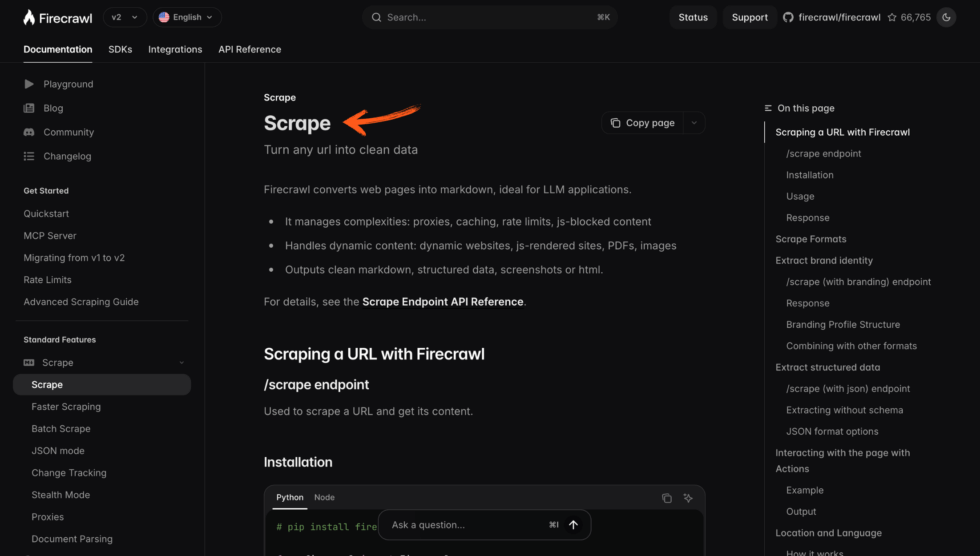
✓ Punkt kontrolny: Powinieneś zobaczyć czysty kod Markdown dla bieżącej strony, gotowy do użycia w aplikacjach AI.
Krok 3: Odczytaj czysty wynik
Firecrawl zwraca czyste dane z możliwością odczytu tekst, oczyszczone ze zbędnych znaczników html.
✅ Wynik: Za pomocą jednego interfejsu API przekształciłeś jedną ze stron internetowych w ustrukturyzowane dane internetowe.
💡 Wskazówka: Ustaw parametr max_age, aby buforować wyniki i pominąć ponowne skanowanie strony, która nie została zmieniona.
Jak korzystać z Firecrawl Crawler
Pełzać umożliwia indeksowanie całych witryn i automatyczne podążanie za linkami bez mapy witryny.
Tryb indeksowania umożliwia indeksowanie witryn internetowych na wielu stronach i zbieranie wszystkich dostępnych stron.
Oto instrukcja krok po kroku, jak z niego korzystać.
Przyjrzyjmy się teraz każdemu krokowi.
Krok 1: Wskaż adres URL główny
Podaj punktowi końcowemu przeszukiwania początkowy adres URL, np. https://example.com.
Firecrawl samodzielnie przeszukuje sieć za pomocą linków i śledzi strony.
Krok 2: Rozpocznij zadanie indeksowania
Uruchom zadanie indeksowania i pobierz zwrócony identyfikator zadania, aby śledzić postęp.
Użyj identyfikatora zadania, aby sprawdzić status i pobrać przeszukane dane po zakończeniu każdej strony.
Oto jak to wygląda:
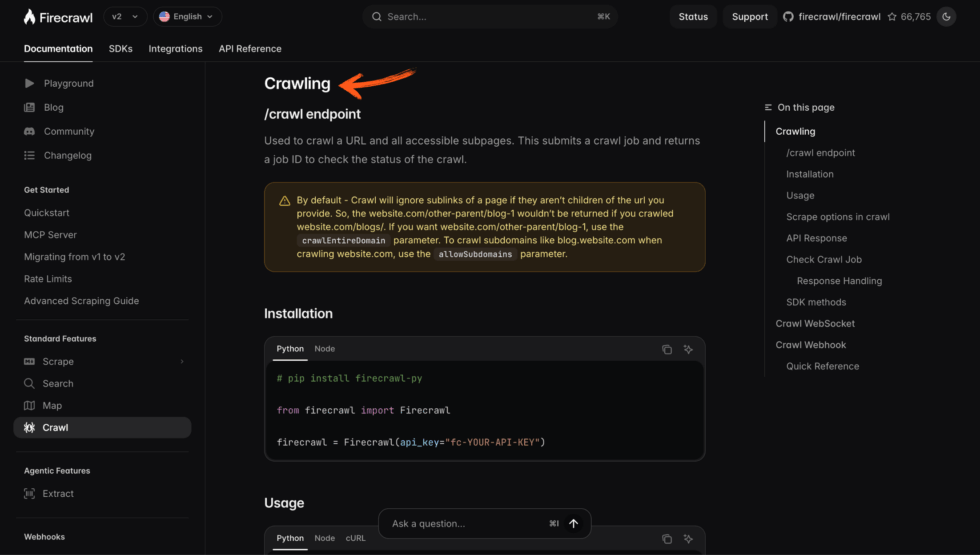
✓ Punkt kontrolny: Powinieneś zobaczyć, jak pobrane ze wszystkich stron witryny strony są przekształcane w dane internetowe.
Krok 3: Eksportuj wyniki
Zbieraj każdą stronę w formacie Markdown lub JSON na potrzeby swoich procesów przetwarzania danych.
✅ Wynik: Przechwyciłeś całą witrynę, nawet złożone witryny z dynamiczną treścią.
💡 Wskazówka: Firecrawl wykorzystuje przetwarzanie wsadowe i współbieżne przeglądarki, dzięki czemu duże operacje indeksowania przebiegają szybko.
Jak korzystać z wyszukiwarki Firecrawl
Szukaj umożliwia przeszukiwanie sieci i zwracanie przejrzystych wyników, które można przekazać bezpośrednio agentom AI.
Funkcja wyszukiwania umożliwia przeszukiwanie sieci i pobieranie danych w czasie rzeczywistym w postaci czytelnego tekstu.
Oto instrukcja krok po kroku, jak z niego korzystać.
Przyjrzyjmy się teraz każdemu krokowi.
Krok 1: Wyślij zapytanie
Wywołaj punkt końcowy wyszukiwania za pomocą prostego zapytania w języku naturalnym.
Firecrawl może przeszukiwać sieć na stronach z wiadomościami, tablicach ogłoszeń o pracę i stronach z recenzjami.
Krok 2: Wybierz format wyjściowy
Poproś o format Markdown lub ustrukturyzowany JSON dla każdego wyniku.
Wszystkie wyniki są dostarczane w postaci czystych danych, a nie zaszumionego, surowego kodu HTML.
Oto jak to wygląda:
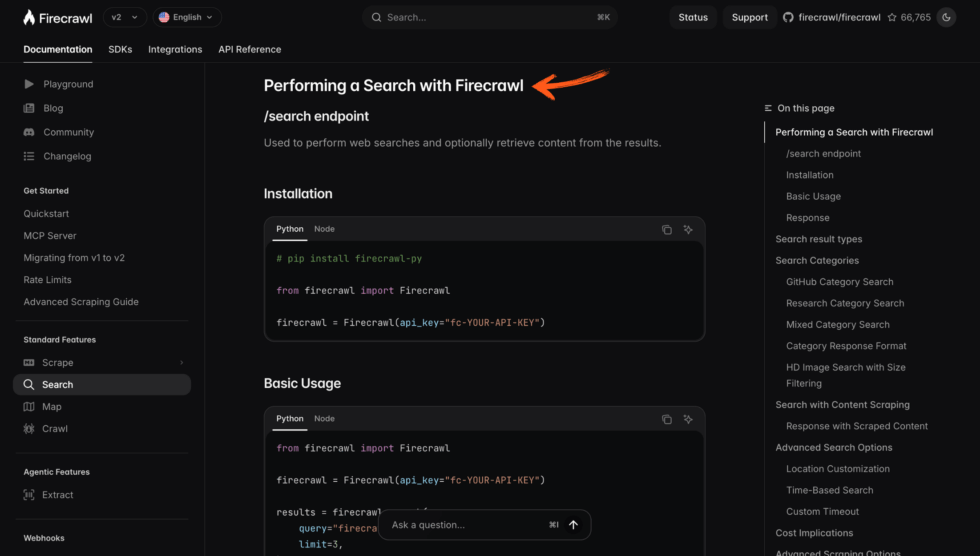
✓ Punkt kontrolny: Powinny zostać wyświetlone uporządkowane strony internetowe w postaci ustrukturyzowanych danych internetowych.
Krok 3: Prześlij do swojej aplikacji
Wprowadź ustrukturyzowane dane do asystenci AI lub przepływy pracy oparte na sztucznej inteligencji.
✅ Wynik: Dodałeś zawartość internetową na żywo do swoich aplikacji AI za pomocą jednego wywołania API.
💡 Wskazówka: Połącz wyszukiwanie z ekstraktem, aby zebrać artykuły informacyjne na potrzeby badań rynku lub wywiadu konkurencyjnego.
Jak korzystać z mapy Firecrawl Advanced
Mapa umożliwia uruchomienie funkcji wyszukiwania adresów URL i przekształcenie jednej domeny w pełną mapę poszczególnych stron.
Tryb mapy szybko pobiera wszystkie adresy URL w witrynie, umożliwiając szybkie wyszukiwanie adresów URL.
Oto instrukcja krok po kroku, jak z niego korzystać.
Przyjrzyjmy się teraz każdemu krokowi.
Krok 1: Prześlij domenę
Przekaż pojedynczy adres URL główny do punktu końcowego mapy.
Firecrawl zwraca wszystkie linki bez konieczności tworzenia mapy witryny.
Krok 2: Przejrzyj listę adresów URL
Przed zeskanowaniem zwróconych stron należy je przeskanować.
Zapisz listę w pliku csv, aby zaplanować wyodrębnianie danych.
Oto jak to wygląda:
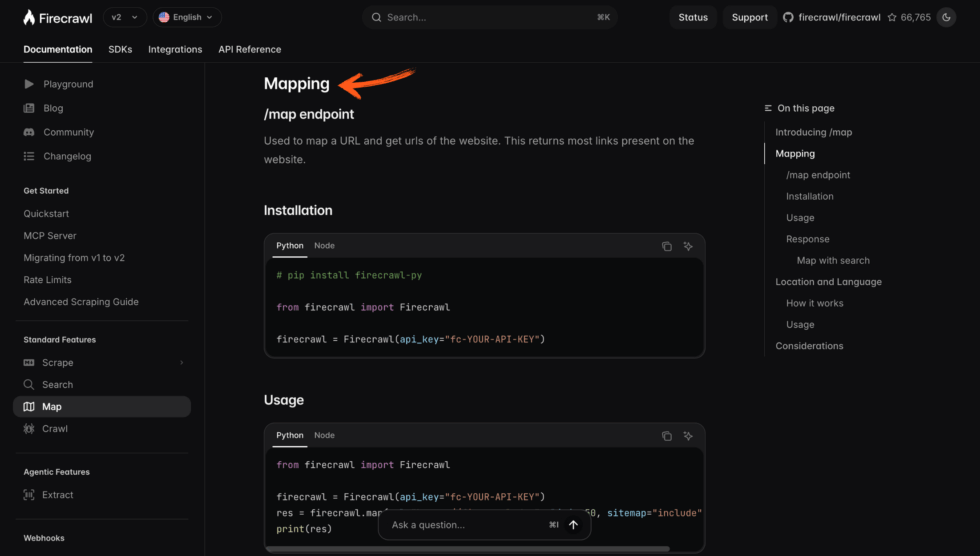
✓ Punkt kontrolny: Powinieneś zobaczyć pełną mapę witryny zawierającą wszystkie strony internetowe pochodzące z jednego adresu URL.
Krok 3: Wybierz, co chcesz zeskrobać
Wybierz strony, które Cię interesują, a następnie prześlij je do scrapowania lub indeksowania.
✅ Wynik: Przygotowałeś mapę całej witryny do ukierunkowanego scrapowania danych z sieci.
💡 Wskazówka: Mapuj najpierw dynamiczne witryny i aplikacje internetowe, aby uniknąć marnowania środków na strony, których nie potrzebujesz.
Jak używać Firecrawl Extractor
Ekstrakt umożliwia wyodrębnianie ustrukturyzowanych danych z dowolnej strony przy użyciu komunikatów w języku naturalnym.
Extract korzysta z analizy wspomaganej przez sztuczną inteligencję, aby wyodrębnić dokładnie te pola, które opisujesz.
Oto instrukcja krok po kroku, jak z niego korzystać.
Przyjrzyjmy się teraz każdemu krokowi.
Krok 1: Zdefiniuj schemat
Napisz model Pydantic za pomocą: from pydantic import BaseModel.
Ekstrakcja oparta na schemacie informuje Firecrawl, które pola zwrócić jako ustrukturyzowany JSON.
Krok 2: Opisz dane
Dodaj monity w języku naturalnym dla pól, których schemat nie może objąć.
W ten sposób można wyodrębnić dane ze stron internetowych bez konieczności pisania reguł parsowania.
Oto jak to wygląda:
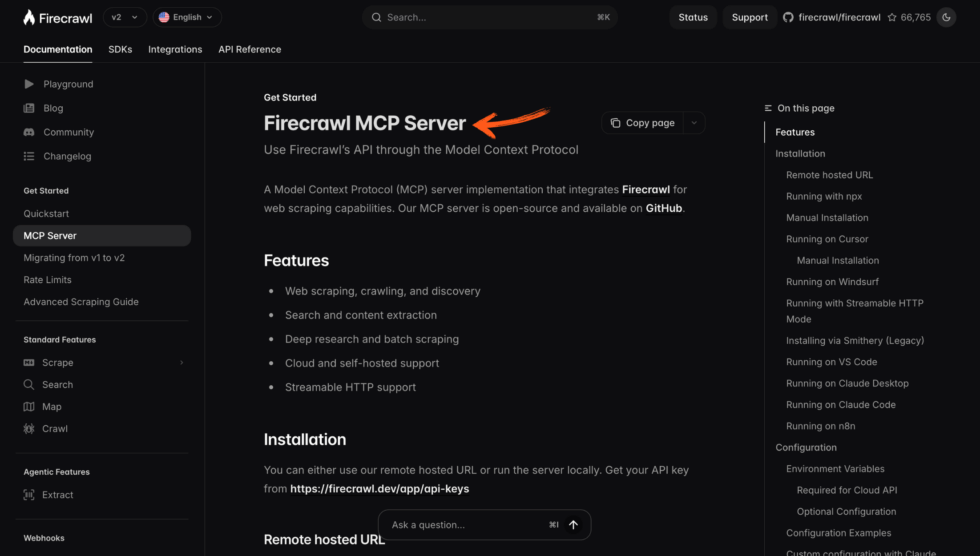
✓ Punkt kontrolny: Zamiast chaotycznych znaczników HTML powinieneś zobaczyć uporządkowane, ustrukturyzowane dane.
Krok 3: Odbierz ustrukturyzowany JSON
Firecrawl zwraca czysty, ustrukturyzowany plik JSON gotowy do użycia w danych treningowych.
✅ Wynik: Zastąpiłeś delikatne narzędzia do scrapowania jednym wywołaniem ekstrakcji i mniejszą ilością czyszczenia danych.
💡 Wskazówka: Użyj only_main_content, include_tags i exclude_tags, aby zachować koncentrację wyodrębnionych danych internetowych.
Porady i skróty Firecrawl Pro
Oto moje najlepsze wskazówki dotyczące czystszego wyodrębniania danych, które zebrałem po ponad roku testowania Firecrawl.
Skróty klawiaturowe
| Działanie | Skrót |
|---|---|
| Biegaj i drap na placu zabaw | Ctrl + Enter |
| Kopiuj klucz API | Ctrl + C |
| Otwórz dokumenty | Ctrl + K |
| Zmień format wyjściowy | Patka |
Ukryte funkcje, których większość ludzi nie dostrzega
- max_age buforowanie: Wykorzystaj ponownie ostatnio przeszukane dane, aby uzyskać szybsze i tańsze ponowne skanowanie.
- Akcje przeglądarki: Kliknij, przewiń i pisz, aby uzyskać dostęp do treści renderowanej w JavaScript.
- Asynchroniczne przetwarzanie wsadowe: Przetwarzaj tysiące adresów URL za pomocą przetwarzania wsadowego bez blokowania aplikacji internetowych.
Typowe błędy, których należy unikać w Firecrawl
Błąd nr 1: Zakodowanie klucza API na stałe
❌ Źle: Wklej swój klucz API bezpośrednio do współdzielonego kodu lub publicznego repozytorium.
✅ Po prawej: Załaduj klucz ze zmiennej środowiskowej, aby pozostał prywatny.
Błąd nr 2: Indeksowanie przed mapowaniem
❌ Źle: Przeszukiwanie całych stron internetowych na ślepo i marnowanie kredytów na stronach-śmieciach.
✅ Po prawej: Najpierw uruchom wykrywanie adresów URL za pomocą mapy, a następnie przeszukaj tylko te strony, których potrzebujesz.
Błąd nr 3: Samodzielne analizowanie surowego kodu HTML
❌ Źle: Tworzenie kruchych reguł do czyszczenia surowego kodu HTML i ręcznego usuwania znaczników HTML.
✅ Po prawej: Użyj ekstrakcji opartej na schemacie, aby uzyskać bezpośrednio czysty, ustrukturyzowany plik JSON.
Rozwiązywanie problemów z Firecrawl
Problem: błędy 401 nieautoryzowane
Przyczyna: Brakuje klucza API lub nie został on załadowany ze zmiennej środowiskowej.
Naprawić: Ponownie wyeksportuj klucz, a następnie utwórz ponownie instancję Firecrawl i spróbuj ponownie.
Problem: błędy przekroczenia limitu czasu na złożonych stronach internetowych
Przyczyna: Ładowanie intensywnego renderowania JavaScript lub dynamicznej zawartości trwa dłużej.
Naprawić: Dodaj akcję oczekiwania, aby bieżąca strona została załadowana przed przechwyceniem.
Problem: Przekroczenie limitów częstotliwości uderzeń
Przyczyna: Zbyt wiele żądań naraz w planie bezpłatnym lub niższym.
Naprawić: Wolniejsze operacje wsadowe lub uaktualnienie do obsługi większej liczby przeglądarek jednocześnie.
📌 Notatka: Jeśli żadna z powyższych metod nie pomoże Ci rozwiązać problemu, skontaktuj się z pomocą techniczną Firecrawl.
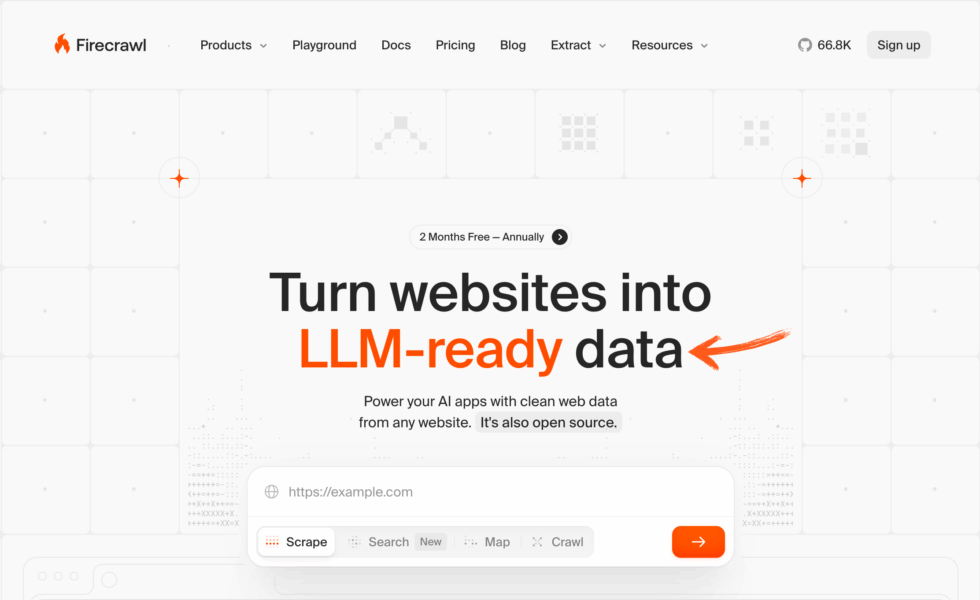
Czym jest Firecrawl?
Firecrawl jest narzędziem do scrapowania stron internetowych opartym na sztucznej inteligencji, które zamienia strony internetowe w czyste, ustrukturyzowane dane.
Można to porównać do robota sieciowego, który przekazuje agentom AI czytelny tekst zamiast chaotycznego, surowego kodu HTML.
Firecrawl został opracowany przez Mendable.ai w celu ograniczenia marnowania tokenów w aplikacjach opartych na sztucznej inteligencji.
Obejrzyj ten krótki przegląd:
Zawiera następujące kluczowe funkcje:
- Zeskrobać: Wyodrębnij dane z pojedynczych stron internetowych w formacie Markdown lub ustrukturyzowanym JSON.
- Pełzać: Przeszukuj całe witryny i podążaj za linkami bez mapy witryny.
- Szukaj: Przeszukaj sieć i zwróć czyste dane z serwisów informacyjnych i recenzji.
- Mapa: Szybkie wyszukiwanie adresów URL, które zamienia jedną domenę w pełną mapę witryny.
- Ekstrakt: Pobierz ustrukturyzowane dane internetowe, korzystając z podpowiedzi w języku naturalnym i schematów Pydantic.
Firecrawl przewyższa tradycyjne scrapowanie stron internetowych, ponieważ obsługuje serwery proxy, limity przepustowości i renderowanie JavaScript.
W przeciwieństwie do tradycyjnych narzędzi, które wymagają Selenium, narzędzie to obsługuje naukowców zajmujących się danymi i programistów za pośrednictwem jednej usługi API.
Aby zapoznać się z pełną recenzją, zobacz naszą Recenzja Firecrawl.
Cennik Firecrawl
Oto, ile kosztuje Firecrawl w 2026 roku:
| Plan | Cena | Najlepsze dla |
|---|---|---|
| Bezpłatny | Bezpłatny | Testowanie funkcji scrape and crawl na kilku stronach |
| Hobby | 16 USD/miesiąc | Samodzielni programiści i małe przepływy danych |
| Standard | 83 USD/miesiąc | Zespoły wykonujące regularne zadania przeszukiwania sieci |
| Wzrost | 333 USD/miesiąc | Badania i monitorowanie rynku o dużej objętości |
Bezpłatny okres próbny: Tak — darmowy plan pozwala na zeskanowanie ograniczonej liczby stron.
Gwarancja zwrotu pieniędzy: Nie ma formalnej gwarancji, ale możesz w każdej chwili obniżyć wersję.
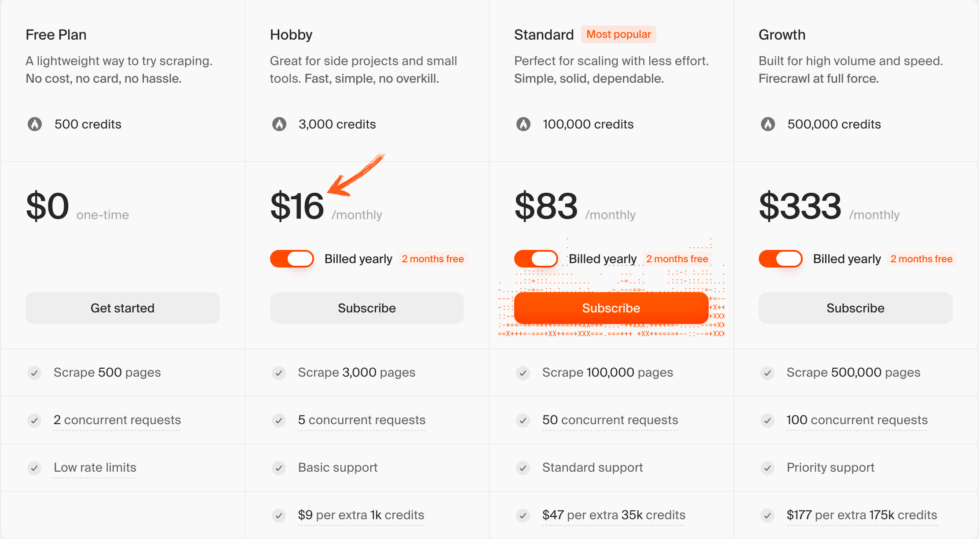
💰 Najlepszy stosunek jakości do ceny: Standard — najlepszy balans kredytów i jednoczesnych przeglądarek dla większości zespołów.
Firecrawl kontra alternatywy
Jak wypada Firecrawl na tle konkurencji? Oto porównanie:
| Narzędzie | Najlepsze dla | Cena | Ocena |
|---|---|---|---|
| Firecrawl | Czyste dane gotowe na sztuczną inteligencję | 16 USD/mies. | ⭐ 3,5 |
| Apify | Wstępnie zbudowani aktorzy | 49 USD/mies. | ⭐ 4,5 |
| Jasne dane | Skala zastępcza | $ Niestandardowe | ⭐ 4.6 |
| Crawl4AI | Otwarte źródło | Bezpłatny | ⭐ 4.4 |
| Scrapy | Kontrolka Pythona | Bezpłatny | ⭐ 4,5 |
| ScrapeGraphAI | Scraping grafów LLM | 20 USD/mies. | ⭐ 4.3 |
Szybkie typy:
- Najlepszy ogółem: Firecrawl — najczystsze dane gotowe do użycia w llm z jednego interfejsu API.
- Najlepszy budżet: Crawl4AI — darmowe i otwarte oprogramowanie dla praktykujących naukowców zajmujących się danymi.
- Najlepsze dla początkujących: Firecrawl — naturalne podpowiedzi językowe ukrywają trudniejsze części.
- Najlepiej w skali proxy: Bright Data — ogromna pula serwerów proxy dla złożonych witryn internetowych.
🎯 Alternatywy dla Firecrawl
Szukasz alternatyw dla Firecrawl? Oto najlepsze opcje:
- 🚀 Apify: Rynek gotowych aktorów do scrapowania stron internetowych, przydatny, gdy potrzebujesz gotowych scraperów w jednym interfejsie API.
- 🏢 Jasne dane: Sieć proxy dla przedsiębiorstw umożliwiająca wykonywanie ogromnych zadań indeksowania i monitorowanie treści na dużą skalę w dynamicznych witrynach internetowych.
- 💰 Crawl4AI: Bezpłatny, open source'owy program do indeksowania, który generuje dane gotowe do llm, idealny do budżetowych przepływów pracy AI i uruchomień lokalnych.
- 🔧 Scrapy: Sprawdzony w praktyce framework Pythona zapewniający programistom pełną kontrolę nad indeksowaniem, analizą składniową i przetwarzaniem danych.
- 🧠 ScrapeGraphAI: Ekstrakcja oparta na grafie i wspomagana sztuczną inteligencją, która mapuje strukturę strony w celu ekstrakcji ustrukturyzowanych danych na podstawie schematów.
Aby zobaczyć pełną listę, zobacz naszą Alternatywy dla Firecrawl przewodnik.
⚔️ Porównanie Firecrawl
Oto jak Firecrawl wypada na tle pozostałych konkurentów:
- Firecrawl kontra Apify: Firecrawl wygrywa pod względem czystego, gotowego do użycia llm wyjścia; Apify wygrywa pod względem swojej biblioteki gotowych programów do scrapowania.
- Firecrawl kontra Bright Data: Bright Data wygrywa pod względem skali proxy; Firecrawl wygrywa pod względem ekstrakcji prostszych, ustrukturyzowanych danych.
- Firecrawl kontra Crawl4AI: Crawl4AI wygrywa pod względem ceny i hostingu; Firecrawl wygrywa pod względem zarządzanych limitów przepustowości i niezawodności.
- Firecrawl kontra Scrapy: Scrapy wygrywa pod względem kontroli niskiego poziomu; Firecrawl wygrywa pod względem szybkości i braku konieczności konfiguracji serwera proxy.
- Firecrawl kontra ScrapeGraphAI: Oba opierają się na sztucznej inteligencji; Firecrawl wygrywa pod względem pokrycia indeksowania, ScrapeGraphAI pod względem logiki graficznej.
Zacznij używać Firecrawl już teraz
Nauczyłeś się korzystać ze wszystkich głównych funkcji Firecrawl:
- ✅ Skrobanie
- ✅ Pełzanie
- ✅ Szukaj
- ✅ Mapa
- ✅ Ekstrakt
Następny krok: Wybierz jedną funkcję i wypróbuj ją teraz.
Większość ludzi zaczyna od Scrape'a.
Zajmie to mniej niż 5 minut.
Często zadawane pytania
Do czego służy Firecrawl?
Firecrawl to narzędzie do scrapowania stron internetowych oparte na sztucznej inteligencji. Zamienia strony internetowe w czyste, gotowe do użycia dane dla agentów AI, systemów rag, badań rynku i monitorowania cen.
Czy można używać Firecrawl za darmo?
Tak. Bezpłatny plan pozwala na zeskanowanie ograniczonej liczby stron za pomocą klucza API, dzięki czemu możesz przetestować zeskanowanie, indeksowanie i ekstrakcję danych przed dokonaniem płatności.
Jak zainstalować Firecrawl?
Uruchom pip install firecrawl-py, następnie ustaw klucz API jako zmienną środowiskową i utwórz instancję Firecrawl, aby rozpocząć pierwsze pojedyncze wywołanie API.
Czym Firecrawl różni się od tradycyjnego scrapowania?
Tradycyjne scrapowanie stron internetowych wymaga Selenium i ręcznej konfiguracji proxy. Firecrawl automatycznie obsługuje renderowanie JavaScript, limity przepustowości i czyszczenie danych za pośrednictwem jednej usługi API.
Czy Firecrawl potrafi wyodrębnić ustrukturyzowane dane?
Tak. Użyj komunikatów w języku naturalnym lub schematu Pydantic do ekstrakcji opartej na schemacie, a Firecrawl zwróci ustrukturyzowany kod JSON zamiast surowego kodu HTML.













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
