
Avvio rapido
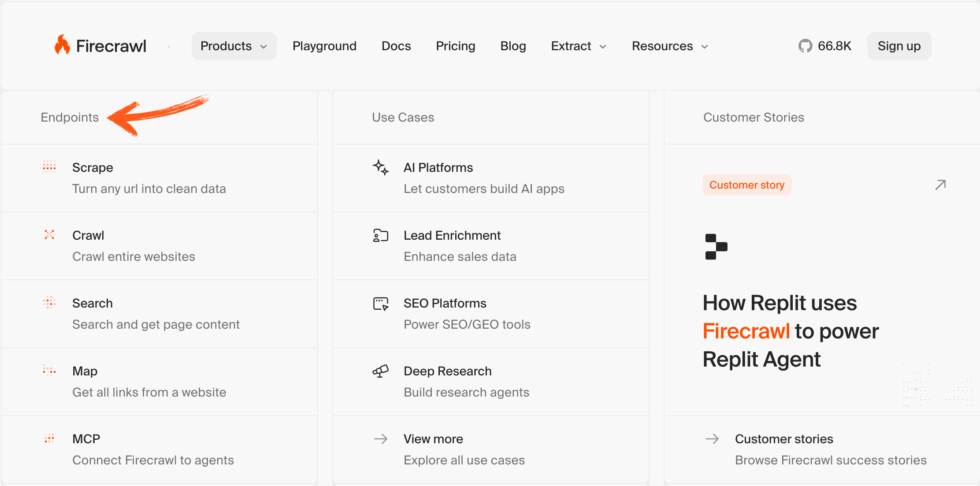
Questa guida illustra tutte le funzionalità di Firecrawl:
- Iniziare — Crea un account Firecrawl e imposta la tua chiave API
- Come usare il raschietto — Estrai i dati pronti per llm da singole pagine web
- Come usare Crawl — Scansiona interi siti web e segui ogni link
- — Trova risposte sul web con l'intelligenza artificiale — Cerca sul web dati in tempo reale
- Come usare la mappa — Run url discovery across individual pages
- Come utilizzare l'estratto — Estrazione di dati strutturati tramite prompt in linguaggio naturale
Tempo necessario: 5 minuti per ogni servizio
In questa guida troverete anche: Consigli professionali | Errori comuni | Risoluzione dei problemi | Prezzi | Alternative
Perché fidarsi di questa guida
Ho utilizzato Firecrawl per oltre un anno e ho testato ogni funzionalità qui descritta.
Questo tutorial su come utilizzare Firecrawl deriva da un'esperienza pratica di web scraping.

Firecrawl è un web crawler basato sull'intelligenza artificiale che trasforma i siti web in dati puliti e pronti per la gestione dei log (LLM).
Ma la maggior parte degli utenti sfrutta solo superficialmente le potenzialità di questo strumento versatile.
Questa guida ti mostra come utilizzare ogni funzionalità principale, passo dopo passo, con l'ausilio di schermate illustrative.
Tutorial di Firecrawl
Questo tutorial completo su Firecrawl ti guiderà attraverso ogni funzionalità, dalla tua prima chiave API alle operazioni batch avanzate che ti trasformeranno in un utente esperto.
Firecrawl
Trasforma qualsiasi sito web in dati puliti e strutturati con una singola API. Firecrawl gestisce il rendering JavaScript, i limiti di frequenza e l'individuazione degli URL, permettendoti di ottenere rapidamente dati pronti per LLM. Inizia con il piano gratuito: non è richiesta alcuna carta di credito.
Getting Started with Firecrawl
Prima di utilizzare qualsiasi funzionalità, completa questa configurazione iniziale.
Ci vogliono circa 3 minuti.
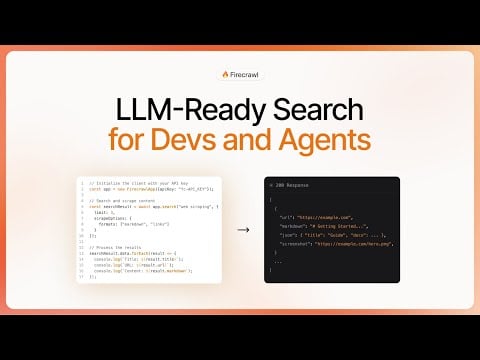
Prima di iniziare, guarda questa breve panoramica:
Ora analizziamo passo passo ciascuna fase.
Passaggio 1: crea il tuo account
Go to the Firecrawl website at https://www.firecrawl.dev.
Fai clic su "Iscriviti" per aprire un account Firecrawl con il piano gratuito.
Inserisci il tuo indirizzo email e crea una password.
✓ Punto di controllo: Controlla il tuo posta in arrivo per ricevere un'e-mail di conferma.
Passaggio 2: Installa e imposta la tua chiave API
Run pip install firecrawl-py to add the api service to your project.
Copia la tua chiave API, quindi salvala come variabile d'ambiente per sicurezza.
Ecco come si presenta la dashboard:
✓ Punto di controllo: Dovresti visualizzare la dashboard principale con i tuoi dati di utilizzo e la chiave API.
Passo 3: Fai la tua prima chiamata
Importa la classe FirecrawlApp e crea un'istanza di Firecrawl con la tua chiave.
Ogni richiesta raggiunge l'endpoint di base all'indirizzo https://api.firecrawl.dev/v2.
✅ Fatto: Sei pronto per estrarre, analizzare, cercare, mappare e raccogliere dati.
Come utilizzare il raschietto Firecrawl
Raschiare Consente di estrarre dati puliti e pronti per llm da un'unica pagina con una singola chiamata API.
La modalità Scrape si concentra su singole pagine ed è ideale per estrarre rapidamente dettagli specifici.
Ecco come usarlo passo dopo passo.
Ora analizziamo ogni passaggio.
Passaggio 1: Ottieni la tua chiave API
Crea un account Firecrawl, quindi copia la tua chiave API dalla dashboard.
Salvala come variabile d'ambiente in modo che la tua chiave API rimanga separata dal codice sorgente.
Passaggio 2: Chiamare l'endpoint di scraping
Pass a single url to the .scrape_url() method on your firecrawl instance.
È possibile richiedere come output il formato Markdown, HTML grezzo o JSON strutturato.
Ecco come si presenta:
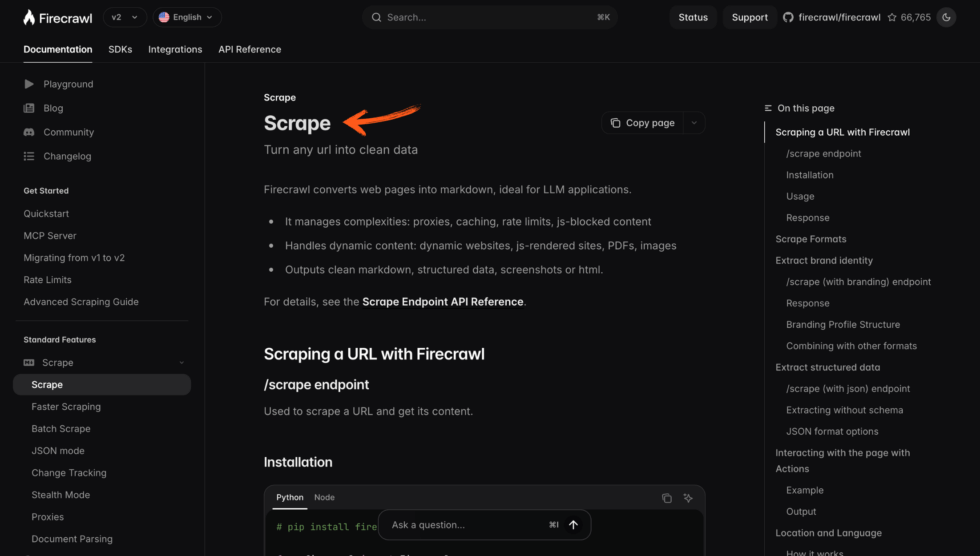
✓ Punto di controllo: Dovresti visualizzare un codice Markdown pulito per la pagina corrente, pronto per le applicazioni di intelligenza artificiale.
Passaggio 3: Leggere l'output pulito
Firecrawl restituisce dati puliti e leggibili testo, privato dei tag HTML superflui.
✅ Risultato: Hai trasformato una delle pagine web in dati web strutturati utilizzando una singola API.
💡 Consiglio da professionista: Imposta il parametro max_age per memorizzare nella cache i risultati ed evitare di eseguire nuovamente lo scraping di una pagina che non è stata modificata.
Come utilizzare Firecrawl Crawler
Strisciare Consente di scansionare interi siti web e seguire automaticamente i link senza bisogno di una mappa del sito.
La modalità di scansione consente di analizzare siti web su più pagine e di raccogliere tutte le pagine raggiungibili.
Ecco come usarlo passo dopo passo.
Ora analizziamo ogni passaggio.
Passaggio 1: puntare a un URL radice
Assegna all'endpoint di scansione un URL iniziale, ad esempio https://example.com.
Firecrawl gestisce la scansione del web attraverso i link e segue le pagine in modo autonomo.
Passaggio 2: Inizia il lavoro di strisciamento
Avvia il processo di indicizzazione e recupera l'ID del processo restituito per monitorarne l'avanzamento.
Utilizza l'ID del job per verificare lo stato e recuperare i dati indicizzati al termine della scansione di ciascuna pagina.
Ecco come si presenta:
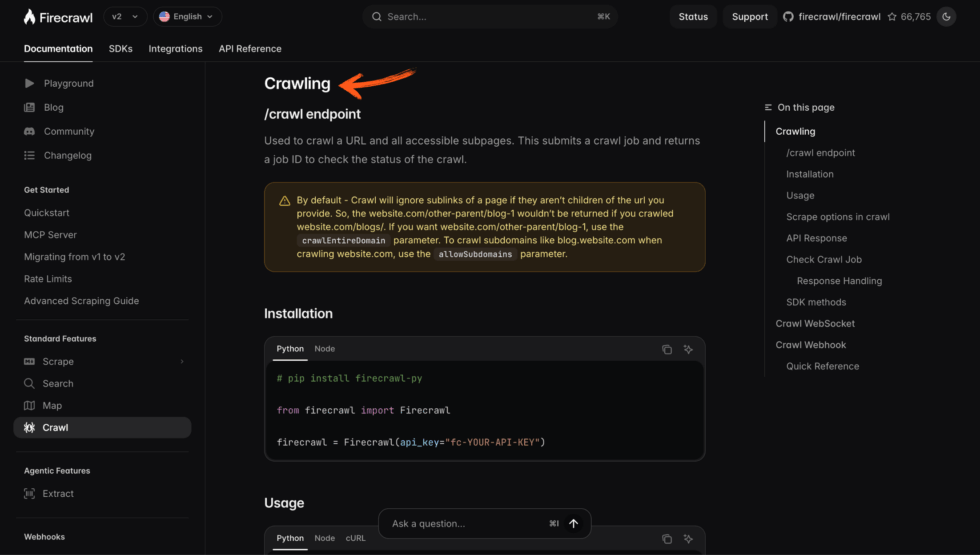
✓ Punto di controllo: Dovresti vedere pagine estratte da tutto il sito che si uniscono a formare i dati web.
Passaggio 3: Esportare i risultati
Raccogli ogni pagina in formato Markdown o JSON strutturato per le tue pipeline di dati.
✅ Risultato: Hai catturato un intero sito, persino siti web complessi con contenuti dinamici.
💡 Consiglio da professionista: Firecrawl utilizza l'elaborazione batch e browser concorrenti, quindi le operazioni di scansione di grandi dimensioni rimangono veloci.
Come utilizzare il motore di ricerca Firecrawl
Ricerca lets you search the web and return clean results you can feed straight into ai agents.
La funzione di ricerca consente di interrogare il web e di recuperare dati in tempo reale sotto forma di testo leggibile.
Ecco come usarlo passo dopo passo.
Ora analizziamo ogni passaggio.
Passaggio 1: Invia una richiesta
Richiama l'endpoint di ricerca con una semplice query in linguaggio naturale.
Firecrawl è in grado di effettuare ricerche sul web, consultando siti di notizie, bacheche di offerte di lavoro e siti di recensioni.
Passaggio 2: Scegliere il formato di output
Richiedi il formato Markdown o JSON strutturato per ciascun risultato.
Ogni risultato viene fornito come dati puliti, non come codice HTML grezzo e rumoroso.
Ecco come si presenta:
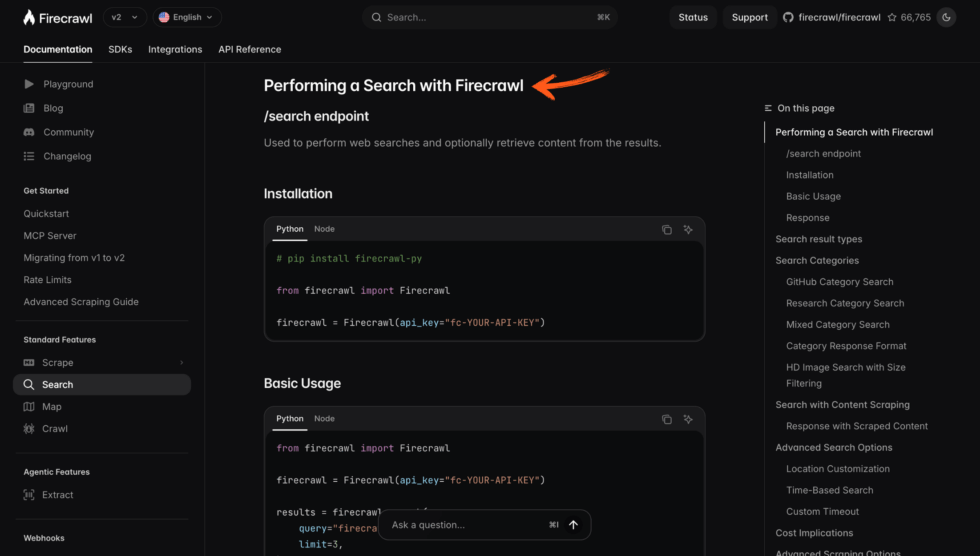
✓ Punto di controllo: Dovresti visualizzare le pagine web classificate come dati web strutturati.
Passaggio 3: collega il flusso alla tua app
Feed the structured data into assistenti IA o flussi di lavoro di intelligenza artificiale.
✅ Risultato: Hai aggiunto contenuti web in tempo reale alle tue applicazioni di intelligenza artificiale con una singola chiamata API.
💡 Consiglio da professionista: Abbina la funzione di ricerca all'estrazione per raccogliere articoli di notizie utili per ricerche di mercato o analisi della concorrenza.
Come utilizzare la mappa avanzata di Firecrawl
Mappa Consente di eseguire la ricerca degli URL e di trasformare un dominio in una mappa completa delle singole pagine.
La modalità mappa recupera rapidamente tutti gli URL di un sito, consentendo una rapida individuazione degli stessi.
Ecco come usarlo passo dopo passo.
Ora analizziamo ogni passaggio.
Passaggio 1: Invia il dominio
Passa un singolo URL radice all'endpoint della mappa.
Firecrawl restituisce tutti i link senza bisogno di una sitemap.
Passaggio 2: Esamina l'elenco degli URL
Prima di estrarre i dati, esaminate le singole pagine restituite.
Salva l'elenco in un file CSV per pianificare l'estrazione dei dati.
Ecco come si presenta:
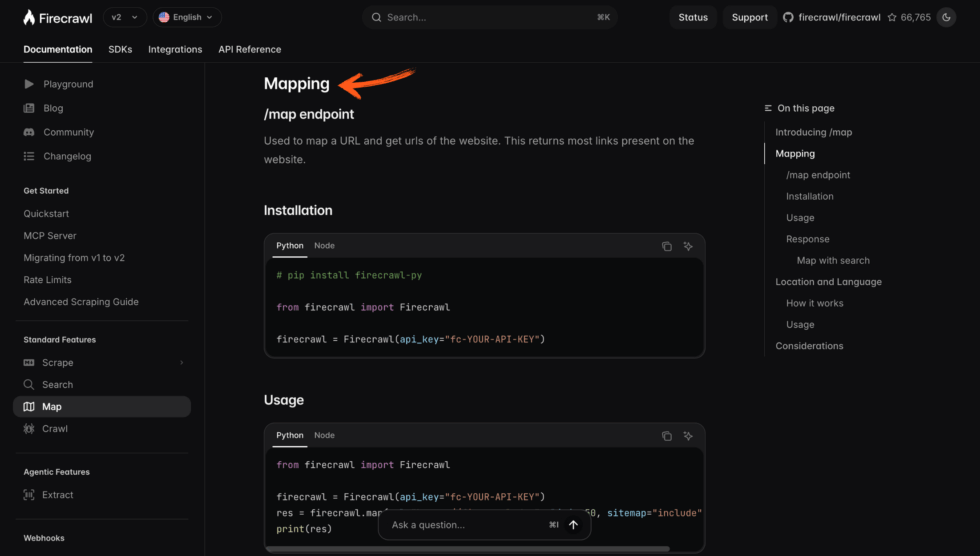
✓ Punto di controllo: Dovresti visualizzare una mappa completa del sito web, accessibile tramite un singolo URL.
Passaggio 3: Selezionare cosa raschiare
Seleziona le pagine che desideri, quindi inviale per l'estrazione o la scansione.
✅ Risultato: Hai mappato l'intero sito, pronto per lo scraping mirato.
💡 Consiglio da professionista: Sui siti web e sulle app dinamiche, è consigliabile visualizzare prima la mappa per evitare di sprecare crediti su pagine non necessarie.
Come utilizzare Firecrawl Extractor
Estrarre Consente di estrarre dati strutturati da qualsiasi pagina utilizzando comandi in linguaggio naturale.
Extract utilizza un sistema di analisi basato sull'intelligenza artificiale per estrarre esattamente i campi che descrivi.
Ecco come usarlo passo dopo passo.
Ora analizziamo ogni passaggio.
Passaggio 1: Definire uno schema
Scrivi un modello Pydantic con: from pydantic import BaseModel.
L'estrazione basata su schema indica a Firecrawl quali campi restituire come JSON strutturato.
Fase 2: Descrivere i dati
Aggiungi prompt in linguaggio naturale per i campi che uno schema non è in grado di gestire.
Ecco come estrarre dati dalle pagine web senza scrivere regole di parsing.
Ecco come si presenta:
✓ Punto di controllo: Dovresti visualizzare dati strutturati e ordinati anziché tag HTML disordinati.
Passaggio 3: Ricezione di JSON strutturato
Firecrawl restituisce un file JSON pulito e strutturato, pronto per essere utilizzato come dato di addestramento.
✅ Risultato: Hai sostituito i fragili scraper con una singola chiamata di estrazione e una minore pulizia dei dati.
💡 Consiglio da professionista: Utilizza only_main_content, include_tags ed exclude_tags per mantenere i dati web estratti focalizzati.
Suggerimenti e scorciatoie di Firecrawl Pro
Dopo aver testato Firecrawl per oltre un anno, ecco i miei migliori consigli per un'estrazione dati più efficace.
Scorciatoie da tastiera
| Azione | Scorciatoia |
|---|---|
| Corri e graffia nel parco giochi | Ctrl + Invio |
| Copia la chiave API | Ctrl + C |
| Apri i documenti | Ctrl + K |
| Cambia formato di output | Tab |
Funzionalità nascoste che la maggior parte delle persone non nota
- caching max_age: Riutilizza i dati raccolti di recente per un'estrazione dati ripetuta più rapida ed economica.
- Azioni del browser: Clicca, scorri e digita per accedere ai contenuti nascosti dietro il rendering JavaScript.
- Async batching: Elabora migliaia di URL in modalità batch senza bloccare le tue applicazioni web.
Errori comuni da evitare durante le escursioni in fuoristrada.
Errore n. 1: Inserire la chiave API direttamente nel codice.
❌ Sbagliato: Pasting your api key directly into shared code or a public repo.
✅ A destra: Carica la chiave da una variabile d'ambiente in modo che rimanga privata.
Errore n. 2: gattonare prima di mappare
❌ Sbagliato: Scansionare alla cieca interi siti web e sprecare crediti su pagine spazzatura.
✅ A destra: Esegui prima la ricerca degli URL con la mappa, poi analizza solo le pagine di cui hai bisogno.
Errore n. 3: Analizzare manualmente il codice HTML grezzo
❌ Sbagliato: Scrivere regole rigide per pulire l'HTML grezzo e rimuovere manualmente i tag HTML.
✅ A destra: Use schema based extraction to get clean structured json directly.
Risoluzione dei problemi di Firecrawl
Problema: 401 errori di accesso non autorizzato
Causa: La tua chiave API non è presente o non è stata caricata dalla variabile d'ambiente.
Aggiustare: Riesporta la chiave, quindi ricrea l'istanza di Firecrawl e riprova.
Problema: errori di timeout su siti web complessi
Causa: Il rendering pesante di JavaScript o i contenuti dinamici richiedono più tempo per essere caricati.
Aggiustare: Aggiungi un'azione di attesa in modo che la pagina corrente termini il caricamento prima dell'acquisizione.
Problema: Raggiungimento dei limiti di frequenza
Causa: Troppe richieste simultanee con il piano gratuito o con un piano inferiore.
Aggiustare: Operazioni batch lente o aggiornamento per supportare un maggior numero di browser simultanei.
📌 Nota: Se nessuna di queste soluzioni risolve il problema, contatta l'assistenza di Firecrawl.
Cos'è Firecrawl?
Firecrawl è uno strumento di web scraping basato sull'intelligenza artificiale che trasforma i siti web in dati puliti e strutturati.
Pensatelo come un web crawler che fornisce agli agenti di intelligenza artificiale un testo leggibile anziché un HTML grezzo e disordinato.
Firecrawl è stato sviluppato da Mendable.ai per ridurre lo spreco di token nelle applicazioni di intelligenza artificiale.
Guarda questa breve panoramica:
Include le seguenti caratteristiche principali:
- Raschiare: Estrai dati da singole pagine web in formato Markdown o JSON strutturato.
- Strisciare: Esplora interi siti web e segui i link senza una mappa del sito.
- Ricerca: Effettua una ricerca sul web e restituisci dati puliti da siti di notizie e siti di recensioni.
- Mappa: Fast url discovery that turns one domain into a full sitemap.
- Estrarre: Pull structured web data using natural language prompts and Pydantic schemas.
Firecrawl supera i metodi tradizionali di web scraping gestendo per te proxy, limiti di frequenza e rendering JavaScript.
A differenza degli strumenti tradizionali che richiedono Selenium, questo prodotto si rivolge a data scientist e sviluppatori tramite un unico servizio API.
Per una recensione completa, consulta la nostra Recensione di Firecrawl.
Prezzi per il percorso a piedi
Ecco quanto costerà Firecrawl nel 2026:
| Piano | Prezzo | Ideale per |
|---|---|---|
| Gratuito | Gratuito | Test di scraping e crawling su alcune pagine |
| Hobby | $ 16/mese | Sviluppatori singoli e piccole pipeline di dati |
| Standard | $83/mese | Team che eseguono regolarmente attività di web crawling |
| Crescita | $ 333/mese | Ricerche e monitoraggio di mercato ad alto volume |
Prova gratuita: Sì, il piano gratuito consente di estrarre dati da un numero limitato di pagine.
Garanzia di rimborso: Non c'è una garanzia formale, ma puoi effettuare il downgrade in qualsiasi momento.
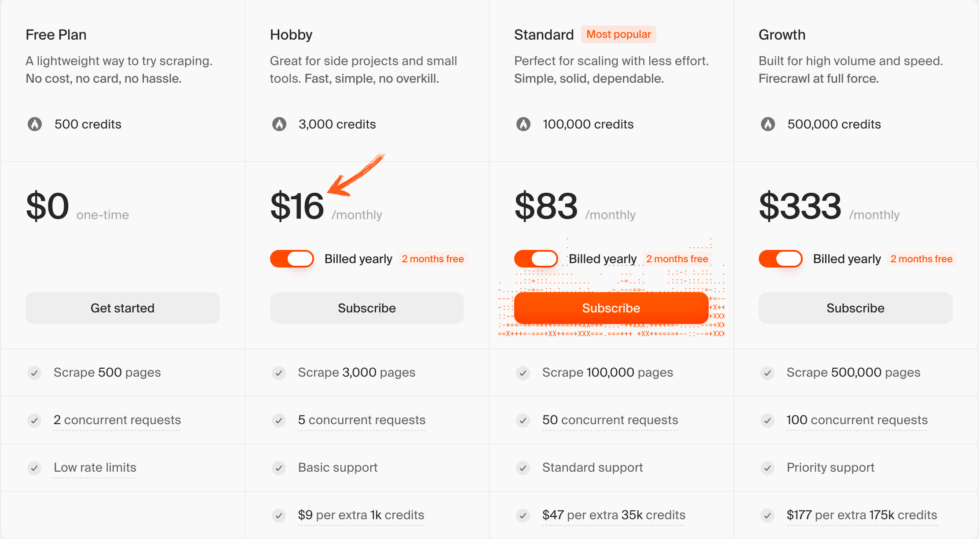
💰 Miglior rapporto qualità-prezzo: Standard: il miglior equilibrio tra crediti e browser simultanei per la maggior parte dei team.
Firecrawl contro alternative
Come si posiziona Firecrawl rispetto alla concorrenza? Ecco il panorama competitivo:
| Attrezzo | Ideale per | Prezzo | Valutazione |
|---|---|---|---|
| Firecrawl | dati puliti pronti per l'IA | 16 dollari al mese | ⭐ 3,5 |
| Apify | Attori predefiniti | $49/mese | ⭐ 4,5 |
| Dati brillanti | scala proxy | $ Custom | ⭐ 4.6 |
| Crawl4AI | Codice sorgente aperto | Gratuito | ⭐ 4.4 |
| Scrapy | Controllo Python | Gratuito | ⭐ 4,5 |
| ScrapeGraphAI | Estrazione dati dal grafico LLM | $20/mese | ⭐ 4.3 |
Scelte rapide:
- Il migliore in assoluto: Firecrawl: dati LLM puliti e pronti all'uso, ottenuti da una singola API.
- Miglior budget: Crawl4AI: software gratuito e open source per data scientist che desiderano cimentarsi in attività pratiche.
- Ideale per principianti: Firecrawl: le istruzioni in linguaggio naturale nascondono le parti più difficili.
- Ideale per la scalabilità proxy: Bright Data: un vasto pool di proxy per siti web complessi.
🎯 Alternative a Firecrawl
Cerchi alternative a Firecrawl? Ecco le migliori opzioni:
- 🚀 Apify: Mercato di attori predefiniti per il web scraping, ideale quando si desiderano scraper già pronti per una singola API.
- 🏢 Dati brillanti: Rete proxy aziendale per operazioni di crawling di grandi dimensioni e monitoraggio dei contenuti su larga scala su siti web dinamici.
- 💰 Crawl4AI: Crawler gratuito e open source che produce dati pronti per llm, ideale per flussi di lavoro di intelligenza artificiale a basso costo ed esecuzioni locali.
- 🔧 Scarso: Framework Python collaudato che offre agli sviluppatori il pieno controllo su crawling, parsing e pipeline di dati.
- 🧠 ScrapeGraphAI: Estrazione basata su grafi e potenziata dall'intelligenza artificiale che mappa la struttura della pagina per l'estrazione di dati strutturati basata su schema.
Per l'elenco completo, consultare il nostro Alternative a Firecrawl guida.
⚔️ Confronto tra Firecrawl
Ecco come Firecrawl si confronta con ciascun concorrente:
- Firecrawl contro Apify: Firecrawl vince grazie a un output pulito e pronto per llm; Apify vince grazie alla sua libreria di scraper predefiniti.
- Firecrawl contro Bright Data: Bright Data vince su larga scala con i proxy; Firecrawl vince nell'estrazione di dati strutturati più semplici.
- Firecrawl contro Crawl4AI: Crawl4AI vince in termini di prezzo e self-hosting; Firecrawl vince in termini di limiti di velocità gestiti e affidabilità.
- Firecrawl contro Scrapy: Scrapy vince grazie al controllo a basso livello; Firecrawl vince grazie alla velocità e all'assenza di configurazione proxy.
- Firecrawl contro ScrapeGraphAI: Entrambi sono basati sull'intelligenza artificiale; Firecrawl eccelle nella copertura di scansione, ScrapeGraphAI nella logica dei grafi.
Inizia subito a usare Firecrawl
Hai imparato a utilizzare tutte le principali funzionalità di Firecrawl:
- ✅ Raschiare
- ✅ Strisciare
- ✅ API di supporto
- ✅ Map
- ✅ Estratto
Passo successivo: Scegli una funzionalità e provala subito.
La maggior parte delle persone inizia con Scrape.
Ci vogliono meno di 5 minuti.
Domande frequenti
A cosa serve Firecrawl?
Firecrawl è uno strumento di web scraping basato sull'intelligenza artificiale. Trasforma le pagine web in dati puliti e pronti per l'analisi LLM, utilizzabili da agenti di intelligenza artificiale, sistemi RAG, ricerche di mercato e monitoraggio dei prezzi.
È possibile utilizzare Firecrawl gratuitamente?
Sì. Il piano gratuito ti permette di effettuare lo scraping di un numero limitato di pagine con la tua chiave API, così puoi testare lo scraping, la scansione e l'estrazione dei dati prima di pagare.
Come si installa Firecrawl?
Esegui il comando `pip install firecrawl-py`, quindi imposta la tua chiave API come variabile d'ambiente e crea un'istanza di firecrawl per avviare la tua prima singola chiamata API.
In che modo Firecrawl si differenzia dalla tradizionale raschiatura?
Il web scraping tradizionale richiede Selenium e la configurazione manuale di un proxy. Firecrawl gestisce automaticamente il rendering JavaScript, i limiti di frequenza e la pulizia dei dati tramite un unico servizio API.
Firecrawl è in grado di estrarre dati strutturati?
Sì. Utilizza prompt in linguaggio naturale o uno schema Pydantic per l'estrazione basata su schema e Firecrawl restituisce JSON strutturato anziché HTML grezzo.













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
