
Início rápido
Este guia abrange todas as funcionalidades do Zyte:
- Começando — Crie sua conta e conclua a configuração inicial.
- Como usar a extração de dados por IA — Extraia dados estruturados de qualquer página da web sem escrever código personalizado.
- Como usar a extração de dados de comércio eletrônico — Coletar dados de produtos de lojas online em grande escala
- Como usar dados para um agente de IA — Fornecer conjuntos de dados limpos para modelos de IA e cientistas de dados
- Como usar a API do Zyte — Adicione web scraping ao seu código através de um ponto central
- Como usar o Extract News & Article Data — Extrair textos completos de artigos de notícias e posts de blogs.
- Como usar dados de extração de vagas de emprego — Reunir anúncios de vagas com informações sobre salário, cargo e empresa.
- Como usar a extração de dados imobiliários — Extrair anúncios de imóveis com detalhes de preço e localização
- Como usar o extrator de dados de mídias sociais — Coletar publicações públicas em redes sociais e dados de perfil
- Como usar hospedagem em nuvem escalável — Execute tarefas de coleta de dados em infraestrutura de nuvem com escalonamento automático
Tempo necessário: 5 minutos por filme
Neste guia também: Dicas profissionais | Erros comuns | Solução de problemas | Preços | Alternativas
Por que confiar neste guia?
Eu uso o Zyte há mais de seis meses e testei todos os recursos abordados aqui. Este tutorial é baseado em experiência prática real — não em propaganda enganosa ou capturas de tela do fornecedor.

Zyte é um dos mais poderosos ferramentas de extração de dados da web Disponível hoje.
Mas a maioria dos usuários apenas arranha a superfície do que ele pode fazer.
Este guia mostra como usar todas as principais funcionalidades.
Passo a passo, com capturas de tela e dicas profissionais.
Tutorial Zyte
Este tutorial completo do Zyte orienta você passo a passo em todas as funcionalidades, desde a configuração inicial até dicas avançadas que farão de você um usuário experiente.
Zyte
Transforme qualquer site em algo estruturado. dados Em minutos. O Zyte cuida da proteção contra banimentos, da rotação de proxies e da renderização do navegador para que os desenvolvedores possam se concentrar em encontrar os dados certos. Comece seu teste gratuito hoje mesmo.
Primeiros passos com o Zyte
Antes de usar qualquer recurso, conclua esta configuração única.
Leva cerca de 3 minutos.
Passo 1: Crie sua conta
Acesse o site da Zyte e clique em "Cadastrar-se".
Insira seu e-mail e crie uma senha para fazer login.
✓ Ponto de verificação: Verifique o seu caixa de entrada para um e-mail de confirmação.
Etapa 2: Acesse o Painel de Controle
Zyte é uma plataforma online — não é necessário fazer download.
Faça login com sua nova conta e abra o painel de controle.
Eis como o painel de controle se parece:
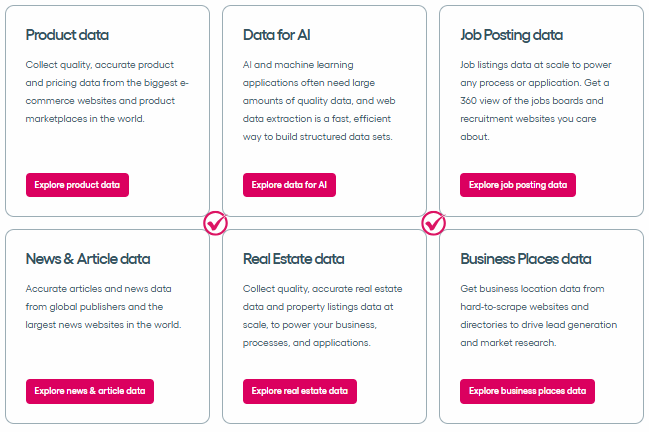
✓ Ponto de verificação: Você deverá ver o painel principal com várias ferramentas listadas.
Etapa 3: Obtenha sua chave de API
Acesse as configurações da sua conta e copie sua chave de API.
Por exemplo, você pode colar essa chave em seu script Python ou em qualquer cliente HTTP.
✅ Concluído: Você está pronto para usar qualquer recurso abaixo.
Como usar o Zyte AI para extração de dados
Extração de dados por IA Permite extrair dados de qualquer site de destino usando análise com inteligência artificial que lida com a complexidade automaticamente.
Veja como usá-lo passo a passo.
Passo 1: Abra a ferramenta de extração de dados por IA.
Faça login no seu painel de controle do Zyte e selecione Extração de Dados por IA.
O extrator de dados com IA lê o conteúdo HTML e o transforma em dados estruturados.
Passo 2: Insira o URL de destino
Cole o URL da página que você deseja extrair dados.
Eis como isso se parece:
✓ Ponto de verificação: Você deverá ver uma prévia dos campos extraídos em formato JSON.
Etapa 3: Revisar e baixar os resultados
Verifique a resposta JSON extraída e exporte o arquivo.
✅ Resultado: Você extraiu com precisão os dados do site alvo e agora pode desenvolver qualquer projeto de web scraping.
💡 Dica profissional: Comece com uma única página para testar antes de expandir para todo o site.
Como usar a extração de dados de e-commerce da Zyte
Extração de dados de comércio eletrônico Permite coletar dados de produtos de sites de comércio eletrônico, incluindo preço, título e detalhes da categoria.
Veja como usá-lo passo a passo.
Passo 1: Selecione Extração de Comércio Eletrônico
Abra o painel de controle e selecione a ferramenta de extração de dados de comércio eletrônico.
Esta ferramenta foi desenvolvida para lidar com páginas de produtos dos principais sites de compras.
Etapa 2: Configurar os campos do produto
Selecione a informação específica que você precisa — preço, título ou categoria.
Eis como isso se parece:
✓ Ponto de verificação: Você deverá ver a lista de produtos com colunas para preço e título.
Etapa 3: Executar e Exportar
Clique em "Extrair" para iniciar a tarefa e baixar os resultados em formato JSON ou CSV.
✅ Resultado: Agora você possui dados estruturados de produtos dos seus sites de e-commerce alvo.
💡 Dica profissional: Utilize parâmetros de geolocalização em suas solicitações para comparar preços específicos da região.
Como usar o agente de IA Zyte
Dados para Agente de IA Permite que você forneça dados limpos da web diretamente para modelos de IA e cientistas de dados para treinamento ou análise.
Veja como usá-lo passo a passo.
Etapa 1: Escolha um pipeline de dados
Selecione a opção Dados para Agente de IA no menu principal.
Isso conecta a saída da sua API de web scraping a fluxos de trabalho prontos para IA.
Etapa 2: Defina o escopo dos seus dados
Defina o escopo dos dados dos sites que você precisa coletar.
Eis como isso se parece:
✓ Ponto de verificação: Seu pipeline mostra um status de conectado com fluxo de dados.
Etapa 3: Exporte para sua ferramenta de IA
Envie os dados estruturados gerados para a sua plataforma de IA preferida.
✅ Resultado: Você está inserindo dados da web diretamente em seus fluxos de trabalho de IA.
💡 Dica profissional: Agende tarefas de extração recorrentes para que seus modelos de IA sejam sempre treinados com dados atualizados.
Como usar a API do Zyte
API Zyte Permite integrar a extração de dados da web em seu próprio código usando um único ponto de entrada de API com proteção anti-banimento.
Veja como usá-lo passo a passo.
Passo 1: Obtenha sua chave de API
Cadastre-se ou faça login e, em seguida, copie sua chave de API da Zyte no painel de controle.
Essa chave é o ponto de entrada para todas as solicitações de API que você fizer.
Etapa 2: Envie sua primeira solicitação
Utilize Python ou qualquer biblioteca HTTP para enviar uma solicitação ao endpoint da API.
Eis como isso se parece:
✓ Ponto de verificação: Seu script retorna um status 200 com o HTML ou JSON da página.
Etapa 3: Analisar a resposta
A API retorna conteúdo HTML ou JSON estruturado, dependendo das suas configurações — verifique cada objeto de resposta em busca de erros.
✅ Resultado: Agora você pode extrair dados de sites programaticamente com seu próprio código.
💡 Dica profissional: Combine a API Zyte com o framework Scrapy e as bibliotecas scrapy-zyte-api para rastreamento em larga escala.
Como usar o extrato de Zyte: notícias e dados de artigos
Extrair dados de notícias e artigos Permite extrair artigos de notícias e conteúdo de blogs automaticamente. texto e extração de dados.
Veja como usá-lo passo a passo.
Passo 1: Abra o Extrator de Notícias
Acesse a opção "Extrair dados de notícias e artigos" no menu.
Esta ferramenta foi otimizada para analisar artigos de notícias de sites de mídia.
Etapa 2: Adicionar URLs de origem
Cole os URLs das páginas de notícias ou feeds que você deseja extrair.
Eis como isso se parece:
✓ Ponto de verificação: Nos resultados, você verá os títulos dos artigos, as datas e as prévias do texto.
Etapa 3: Baixar os dados do artigo
Execute a extração e exporte os resultados com título, data e texto completo.
✅ Resultado: Você tem artigos de notícias estruturados, prontos para análise ou arquivamento.
💡 Dica profissional: Use filtros de categoria para refinar os resultados ao pesquisar em grandes sites de notícias.
Como usar os dados de extração de tarefas do Zyte
Dados de extração de empregos Permite coletar anúncios de vagas de emprego de sites de carreira com campos estruturados, como título, empresa e salário.
Veja como usá-lo passo a passo.
Passo 1: Selecione a tarefa de extração de dados
Abra a função "Extração de Dados de Tarefas" no painel de ferramentas.
Este programa extrai dados automaticamente dos layouts mais comuns de sites de vagas de emprego.
Etapa 2: Defina seus critérios de pesquisa
Insira o cargo, a localização ou a categoria que deseja segmentar.
Eis como isso se parece:
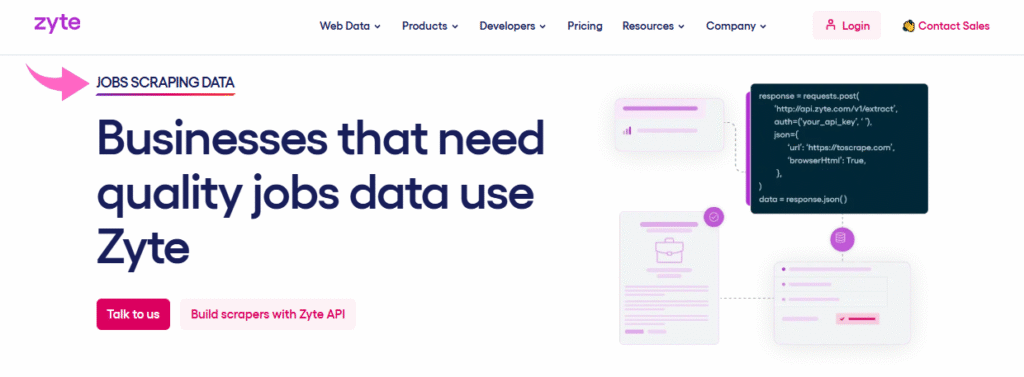
✓ Ponto de verificação: Aparece uma tabela com a lista de vagas de emprego, contendo todos os campos solicitados.
Etapa 3: Exportar anúncios de emprego
Faça o download dos dados como um arquivo CSV ou JSON para análise.
✅ Resultado: Você possui dados limpos de anúncios de vagas para pesquisa de mercado ou monitoramento.
💡 Dica profissional: Agende verificações semanais para monitorar novas vagas e tendências salariais ao longo do tempo.
Como usar a ferramenta de extração de dados imobiliários Zyte
Imobiliária Extração de dados Permite extrair anúncios de imóveis de sites imobiliários com campos de preço, localização e detalhes.
Veja como usá-lo passo a passo.
Etapa 1: Extração de Imóveis Abertos
Selecione "Extração de Dados Imobiliários" no painel de controle.
Este módulo analisa páginas de anúncios de imóveis nos principais sites imobiliários.
Etapa 2: Configurar campos de propriedade
Selecione os dados que você precisa — preço, endereço ou metragem quadrada.
Eis como isso se parece:
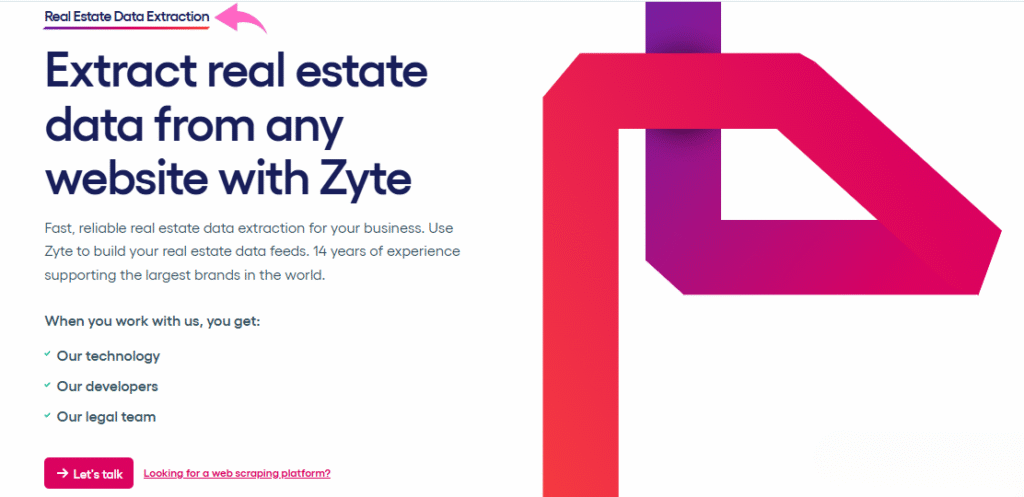
✓ Ponto de verificação: Os anúncios de imóveis são exibidos com colunas de preço e localização.
Etapa 3: Exportar Listagens
Faça o download dos resultados no formato de sua preferência para análise.
✅ Resultado: Você estruturou dados imobiliários para análise de investimentos.
💡 Dica profissional: Utilize proxies com segmentação geográfica para acessar anúncios de imóveis restritos a determinadas regiões.
Como usar o extrator de dados de mídias sociais Zyte
Extrator de dados de mídias sociais Permite coletar dados públicos de mídias sociais, incluindo publicações, perfis e métricas de engajamento.
Veja como usá-lo passo a passo.
Passo 1: Escolha o Social Media Scraper
Selecione a ferramenta Social Media Scraper no menu.
Esta função gerencia perfis públicos e páginas de postagens em diversas plataformas.
Etapa 2: Insira os URLs do perfil ou da hashtag
Cole os URLs das páginas públicas ou tópicos que você deseja extrair.
Eis como isso se parece:
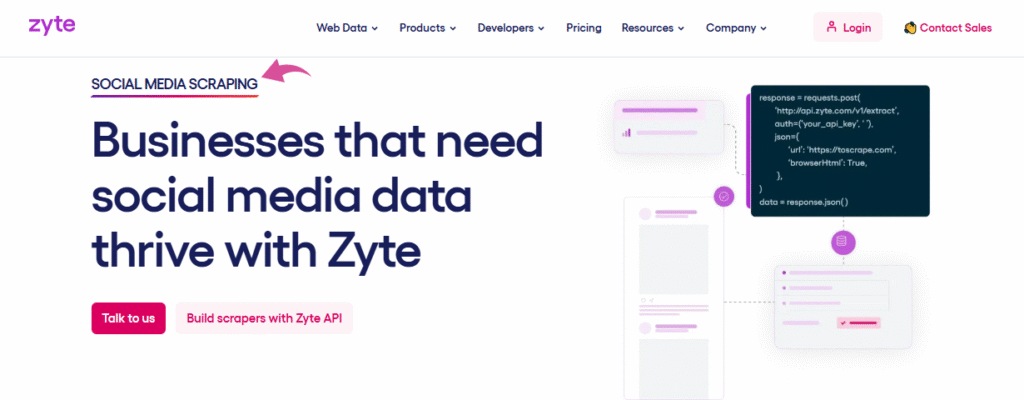
✓ Ponto de verificação: As postagens em redes sociais aparecem com colunas de texto e engajamento.
Etapa 3: Revisar e baixar os dados
Verifique o resultado e exporte como um arquivo JSON ou CSV.
✅ Resultado: Agora você tem dados sociais públicos prontos para análise de tendências ou reportagem.
💡 Dica profissional: Respeite os limites de taxa e os termos do site para que seu scraper funcione sem problemas.
Como usar a hospedagem em nuvem escalável da Zyte
Hospedagem em nuvem escalável Permite executar suas tarefas de web scraping em infraestrutura de nuvem que se adapta às suas necessidades de dados da web.
Veja como usá-lo passo a passo.
Passo 1: Acesse as configurações de hospedagem em nuvem.
Acesse a seção Hospedagem em Nuvem Escalável na sua conta.
É aqui que você gerencia os recursos do servidor para suas tarefas de extração.
Etapa 2: Implante sua tarefa de extração de dados.
Faça o upload do seu spider ou script e selecione o nível de recurso desejado.
Eis como isso se parece:
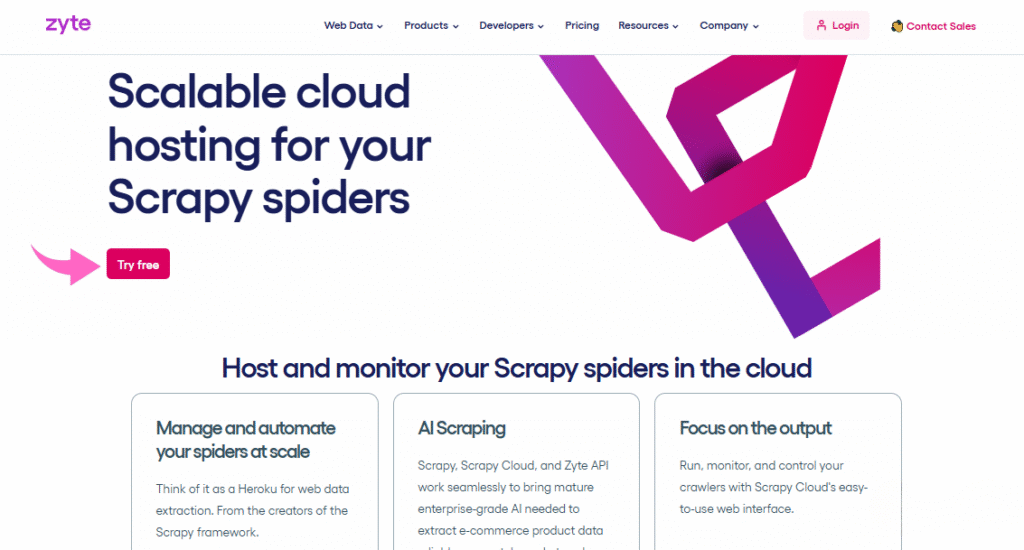
✓ Ponto de verificação: Seu painel de tarefas exibe os spiders ativos com estatísticas de uso de recursos.
Etapa 3: Monitorar e dimensionar
Acompanhe o progresso do trabalho e ajuste os recursos conforme suas necessidades de dados aumentam.
✅ Resultado: Suas atividades de web scraping são executadas em infraestrutura de nuvem gerenciada, em qualquer escala.
💡 Dica profissional: Comece com um plano menor e aumente a escala somente depois de entender o volume real de solicitações.
Dicas e Atalhos do Zyte Pro
Após testar o Zyte por mais de seis meses, aqui estão minhas melhores dicas.
Atalhos de teclado
| Ação | Atalho |
|---|---|
| Aranha corre | Ctrl + R |
| Interrompa o trabalho ativo | Ctrl + Shift + S |
| Abra o console do Zyte IDE | Ctrl + ` |
| Pesquisar arquivos do projeto | Ctrl + P |
Características ocultas que a maioria das pessoas não percebe
- Zyte IDE: Escreva, teste e depure scripts de navegador diretamente em um ambiente baseado em navegador, sem precisar alternar para um editor local.
- Extração automática: O extrator com inteligência artificial retorna dados JSON estruturados sem a necessidade de escrever código de análise sintática e se adapta quando os sites mudam de layout.
- Converse conosco pelo ZyteBot: Use o chat integrado do aplicativo com o ZyteBot para obter respostas instantâneas sobre configuração, erros ou dúvidas sobre boas práticas.
Erros comuns a evitar no Zyte
Erro nº 1: Ignorar as configurações de rotação do proxy
❌ Errado: O envio de todas as solicitações a partir de um único endereço IP aciona o bloqueio do IP no site alvo.
✅ Direita: Ative os proxies rotativos inteligentes para que o Zyte alterne automaticamente os IPs e evite a detecção.
Erro nº 2: Extrair dados sem verificar o arquivo robots.txt
❌ Errado: A indexação de páginas que o proprietário do site bloqueou é demorada para corrigir e pode causar problemas legais.
✅ Direita: Sempre revise as diretrizes do robots.txt e identifique os caminhos restritos antes de começar a praticar web scraping responsável.
Erro nº 3: Não tratar erros no seu script
❌ Errado: Permitir que seu scraper falhe silenciosamente quando uma página da web retornar uma resposta 403 ou um tempo limite excedido.
✅ Direita: Adicione tratamento de erros ao seu código para registrar erros HTTP e tentar novamente as solicitações com falha automaticamente.
Solução de problemas do Zyte
Problema: As solicitações retornam conteúdo HTML vazio.
Causa: O site em questão utiliza JavaScript para carregar conteúdo dinamicamente.
Consertar: Habilite a renderização do navegador em sua solicitação à API da Zyte para que a página carregue completamente antes da extração.
Problema: O scraper fica bloqueado após algumas requisições.
Causa: O site detecta solicitações repetidas do mesmo endereço IP ou agente de usuário.
Consertar: Ative a rotação inteligente de proxies e adicione cabeçalhos personalizados às suas solicitações para evitar a detecção por robôs.
Problema: Os dados extraídos contêm campos ausentes ou corrompidos.
Causa: O site de destino alterou seu layout, o que quebrou seu analisador sintático.
Consertar: Mude para a Extração Automática para que a IA se adapte às mudanças de layout sem que você precise atualizar seu código manualmente.
📌 Observação: Se nenhuma dessas soluções resolver o seu problema, entre em contato com o suporte da Zyte ou utilize o chat disponível 24 horas por dia, 7 dias por semana, para obter ajuda.
O que é Zyte?
Zyte é uma plataforma de web scraping que ajuda desenvolvedores e cientistas de dados a extrair dados de sites sem precisar lidar manualmente com bloqueios de IP, proxies ou medidas anti-bot.
Considere-o como um ponto central para todas as suas necessidades de dados da web — uma plataforma com múltiplas ferramentas para cada tarefa de extração de dados.
Veja esta breve visão geral:
Inclui estas características principais:
- Extração de dados por IA: Utilize IA para extrair dados estruturados de qualquer página da web sem a necessidade de código de análise personalizado.
- Extração de dados de comércio eletrônico: Coletar dados de produtos de lojas online em grande escala.
- Dados para o agente de IA: Forneça conjuntos de dados limpos e estruturados diretamente aos modelos de IA.
- API Zyte: Integre a extração de dados da web ao seu próprio código com proteção anti-banimento integrada.
- Extrair dados de notícias e artigos: Obtenha artigos de notícias com texto completo e metadados.
- Extração de dados de vagas de emprego: Reúna anúncios de vagas estruturados em sites de emprego.
- Extração de dados imobiliários: Extraia anúncios de imóveis com campos de preço e localização.
- Extrator de dados de mídias sociais: Coletar publicações públicas e dados de perfil para análise.
- Hospedagem em nuvem escalável: Execute tarefas de coleta de dados em infraestrutura com escalonamento automático.
Para uma análise completa, consulte nosso artigo. Análise do Zyte.
O Zyte é ideal para qualquer equipe que precise coletar páginas da web em grande escala sem gerenciar proxies ou escrever analisadores personalizados do zero.
Preços do Zyte
Eis o preço do Zyte em 2026:
A Zyte utiliza um modelo de preços de pagamento por solicitação, baseado em níveis de complexidade do site.
Resposta HTTP extraída — Preço por 1.000 solicitações
| Nível do site | Pagamento por uso | Plano de $100 | Plano de $500 |
|---|---|---|---|
| Nível 1 | $0.40 | $0.30 | $0.19 |
| Nível 2 | $0.50 | $0.37 | $0.24 |
| Nível 3 | $0.70 | $0.52 | $0.33 |
| Nível 4 | $0.97 | $0.72 | $0.46 |
| Nível 5 | $1.53 | $1.15 | $0.73 |
Solicitações extraídas do navegador — Preço por 1.000 solicitações
| Nível do site | Pagamento por uso | Plano de $100 | Plano de $500 |
|---|---|---|---|
| Nível 1 | $1.80 | $1.35 | $0.85 |
| Nível 2 | $2.80 | $2.10 | $1.33 |
| Nível 3 | $4.80 | $3.59 | $2.27 |
| Nível 4 | $8.79 | $6.59 | $4.17 |
| Nível 5 | $16.78 | $12.58 | $7.96 |
Teste grátis: Sim — novas contas recebem créditos gratuitos para testar a plataforma.
Garantia de reembolso: Não — os créditos não são reembolsáveis após serem utilizados.
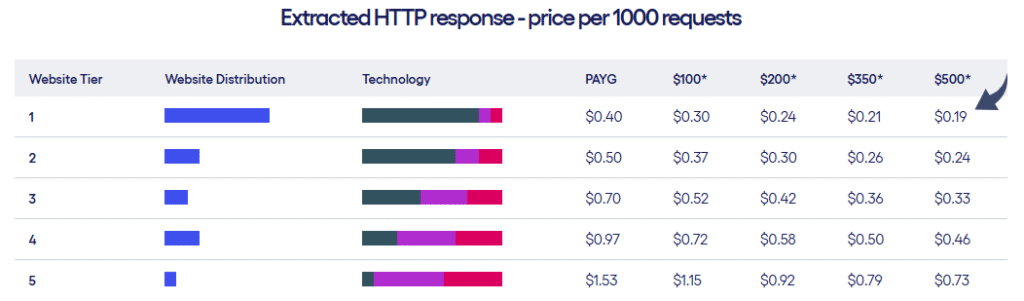
💰 Melhor custo-benefício: Plano de US$ 500 no Nível 1 — você obtém o menor preço por solicitação, a US$ 0,19 para HTTP e US$ 0,85 para extração pelo navegador.
Zyte vs. Alternativas
Como a Zyte se compara? Aqui está o panorama competitivo:
| Ferramenta | Ideal para | Preço | Avaliação |
|---|---|---|---|
| Zyte | Web scraping full-stack | $0,19+/1K exigido | ⭐ 4,5 |
| Apify | atores de raspagem pré-construídos | US$ 49/mês | ⭐ 4,6 |
| ScrapeGraphAI | Extração de grafos orientada por IA | Código aberto/gratuito | ⭐ 4,3 |
| Dados brilhantes | Redes proxy empresariais | Mais de US$ 500 por mês | ⭐ 4,5 |
| Navegar na IA | Web scraping sem código | US$ 49/mês | ⭐ 4,4 |
| ScrapingBee | Extração simples de dados de API | US$ 49/mês | ⭐ 4,4 |
| Oxylabs | Procurações residenciais | US$ 99/mês | ⭐ 4,5 |
| ThorData | Rotação de procuração orçamentária | US$ 15/mês | ⭐ 4,2 |
| Extrator de dados da web | Extração de dados de extensões de navegador | Grátis/US$ 50/mês | ⭐ 4,3 |
| Raspador de Hélio | Extração visual de dados para desktop | US$ 99 (pagamento único) | ⭐ 4.1 |
| Firecrawl | Extração de dados pronta para mestrado | US$ 19/mês | ⭐ 4,4 |
Escolhas rápidas:
- Melhor no geral: Zyte — gerencia tudo, desde o gerenciamento de proxies até a extração de IA, em uma única plataforma.
- Melhor orçamento: ScrapeGraphAI — código aberto e gratuito para desenvolvedores que desejam controle total.
- Ideal para iniciantes: Browse AI — uma interface sem código que torna a extração de dados da web acessível.
- Melhor opção para empresas: Bright Data — uma enorme rede de proxies criada para operações em larga escala.
🎯 Alternativas ao Zyte
Procurando alternativas ao Zyte? Aqui estão as melhores opções:
- 🚀 Apify: Oferece centenas de atores pré-construídos para tarefas comuns de extração de dados, com um generoso plano gratuito para projetos pequenos.
- 💰 ScrapeGraphAI: Biblioteca de extração de dados de IA de código aberto para desenvolvedores Python que preferem controle total sem taxas de assinatura.
- 🏢 Dados brilhantes: Rede proxy de nível empresarial com mais de 72 milhões de IPs e uma plataforma completa de coleta de dados.
- 👶 Navegar na IA: Ferramenta de extração de dados da web sem código, que permite a qualquer pessoa extrair dados da web apontando e clicando — sem necessidade de programação.
- ⚡ ScrapingBee: API simples que lida com proxies e navegadores sem interface gráfica, permitindo que você faça web scraping com uma única requisição HTTP.
- 🔒 Oxylabs: Proxies residenciais e de data center premium combinados com uma API de web scraping para coleta em larga escala.
- 🔥 ThorData: Serviço de proxy econômico com rotação sólida e boa cobertura para equipes sensíveis a preços.
- 🔧 Extrator de dados da web: Extensão gratuita para navegadores que permite criar scrapers visualmente dentro do Chrome — ótima para trabalhos rápidos.
- 🧠 Raspador de hélio: Aplicativo para desktop para extração visual de dados, com preço de compra único e sem taxas recorrentes.
- 🌟 Firecrawl: Transforma qualquer site em dados prontos para o LLM com saída Markdown limpa — desenvolvido para fluxos de trabalho de IA.
Para ver a lista completa, consulte nosso Alternativas ao Zyte guia.
⚔️ Comparação do Zyte
Veja como a Zyte se compara a cada concorrente:
- Zyte vs Apify: A Zyte se destaca em tecnologia anti-banimento e proxies gerenciados. A Apify se destaca em agentes de raspagem pré-construídos e marketplace.
- Zyte vs ScrapeGraphAI: O Zyte é totalmente gerenciado e oferece suporte. O ScrapeGraphAI é gratuito, mas requer mais configuração por parte do desenvolvedor.
- Zyte vs Bright Data: Ambas oferecem ferramentas de nível empresarial. A Bright Data possui mais proxies, enquanto a Zyte tem melhor extração de IA.
- Zyte vs Browse AI: O Zyte é melhor para desenvolvedores que escrevem código. Veja as vantagens da IA para usuários não técnicos.
- Zyte vs ScrapingBee: O Zyte oferece recursos mais avançados e integração com o Scrapy. O ScrapingBee é mais simples para extração básica de dados de API.
- Zyte vs Oxylabs: Ambas se destacam na rotação de proxies. A Zyte adiciona extração por IA, enquanto a Oxylabs se concentra na infraestrutura de proxies.
- Zyte vs ThorData: O ThorData é mais barato para necessidades que exigem apenas proxies. O Zyte inclui ferramentas de extração que vão além dos proxies.
- Zyte vs Web Scraper: O Web Scraper é gratuito para tarefas pequenas. O Zyte lida com extração de dados em larga escala com hospedagem em nuvem.
- Raspador Zyte vs Hélio: O Helium é uma ferramenta para desktop com custo único. O Zyte é baseado na nuvem e escalável para milhões de páginas.
- Zyte vs Firecrawl: O Firecrawl se destaca na geração de resultados compatíveis com LLM. O Zyte abrange uma gama mais ampla de casos de uso de scraping.
Comece a usar o Zyte agora mesmo
Você aprendeu a usar todos os principais recursos do Zyte:
- ✅ Extração de dados por IA
- ✅ Extração de dados de comércio eletrônico
- ✅ Dados para Agente de IA
- ✅ API Zyte
- ✅ Extrair dados de notícias e artigos
- ✅ Extração de dados de empregos
- ✅ Extração de Dados Imobiliários
- ✅ Extrator de dados de mídias sociais
- ✅ Hospedagem em Nuvem Escalável
Próximo passo: Escolha uma funcionalidade e experimente agora mesmo.
A maioria das pessoas começa com a extração de dados por meio de IA.
Leva menos de 5 minutos.
Perguntas frequentes
Para que serve o Zyte?
Zyte é uma plataforma de web scraping que permite extrair dados de sites em grande escala. Ela gerencia proxies, proteção contra banimento e extração de dados.
O Zyte é gratuito?
A Zyte oferece créditos gratuitos para novas contas. Depois disso, você paga por solicitação, com base no plano do site e no tipo de solicitação.
A API do Zyte funciona com Python?
Sim. A API Zyte funciona com Python e se integra diretamente ao framework Scrapy através da biblioteca scrapy-zyte-api.
Como a Zyte lida com bloqueios de IP?
A Zyte utiliza proxies rotativos inteligentes que trocam de endereço IP automaticamente. Isso evita a detecção por sistemas anti-bot em sites de destino.
O Zyte consegue extrair dados de páginas com muito JavaScript?
Sim. O Zyte suporta renderização pelo navegador, que carrega o conteúdo JavaScript completamente antes de extrair os dados da página.













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
