
Avvio rapido
Questa guida illustra tutte le funzionalità di Zyte:
- Iniziare — Crea il tuo account e completa la configurazione iniziale
- Come utilizzare lo scraping tramite intelligenza artificiale — Estrai dati strutturati da qualsiasi pagina web senza scrivere codice personalizzato
- Come utilizzare l'estrazione dei dati per l'e-commerce — Raccogliere dati sui prodotti dai negozi online su larga scala
- Come utilizzare i dati per un agente di intelligenza artificiale — Fornire set di dati puliti ai modelli di intelligenza artificiale e agli scienziati dei dati
- Come utilizzare l'API di Zyte — Aggiungi il web scraping al tuo codice tramite un unico punto centrale
- Come utilizzare i dati di estrazione di notizie e articoli — Estrazione di articoli di notizie e post di blog con estrazione del testo completo
- Come utilizzare i dati estratti dalle offerte di lavoro — Raccogli annunci di lavoro con indicazione di stipendio, qualifica e azienda.
- Come utilizzare l'estrazione dei dati immobiliari — Estrai gli annunci immobiliari con i dettagli relativi a prezzi e posizione.
- Come utilizzare uno strumento di scraping per i social media — Raccogliere i post pubblici sui social media e i dati del profilo
- Come utilizzare l'hosting cloud scalabile — Eseguire attività di scraping su un'infrastruttura cloud con scalabilità automatica
Tempo necessario: 5 minuti per ogni servizio
In questa guida troverete anche: Consigli professionali | Errori comuni | Risoluzione dei problemi | Prezzi | Alternative
Perché fidarsi di questa guida
Ho utilizzato Zyte per oltre sei mesi e ho testato ogni funzionalità descritta in questo tutorial. Questa guida si basa su una reale esperienza pratica, non su contenuti di marketing o screenshot del fornitore.

Zyte è uno dei più potenti strumenti di web scraping disponibile oggi.
Ma la maggior parte degli utenti ne sfrutta solo una minima parte delle potenzialità.
Questa guida ti mostra come utilizzare tutte le principali funzionalità.
Passo dopo passo, con schermate e consigli da professionisti.
Zyte Tutorial
Questo tutorial completo su Zyte ti guida passo passo attraverso ogni funzionalità, dalla configurazione iniziale ai suggerimenti avanzati che ti trasformeranno in un utente esperto.
Zyte
Trasforma qualsiasi sito web in un sistema strutturato dati In pochi minuti. Zyte gestisce la protezione anti-ban, la rotazione dei proxy e il rendering del browser, consentendo agli sviluppatori di concentrarsi sulla ricerca dei dati giusti. Inizia oggi stesso la tua prova gratuita.
Guida introduttiva a Zyte
Prima di utilizzare qualsiasi funzionalità, completa questa configurazione iniziale.
Ci vogliono circa 3 minuti.
Passaggio 1: crea il tuo account
Vai sul sito web di Zyte e fai clic su "Iscriviti".
Inserisci il tuo indirizzo email e crea una password per accedere.
✓ Punto di controllo: Controlla il tuo posta in arrivo per ricevere un'e-mail di conferma.
Passaggio 2: Accedere alla dashboard
Zyte è una piattaforma basata sul web: non è necessario scaricare nulla.
Accedi con il tuo nuovo account e apri la dashboard.
Ecco come si presenta la dashboard:
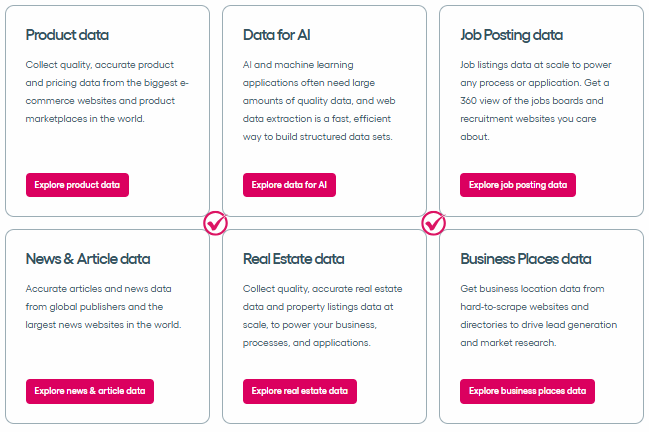
✓ Punto di controllo: Dovresti visualizzare la dashboard principale con diversi strumenti elencati.
Passaggio 3: Ottieni la tua chiave API
Accedi alle impostazioni del tuo account e copia la tua chiave API.
Ad esempio, puoi incollare questa chiave nel tuo script Python o in qualsiasi client HTTP.
✅ Fatto: Sei pronto per utilizzare una qualsiasi delle funzioni seguenti.
Come utilizzare Zyte AI Scraping
Scraping tramite IA Consente di estrarre dati da qualsiasi sito web di destinazione utilizzando un'analisi basata sull'intelligenza artificiale che gestisce automaticamente la complessità.
Ecco come usarlo passo dopo passo.
Passaggio 1: Apri lo strumento di scraping AI
Accedi alla tua dashboard di Zyte e seleziona AI Scraping.
Lo scraper basato sull'intelligenza artificiale legge il contenuto HTML e lo trasforma in dati strutturati.
Incolla l'URL del sito web da cui desideri estrarre i dati.
Incolla l'URL della pagina da cui desideri estrarre i dati.
Ecco come si presenta:
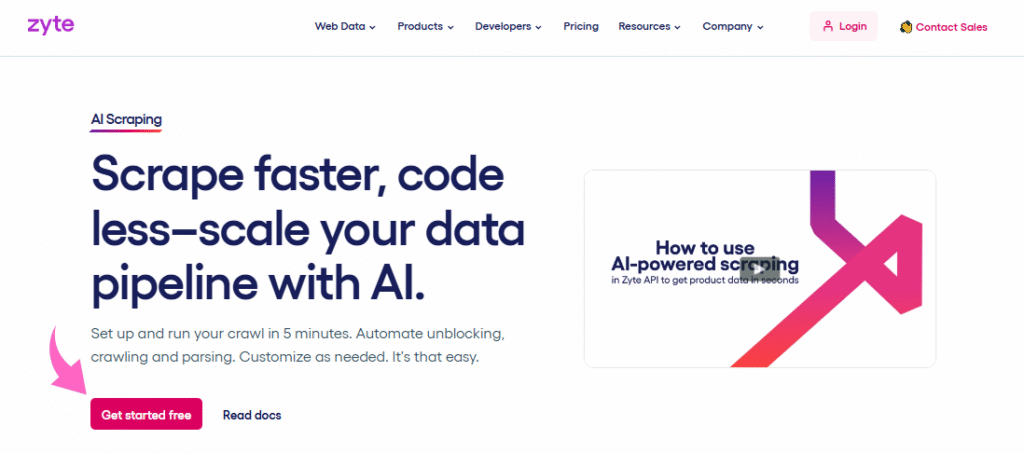
✓ Punto di controllo: Dovresti visualizzare un'anteprima dei campi estratti in formato JSON.
Passaggio 3: Rivedi e scarica i risultati
Check the extracted json response and export your file.
✅ Risultato: Hai estratto correttamente i dati dal sito web di destinazione e ora puoi avviare qualsiasi progetto di web scraping.
💡 Consiglio da professionista: Start with a single page to test before running at scale across an entire site.
Come utilizzare Zyte Ecommerce Data Extraction
Estrazione dati per l'e-commerce Consente di raccogliere dati sui prodotti dai siti di e-commerce, inclusi prezzo, titolo e dettagli sulla categoria.
Ecco come usarlo passo dopo passo.
Passaggio 1: Selezionare l'estrazione per l'e-commerce
Open the dashboard and choose the e commerce data extraction tool.
Questo strumento è stato creato per gestire le pagine prodotto dei principali siti di shopping.
Passaggio 2: Configurare i campi del prodotto
Seleziona le informazioni specifiche di cui hai bisogno: prezzo, titolo o categoria.
Ecco come si presenta:
✓ Punto di controllo: Dovresti visualizzare gli elenchi dei prodotti con le colonne relative al prezzo e al titolo.
Passaggio 3: Esegui ed esporta
Fai clic su "Estrai" per avviare il processo e scaricare i risultati in formato JSON o CSV.
✅ Risultato: Ora disponi di dati di prodotto strutturati provenienti dai siti di e-commerce che hai preso di mira.
💡 Consiglio da professionista: Utilizza i parametri di geolocalizzazione nelle tue richieste per confrontare i prezzi specifici per regione.
Come utilizzare l'agente Zyte AI
Dati per l'agente di intelligenza artificiale Consente di fornire dati web puliti direttamente a modelli di intelligenza artificiale e data scientist per l'addestramento o l'analisi.
Ecco come usarlo passo dopo passo.
Passaggio 1: Scegliere una pipeline di dati
Seleziona l'opzione Dati per l'agente AI dal menu principale.
Questo collega l'output della tua API di web scraping a pipeline predisposte per l'intelligenza artificiale.
Passaggio 2: Imposta l'ambito dei dati
Definisci l'ambito dei dati provenienti dai siti web che devi raccogliere.
Ecco come si presenta:
✓ Punto di controllo: La pipeline mostra uno stato di connessione con flusso di dati.
Passaggio 3: Esporta nel tuo strumento di intelligenza artificiale
Invia l'output dei dati strutturati alla piattaforma di intelligenza artificiale che preferisci.
✅ Risultato: Stai inserendo dati web direttamente nei tuoi flussi di lavoro di intelligenza artificiale.
💡 Consiglio da professionista: Schedule recurring extraction jobs so your AI models always train on fresh data.
Come utilizzare l'API di Zyte
API Zyte Consente di integrare il web scraping nel proprio codice utilizzando un singolo punto di accesso API con protezione anti-ban.
Ecco come usarlo passo dopo passo.
Passaggio 1: Ottieni la tua chiave API
Registrati o accedi, quindi copia la tua chiave API Zyte dalla dashboard.
Questa chiave rappresenta il punto di ingresso per ogni richiesta API effettuata.
Passaggio 2: Invia la tua prima richiesta
Utilizza Python o qualsiasi libreria HTTP per inviare una richiesta all'endpoint dell'API.
Ecco come si presenta:
✓ Punto di controllo: Il tuo script restituisce uno stato 200 con la pagina in formato HTML o JSON.
Passaggio 3: Analizzare la risposta
L'API restituisce contenuti HTML o JSON strutturato a seconda delle impostazioni: controlla ogni oggetto di risposta per eventuali errori.
✅ Risultato: Ora è possibile estrarre dati dai siti web in modo programmatico utilizzando il proprio codice.
💡 Consiglio da professionista: Per la scansione su larga scala, abbina l'API Zyte al framework Scrapy e alle librerie scrapy-zyte-api.
How to Use Zyte Extract News & Article Data
Estrazione di notizie e dati degli articoli ti consente di estrarre automaticamente articoli di notizie e contenuti di blog testo e l'estrazione dei dati.
Ecco come usarlo passo dopo passo.
Passaggio 1: Apri l'estrattore di notizie
Nel menu, seleziona "Estrai dati di notizie e articoli".
This tool is tuned for parsing news articles from media sites.
Passaggio 2: Aggiungere gli URL di origine
Incolla gli URL delle pagine o dei feed di notizie che desideri analizzare.
Ecco come si presenta:
✓ Punto di controllo: Nei risultati vengono visualizzati i titoli degli articoli, le date e le anteprime del testo.
Passaggio 3: Scarica i dati dell'articolo
Esegui l'estrazione ed esporta i risultati con titolo, data e testo completo.
✅ Risultato: Hai a disposizione articoli di notizie strutturati, pronti per l'analisi o l'archiviazione.
💡 Consiglio da professionista: Utilizza i filtri di categoria per restringere i risultati quando effettui ricerche su grandi siti di notizie.
Come utilizzare i dati estratti da Zyte Job
Dati di estrazione dei lavori Consente di raccogliere annunci di lavoro da siti di carriera con campi strutturati come titolo, azienda e stipendio.
Ecco come usarlo passo dopo passo.
Passaggio 1: Selezionare Job Scraping
Apri la funzione di estrazione dati dai processi dal pannello degli strumenti.
Questo strumento di scraping gestisce automaticamente i layout più comuni delle bacheche di lavoro.
Passaggio 2: Definisci i criteri di ricerca
Inserisci la qualifica professionale, la località o la categoria che desideri targettizzare.
Ecco come si presenta:
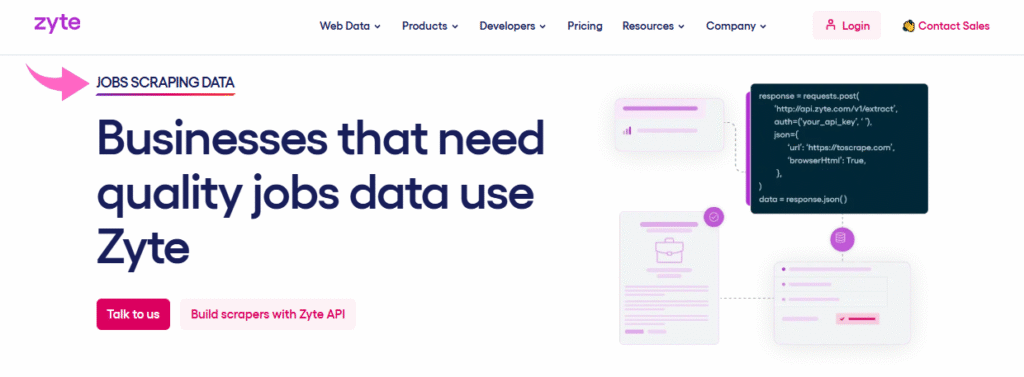
✓ Punto di controllo: Viene visualizzata una tabella con le offerte di lavoro e tutti i campi richiesti.
Passaggio 3: Esportare gli annunci di lavoro
Scarica i dati in formato CSV o JSON per poterli esaminare.
✅ Risultato: Hai a disposizione dati puliti sugli annunci di lavoro, utili per ricerche di mercato o per il monitoraggio.
💡 Consiglio da professionista: Pianifica acquisizioni settimanali per monitorare le nuove offerte di lavoro e l'andamento degli stipendi nel tempo.
Come utilizzare l'estrazione dati immobiliari di Zyte
Immobiliare Estrazione dei dati Consente di estrarre annunci immobiliari da siti del settore, includendo prezzo, posizione e dettagli.
Ecco come usarlo passo dopo passo.
Passaggio 1: Aprire l'estrazione immobiliare
Seleziona Estrazione dati immobiliari dalla dashboard.
Questo modulo analizza le pagine degli annunci immobiliari sui principali siti web del settore.
Passaggio 2: Configurare i campi delle proprietà
Seleziona i dati di cui hai bisogno: prezzo, indirizzo o metratura.
Ecco come si presenta:
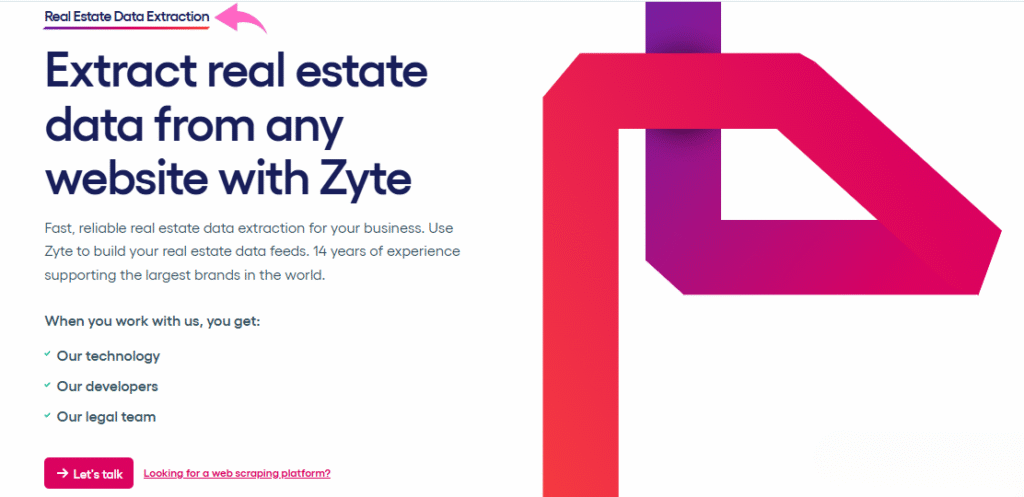
✓ Punto di controllo: Gli annunci immobiliari vengono visualizzati con le colonne relative al prezzo e alla posizione.
Passaggio 3: Esporta gli elenchi
Scarica i risultati nel formato che preferisci per l'analisi.
✅ Risultato: Hai a disposizione dati immobiliari strutturati per l'analisi degli investimenti.
💡 Consiglio da professionista: Utilizza proxy con targeting geografico per accedere agli annunci immobiliari con restrizioni regionali.
Come utilizzare Zyte Social Media Scraper
Estrattore di contenuti dai social media Consente di raccogliere dati pubblici dai social media, inclusi post, profili e metriche di coinvolgimento.
Ecco come usarlo passo dopo passo.
Passaggio 1: Scegli lo strumento di scraping dei social media
Seleziona lo strumento Social Media Scraper dal menu.
Questo sistema gestisce le pagine del profilo pubblico e i post su tutte le piattaforme.
Passaggio 2: Inserire gli URL del profilo o dell'hashtag
Incolla gli URL delle pagine pubbliche o degli argomenti da cui desideri estrarre i dati.
Ecco come si presenta:
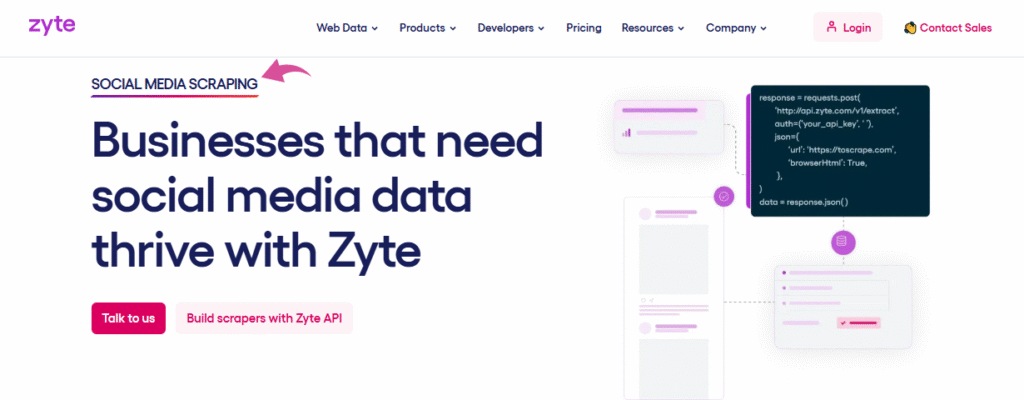
✓ Punto di controllo: I post sui social media vengono visualizzati con colonne di testo e di interazione.
Passaggio 3: Rivedi e scarica i dati
Verifica l'output ed esportalo come file JSON o CSV.
✅ Risultato: Ora hai a disposizione dati social pubblici pronti per l'analisi delle tendenze o segnalazione.
💡 Consiglio da professionista: Rispetta i limiti di utilizzo e i termini del sito per garantire il corretto funzionamento del tuo scraper.
Come utilizzare l'hosting cloud scalabile Zyte
Hosting cloud scalabile ti consente di eseguire le tue attività di web scraping su un'infrastruttura cloud che si adatta alle tue esigenze di dati web.
Ecco come usarlo passo dopo passo.
Passaggio 1: Accedere alle impostazioni di hosting cloud
Accedi alla sezione Hosting cloud scalabile nel tuo account.
Qui è possibile gestire le risorse del server per i processi di estrazione.
Step 2: Deploy Your Scraping Job
Carica il tuo spider o script e seleziona il tuo livello di risorse.
Ecco come si presenta:
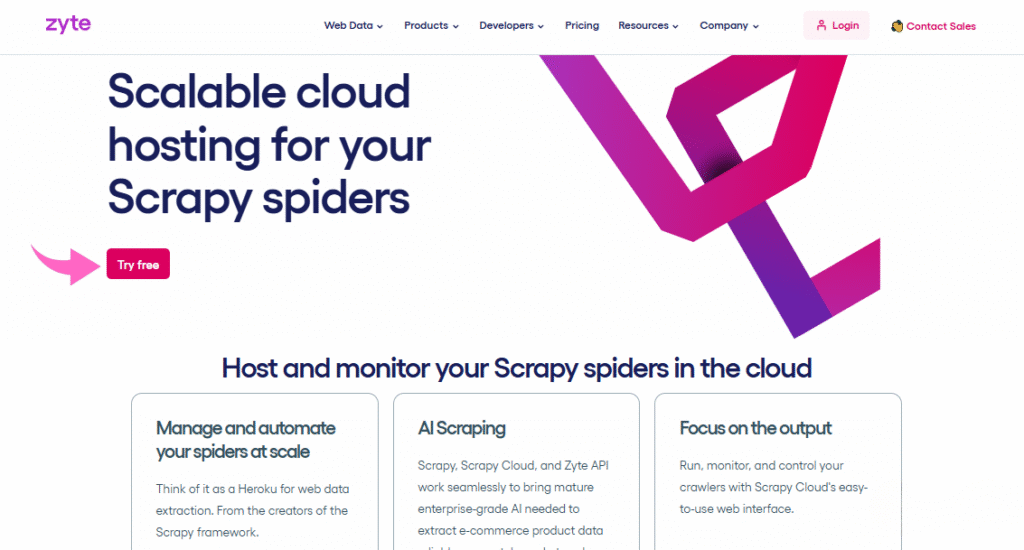
✓ Punto di controllo: Your job dashboard shows active spiders with resource usage stats.
Fase 3: Monitorare e scalare
Monitora l'avanzamento dei lavori e adegua le risorse in base all'evoluzione delle tue esigenze di dati.
✅ Risultato: Il tuo web scraping viene eseguito su un'infrastruttura cloud gestita, a qualsiasi scala.
💡 Consiglio da professionista: Inizia con un piano più piccolo e aumentalo solo dopo aver compreso il volume effettivo delle richieste.
Suggerimenti e scorciatoie per Zyte Pro
Dopo aver testato Zyte per oltre sei mesi, ecco i miei migliori consigli.
Scorciatoie da tastiera
| Azione | Scorciatoia |
|---|---|
| Ragno di corsa | Torna alla dashboard |
| Interrompi il lavoro attivo | Ctrl + Maiusc + S |
| Apri la console di Zyte IDE | Ctrl + ` |
| Cerca i file del progetto | Ctrl + P |
Funzionalità nascoste che la maggior parte delle persone non nota
- Zyte IDE: Scrivi, testa ed esegui il debug degli script del browser direttamente in un ambiente basato su browser, senza dover passare a un editor locale.
- Estrazione automatica: L'estrattore basato sull'intelligenza artificiale restituisce dati JSON strutturati senza bisogno di scrivere codice di parsing e si adatta ai cambiamenti di layout dei siti web.
- Chat with us ZyteBot: Utilizza la chat integrata nell'app con ZyteBot per ottenere risposte immediate su configurazione, errori o domande sulle migliori pratiche.
Errori comuni da evitare con Zyte
Mistake #1: Ignoring Proxy Rotation Settings
❌ Sbagliato: L'invio di tutte le richieste da un unico indirizzo IP, che innesca il blocco dell'IP sul sito web di destinazione.
✅ A destra: Enable smart rotating proxies so Zyte automatically switches IPs to avoid detection.
Errore n. 2: Eseguire lo scraping senza controllare robots.txt
❌ Sbagliato: Indicizzare pagine che il proprietario del sito ha bloccato, un problema che richiede tempo per essere risolto e che può comportare conseguenze legali.
✅ A destra: Prima di iniziare a praticare il web scraping in modo responsabile, è sempre opportuno consultare le linee guida del file robots.txt e identificare i percorsi soggetti a restrizioni.
Errore n. 3: Non gestire gli errori nello script
❌ Sbagliato: Letting your scraper crash silently when a webpage returns a 403 or timeout response.
✅ A destra: Aggiungi la gestione degli errori al tuo codice per registrare gli errori HTTP e ritentare automaticamente le richieste non riuscite.
Risoluzione dei problemi di Zyte
Problema: le richieste restituiscono contenuto HTML vuoto
Causa: Il sito web di destinazione utilizza JavaScript per caricare i contenuti in modo dinamico.
Aggiustare: Abilita il rendering del browser nella tua richiesta API di Zyte in modo che la pagina si carichi completamente prima dell'estrazione.
Problema: lo scraper si blocca dopo poche richieste.
Causa: Il sito rileva richieste ripetute provenienti dallo stesso indirizzo IP o dallo stesso user agent.
Aggiustare: Attiva la rotazione intelligente del proxy e aggiungi intestazioni personalizzate alle tue richieste per evitare il rilevamento da parte dei sistemi anti-bot.
Problema: i dati estratti presentano campi mancanti o danneggiati.
Causa: Il sito web di destinazione ha modificato il suo layout, causando un errore nel parser.
Aggiustare: Passa all'estrazione automatica in modo che l'IA si adatti alle modifiche del layout senza dover aggiornare manualmente il codice.
📌 Nota: Se nessuna di queste soluzioni risolve il problema, contatta l'assistenza clienti di Zyte o utilizza la chat disponibile 24 ore su 24, 7 giorni su 7, per ricevere aiuto.
Che cos'è Zyte?
Zyte è una piattaforma di web scraping che aiuta sviluppatori e data scientist a estrarre dati dai siti web senza dover gestire manualmente blocchi IP, proxy o misure anti-bot.
Pensala come un punto centrale per tutte le tue esigenze di dati web: un'unica piattaforma con molteplici strumenti per ogni attività di scraping.
Guarda questa breve panoramica:
Include le seguenti caratteristiche principali:
- Scraping AI: Utilizza l'intelligenza artificiale per estrarre dati strutturati da qualsiasi pagina web senza bisogno di codice di analisi personalizzato.
- Estrazione dati per l'e-commerce: Raccogliere dati sui prodotti dai negozi online su larga scala.
- Data for AI Agent: Fornisci set di dati puliti e strutturati direttamente ai modelli di intelligenza artificiale.
- API di Zyte: Integra il web scraping nel tuo codice con protezione anti-ban integrata.
- Dati di estrazione di notizie e articoli: Recupera articoli di notizie con testo completo e metadati.
- Dati relativi all'estrazione dei lavori: Raccogli annunci di lavoro strutturati da siti web dedicati alla ricerca di impiego.
- Estrazione di dati immobiliari: Estrai annunci immobiliari contenenti i campi relativi a prezzo e posizione.
- Strumento di estrazione dati dai social media: Raccogli post pubblici e dati del profilo a scopo di analisi.
- Hosting cloud scalabile: Eseguire processi di scraping su un'infrastruttura con scalabilità automatica.
Per una recensione completa, consulta la nostra Recensione di Zyte.
Zyte è la soluzione ideale per qualsiasi team che necessiti di raccogliere pagine web su larga scala senza dover gestire proxy o scrivere parser personalizzati da zero.
Prezzi di Zyte
Ecco quanto costerà Zyte nel 2026:
Zyte uses a pay-per-request pricing model based on website complexity tiers.
Risposta HTTP estratta — Prezzo per 1.000 richieste
| Livello del sito web | Paga mentre consumi | Piano da 100 dollari | Piano da 500 dollari |
|---|---|---|---|
| Livello 1 | $0.40 | $0.30 | $0.19 |
| Livello 2 | $0.50 | $0.37 | $0.24 |
| Livello 3 | $0.70 | $0.52 | $0.33 |
| Livello 4 | $0.97 | $0.72 | $0.46 |
| Livello 5 | $1.53 | $1.15 | $0.73 |
Richieste del browser estratte: prezzo per 1.000 richieste
| Livello del sito web | Paga mentre consumi | Piano da 100 dollari | Piano da 500 dollari |
|---|---|---|---|
| Livello 1 | $1.80 | $1.35 | $0.85 |
| Livello 2 | $2.80 | $2.10 | $1.33 |
| Livello 3 | $4.80 | $3.59 | $2.27 |
| Livello 4 | $8.79 | $6.59 | $4.17 |
| Livello 5 | $16.78 | $12.58 | $7.96 |
Prova gratuita: Sì, i nuovi account ricevono crediti gratuiti per testare la piattaforma.
Garanzia di rimborso: No, i crediti non sono rimborsabili una volta utilizzati.
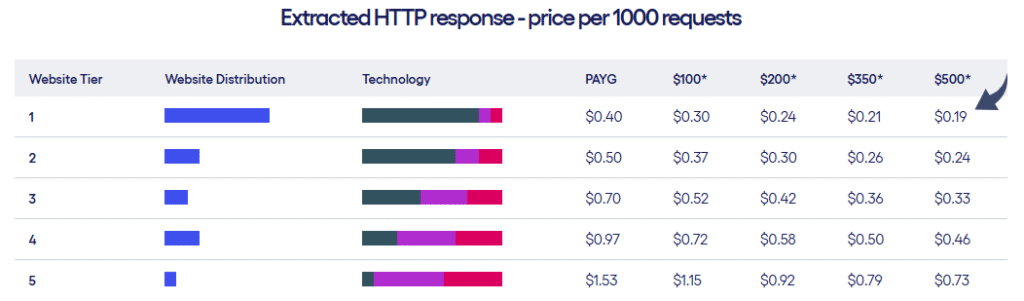
💰 Miglior rapporto qualità-prezzo: Piano da 500 $ di Livello 1: ottieni il prezzo più basso per richiesta, pari a 0,19 $ per HTTP e 0,85 $ per l'estrazione tramite browser.
Zyte contro le alternative
Come si posiziona Zyte rispetto alla concorrenza? Ecco il panorama competitivo:
| Attrezzo | Ideale per | Prezzo | Valutazione |
|---|---|---|---|
| Zyte | Web scraping full-stack | $0,19+/1K richiesto | ⭐ 4,5 |
| Apify | attori di raschiatura pre-costruiti | $49/mese | ⭐ 4.6 |
| ScrapeGraphAI | Estrazione di dati da grafici tramite intelligenza artificiale | Libero/Open Source | ⭐ 4.3 |
| Dati brillanti | Reti proxy aziendali | Oltre 500 dollari al mese | ⭐ 4,5 |
| Esplora l'IA | Web scraping senza codice | $49/mese | ⭐ 4.4 |
| ScrapingBee | Semplice estrazione dati tramite API | $49/mese | ⭐ 4.4 |
| Oxylabs | Proxy residenziali | $ 99/mese | ⭐ 4,5 |
| ThorData | rotazione del proxy di bilancio | 15 dollari al mese | ⭐ 4.2 |
| Web Scraper | Estrazione dati dalle estensioni del browser | Gratuito/50$/mese | ⭐ 4.3 |
| Raschietto per elio | Estrazione visiva dal desktop | $99 una tantum | ⭐ 4.1 |
| Firecrawl | Estrazione dati pronta per LLM | $ 19/mese | ⭐ 4.4 |
Scelte rapide:
- Il migliore in assoluto: Zyte gestisce tutto, dalla gestione dei proxy all'estrazione di dati tramite intelligenza artificiale, in un'unica piattaforma.
- Miglior budget: ScrapeGraphAI è un software open-source e gratuito per gli sviluppatori che desiderano il pieno controllo.
- Ideale per principianti: Browse AI è un'interfaccia senza codice che rende accessibile il web scraping.
- Ideale per le aziende: Bright Data: una vasta rete di proxy progettata per operazioni su larga scala.
🎯 Alternative a Zyte
Cerchi alternative a Zyte? Ecco le migliori opzioni:
- 🚀 Apify: Offre centinaia di attori predefiniti per le attività di scraping più comuni, con un generoso piano gratuito per i progetti di piccole dimensioni.
- 💰 ScrapeGraphAI: Libreria di scraping basata sull'intelligenza artificiale open-source per sviluppatori Python che desiderano il pieno controllo senza costi di abbonamento.
- 🏢 Dati brillanti: Rete proxy di livello aziendale con oltre 72 milioni di indirizzi IP e una piattaforma completa per la raccolta dati.
- 👶 Esplora l'IA: Strumento di scraping senza codice che permette a chiunque di estrarre dati dal web semplicemente puntando e cliccando, senza bisogno di programmare.
- ⚡ ScrapingBee: Un'API semplice che gestisce proxy e browser headless, permettendoti di effettuare lo scraping con una singola richiesta HTTP.
- 🔒 Oxylabs: Proxy residenziali e per data center di alta qualità, abbinati a un'API di web scraping per la raccolta di dati su larga scala.
- 🔥 ThorData: Servizio proxy economico con una solida rotazione e una buona copertura per team attenti al prezzo.
- 🔧 Web Scraper: Estensione gratuita per browser che consente di creare scraper in modo visivo direttamente all'interno di Chrome: ideale per lavori rapidi.
- 🧠 Raschietto per elio: Desktop app for visual scraping with a one-time purchase price and no recurring fees.
- 🌟 Carico di fuoco: Trasforma qualsiasi sito web in dati pronti per LLM con un output Markdown pulito, progettato per flussi di lavoro basati sull'intelligenza artificiale.
Per l'elenco completo, consultare il nostro Alternative a Zyte guida.
⚔️ Confronto tra Zyte
Ecco come Zyte si posiziona rispetto a ciascun concorrente:
- Zyte contro Apify: Zyte vince grazie alla tecnologia anti-ban e ai proxy gestiti. Apify vince grazie agli attori di scraping preconfigurati e al marketplace.
- Zyte contro ScrapeGraphAI: Zyte è completamente gestito con supporto. ScrapeGraphAI è gratuito ma richiede una configurazione più complessa da parte dello sviluppatore.
- Zyte contro Bright Data: Entrambi offrono strumenti di livello aziendale. Bright Data ha più proxy, mentre Zyte ha una migliore estrazione tramite intelligenza artificiale.
- Zyte contro Browse AI: Zyte è più adatto agli sviluppatori che scrivono codice. Browse AI è invece più indicato per gli utenti non tecnici.
- Zyte contro ScrapingBee: Zyte offre funzionalità più avanzate e l'integrazione con Scrapy. ScrapingBee è più semplice e adatto allo scraping di base delle API.
- Zyte contro Oxylabs: Entrambi eccellono nella rotazione dei proxy. Zyte aggiunge l'estrazione tramite intelligenza artificiale, mentre Oxylabs si concentra sull'infrastruttura proxy.
- Zyte contro ThorData: ThorData è più economico per chi ha bisogno solo di proxy. Zyte include strumenti di estrazione che vanno oltre i semplici proxy.
- Zyte contro Web Scraper: Web Scraper è gratuito per piccoli progetti. Zyte gestisce lo scraping su larga scala con hosting cloud.
- Zyte contro Helium Scraper: Helium è uno strumento desktop con un costo una tantum. Zyte è basato sul cloud e scalabile fino a milioni di pagine.
- Zyte contro Firecrawl: Firecrawl eccelle nell'output pronto per LLM. Zyte copre una gamma più ampia di casi d'uso per lo scraping.
Inizia subito a usare Zyte
Hai imparato a usare tutte le principali funzionalità di Zyte:
- ✅ Web scraping basato sull'IA
- ✅ Ecommerce Data Extraction
- ✅ Dati per l'agente AI
- ✅ API Zyte
- ✅ Extract News & Article Data
- ✅ Estrazione dati di lavoro
- ✅ Real Estate Data Extraction
- ✅ Strumento di estrazione dati dai social media
- ✅ Hosting cloud scalabile
Passo successivo: Scegli una funzionalità e provala subito.
La maggior parte delle persone inizia con lo scraping tramite intelligenza artificiale.
Ci vogliono meno di 5 minuti.
Domande frequenti
A cosa serve Zyte?
Zyte è una piattaforma di web scraping che consente di estrarre dati da siti web su larga scala. Gestisce proxy, protezione anti-ban ed estrazione dati.
Is Zyte free to use?
Zyte offre crediti gratuiti per i nuovi account. Successivamente, il pagamento avviene per ogni richiesta, in base al piano del sito web e al tipo di richiesta.
L'API di Zyte funziona con Python?
Sì. L'API Zyte funziona con Python e si integra direttamente con il framework Scrapy tramite la libreria scrapy-zyte-api.
Come gestisce Zyte i blocchi IP?
Zyte utilizza proxy rotanti intelligenti che cambiano automaticamente gli indirizzi IP. Questo evita il rilevamento da parte dei sistemi anti-bot sui siti web di destinazione.
Zyte è in grado di estrarre dati da pagine web ricche di JavaScript?
Sì. Zyte supporta il rendering del browser, che carica completamente il contenuto JavaScript prima di estrarre i dati dalla pagina.













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
