
Snelstart
Deze handleiding behandelt alle functies van Zyte:
- Aan de slag — Maak je account aan en voltooi de eerste installatie.
- Hoe AI-scraping te gebruiken — Haal gestructureerde gegevens op van elke webpagina zonder aangepaste code te schrijven
- Hoe gebruik je data-extractie voor e-commerce? — Verzamel productgegevens van online winkels op grote schaal
- Hoe data te gebruiken voor een AI-agent — Lever schone datasets aan AI-modellen en datawetenschappers
- Hoe gebruik je de Zyte API? — Voeg webscraping toe aan je code via één centraal punt
- Hoe u gegevens uit nieuws- en artikelgegevens kunt extraheren — Verzamel nieuwsartikelen en blogberichten met volledige tekstextractie.
- Hoe gebruik je data uit vacature-scraping? — Verzamel vacatures met velden voor salaris, functietitel en bedrijf.
- Hoe data-extractie uit de vastgoedsector te gebruiken — Zoek naar vastgoedadvertenties met prijs- en locatiegegevens
- Hoe gebruik je een social media scraper? — Verzamel openbare berichten en profielgegevens van sociale media
- Hoe schaalbare cloudhosting te gebruiken — Voer scrapingtaken uit op automatisch schaalbare cloudinfrastructuur
Benodigde tijd: 5 minuten per film
Ook in deze handleiding: Professionele tips | Veelgemaakte fouten | Probleemoplossing | Prijzen | Alternatieven
Waarom zou je deze gids vertrouwen?
Ik gebruik Zyte al meer dan zes maanden en heb alle functies die hier worden beschreven, getest. Deze handleiding is gebaseerd op echte praktijkervaring – geen marketingpraatjes of screenshots van de leverancier.

Zyte is een van de krachtigste web scraping tools Vandaag beschikbaar.
Maar de meeste gebruikers benutten slechts een fractie van de mogelijkheden.
Deze handleiding laat u zien hoe u alle belangrijke functies kunt gebruiken.
Stap voor stap, met screenshots en professionele tips.
Zyte-handleiding
Deze complete Zyte-handleiding leidt je stap voor stap door alle functies, van de eerste installatie tot geavanceerde tips waarmee je een gevorderde gebruiker wordt.
Zyte
Transformeer elke website in een gestructureerde website. gegevens Binnen enkele minuten. Zyte regelt anti-ban-bescherming, proxyrotatie en browserrendering, zodat ontwikkelaars zich kunnen concentreren op het vinden van de juiste data. Start vandaag nog uw gratis proefperiode.
Aan de slag met Zyte
Voordat u een functie kunt gebruiken, moet u deze eenmalige installatie voltooien.
Het duurt ongeveer 3 minuten.
Stap 1: Maak uw account aan
Ga naar de website van Zyte en klik op 'Aanmelden'.
Voer uw e-mailadres in en maak een wachtwoord aan om in te loggen.
✓ Controlepunt: Controleer uw inbox voor een bevestigingsmail.
Stap 2: Open het dashboard
Zyte is een webgebaseerd platform – downloaden is niet nodig.
Log in met je nieuwe account en open het dashboard.
Zo ziet het dashboard eruit:
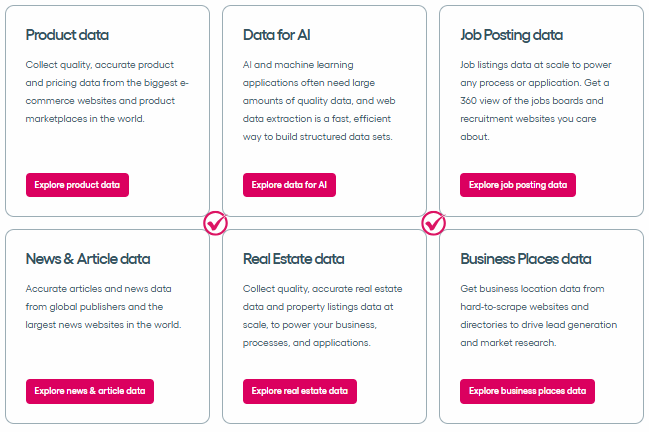
✓ Controlepunt: Je zou het hoofddashboard met meerdere tools moeten zien.
Stap 3: Haal je API-sleutel op
Ga naar je accountinstellingen en kopieer je API-sleutel.
Je kunt deze sleutel bijvoorbeeld in je Python-script of een HTTP-client plakken.
✅ Klaar: Je bent klaar om een van de onderstaande functies te gebruiken.
Hoe gebruik je Zyte AI-scraping?
AI-scraping Hiermee kunt u gegevens van elke gewenste website extraheren met behulp van AI-gestuurde parsing die automatisch complexe gegevens verwerkt.
Hieronder leggen we stap voor stap uit hoe je het gebruikt.
Stap 1: Open de AI-scrapingtool.
Log in op je Zyte-dashboard en selecteer AI Scraping.
De AI-scraper leest HTML-content en zet deze om in gestructureerde data.
Stap 2: Voer uw doel-URL in
Plak hier de URL van de pagina die je wilt scrapen.
Zo ziet het eruit:
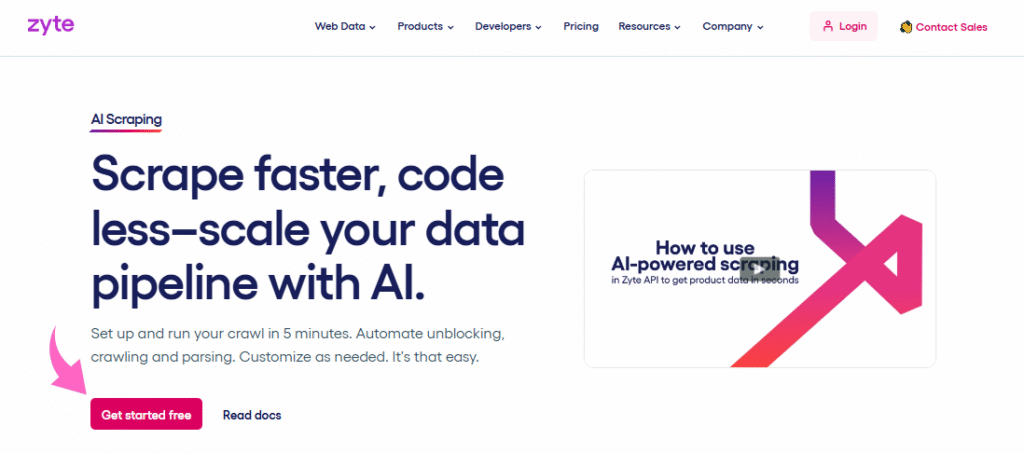
✓ Controlepunt: Je zou een voorbeeld van de geëxtraheerde velden in JSON-formaat moeten zien.
Stap 3: Resultaten bekijken en downloaden
Controleer het geëxtraheerde JSON-antwoord en exporteer uw bestand.
✅ Resultaat: Je hebt nauwkeurig gegevens van je doelwebsite geëxtraheerd en kunt nu elk gewenst webscrapingproject opzetten.
💡 Pro-tip: Begin met een enkele pagina om te testen voordat je het op grote schaal op een hele website uitrolt.
Hoe gebruik je Zyte Ecommerce Data Extraction?
E-commerce data-extractie Hiermee kunt u productgegevens van e-commercewebsites verzamelen, waaronder prijs-, titel- en categoriegegevens.
Hieronder leggen we stap voor stap uit hoe je het gebruikt.
Stap 1: Selecteer E-commerce-extractie
Open het dashboard en kies de tool voor het extraheren van e-commercegegevens.
Deze tool is ontwikkeld voor het verwerken van productpagina's van grote webwinkels.
Stap 2: Productvelden configureren
Selecteer de specifieke informatie die u nodig hebt: prijs, titel of categorie.
Zo ziet het eruit:
✓ Controlepunt: Je zou productlijsten moeten zien met kolommen voor prijs en titel.
Stap 3: Uitvoeren en exporteren
Klik op 'Uitpakken' om de taak te starten en de resultaten in JSON- of CSV-formaat te downloaden.
✅ Resultaat: Je beschikt nu over gestructureerde productgegevens van je doel-e-commercewebsites.
💡 Pro-tip: Gebruik geolocatieparameters in uw aanvragen om prijzen per regio te vergelijken.
Hoe gebruik je de Zyte AI-agent?
Gegevens voor AI-agent Hiermee kunt u schone webgegevens rechtstreeks aan AI-modellen en datawetenschappers doorgeven voor training of analyse.
Hieronder leggen we stap voor stap uit hoe je het gebruikt.
Stap 1: Kies een datapipeline
Selecteer de optie 'Gegevens voor AI-agent' in het hoofdmenu.
Dit verbindt de output van uw webscraping-API met AI-compatibele pipelines.
Stap 2: Stel uw gegevensbereik in
Bepaal welke soorten gegevens van websites u wilt verzamelen.
Zo ziet het eruit:
✓ Controlepunt: Uw pipeline geeft een verbonden status weer en er stroomt data doorheen.
Stap 3: Exporteer naar uw AI-tool
Stuur de gestructureerde data-output naar uw favoriete AI-platform.
✅ Resultaat: Je voert webgegevens rechtstreeks in je AI-workflows in.
💡 Pro-tip: Plan terugkerende extractietaken in, zodat uw AI-modellen altijd met actuele gegevens worden getraind.
Hoe gebruik je de Zyte API?
Zyte API Hiermee kunt u webscraping in uw eigen code integreren via één API-ingangspunt met bescherming tegen blokkeringen.
Hieronder leggen we stap voor stap uit hoe je het gebruikt.
Stap 1: Verkrijg uw API-sleutel
Meld je aan of log in en kopieer vervolgens je Zyte API-sleutel vanuit het dashboard.
Deze sleutel is het startpunt voor elk API-verzoek dat u doet.
Stap 2: Verstuur je eerste aanvraag
Gebruik Python of een andere HTTP-bibliotheek om een verzoek naar het API-eindpunt te sturen.
Zo ziet het eruit:
✓ Controlepunt: Je script retourneert een 200-statuscode met de HTML- of JSON-gegevens van de pagina.
Stap 3: Het antwoord parseren
De API retourneert HTML-inhoud of gestructureerde JSON, afhankelijk van uw instellingen. Controleer elk responsobject op fouten.
✅ Resultaat: Je kunt nu programmatisch gegevens van websites extraheren met je eigen code.
💡 Pro-tip: Combineer de Zyte API met het Scrapy-framework en de scrapy-zyte-api-bibliotheken voor grootschalige webcrawling.
Hoe Zyte Extract te gebruiken Nieuws & Artikelgegevens
Extraheer nieuws- en artikelgegevens Hiermee kunt u automatisch nieuwsartikelen en blogcontent ophalen. tekst en datumextractie.
Hieronder leggen we stap voor stap uit hoe je het gebruikt.
Stap 1: Open de nieuwsextractor.
Ga in het menu naar 'Nieuws- en artikelgegevens extraheren'.
Deze tool is geoptimaliseerd voor het analyseren van nieuwsartikelen van mediasites.
Stap 2: Bron-URL's toevoegen
Plak hier de URL's van de nieuwspagina's of feeds die je wilt scrapen.
Zo ziet het eruit:
✓ Controlepunt: In de zoekresultaten zie je artikeltitels, datums en tekstvoorbeelden.
Stap 3: Artikelgegevens downloaden
Voer de extractie uit en exporteer de resultaten met titel, datum en volledige tekst.
✅ Resultaat: Je hebt gestructureerde nieuwsartikelen klaar voor analyse of archivering.
💡 Pro-tip: Gebruik categoriefilters om de zoekresultaten te verfijnen bij het zoeken op grote nieuwssites.
Hoe gebruik je Zyte Job voor het scrapen van data?
Job Scraping Data Hiermee kunt u vacatures verzamelen van carrièrewebsites met gestructureerde velden zoals functietitel, bedrijf en salaris.
Hieronder leggen we stap voor stap uit hoe je het gebruikt.
Stap 1: Selecteer Job Scraping
Open de functie 'Job Scraping Data' vanuit het gereedschapspaneel.
Deze scraper verwerkt automatisch de meest voorkomende vacaturebankindelingen.
Stap 2: Definieer uw zoekcriteria
Voer de functietitel, locatie of categorie in waarop u zich wilt richten.
Zo ziet het eruit:
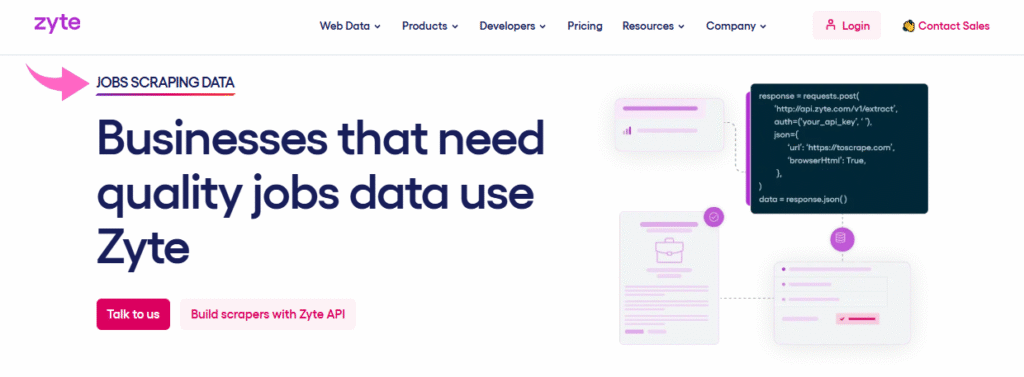
✓ Controlepunt: Er verschijnt een tabel met vacatures, inclusief alle gevraagde velden.
Stap 3: Vacatureoverzichten exporteren
Download de gegevens als een csv- of json-bestand ter controle.
✅ Resultaat: Je beschikt over schone vacaturegegevens voor marktonderzoek of -monitoring.
💡 Pro-tip: Plan wekelijkse data-scraping in om nieuwe vacatures en salaristrends in de loop van de tijd te volgen.
Hoe gebruik je Zyte voor het extraheren van vastgoedgegevens?
Vastgoed Gegevensextractie Hiermee kunt u woningaanbiedingen van makelaarswebsites verzamelen met velden voor prijs, locatie en details.
Hieronder leggen we stap voor stap uit hoe je het gebruikt.
Stap 1: Open de vastgoedextractie
Selecteer 'Vastgoeddata-extractie' in het dashboard.
Deze module analyseert pagina's met woningaanbiedingen van de belangrijkste vastgoedwebsites.
Stap 2: Eigenschappenvelden configureren
Selecteer de gegevens die u nodig hebt: prijs, adres of vierkante meters.
Zo ziet het eruit:
✓ Controlepunt: De woningaanbiedingen worden weergegeven met kolommen voor prijs en locatie.
Stap 3: Exporteer de lijsten
Download de resultaten in het formaat van uw voorkeur voor analyse.
✅ Resultaat: U beschikt over gestructureerde vastgoedgegevens voor investeringsanalyses.
💡 Pro-tip: Gebruik proxy's met geografische targeting om toegang te krijgen tot vastgoedaanbiedingen die alleen in die regio beschikbaar zijn.
Hoe gebruik je Zyte Social Media Scraper?
Sociale media scraper Hiermee kun je openbare sociale mediagegevens verzamelen, waaronder berichten, profielen en engagementstatistieken.
Hieronder leggen we stap voor stap uit hoe je het gebruikt.
Stap 1: Kies een socialmedia-scraper.
Selecteer de tool 'Social Media Scraper' in het menu.
Dit beheert openbare profiel- en berichtenpagina's op alle platformen.
Stap 2: Voer profiel- of hashtag-URL's in
Plak hier de URL's van de openbare pagina's of onderwerpen die u wilt scrapen.
Zo ziet het eruit:
✓ Controlepunt: Berichten op sociale media worden weergegeven met kolommen voor tekst en interactie.
Stap 3: Gegevens controleren en downloaden
Controleer de uitvoer en exporteer deze als een JSON- of CSV-bestand.
✅ Resultaat: Je hebt nu openbare sociale data beschikbaar voor trendanalyse of rapportage.
💡 Pro-tip: Houd rekening met de limieten voor het aantal aanvragen en de algemene voorwaarden van de website om ervoor te zorgen dat uw scraper soepel blijft werken.
Hoe gebruik je Zyte schaalbare cloudhosting?
Schaalbare cloudhosting Hiermee kunt u uw webscrapingtaken uitvoeren op cloudinfrastructuur die meegroeit met uw webdatabehoeften.
Hieronder leggen we stap voor stap uit hoe je het gebruikt.
Stap 1: Toegang tot de cloudhostinginstellingen
Open het gedeelte Schaalbare cloudhosting in uw account.
Hier beheert u de serverbronnen voor uw extractietaken.
Stap 2: Voer uw scrapingtaak uit
Upload je spider of script en selecteer je resourcecategorie.
Zo ziet het eruit:
✓ Controlepunt: Op je takenoverzicht zie je actieve spiders met statistieken over het resourcegebruik.
Stap 3: Monitoren en schalen
Volg de voortgang van taken en pas de resources aan naarmate uw datavereisten toenemen.
✅ Resultaat: Uw webscraping draait op beheerde cloudinfrastructuur, ongeacht de schaal.
💡 Pro-tip: Begin met een kleiner plan en schaal pas op nadat je inzicht hebt in het werkelijke aantal aanvragen.
Zyte Pro-tips en -sneltoetsen
Na Zyte meer dan zes maanden te hebben getest, deel ik hier mijn beste tips.
Toetsenbord sneltoetsen
| Actie | Snelkoppeling |
|---|---|
| Ren spin | Ctrl + R |
| Stop de actieve taak | Ctrl + Shift + S |
| Open de Zyte IDE-console | Ctrl + ` |
| Projectbestanden doorzoeken | Ctrl + P |
Verborgen functies die de meeste mensen over het hoofd zien
- Zyte IDE: Schrijf, test en debug browserscripts rechtstreeks in een browseromgeving zonder over te schakelen naar een lokale editor.
- Automatische extractie: De AI-gestuurde extractor levert gestructureerde JSON-gegevens zonder dat er parseercode hoeft te worden geschreven en past zich aan wanneer de lay-out van websites verandert.
- Chat met ons via ZyteBot: Gebruik de ingebouwde chatfunctie van ZyteBot om direct antwoord te krijgen op vragen over installatie, fouten of de beste werkwijze.
Veelvoorkomende fouten bij het gebruik van Zyte die je moet vermijden
Fout nr. 1: Het negeren van de instellingen voor proxyrotatie.
❌ Fout: Het versturen van alle verzoeken vanaf één IP-adres leidt tot een IP-blokkering op de betreffende website.
✅ Rechts: Schakel slimme roterende proxy's in, zodat Zyte automatisch van IP-adres wisselt om detectie te voorkomen.
Fout nr. 2: Webscraping uitvoeren zonder robots.txt te controleren
❌ Fout: Het crawlen van pagina's die door de site-eigenaar zijn geblokkeerd, wat tijdrovend is om te herstellen en tot juridische problemen kan leiden.
✅ Rechts: Raadpleeg altijd de richtlijnen in robots.txt en identificeer de beperkte paden voordat u begint met verantwoord webscrapen.
Fout nr. 3: Foutafhandeling in je script
❌ Fout: Je kunt je scraper stilletjes laten crashen wanneer een webpagina een 403-fout of time-out retourneert.
✅ Rechts: Voeg foutafhandeling toe aan je code om HTTP-fouten te loggen en mislukte verzoeken automatisch opnieuw te proberen.
Probleemoplossing voor Zyte
Probleem: Verzoeken retourneren lege HTML-inhoud.
Oorzaak: De doelwebsite gebruikt JavaScript om content dynamisch te laden.
Repareren: Schakel browserrendering in voor je Zyte API-verzoek, zodat de pagina volledig laadt voordat de gegevens worden verzameld.
Probleem: De scraper wordt na een paar verzoeken geblokkeerd.
Oorzaak: De site detecteert herhaalde verzoeken vanaf hetzelfde IP-adres of dezelfde gebruikersagent.
Repareren: Schakel slimme proxyrotatie in en voeg aangepaste headers toe aan uw verzoeken om detectie door antibots te voorkomen.
Probleem: De geëxtraheerde gegevens bevatten ontbrekende of beschadigde velden.
Oorzaak: De doelwebsite heeft zijn lay-out gewijzigd, waardoor uw parser niet meer werkt.
Repareren: Schakel over naar Automatische extractie, zodat de AI zich aanpast aan lay-outwijzigingen zonder dat u uw code handmatig hoeft bij te werken.
📌 Opmerking: Als geen van deze oplossingen uw probleem verhelpt, neem dan contact op met de Zyte-support of gebruik de 24/7 chat voor hulp.
Wat is Zyte?
Zyte is een webscrapingplatform dat ontwikkelaars en datawetenschappers helpt om gegevens van websites te extraheren zonder handmatig IP-blokkeringen, proxy's of anti-botmaatregelen te hoeven omzeilen.
Zie het als een centraal punt voor al uw webdata-behoeften: één platform met meerdere tools voor elke scrapingtaak.
Bekijk dit korte overzicht:
Het omvat de volgende belangrijke kenmerken:
- AI-scraping: Gebruik AI om gestructureerde data van elke webpagina te extraheren zonder aangepaste parseercode.
- E-commerce data-extractie: Verzamel op grote schaal productgegevens van webwinkels.
- Gegevens voor AI-agent: Voer schone, gestructureerde datasets rechtstreeks in AI-modellen.
- Zyte API: Integreer web scraping in je eigen code met ingebouwde bescherming tegen blokkeringen.
- Nieuws- en artikelgegevens extraheren: Haal nieuwsartikelen op met volledige tekst en metadata.
- Jobgegevens scrapen: Verzamel gestructureerde vacatures van carrièrewebsites.
- Extractie van vastgoedgegevens: Verzamel vastgoedadvertenties met prijs- en locatiegegevens.
- Socialmedia-scraper: Verzamel openbare berichten en profielgegevens voor analyse.
- Schaalbare cloudhosting: Voer scrapingtaken uit op een automatisch schaalbare infrastructuur.
Voor een volledige recensie, zie onze Zyte-recensie.
Zyte is een logische keuze voor elk team dat op grote schaal webpagina's moet verzamelen zonder proxies te hoeven beheren of zelf parsers te hoeven schrijven.
Zyte-prijzen
Dit zijn de kosten van Zyte in 2026:
Zyte hanteert een prijsmodel waarbij per verzoek wordt betaald, afhankelijk van de complexiteit van de website.
Geëxtraheerde HTTP-respons — Prijs per 1.000 aanvragen
| Websiteniveau | Betalen per gebruik | $100 Plan | Plan van $500 |
|---|---|---|---|
| Niveau 1 | $0.40 | $0.30 | $0.19 |
| Niveau 2 | $0.50 | $0.37 | $0.24 |
| Niveau 3 | $0.70 | $0.52 | $0.33 |
| Niveau 4 | $0.97 | $0.72 | $0.46 |
| Niveau 5 | $1.53 | $1.15 | $0.73 |
Geëxtraheerde browserverzoeken — Prijs per 1.000 verzoeken
| Websiteniveau | Betalen per gebruik | $100 Plan | Plan van $500 |
|---|---|---|---|
| Niveau 1 | $1.80 | $1.35 | $0.85 |
| Niveau 2 | $2.80 | $2.10 | $1.33 |
| Niveau 3 | $4.80 | $3.59 | $2.27 |
| Niveau 4 | $8.79 | $6.59 | $4.17 |
| Niveau 5 | $16.78 | $12.58 | $7.96 |
Gratis proefperiode: Ja, nieuwe accounts krijgen gratis tegoed om het platform te testen.
Geld-terug-garantie: Nee, credits worden niet terugbetaald zodra ze zijn gebruikt.
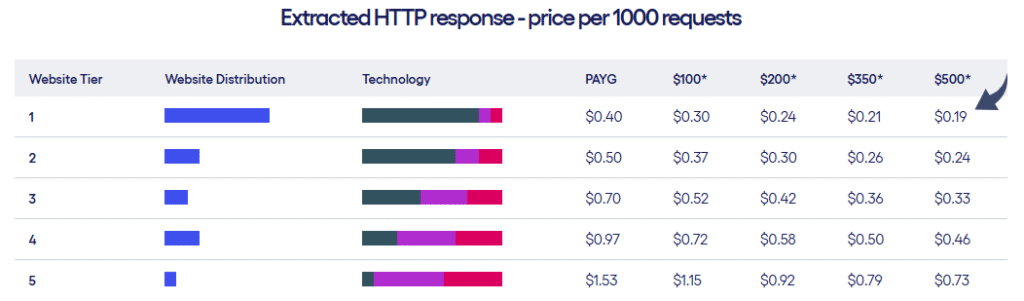
💰 Beste prijs-kwaliteitverhouding: Het abonnement van $500 op niveau 1 — u krijgt de laagste prijs per aanvraag: $0,19 voor HTTP en $0,85 voor extractie uit de browser.
Zyte versus alternatieven
Hoe verhoudt Zyte zich tot de concurrentie? Dit is het concurrentielandschap:
| Hulpmiddel | Het beste voor | Prijs | Beoordeling |
|---|---|---|---|
| Zyte | Full-stack web scraping | $0,19+/1K vereist | ⭐ 4,5 |
| Apify | Voorgebouwde scraping-actoren | $49/maand | ⭐ 4.6 |
| ScrapeGraphAI | AI-gestuurde grafiekscraping | Gratis/Open Source | ⭐ 4.3 |
| Bright Data | Proxy-netwerken voor bedrijven | $500+/maand | ⭐ 4,5 |
| Blader door AI | Web scraping zonder code | $49/maand | ⭐ 4.4 |
| Schraperbij | Eenvoudige API-scraping | $49/maand | ⭐ 4.4 |
| Oxylabs | Residentiële volmachten | $99/maand | ⭐ 4,5 |
| ThorData | Budget proxy rotatie | $15/maand | ⭐ 4.2 |
| Webscraper | Browser-extensie scraping | Gratis/$50/maand | ⭐ 4.3 |
| Heliumschraper | Desktop visuele scraping | $99 eenmalig | ⭐ 4.1 |
| Brandweerkruipen | LLM-geschikte data-extractie | $19/maand | ⭐ 4.4 |
Snelle keuzes:
- Beste overall: Zyte regelt alles, van proxybeheer tot AI-extractie, in één platform.
- Beste budget: ScrapeGraphAI — open-source en gratis voor ontwikkelaars die volledige controle willen.
- Het meest geschikt voor beginners: Browse AI — een interface zonder code die webscraping toegankelijk maakt.
- Het meest geschikt voor bedrijven: Bright Data — een enorm proxynetwerk, speciaal ontworpen voor grootschalige operaties.
🎯 Alternatieven voor Zyte
Op zoek naar alternatieven voor Zyte? Dit zijn de beste opties:
- 🚀 Apify: Biedt honderden vooraf gebouwde actors voor veelvoorkomende scrapingtaken, met een royale gratis versie voor kleine projecten.
- 💰 ScrapeGraphAI: Open-source AI-scrapingbibliotheek voor Python-ontwikkelaars die volledige controle willen zonder abonnementskosten.
- 🏢 Heldere gegevens: Een proxy-netwerk van bedrijfsniveau met meer dan 72 miljoen IP-adressen en een compleet platform voor gegevensverzameling.
- 👶 Blader door AI: Een webscraper zonder programmeerkennis waarmee iedereen webgegevens kan extraheren door te klikken en te mikken — programmeren is niet nodig.
- ⚡ ScrapingBee: Een eenvoudige API die proxy's en headless browsers ondersteunt, zodat je met één enkele HTTP-aanvraag gegevens kunt scrapen.
- 🔒 Oxylabs: Hoogwaardige proxy's voor thuisgebruik en datacenters, gecombineerd met een webscraping-API voor grootschalige dataverzameling.
- 🔥 ThorData: Een budgetvriendelijke proxy-service met een solide rotatie en goede dekking voor prijsbewuste teams.
- 🔧 Webscraper: Gratis browserextensie waarmee je visueel webscrapers kunt bouwen in Chrome — ideaal voor snelle klussen.
- 🧠 Heliumschraper: Desktop-app voor visueel scrapen met een eenmalige aanschafprijs en zonder terugkerende kosten.
- 🌟 Firecrawl: Zet elke website om in LLM-compatibele data met overzichtelijke markdown-output — speciaal ontwikkeld voor AI-workflows.
Voor de volledige lijst, zie onze Alternatieven voor Zyte gids.
⚔️ Zyte vergeleken
Hieronder een vergelijking van Zyte met de concurrenten:
- Zyte versus Apify: Zyte wint op het gebied van anti-ban-technologie en beheerde proxies. Apify wint op het gebied van vooraf gebouwde scraping-actoren en een marktplaats.
- Zyte versus ScrapeGraphAI: Zyte wordt volledig beheerd en ondersteund. ScrapeGraphAI is gratis, maar vereist meer configuratie door de ontwikkelaar.
- Zyte versus Bright Data: Beide bedrijven bieden tools van enterprise-niveau. Bright Data heeft meer proxy's, terwijl Zyte betere AI-extractie biedt.
- Zyte versus Browse AI: Zyte is beter geschikt voor ontwikkelaars die code schrijven. Browse AI is de winnaar voor niet-technische gebruikers.
- Zyte versus ScrapingBee: Zyte biedt uitgebreidere functies en Scrapy-integratie. ScrapingBee is eenvoudiger voor basis API-scraping.
- Zyte versus Oxylabs: Beide bedrijven blinken uit in proxyrotatie. Zyte voegt daar AI-extractie aan toe, terwijl Oxylabs zich richt op proxy-infrastructuur.
- Zyte versus ThorData: ThorData is goedkoper voor behoeften die alleen proxy's vereisen. Zyte bevat extractietools die verder gaan dan alleen proxies.
- Zyte versus webscraper: Web Scraper is gratis voor kleine taken. Zyte biedt cloudhosting voor grootschalige webscraping.
- Zyte versus Helium Scraper: Helium is een desktoptool met een eenmalige aanschafprijs. Zyte is cloudgebaseerd en schaalbaar tot miljoenen pagina's.
- Zyte versus Firecrawl: Firecrawl blinkt uit in LLM-compatibele output. Zyte bestrijkt een breder scala aan scraping-toepassingen.
Begin nu met het gebruik van Zyte.
Je hebt geleerd hoe je alle belangrijke functies van Zyte kunt gebruiken:
- ✅ AI-scraping
- ✅ Gegevensextractie voor e-commerce
- ✅ Gegevens voor AI-agent
- ✅ Zyte API
- ✅ Nieuws- en artikelgegevens extraheren
- ✅ Gegevens scrapen voor banen
- ✅ Gegevensextractie uit de vastgoedsector
- ✅ Sociale media scraper
- ✅ Schaalbare cloudhosting
Volgende stap: Kies één functie en probeer die nu uit.
De meeste mensen beginnen met AI-scraping.
Het duurt minder dan 5 minuten.
Veelgestelde vragen
Waarvoor wordt Zyte gebruikt?
Zyte is een webscrapingplatform waarmee je op grote schaal gegevens van websites kunt extraheren. Het platform biedt ondersteuning voor proxies, anti-banbeveiliging en data-extractie.
Is Zyte gratis te gebruiken?
Zyte biedt gratis credits aan voor nieuwe accounts. Daarna betaal je per verzoek, afhankelijk van je websiteabonnement en het type verzoek.
Werkt de Zyte API met Python?
Ja. De Zyte API werkt met Python en integreert direct met het Scrapy-framework via de scrapy-zyte-api-bibliotheek.
Hoe gaat Zyte om met IP-blokkeringen?
Zyte maakt gebruik van slimme, roterende proxy's die automatisch van IP-adres wisselen. Hierdoor wordt detectie door antibot-systemen op de doelwebsites voorkomen.
Kan Zyte pagina's met veel JavaScript scrapen?
Ja. Zyte ondersteunt browserrendering, waarbij JavaScript-content volledig wordt geladen voordat gegevens van de pagina worden geëxtraheerd.













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
