
เริ่มต้นใช้งานอย่างรวดเร็ว
คู่มือนี้ครอบคลุมทุกฟีเจอร์ของ Zyte:
- เริ่มต้นใช้งาน — สร้างบัญชีของคุณและทำการตั้งค่าเริ่มต้นให้เสร็จสมบูรณ์
- วิธีใช้งาน AI Scraping — ดึงข้อมูลที่มีโครงสร้างจากเว็บเพจใดก็ได้โดยไม่ต้องเขียนโค้ดเพิ่มเติม
- วิธีใช้งานการดึงข้อมูลอีคอมเมิร์ซ — รวบรวมข้อมูลผลิตภัณฑ์จากร้านค้าออนไลน์ในปริมาณมาก
- วิธีการใช้ข้อมูลสำหรับเอเจนต์ AI — จัดหาชุดข้อมูลที่สะอาดให้กับโมเดล AI และนักวิทยาศาสตร์ข้อมูล
- วิธีใช้งาน Zyte API — เพิ่มฟังก์ชันการดึงข้อมูลจากเว็บไซต์ลงในโค้ดของคุณผ่านจุดศูนย์กลางเพียงจุดเดียว
- วิธีใช้งานการดึงข้อมูลข่าวและบทความ — คัดลอกบทความข่าวและบทความบล็อกพร้อมดึงข้อความฉบับเต็ม
- วิธีใช้งานข้อมูลการดึงงาน (Job Scraping Data) — รวบรวมข้อมูลประกาศรับสมัครงานพร้อมระบุเงินเดือน ตำแหน่งงาน และชื่อบริษัท
- วิธีใช้งานการดึงข้อมูลอสังหาริมทรัพย์ — ดึงข้อมูลรายการอสังหาริมทรัพย์พร้อมราคาและรายละเอียดสถานที่ตั้ง
- วิธีใช้งานโปรแกรมดึงข้อมูลจากโซเชียลมีเดีย — รวบรวมข้อมูลโพสต์และข้อมูลโปรไฟล์จากโซเชียลมีเดียสาธารณะ
- วิธีใช้งานบริการคลาวด์โฮสติ้งที่ปรับขนาดได้ — เรียกใช้งานการดึงข้อมูลบนโครงสร้างพื้นฐานคลาวด์ที่ปรับขนาดได้อัตโนมัติ
ระยะเวลาที่ใช้: แต่ละฟีเจอร์ใช้เวลา 5 นาที
นอกจากนี้ในคู่มือนี้ยังมี: เคล็ดลับสำหรับมืออาชีพ | ข้อผิดพลาดที่พบบ่อย | การแก้ไขปัญหา | ความละเอียด | ตัวเลือกต่าง ๆ
เหตุใดจึงควรเชื่อถือคู่มือนี้
ฉันใช้ Zyte มานานกว่าหกเดือนแล้ว และได้ทดสอบทุกฟีเจอร์ที่กล่าวถึงในคู่มือนี้แล้ว คู่มือนี้มาจากประสบการณ์จริง ไม่ใช่คำโฆษณาชวนเชื่อหรือภาพหน้าจอจากผู้จำหน่าย

Zyte เป็นหนึ่งในตัวละครที่ทรงพลังที่สุด เครื่องมือดึงข้อมูลจากเว็บ พร้อมจำหน่ายแล้ววันนี้
แต่ผู้ใช้ส่วนใหญ่รู้จักเพียงแค่ส่วนน้อยของสิ่งที่มันทำได้เท่านั้น
คู่มือนี้จะแสดงวิธีใช้งานฟีเจอร์หลักทั้งหมด
ทีละขั้นตอน พร้อมภาพหน้าจอและเคล็ดลับจากมืออาชีพ
บทช่วยสอนการใช้งาน Zyte
คู่มือการใช้งาน Zyte ฉบับสมบูรณ์นี้จะแนะนำคุณทีละขั้นตอนเกี่ยวกับทุกฟีเจอร์ ตั้งแต่การตั้งค่าเริ่มต้นไปจนถึงเคล็ดลับขั้นสูงที่จะทำให้คุณเป็นผู้ใช้งานระดับมืออาชีพ
ไซท์
แปลงเว็บไซต์ใดๆ ให้เป็นโครงสร้าง ข้อมูล ภายในไม่กี่นาที Zyte จัดการการป้องกันการแบน การหมุนเวียนพร็อกซี และการแสดงผลเบราว์เซอร์ เพื่อให้นักพัฒนาสามารถมุ่งเน้นไปที่การค้นหาข้อมูลที่ถูกต้อง เริ่มทดลองใช้งานฟรีได้แล้ววันนี้
เริ่มต้นใช้งาน Zyte กันเถอะ
ก่อนใช้งานฟีเจอร์ใดๆ โปรดทำการตั้งค่าครั้งแรกนี้ให้เสร็จสมบูรณ์
ใช้เวลาประมาณ 3 นาที
ขั้นตอนที่ 1: สร้างบัญชีของคุณ
เข้าไปที่เว็บไซต์ของ Zyte แล้วคลิก "ลงทะเบียน"
กรอกอีเมลและสร้างรหัสผ่านเพื่อเข้าสู่ระบบ
✓ ด่าน: ตรวจสอบของคุณ จดหมายเข้า สำหรับอีเมลยืนยัน
ขั้นตอนที่ 2: เข้าสู่แดชบอร์ด
Zyte เป็นแพลตฟอร์มบนเว็บ ไม่จำเป็นต้องดาวน์โหลด
เข้าสู่ระบบด้วยบัญชีใหม่ของคุณและเปิดแดชบอร์ด
นี่คือหน้าตาของแดชบอร์ด:
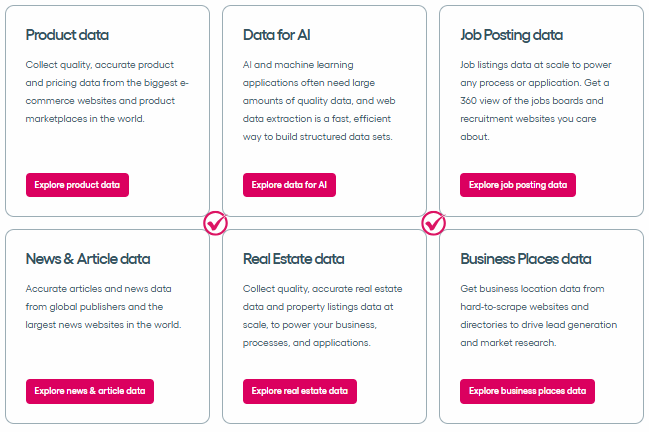
✓ ด่าน: คุณจะเห็นหน้าแดชบอร์ดหลักที่มีเครื่องมือต่างๆ แสดงอยู่หลายรายการ
ขั้นตอนที่ 3: รับคีย์ API ของคุณ
ไปที่การตั้งค่าบัญชีของคุณแล้วคัดลอกคีย์ API ของคุณ
ตัวอย่างเช่น คุณสามารถวางคีย์นี้ลงในสคริปต์ Python หรือไคลเอ็นต์ HTTP ใดก็ได้
✅ เสร็จเรียบร้อยแล้ว: คุณพร้อมที่จะใช้งานฟีเจอร์ต่างๆ ด้านล่างแล้ว
วิธีใช้งาน Zyte AI Scraping
การดึงข้อมูลด้วย AI ช่วยให้คุณดึงข้อมูลจากเว็บไซต์เป้าหมายใดก็ได้โดยใช้การวิเคราะห์ข้อมูลด้วย AI ซึ่งจัดการความซับซ้อนโดยอัตโนมัติ
นี่คือวิธีการใช้งานทีละขั้นตอน
ขั้นตอนที่ 1: เปิดเครื่องมือ AI Scraping
ล็อกอินเข้าสู่แดชบอร์ด Zyte ของคุณ แล้วเลือก AI Scraping
โปรแกรม AI สำหรับดึงข้อมูลจะอ่านเนื้อหา HTML และแปลงให้เป็นข้อมูลที่มีโครงสร้าง
ขั้นตอนที่ 2: ป้อน URL เป้าหมายของคุณ
วาง URL ของหน้าเว็บที่คุณต้องการดึงข้อมูลลงไป
นี่คือหน้าตาของมัน:
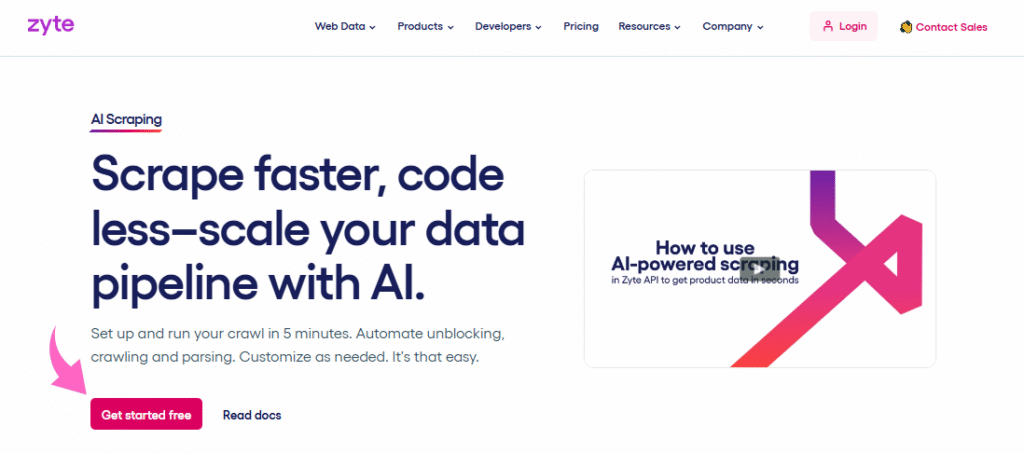
✓ ด่าน: คุณควรจะเห็นตัวอย่างของฟิลด์ที่แยกออกมาในรูปแบบ JSON
ขั้นตอนที่ 3: ตรวจสอบและดาวน์โหลดผลลัพธ์
ตรวจสอบข้อมูล JSON ที่ดึงออกมา แล้วส่งออกไฟล์ของคุณ
✅ ผลลัพธ์: คุณได้ดึงข้อมูลจากเว็บไซต์เป้าหมายได้อย่างแม่นยำแล้ว และตอนนี้คุณสามารถสร้างโปรเจ็กต์การดึงข้อมูลจากเว็บไซต์ใดๆ ก็ได้
💡 เคล็ดลับสำหรับมืออาชีพ: เริ่มต้นด้วยการทดสอบกับหน้าเว็บเพียงหน้าเดียวก่อนที่จะใช้งานในวงกว้างกับเว็บไซต์ทั้งหมด
วิธีใช้งาน Zyte Ecommerce Data Extraction
การดึงข้อมูลอีคอมเมิร์ซ ช่วยให้คุณรวบรวมข้อมูลผลิตภัณฑ์จากเว็บไซต์อีคอมเมิร์ซ รวมถึงราคา ชื่อสินค้า และรายละเอียดหมวดหมู่
นี่คือวิธีการใช้งานทีละขั้นตอน
ขั้นตอนที่ 1: เลือกการดึงข้อมูลอีคอมเมิร์ซ
เปิดแดชบอร์ดและเลือกเครื่องมือดึงข้อมูลอีคอมเมิร์ซ
เครื่องมือนี้ถูกสร้างขึ้นเพื่อจัดการกับหน้าสินค้าจากเว็บไซต์ช้อปปิ้งออนไลน์ชั้นนำต่างๆ
ขั้นตอนที่ 2: กำหนดค่าฟิลด์ผลิตภัณฑ์
เลือกข้อมูลเฉพาะที่คุณต้องการ — ราคา ชื่อสินค้า หรือหมวดหมู่
นี่คือหน้าตาของมัน:
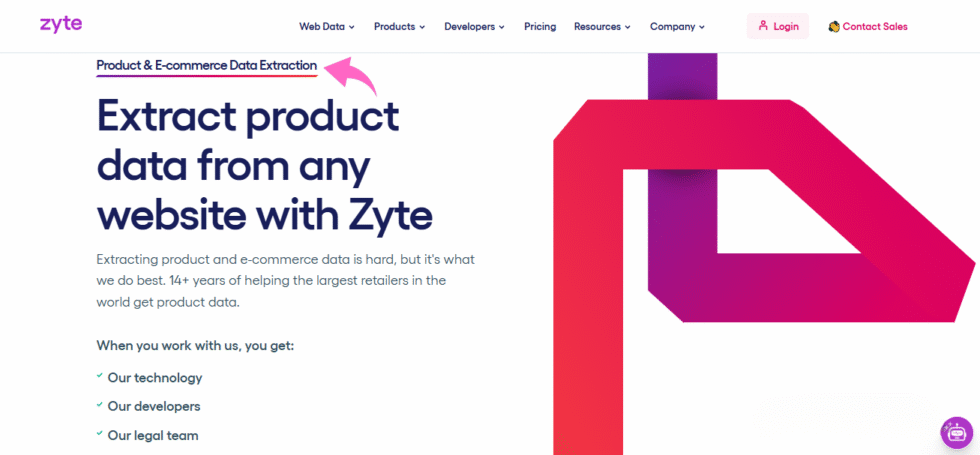
✓ ด่าน: คุณควรเห็นรายการสินค้าที่มีคอลัมน์ราคาและชื่อสินค้า
ขั้นตอนที่ 3: เรียกใช้งานและส่งออก
คลิกที่ปุ่ม "แตกไฟล์" เพื่อเริ่มการทำงานและดาวน์โหลดผลลัพธ์ในรูปแบบ JSON หรือ CSV
✅ ผลลัพธ์: ขณะนี้คุณมีข้อมูลผลิตภัณฑ์ที่มีโครงสร้างจากเว็บไซต์อีคอมเมิร์ซเป้าหมายของคุณแล้ว
💡 เคล็ดลับสำหรับมืออาชีพ: ใช้พารามิเตอร์ตำแหน่งทางภูมิศาสตร์ในคำขอของคุณเพื่อเปรียบเทียบราคาเฉพาะภูมิภาค
วิธีใช้งาน Zyte AI Agent
ข้อมูลสำหรับเอเจนต์ AI ช่วยให้คุณป้อนข้อมูลเว็บที่สะอาดโดยตรงไปยังโมเดล AI และนักวิทยาศาสตร์ข้อมูลเพื่อใช้ในการฝึกฝนหรือวิเคราะห์
นี่คือวิธีการใช้งานทีละขั้นตอน
ขั้นตอนที่ 1: เลือก Data Pipeline
เลือกตัวเลือก "ข้อมูลสำหรับเอเจนต์ AI" จากเมนูหลัก
นี่เป็นการเชื่อมต่อเอาต์พutของ API การดึงข้อมูลจากเว็บของคุณเข้ากับไปป์ไลน์ที่พร้อมใช้งาน AI
ขั้นตอนที่ 2: ตั้งค่าขอบเขตข้อมูลของคุณ
กำหนดขอบเขตของข้อมูลจากเว็บไซต์ที่คุณต้องการรวบรวม
นี่คือหน้าตาของมัน:
✓ ด่าน: ไปป์ไลน์ของคุณแสดงสถานะเชื่อมต่อแล้ว โดยมีข้อมูลไหลเวียนอยู่
ขั้นตอนที่ 3: ส่งออกไปยังเครื่องมือ AI ของคุณ
ส่งข้อมูลที่มีโครงสร้างไปยังแพลตฟอร์ม AI ที่คุณต้องการ
✅ ผลลัพธ์: คุณกำลังป้อนข้อมูลจากเว็บเข้าสู่เวิร์กโฟลว์ AI ของคุณโดยตรง
💡 เคล็ดลับสำหรับมืออาชีพ: ตั้งค่าการดึงข้อมูลแบบวนซ้ำเพื่อให้โมเดล AI ของคุณได้รับการฝึกฝนด้วยข้อมูลใหม่เสมอ
วิธีใช้งาน Zyte API
Zyte API ช่วยให้คุณสามารถผสานการดึงข้อมูลจากเว็บไซต์เข้ากับโค้ดของคุณเองได้ โดยใช้จุดเข้าใช้งาน API เพียงจุดเดียว พร้อมระบบป้องกันการแบน
นี่คือวิธีการใช้งานทีละขั้นตอน
ขั้นตอนที่ 1: รับคีย์ API ของคุณ
สมัครสมาชิกหรือเข้าสู่ระบบ จากนั้นคัดลอกคีย์ API ของ Zyte จากแดชบอร์ด
คีย์นี้เป็นจุดเริ่มต้นสำหรับทุกคำขอ API ที่คุณส่ง
ขั้นตอนที่ 2: ส่งคำขอแรกของคุณ
ใช้ Python หรือไลบรารี HTTP ใดก็ได้เพื่อส่งคำขอไปยังปลายทาง API
นี่คือหน้าตาของมัน:
✓ ด่าน: สคริปต์ของคุณส่งคืนสถานะ 200 พร้อมกับ HTML หรือ JSON ของหน้าเว็บ
ขั้นตอนที่ 3: วิเคราะห์คำตอบ
API จะส่งคืนเนื้อหา HTML หรือ JSON ที่มีโครงสร้าง ขึ้นอยู่กับการตั้งค่าของคุณ โปรดตรวจสอบออบเจ็กต์การตอบกลับแต่ละรายการเพื่อหาข้อผิดพลาด
✅ ผลลัพธ์: ตอนนี้คุณสามารถดึงข้อมูลจากเว็บไซต์โดยใช้โค้ดของคุณเองได้แล้ว
💡 เคล็ดลับสำหรับมืออาชีพ: จับคู่ API ของ Zyte กับเฟรมเวิร์ก Scrapy และไลบรารี scrapy-zyte-api เพื่อการรวบรวมข้อมูลขนาดใหญ่
วิธีใช้ Zyte Extract ข้อมูลข่าวและบทความ
ดึงข้อมูลข่าวและบทความ ช่วยให้คุณดึงบทความข่าวและเนื้อหาบล็อกได้โดยอัตโนมัติ ข้อความ และการดึงข้อมูลวันที่
นี่คือวิธีการใช้งานทีละขั้นตอน
ขั้นตอนที่ 1: เปิดโปรแกรมดึงข่าวสาร
ไปที่เมนูแล้วเลือก "ดึงข้อมูลข่าวสารและบทความ"
เครื่องมือนี้ได้รับการปรับแต่งมาเพื่อวิเคราะห์บทความข่าวจากเว็บไซต์สื่อต่างๆ
ขั้นตอนที่ 2: เพิ่ม URL แหล่งที่มา
วาง URL ของหน้าข่าวหรือฟีดข่าวที่คุณต้องการดึงข้อมูลลงไป
นี่คือหน้าตาของมัน:
✓ ด่าน: คุณจะเห็นชื่อบทความ วันที่ และตัวอย่างเนื้อหาในผลการค้นหา
ขั้นตอนที่ 3: ดาวน์โหลดข้อมูลบทความ
ดำเนินการแยกข้อมูลและส่งออกผลลัพธ์พร้อมชื่อเรื่อง วันที่ และข้อความฉบับเต็ม
✅ ผลลัพธ์: คุณมีบทความข่าวที่จัดโครงสร้างไว้แล้ว พร้อมสำหรับการวิเคราะห์หรือจัดเก็บ
💡 เคล็ดลับสำหรับมืออาชีพ: ใช้ตัวกรองหมวดหมู่เพื่อจำกัดผลลัพธ์เมื่อค้นหาในเว็บไซต์ข่าวขนาดใหญ่
วิธีใช้งาน Zyte Job Scraping เพื่อดึงข้อมูล
งานดึงข้อมูล ช่วยให้คุณรวบรวมประกาศรับสมัครงานจากเว็บไซต์หางานต่างๆ โดยใช้ฟิลด์ที่มีโครงสร้าง เช่น ตำแหน่งงาน บริษัท และเงินเดือน
นี่คือวิธีการใช้งานทีละขั้นตอน
ขั้นตอนที่ 1: เลือก Job Scraping
เปิดใช้งานฟังก์ชันการดึงข้อมูลงาน (Job Scraping Data) จากแผงเครื่องมือ
โปรแกรมดึงข้อมูลนี้จัดการกับรูปแบบเว็บไซต์หางานทั่วไปโดยอัตโนมัติ
ขั้นตอนที่ 2: กำหนดเกณฑ์การค้นหาของคุณ
ระบุชื่อตำแหน่งงาน สถานที่ หรือหมวดหมู่ที่คุณต้องการกำหนดเป้าหมาย
นี่คือหน้าตาของมัน:
✓ ด่าน: ตารางแสดงรายการตำแหน่งงานจะปรากฏขึ้นพร้อมช่องกรอกข้อมูลที่ร้องขอทั้งหมด
ขั้นตอนที่ 3: ส่งออกรายการประกาศรับสมัครงาน
ดาวน์โหลดข้อมูลในรูปแบบไฟล์ CSV หรือ JSON เพื่อตรวจสอบ
✅ ผลลัพธ์: คุณมีข้อมูลประกาศรับสมัครงานที่สะอาดและครบถ้วนสำหรับการวิจัยตลาดหรือการติดตามผล
💡 เคล็ดลับสำหรับมืออาชีพ: กำหนดให้มีการดึงข้อมูลรายสัปดาห์เพื่อติดตามประกาศรับสมัครงานใหม่และแนวโน้มเงินเดือนในช่วงเวลาต่างๆ
วิธีใช้งานโปรแกรมดึงข้อมูลอสังหาริมทรัพย์ Zyte
อสังหาริมทรัพย์ การดึงข้อมูล ช่วยให้คุณดึงข้อมูลรายชื่ออสังหาริมทรัพย์จากเว็บไซต์อสังหาริมทรัพย์ต่างๆ โดยใช้ช่องข้อมูลราคา สถานที่ และรายละเอียดต่างๆ
นี่คือวิธีการใช้งานทีละขั้นตอน
ขั้นตอนที่ 1: เปิดใช้งานการดึงข้อมูลอสังหาริมทรัพย์
เลือก "การดึงข้อมูลอสังหาริมทรัพย์" จากแดชบอร์ด
โมดูลนี้จะวิเคราะห์ข้อมูลหน้าแสดงรายการอสังหาริมทรัพย์จากเว็บไซต์อสังหาริมทรัพย์หลักๆ หลายแห่ง
ขั้นตอนที่ 2: กำหนดค่าฟิลด์คุณสมบัติ
เลือกข้อมูลที่คุณต้องการ — ราคา ที่อยู่ หรือพื้นที่ใช้สอย (ตารางฟุต)
นี่คือหน้าตาของมัน:
✓ ด่าน: รายการอสังหาริมทรัพย์จะแสดงพร้อมคอลัมน์ราคาและสถานที่ตั้ง
ขั้นตอนที่ 3: ส่งออกรายการสินค้า
ดาวน์โหลดผลลัพธ์ในรูปแบบที่คุณต้องการเพื่อทำการวิเคราะห์
✅ ผลลัพธ์: คุณได้จัดโครงสร้างข้อมูลอสังหาริมทรัพย์เพื่อใช้ในการวิเคราะห์การลงทุนแล้ว
💡 เคล็ดลับสำหรับมืออาชีพ: ใช้พร็อกซีที่มีการกำหนดเป้าหมายตามภูมิศาสตร์เพื่อเข้าถึงรายการอสังหาริมทรัพย์ที่จำกัดเฉพาะภูมิภาค
วิธีใช้งาน Zyte Social Media Scraper
โปรแกรมดึงข้อมูลจากโซเชียลมีเดีย ช่วยให้คุณรวบรวมข้อมูลโซเชียลมีเดียสาธารณะ รวมถึงโพสต์ โปรไฟล์ และตัวชี้วัดการมีส่วนร่วม
นี่คือวิธีการใช้งานทีละขั้นตอน
ขั้นตอนที่ 1: เลือกโปรแกรมดึงข้อมูลจากโซเชียลมีเดีย
เลือกเครื่องมือ Social Media Scraper จากเมนู
ส่วนนี้ใช้สำหรับจัดการโปรไฟล์สาธารณะและหน้าโพสต์ในทุกแพลตฟอร์ม
ขั้นตอนที่ 2: ป้อน URL โปรไฟล์หรือแฮชแท็ก
วาง URL ของหน้าเว็บสาธารณะหรือหัวข้อที่คุณต้องการดึงข้อมูลลงไป
นี่คือหน้าตาของมัน:
✓ ด่าน: โพสต์บนโซเชียลมีเดียจะแสดงพร้อมคอลัมน์ข้อความและการมีส่วนร่วม
ขั้นตอนที่ 3: ตรวจสอบและดาวน์โหลดข้อมูล
ตรวจสอบผลลัพธ์และส่งออกเป็นไฟล์ JSON หรือ CSV
✅ ผลลัพธ์: ขณะนี้คุณมีข้อมูลโซเชียลสาธารณะพร้อมสำหรับการวิเคราะห์แนวโน้มแล้ว การรายงาน.
💡 เคล็ดลับสำหรับมืออาชีพ: โปรดเคารพข้อจำกัดด้านอัตราการใช้งานและข้อกำหนดของเว็บไซต์เพื่อให้โปรแกรมดึงข้อมูลของคุณทำงานได้อย่างราบรื่น
วิธีใช้งาน Zyte Scalable Cloud Hosting
บริการโฮสติ้งบนคลาวด์ที่ปรับขนาดได้ ช่วยให้คุณสามารถรันงานดึงข้อมูลจากเว็บไซต์บนโครงสร้างพื้นฐานคลาวด์ที่ปรับขนาดได้ตามความต้องการข้อมูลเว็บของคุณ
นี่คือวิธีการใช้งานทีละขั้นตอน
ขั้นตอนที่ 1: เข้าถึงการตั้งค่าโฮสติ้งบนคลาวด์
เปิดส่วน "การโฮสต์บนคลาวด์ที่ปรับขนาดได้" ในบัญชีของคุณ
ส่วนนี้ใช้สำหรับจัดการทรัพยากรเซิร์ฟเวอร์สำหรับงานดึงข้อมูลของคุณ
ขั้นตอนที่ 2: ปรับใช้โปรแกรมดึงข้อมูลของคุณ
อัปโหลดสไปเดอร์หรือสคริปต์ของคุณ และเลือกระดับทรัพยากรที่คุณต้องการ
นี่คือหน้าตาของมัน:
✓ ด่าน: หน้าแดชบอร์ดงานของคุณจะแสดงสไปเดอร์ที่กำลังทำงานอยู่ พร้อมสถิติการใช้ทรัพยากร
ขั้นตอนที่ 3: ตรวจสอบและปรับขนาด
ติดตามความคืบหน้าของงานและปรับเปลี่ยนทรัพยากรตามความต้องการข้อมูลที่เพิ่มขึ้น
✅ ผลลัพธ์: ระบบการดึงข้อมูลจากเว็บไซต์ของคุณทำงานบนโครงสร้างพื้นฐานคลาวด์แบบจัดการได้ในทุกระดับ
💡 เคล็ดลับสำหรับมืออาชีพ: เริ่มต้นด้วยแผนขนาดเล็กก่อน แล้วค่อยขยายขนาดเมื่อคุณเข้าใจปริมาณคำขอที่แท้จริงของคุณแล้ว
เคล็ดลับและทางลัดสำหรับ Zyte Pro
หลังจากทดลองใช้ Zyte มานานกว่าหกเดือน นี่คือเคล็ดลับที่ดีที่สุดของฉัน
แป้นพิมพ์ลัด
| การกระทำ | ทางลัด |
|---|---|
| วิ่งแมงมุม | Ctrl + R |
| หยุดงานที่กำลังดำเนินการอยู่ | Ctrl + Shift + S |
| เปิดคอนโซลของ Zyte IDE | Ctrl + ` |
| ค้นหาไฟล์โครงการ | Ctrl + P |
คุณสมบัติที่ซ่อนอยู่ซึ่งคนส่วนใหญ่มองข้ามไป
- Zyte IDE: เขียน ทดสอบ และแก้ไขข้อผิดพลาดของสคริปต์เบราว์เซอร์โดยตรงในสภาพแวดล้อมบนเบราว์เซอร์ โดยไม่ต้องเปลี่ยนไปใช้โปรแกรมแก้ไขในเครื่อง
- การดึงข้อมูลอัตโนมัติ: เครื่องมือแยกข้อมูลที่ใช้ AI จะส่งคืนข้อมูล JSON ที่มีโครงสร้างโดยไม่ต้องเขียนโค้ดสำหรับการแยกวิเคราะห์ และปรับเปลี่ยนได้ตามการเปลี่ยนแปลงโครงสร้างของเว็บไซต์
- แชทกับเราได้ที่ ZyteBot: ใช้แชทในแอปกับ ZyteBot เพื่อรับคำตอบทันทีเกี่ยวกับการตั้งค่า ข้อผิดพลาด หรือคำถามเกี่ยวกับแนวทางปฏิบัติที่ดีที่สุด
ข้อผิดพลาดทั่วไปที่ควรหลีกเลี่ยงในการใช้ Zyte
ข้อผิดพลาดที่ 1: ละเลยการตั้งค่าการหมุนพร็อกซี
❌ ผิด: การส่งคำขอทั้งหมดจาก IP เดียว จะทำให้ IP นั้นถูกแบนบนเว็บไซต์เป้าหมาย
✅ ด้านขวา: เปิดใช้งานพร็อกซีหมุนเวียนอัจฉริยะเพื่อให้ Zyte สลับ IP โดยอัตโนมัติเพื่อหลีกเลี่ยงการตรวจจับ
ข้อผิดพลาดที่ 2: การดึงข้อมูลโดยไม่ตรวจสอบไฟล์ robots.txt
❌ ผิด: การรวบรวมข้อมูลจากหน้าเว็บที่เจ้าของเว็บไซต์บล็อกไว้ ซึ่งต้องใช้เวลานานในการแก้ไขและอาจก่อให้เกิดปัญหาทางกฎหมายได้
✅ ด้านขวา: ควรตรวจสอบหลักเกณฑ์ robots.txt และระบุเส้นทางที่ถูกจำกัดก่อนเริ่มใช้งานการดึงข้อมูลจากเว็บไซต์อย่างมีความรับผิดชอบเสมอ
ข้อผิดพลาดที่ 3: ไม่จัดการกับข้อผิดพลาดในสคริปต์ของคุณ
❌ ผิด: ตั้งค่าให้โปรแกรมดึงข้อมูลของคุณหยุดทำงานโดยไม่มีข้อความแจ้งเตือนเมื่อเว็บเพจส่งค่าตอบกลับเป็น 403 หรือหมดเวลา
✅ ด้านขวา: เพิ่มการจัดการข้อผิดพลาดในโค้ดของคุณเพื่อบันทึกข้อผิดพลาด HTTP และลองส่งคำขอที่ล้มเหลวซ้ำโดยอัตโนมัติ
การแก้ไขปัญหาของ Zyte
ปัญหา: คำขอส่งคืนเนื้อหา HTML ว่างเปล่า
สาเหตุ: เว็บไซต์เป้าหมายใช้ JavaScript ในการโหลดเนื้อหาแบบไดนามิก
แก้ไข: เปิดใช้งานการแสดงผลเบราว์เซอร์ในคำขอ API ของ Zyte เพื่อให้หน้าเว็บโหลดเสร็จสมบูรณ์ก่อนการดึงข้อมูล
ปัญหา: โปรแกรมดึงข้อมูลหยุดทำงานหลังจากส่งคำขอไปไม่กี่ครั้ง
สาเหตุ: เว็บไซต์ตรวจพบการร้องขอซ้ำจาก IP หรือ User Agent เดียวกัน
แก้ไข: เปิดใช้งานการหมุนเวียนพร็อกซีอัจฉริยะและเพิ่มส่วนหัวแบบกำหนดเองลงในคำขอของคุณเพื่อหลีกเลี่ยงการตรวจจับจากระบบป้องกันบอท
ปัญหา: ข้อมูลที่ดึงมามีข้อมูลที่ขาดหายหรือเสียหาย
สาเหตุ: เว็บไซต์เป้าหมายได้เปลี่ยนรูปแบบการแสดงผล ซึ่งทำให้โปรแกรมวิเคราะห์ข้อมูลของคุณทำงานผิดพลาด
แก้ไข: เปลี่ยนไปใช้การดึงข้อมูลอัตโนมัติ เพื่อให้ AI ปรับให้เข้ากับการเปลี่ยนแปลงเลย์เอาต์โดยไม่ต้องอัปเดตโค้ดด้วยตนเอง
📌 บันทึก: หากวิธีเหล่านี้ไม่สามารถแก้ไขปัญหาของคุณได้ โปรดติดต่อฝ่ายสนับสนุนของ Zyte หรือใช้บริการแชทตลอด 24 ชั่วโมงเพื่อขอความช่วยเหลือ
Zyte คืออะไร?
ไซท์ เป็นแพลตฟอร์มเว็บสแครปปิ้งที่ช่วยให้นักพัฒนาและนักวิทยาศาสตร์ข้อมูลสามารถดึงข้อมูลจากเว็บไซต์ได้โดยไม่ต้องจัดการกับการแบน IP, พร็อกซี หรือมาตรการป้องกันบอทด้วยตนเอง
ลองนึกภาพว่านี่คือศูนย์กลางสำหรับทุกความต้องการด้านข้อมูลบนเว็บของคุณ — แพลตฟอร์มเดียวที่มีเครื่องมือมากมายสำหรับทุกงานการดึงข้อมูล
ชมภาพรวมโดยย่อนี้:
ประกอบด้วยคุณสมบัติหลักดังต่อไปนี้:
- การดึงข้อมูลจาก AI: ใช้ AI ในการดึงข้อมูลที่มีโครงสร้างจากเว็บเพจใดๆ โดยไม่ต้องเขียนโค้ดแยกวิเคราะห์เอง
- การดึงข้อมูลอีคอมเมิร์ซ: รวบรวมข้อมูลผลิตภัณฑ์จากร้านค้าออนไลน์ในปริมาณมาก
- ข้อมูลสำหรับเอเจนต์ AI: ป้อนชุดข้อมูลที่สะอาดและมีโครงสร้างอย่างเป็นระเบียบให้กับโมเดล AI โดยตรง
- Zyte API: ผสานการดึงข้อมูลจากเว็บไซต์เข้ากับโค้ดของคุณเอง พร้อมระบบป้องกันการแบนในตัว
- ดึงข้อมูลข่าวและบทความ: ดึงบทความข่าวพร้อมข้อความเต็มและข้อมูลเมตา
- งานดึงข้อมูลจากโปรแกรม: รวบรวมรายละเอียดงานที่เป็นระบบจากเว็บไซต์หางานต่างๆ
- การดึงข้อมูลอสังหาริมทรัพย์: ดึงข้อมูลรายการอสังหาริมทรัพย์ที่มีราคาและสถานที่ตั้ง
- โปรแกรมดึงข้อมูลจากโซเชียลมีเดีย: รวบรวมข้อมูลโพสต์สาธารณะและข้อมูลโปรไฟล์เพื่อนำมาวิเคราะห์
- บริการโฮสติ้งบนคลาวด์ที่ปรับขนาดได้: เรียกใช้งานการดึงข้อมูลบนโครงสร้างพื้นฐานที่ปรับขนาดได้อัตโนมัติ
สำหรับรีวิวฉบับเต็ม โปรดดูที่หน้าของเรา รีวิว Zyte.
Zyte เหมาะสำหรับทีมใดก็ตามที่ต้องการรวบรวมหน้าเว็บจำนวนมากโดยไม่ต้องจัดการพร็อกซีหรือเขียนตัวแยกวิเคราะห์แบบกำหนดเองตั้งแต่เริ่มต้น
ราคาของ Zyte
นี่คือราคาของ Zyte ในปี 2026:
Zyte ใช้โมเดลการคิดราคาแบบจ่ายตามจำนวนคำขอ โดยอิงตามระดับความซับซ้อนของเว็บไซต์
ข้อมูลการตอบกลับ HTTP ที่ดึงมา — ราคาต่อ 1,000 คำขอ
| ระดับเว็บไซต์ | จ่ายตามการใช้งาน | แผน 100 ดอลลาร์ | แผน 500 ดอลลาร์ |
|---|---|---|---|
| ระดับ 1 | $0.40 | $0.30 | $0.19 |
| ระดับ 2 | $0.50 | $0.37 | $0.24 |
| ระดับ 3 | $0.70 | $0.52 | $0.33 |
| ระดับ 4 | $0.97 | $0.72 | $0.46 |
| ระดับ 5 | $1.53 | $1.15 | $0.73 |
จำนวนคำขอจากเบราว์เซอร์ที่ดึงออกมา — ราคาต่อ 1,000 คำขอ
| ระดับเว็บไซต์ | จ่ายตามการใช้งาน | แผน 100 ดอลลาร์ | แผน 500 ดอลลาร์ |
|---|---|---|---|
| ระดับ 1 | $1.80 | $1.35 | $0.85 |
| ระดับ 2 | $2.80 | $2.10 | $1.33 |
| ระดับ 3 | $4.80 | $3.59 | $2.27 |
| ระดับ 4 | $8.79 | $6.59 | $4.17 |
| ระดับ 5 | $16.78 | $12.58 | $7.96 |
ทดลองใช้งานฟรี: ใช่แล้ว บัญชีใหม่จะได้รับเครดิตฟรีเพื่อทดลองใช้แพลตฟอร์ม
รับประกันคืนเงิน: ไม่ค่ะ เครดิตที่ใช้ไปแล้วไม่สามารถขอคืนได้
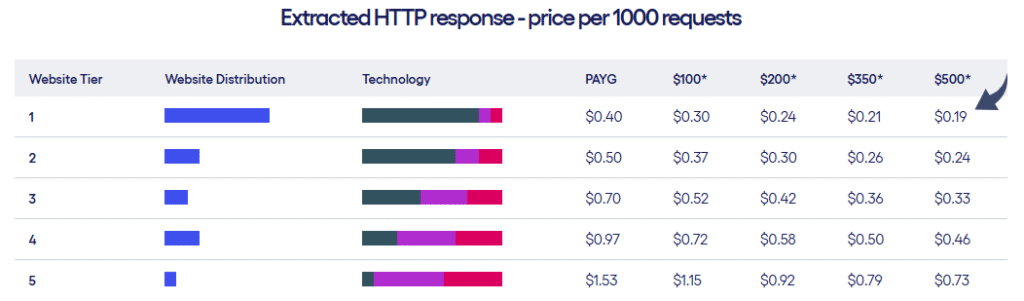
💰 คุ้มค่าที่สุด: แพ็กเกจ 500 ดอลลาร์สหรัฐฯ ระดับ 1 — คุณจะได้รับราคาต่อคำขอที่ต่ำที่สุดที่ 0.19 ดอลลาร์สหรัฐฯ สำหรับ HTTP และ 0.85 ดอลลาร์สหรัฐฯ สำหรับการดึงข้อมูลจากเบราว์เซอร์
Zyte เทียบกับตัวเลือกอื่นๆ
Zyte เป็นอย่างไรเมื่อเทียบกับคู่แข่ง? นี่คือภาพรวมของคู่แข่ง:
| เครื่องมือ | เหมาะสำหรับ | ราคา | การให้คะแนน |
|---|---|---|---|
| ไซท์ | การดึงข้อมูลจากเว็บแบบ Full-stack | $0.19+/1K ที่ต้องการ | ⭐ 4.5 |
| อะพิฟาย | นักแสดงการดึงข้อมูลที่สร้างไว้ล่วงหน้า | 49 ดอลลาร์/เดือน | ⭐ 4.6 |
| สแครปกราฟ AI | การดึงข้อมูลกราฟโดยใช้ AI | ฟรี/โอเพนซอร์ส | ⭐ 4.3 |
| ข้อมูลสดใส | เครือข่ายพร็อกซีระดับองค์กร | 500 ดอลลาร์ขึ้นไป/เดือน | ⭐ 4.5 |
| เรียกดู AI | การดึงข้อมูลจากเว็บโดยไม่ต้องเขียนโค้ด | 49 ดอลลาร์/เดือน | ⭐ 4.4 |
| สแครปปิ้งบี | การดึงข้อมูลจาก API อย่างง่าย | 49 ดอลลาร์/เดือน | ⭐ 4.4 |
| ออกซี่แล็บส์ | พร็อกซีที่อยู่อาศัย | 99 ดอลลาร์/เดือน | ⭐ 4.5 |
| ธอร์ดาต้า | การหมุนเวียนตัวแทนงบประมาณ | 15 ดอลลาร์/เดือน | ⭐ 4.2 |
| เว็บสแครปเปอร์ | การดึงข้อมูลจากส่วนขยายเบราว์เซอร์ | ฟรี/50 ดอลลาร์/เดือน | ⭐ 4.3 |
| เครื่องขูดฮีเลียม | การดึงข้อมูลภาพจากเดสก์ท็อป | ชำระครั้งเดียว 99 ดอลลาร์ | ⭐ 4.1 |
| ไฟร์ครอว์ล | การดึงข้อมูลที่พร้อมสำหรับ LLM | 19 ดอลลาร์/เดือน | ⭐ 4.4 |
ตัวเลือกที่น่าสนใจ:
- ดีที่สุดโดยรวม: Zyte — จัดการทุกอย่างตั้งแต่การจัดการพร็อกซีไปจนถึงการดึงข้อมูลด้วย AI ในแพลตฟอร์มเดียว
- งบประมาณที่ดีที่สุด: ScrapeGraphAI — ซอฟต์แวร์โอเพนซอร์สและใช้งานได้ฟรีสำหรับนักพัฒนาที่ต้องการควบคุมการทำงานอย่างเต็มที่
- เหมาะสำหรับผู้เริ่มต้น: Browse AI — อินเทอร์เฟซแบบไม่ต้องเขียนโค้ดที่ทำให้การดึงข้อมูลจากเว็บไซต์เป็นเรื่องง่าย
- เหมาะสำหรับองค์กรธุรกิจ: Bright Data — เครือข่ายพร็อกซีขนาดใหญ่ที่สร้างขึ้นเพื่อรองรับการดำเนินงานขนาดใหญ่
🎯 ทางเลือกอื่นนอกเหนือจาก Zyte
กำลังมองหาผลิตภัณฑ์อื่นแทน Zyte อยู่ใช่ไหม? นี่คือตัวเลือกที่ดีที่สุด:
- 🚀 อะพิฟาย: มี Actor สำเร็จรูปหลายร้อยตัวสำหรับงานดึงข้อมูลทั่วไป พร้อมแพ็กเกจฟรีที่คุ้มค่าสำหรับโปรเจกต์ขนาดเล็ก
- 💰 ScrapeGraphAI: ไลบรารีโอเพนซอร์สสำหรับ AI สแกนข้อมูล สำหรับนักพัฒนา Python ที่ต้องการควบคุมการทำงานอย่างเต็มที่โดยไม่ต้องเสียค่าสมัครสมาชิก
- 🏢 ข้อมูลอันสดใส: เครือข่ายพร็อกซีระดับองค์กรที่มี IP มากกว่า 72 ล้านรายการ และแพลตฟอร์มการเก็บรวบรวมข้อมูลแบบครบวงจร
- 👶 เรียกดู AI: โปรแกรมดึงข้อมูลเว็บแบบไม่ต้องเขียนโค้ด ที่ช่วยให้ทุกคนสามารถดึงข้อมูลจากเว็บไซต์ได้เพียงแค่ชี้และคลิก โดยไม่ต้องเขียนโปรแกรมใดๆ
- ⚡ ScrapingBee: API ที่ใช้งานง่าย รองรับพร็อกซีและเบราว์เซอร์แบบ Headless ช่วยให้คุณสามารถดึงข้อมูลได้ด้วยคำขอ HTTP เพียงครั้งเดียว
- 🔒 ออกซีแล็บส์: พร็อกซีระดับพรีเมียมสำหรับที่พักอาศัยและศูนย์ข้อมูล จับคู่กับ API สำหรับการดึงข้อมูลจากเว็บไซต์ เพื่อการรวบรวมข้อมูลขนาดใหญ่
- 🔥 ธอร์ดาต้า: บริการพร็อกซีราคาประหยัด พร้อมระบบหมุนเวียนที่แข็งแกร่ง และครอบคลุมพื้นที่ได้ดี เหมาะสำหรับทีมที่คำนึงถึงราคาเป็นหลัก
- 🔧 โปรแกรมดึงข้อมูลจากเว็บไซต์: ส่วนเสริมเบราว์เซอร์ฟรีที่ช่วยให้คุณสร้างโปรแกรมดึงข้อมูลแบบเห็นภาพได้ภายใน Chrome — เหมาะสำหรับงานด่วน
- 🧠 เครื่องขูดฮีเลียม: แอปพลิเคชันบนเดสก์ท็อปสำหรับการดึงข้อมูลด้วยภาพ โดยซื้อครั้งเดียวไม่มีค่าใช้จ่ายรายเดือน
- 🌟 ไฟร์ครอว์ล: แปลงเว็บไซต์ใดๆ ให้เป็นข้อมูลที่พร้อมใช้งานสำหรับ LLM ด้วยเอาต์พุต Markdown ที่สะอาดตา — สร้างขึ้นเพื่อเวิร์กโฟลว์ AI
ดูรายชื่อทั้งหมดได้ที่หน้าของเรา ทางเลือกอื่นนอกเหนือจาก Zyte แนะนำ.
⚔️ เปรียบเทียบ Zyte
ต่อไปนี้คือการเปรียบเทียบ Zyte กับคู่แข่งแต่ละราย:
- Zyte เทียบกับ Apify: Zyte ชนะเลิศในด้านเทคโนโลยีป้องกันการแบนและพร็อกซีแบบจัดการได้ ส่วน Apify ชนะเลิศในด้านตัวดึงข้อมูลสำเร็จรูปและตลาดกลาง
- Zyte เทียบกับ ScrapeGraphAI: Zyte เป็นระบบที่มีการจัดการอย่างเต็มรูปแบบพร้อมการสนับสนุน ส่วน ScrapeGraphAI นั้นฟรี แต่ต้องมีการตั้งค่าเพิ่มเติมจากนักพัฒนา
- Zyte เทียบกับ Bright Data: ทั้งสองบริษัทนำเสนอเครื่องมือระดับองค์กร Bright Data มีพร็อกซีมากกว่า ในขณะที่ Zyte มีความสามารถในการแยกข้อมูลด้วย AI ที่ดีกว่า
- Zyte เทียบกับ Browse AI: Zyte เหมาะสำหรับนักพัฒนาที่เขียนโค้ดมากกว่า ส่วน Browse AI เหมาะสำหรับผู้ใช้ที่ไม่เชี่ยวชาญด้านเทคนิค
- Zyte เทียบกับ ScrapingBee: Zyte มีฟีเจอร์ที่ครบครันกว่าและสามารถทำงานร่วมกับ Scrapy ได้ ในขณะที่ ScrapingBee นั้นใช้งานง่ายกว่าสำหรับการดึงข้อมูลจาก API ขั้นพื้นฐาน
- Zyte เทียบกับ Oxylabs: ทั้งสองบริษัทมีความเชี่ยวชาญด้านการหมุนเวียนพร็อกซี Zyte เพิ่มฟังก์ชันการดึงข้อมูลด้วย AI ในขณะที่ Oxylabs เน้นไปที่โครงสร้างพื้นฐานของพร็อกซี
- Zyte ปะทะ ThorData: ThorData มีราคาถูกกว่าสำหรับการใช้งานเฉพาะพร็อกซี ส่วน Zyte มีเครื่องมือแยกข้อมูลนอกเหนือจากพร็อกซีด้วย
- Zyte เทียบกับ Web Scraper: Web Scraper ใช้งานได้ฟรีสำหรับงานขนาดเล็ก ส่วน Zyte เหมาะสำหรับการดึงข้อมูลขนาดใหญ่ด้วยบริการโฮสติ้งบนคลาวด์
- เปรียบเทียบ Zyte กับ Helium Scraper: Helium เป็นเครื่องมือบนเดสก์ท็อปที่มีค่าใช้จ่ายเพียงครั้งเดียว ส่วน Zyte เป็นแบบคลาวด์และสามารถรองรับการใช้งานได้ถึงหลายล้านหน้า
- Zyte ปะทะ Firecrawl: Firecrawl โดดเด่นในเรื่องการสร้างเอาต์พุตที่พร้อมใช้งานสำหรับ LLM ในขณะที่ Zyte ครอบคลุมการใช้งานการดึงข้อมูลที่กว้างกว่า
เริ่มใช้งาน Zyte ได้เลยตอนนี้
คุณได้เรียนรู้วิธีการใช้งานฟีเจอร์หลักๆ ของ Zyte แล้ว:
- ✅ การดึงข้อมูลด้วย AI
- ✅ การดึงข้อมูลอีคอมเมิร์ซ
- ✅ ข้อมูลสำหรับเอเจนต์ AI
- ✅ Zyte API
- ✅ ดึงข้อมูลข่าวสารและบทความ
- ✅ งานดึงข้อมูล (Scraping Data)
- ✅ การดึงข้อมูลอสังหาริมทรัพย์
- ✅ โปรแกรมดึงข้อมูลจากโซเชียลมีเดีย
- ✅ บริการโฮสติ้งบนคลาวด์ที่ปรับขนาดได้
ขั้นตอนต่อไป: เลือกฟีเจอร์หนึ่งอย่างแล้วลองใช้ดูเลย
คนส่วนใหญ่เริ่มต้นด้วยการใช้ AI Scraping
ใช้เวลาน้อยกว่า 5 นาที
ถาม บ่อย ๆ
Zyte ใช้สำหรับอะไร?
Zyte เป็นแพลตฟอร์มสำหรับการดึงข้อมูลจากเว็บไซต์ ซึ่งช่วยให้คุณดึงข้อมูลจากเว็บไซต์ได้ในปริมาณมาก โดยมีระบบจัดการพร็อกซี การป้องกันการแบน และการดึงข้อมูลในตัว
Zyte ใช้งานได้ฟรีหรือไม่?
Zyte มอบเครดิตฟรีสำหรับบัญชีใหม่ หลังจากนั้น คุณจะต้องชำระค่าบริการต่อคำขอ โดยขึ้นอยู่กับระดับของเว็บไซต์และประเภทของคำขอ
Zyte API สามารถใช้งานร่วมกับ Python ได้หรือไม่?
ใช่แล้ว Zyte API สามารถใช้งานร่วมกับ Python และผสานรวมเข้ากับเฟรมเวิร์ก Scrapy โดยตรงผ่านไลบรารี scrapy-zyte-api
Zyte จัดการกับการแบน IP อย่างไร?
Zyte ใช้พร็อกซีหมุนเวียนอัจฉริยะที่สลับที่อยู่ IP โดยอัตโนมัติ ซึ่งจะช่วยหลีกเลี่ยงการตรวจจับโดยระบบป้องกันบอทบนเว็บไซต์เป้าหมาย
Zyte สามารถดึงข้อมูลจากหน้าเว็บที่มี JavaScript จำนวนมากได้หรือไม่?
ใช่ Zyte รองรับการแสดงผลบนเบราว์เซอร์ ซึ่งจะโหลดเนื้อหา JavaScript ให้สมบูรณ์ก่อนที่จะดึงข้อมูลจากหน้าเว็บ













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
