
Szybki start
W tym przewodniku omówiono wszystkie funkcje Zyte:
- Rozpoczęcie pracy — Utwórz konto i zakończ konfigurację początkową
- Jak korzystać ze scrapowania AI — Pobieraj ustrukturyzowane dane z dowolnej strony internetowej bez pisania niestandardowego kodu
- Jak korzystać z ekstrakcji danych e-commerce — Zbieraj dane o produktach ze sklepów internetowych na dużą skalę
- Jak wykorzystać dane dla agenta AI — Dostarczaj czyste zestawy danych modelom AI i naukowcom zajmującym się danymi
- Jak korzystać z API Zyte — Dodaj scrapowanie stron internetowych do swojego kodu za pomocą jednego centralnego punktu
- Jak korzystać z funkcji Ekstrakcja danych z wiadomości i artykułów — Zbieraj artykuły prasowe i wpisy blogowe z pełną ekstrakcją tekstu
- Jak korzystać z danych pozyskiwanych z zadań scrapingowych — Zbierz oferty pracy z informacjami o wynagrodzeniu, stanowisku i firmie
- Jak korzystać z ekstrakcji danych o nieruchomościach — Wyodrębnij oferty nieruchomości ze szczegółami dotyczącymi cen i lokalizacji
- Jak korzystać z narzędzia Social Media Scraper — Zbieraj publiczne posty w mediach społecznościowych i dane profilowe
- Jak korzystać ze skalowalnego hostingu w chmurze — Uruchamiaj zadania scrapowania w infrastrukturze chmurowej z automatycznym skalowaniem
Czas potrzebny: 5 minut na każdy film
Również w tym przewodniku: Profesjonalne porady | Typowe błędy | Rozwiązywanie problemów | Wycena | Alternatywy
Dlaczego warto zaufać temu przewodnikowi
Korzystam z Zyte od ponad sześciu miesięcy i przetestowałem każdą funkcję opisaną w tym poradniku. Ten samouczek opiera się na prawdziwych doświadczeniach praktycznych — nie na marketingowym bełkocie ani zrzutach ekranu od dostawców.

Zyte jest jednym z najpotężniejszych narzędzia do scrapowania stron internetowych dostępne już dziś.
Jednak większość użytkowników wykorzystuje zaledwie ułamek jego możliwości.
W tym przewodniku dowiesz się, jak korzystać ze wszystkich głównych funkcji.
Krok po kroku, ze zrzutami ekranu i profesjonalnymi poradami.
Samouczek Zyte
Ten kompletny samouczek Zyte przeprowadzi Cię przez wszystkie funkcje krok po kroku, od początkowej konfiguracji po zaawansowane wskazówki, które uczynią z Ciebie zaawansowanego użytkownika.
Zyte
Zmień dowolną witrynę internetową w ustrukturyzowaną dane w kilka minut. Zyte obsługuje ochronę przed banami, rotację serwerów proxy i renderowanie w przeglądarce, dzięki czemu programiści mogą skupić się na wyszukiwaniu odpowiednich danych. Rozpocznij bezpłatny okres próbny już dziś.
Rozpoczęcie pracy z Zyte
Przed użyciem jakiejkolwiek funkcji należy wykonać jednorazową konfigurację.
Zajmie to około 3 minuty.
Krok 1: Utwórz swoje konto
Wejdź na stronę Zyte i kliknij „Zarejestruj się”.
Podaj swój adres e-mail i utwórz hasło, aby się zalogować.
✓ Punkt kontrolny: Sprawdź swoje skrzynka odbiorcza aby otrzymać e-mail z potwierdzeniem.
Krok 2: Uzyskaj dostęp do pulpitu nawigacyjnego
Zyte to platforma internetowa — nie wymaga pobierania.
Zaloguj się na nowe konto i otwórz panel.
Oto jak wygląda pulpit nawigacyjny:
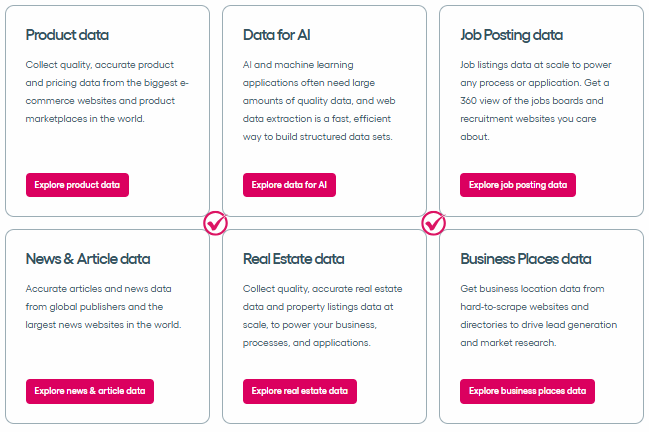
✓ Punkt kontrolny: Powinieneś zobaczyć główny panel z listą wielu narzędzi.
Krok 3: Uzyskaj klucz API
Przejdź do ustawień konta i skopiuj swój klucz API.
Możesz na przykład wkleić ten klucz do skryptu Pythona lub dowolnego klienta HTTP.
✅ Zrobione: Możesz już używać dowolnej funkcji poniżej.
Jak korzystać ze scrapowania Zyte AI
Scraping AI umożliwia wyodrębnienie danych z dowolnej witryny docelowej za pomocą analizy wspomaganej sztuczną inteligencją, która automatycznie radzi sobie ze złożonością.
Oto instrukcja krok po kroku, jak z niego korzystać.
Krok 1: Otwórz narzędzie do scrapowania AI
Zaloguj się do panelu Zyte i wybierz opcję AI Scraping.
Narzędzie AI odczytuje zawartość HTML i przekształca ją w ustrukturyzowane dane.
Krok 2: Wprowadź adres URL docelowy
Wklej adres URL strony, którą chcesz zeskrobać.
Oto jak to wygląda:
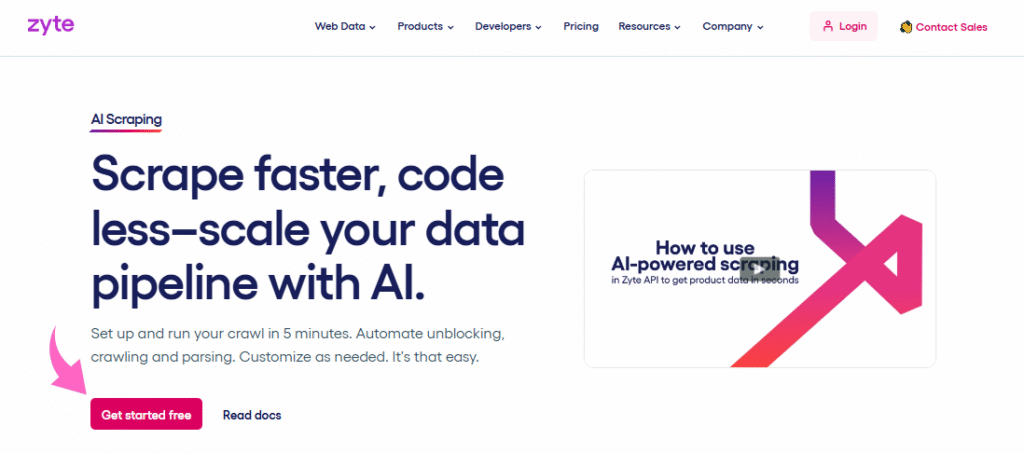
✓ Punkt kontrolny: Powinieneś zobaczyć podgląd wyodrębnionych pól w formacie json.
Krok 3: Przejrzyj i pobierz wyniki
Sprawdź wyodrębnioną odpowiedź JSON i wyeksportuj plik.
✅ Wynik: Dokładnie wyodrębniłeś dane ze swojej docelowej witryny i możesz teraz utworzyć dowolny projekt scrapowania stron internetowych.
💡 Wskazówka: Zacznij od przetestowania pojedynczej strony, a następnie przetestuj ją na całej witrynie.
Jak korzystać z ekstrakcji danych e-commerce w Zyte
Ekstrakcja danych e-commerce umożliwia zbieranie danych o produktach z witryn e-commerce, w tym cen, tytułów i szczegółów kategorii.
Oto instrukcja krok po kroku, jak z niego korzystać.
Krok 1: Wybierz ekstrakcję e-commerce
Otwórz pulpit nawigacyjny i wybierz narzędzie do ekstrakcji danych e-commerce.
Narzędzie to zostało stworzone do obsługi stron produktów z największych witryn zakupowych.
Krok 2: Skonfiguruj pola produktu
Wybierz konkretne informacje, których potrzebujesz — cenę, tytuł lub kategorię.
Oto jak to wygląda:
✓ Punkt kontrolny: Powinny zostać wyświetlone listy produktów z kolumnami ceny i tytułu.
Krok 3: Uruchom i eksportuj
Kliknij „Wyodrębnij”, aby rozpocząć zadanie i pobrać wyniki w formacie JSON lub CSV.
✅ Wynik: Masz teraz ustrukturyzowane dane o produktach ze swoich docelowych witryn e-commerce.
💡 Wskazówka: Użyj parametrów geolokalizacji w swoich zapytaniach, aby porównać ceny w poszczególnych regionach.
Jak korzystać z agenta Zyte AI
Dane dla agenta AI umożliwia przekazywanie czystych danych internetowych bezpośrednio do modeli AI i naukowców zajmujących się danymi w celu ich szkolenia lub analizy.
Oto instrukcja krok po kroku, jak z niego korzystać.
Krok 1: Wybierz kanał danych
Wybierz opcję Dane dla agenta AI z menu głównego.
Łączy dane wyjściowe interfejsu API web scrapingu z procesami gotowymi na obsługę sztucznej inteligencji.
Krok 2: Ustaw zakres danych
Określ zakres danych ze stron internetowych, które chcesz zbierać.
Oto jak to wygląda:
✓ Punkt kontrolny: Twój kanał pokazuje połączony status z przepływającymi danymi.
Krok 3: Eksportuj do swojego narzędzia AI
Wyślij ustrukturyzowane dane wyjściowe na preferowaną platformę AI.
✅ Wynik: Wprowadzasz dane internetowe bezpośrednio do swoich przepływów pracy opartych na sztucznej inteligencji.
💡 Wskazówka: Zaplanuj cykliczne zadania ekstrakcji, aby Twoje modele AI zawsze uczyły się na nowych danych.
Jak korzystać z API Zyte
API Zyte umożliwia integrację web scrapingu z własnym kodem przy użyciu pojedynczego punktu wejścia do API z ochroną przed banami.
Oto instrukcja krok po kroku, jak z niego korzystać.
Krok 1: Uzyskaj klucz API
Zarejestruj się lub zaloguj, a następnie skopiuj klucz API Zyte z pulpitu nawigacyjnego.
Ten klucz stanowi punkt wejścia dla każdego żądania API.
Krok 2: Wyślij swoją pierwszą prośbę
Użyj języka Python lub dowolnej biblioteki HTTP, aby wysłać żądanie do punktu końcowego interfejsu API.
Oto jak to wygląda:
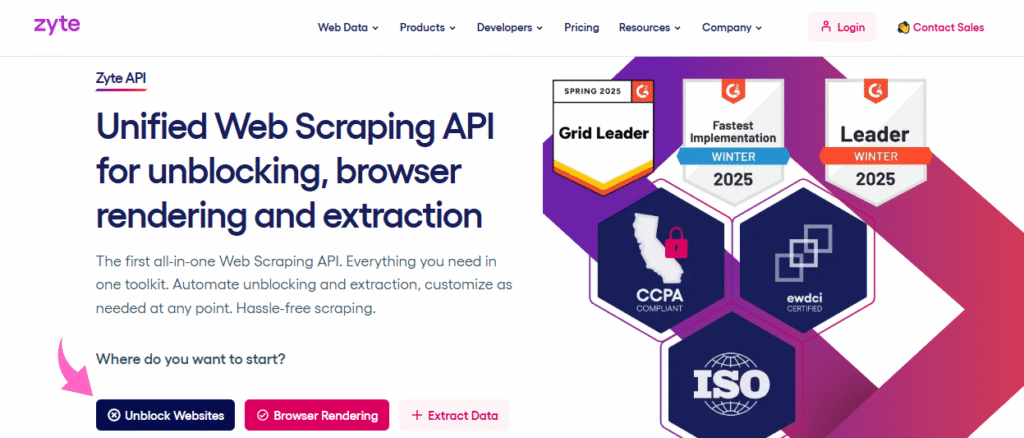
✓ Punkt kontrolny: Twój skrypt zwraca status 200 ze stroną html lub json.
Krok 3: Analiza odpowiedzi
Interfejs API zwraca zawartość HTML lub ustrukturyzowany kod JSON w zależności od ustawień — sprawdź każdy obiekt odpowiedzi pod kątem błędów.
✅ Wynik: Teraz możesz programowo wyodrębniać dane ze stron internetowych, używając własnego kodu.
💡 Wskazówka: Połącz interfejs API zyte z frameworkiem Scrapy i bibliotekami scrapy-zyte-api w celu umożliwienia indeksowania na dużą skalę.
Jak korzystać z ekstraktu Zyte – wiadomości i artykuły
Wyodrębnij dane z wiadomości i artykułów umożliwia automatyczne pobieranie artykułów informacyjnych i treści blogowych tekst i ekstrakcji dat.
Oto instrukcja krok po kroku, jak z niego korzystać.
Krok 1: Otwórz ekstraktor wiadomości
Przejdź do opcji Wyodrębnij dane wiadomości i artykułów w menu.
Narzędzie to jest przeznaczone do analizowania artykułów informacyjnych z serwisów medialnych.
Krok 2: Dodaj adresy URL źródła
Wklej adresy URL stron z wiadomościami lub kanałów, które chcesz pozyskać.
Oto jak to wygląda:
✓ Punkt kontrolny: W wynikach wyszukiwania zobaczysz tytuły artykułów, daty i podgląd tekstu.
Krok 3: Pobierz dane artykułu
Uruchom wyodrębnianie i eksportowanie wyników wraz z tytułem, datą i pełnym tekstem.
✅ Wynik: Posiadasz uporządkowane artykuły informacyjne gotowe do analizy lub archiwizacji.
💡 Wskazówka: Użyj filtrów kategorii, aby zawęzić wyniki podczas przeszukiwania dużych serwisów informacyjnych.
Jak korzystać z danych scrapowania zadań Zyte
Dane ze scrapowania zadań umożliwia zbieranie ofert pracy z serwisów poświęconych karierze zawodowej, z polami strukturalnymi, takimi jak stanowisko, firma i wynagrodzenie.
Oto instrukcja krok po kroku, jak z niego korzystać.
Krok 1: Wybierz opcję Scrapingu zadań
Otwórz funkcję Job Scraping Data z panelu narzędzi.
Ten program do automatycznego tworzenia szablonów ogłoszeń o pracę obsługuje najczęściej spotykane układy.
Krok 2: Zdefiniuj kryteria wyszukiwania
Wprowadź stanowisko, lokalizację lub kategorię, którą chcesz objąć wyszukiwaniem.
Oto jak to wygląda:
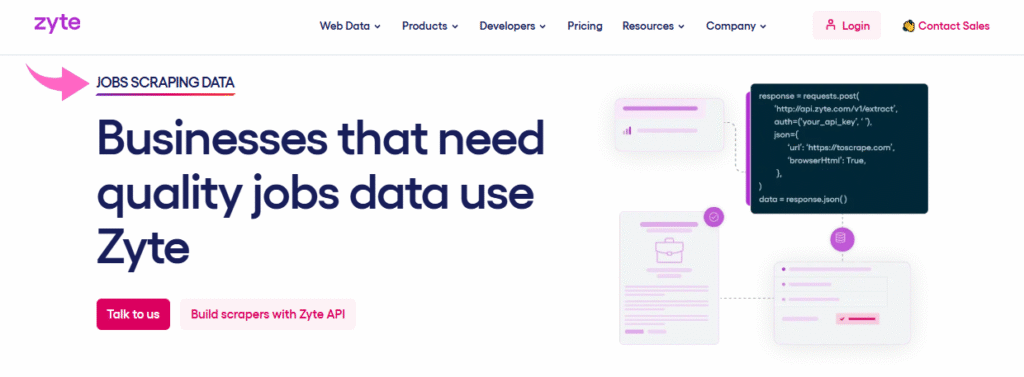
✓ Punkt kontrolny: Pojawi się tabela ofert pracy zawierająca wszystkie wymagane pola.
Krok 3: Eksportuj oferty pracy
Pobierz dane w postaci pliku csv lub json, aby je przejrzeć.
✅ Wynik: Posiadasz czyste dane dotyczące ofert pracy, które można wykorzystać do badań rynku lub śledzenia ofert.
💡 Wskazówka: Zaplanuj cotygodniowe skany, aby monitorować nowe ogłoszenia i trendy wynagrodzeń w czasie.
Jak korzystać z narzędzia Zyte Real Estate Data Extraction
Nieruchomość Ekstrakcja danych umożliwia pozyskiwanie ofert nieruchomości ze stron internetowych z ogłoszeniami o nieruchomościach, zawierających pola dotyczące ceny, lokalizacji i szczegółów.
Oto instrukcja krok po kroku, jak z niego korzystać.
Krok 1: Otwórz ekstrakcję nieruchomości
Wybierz opcję Ekstrakcja danych o nieruchomościach z pulpitu nawigacyjnego.
Ten moduł analizuje strony z ofertami nieruchomości na najważniejszych serwisach o nieruchomościach.
Krok 2: Skonfiguruj pola właściwości
Wybierz potrzebne Ci dane — cenę, adres lub powierzchnię w metrach kwadratowych.
Oto jak to wygląda:
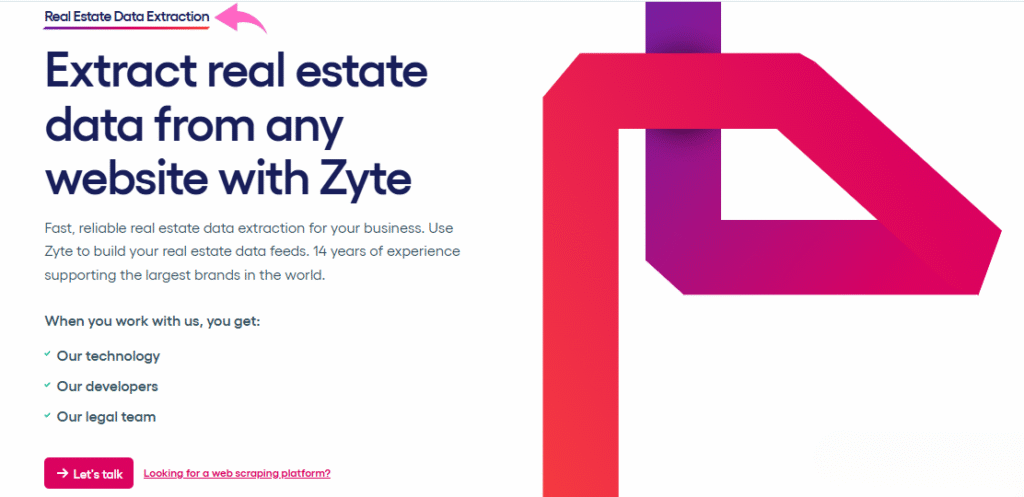
✓ Punkt kontrolny: Ogłoszenia nieruchomości są wyświetlane w kolumnach z ceną i lokalizacją.
Krok 3: Eksportuj oferty
Pobierz wyniki w preferowanym formacie w celu przeprowadzenia analizy.
✅ Wynik: Posiadasz ustrukturyzowane dane dotyczące nieruchomości na potrzeby analizy inwestycyjnej.
💡 Wskazówka: Użyj serwerów proxy z funkcją kierowania geograficznego, aby uzyskać dostęp do ofert nieruchomości zablokowanych regionalnie.
Jak korzystać z narzędzia Zyte Social Media Scraper
Scraper mediów społecznościowych umożliwia zbieranie publicznych danych z mediów społecznościowych, obejmujących posty, profile i wskaźniki zaangażowania.
Oto instrukcja krok po kroku, jak z niego korzystać.
Krok 1: Wybierz narzędzie do zbierania danych z mediów społecznościowych
Wybierz narzędzie Social Media Scraper z menu.
Zarządza publicznymi profilami i stronami postów na różnych platformach.
Krok 2: Wprowadź adresy URL profili lub hashtagów
Wklej adresy URL publicznych stron lub tematów, które chcesz zeskrobać.
Oto jak to wygląda:
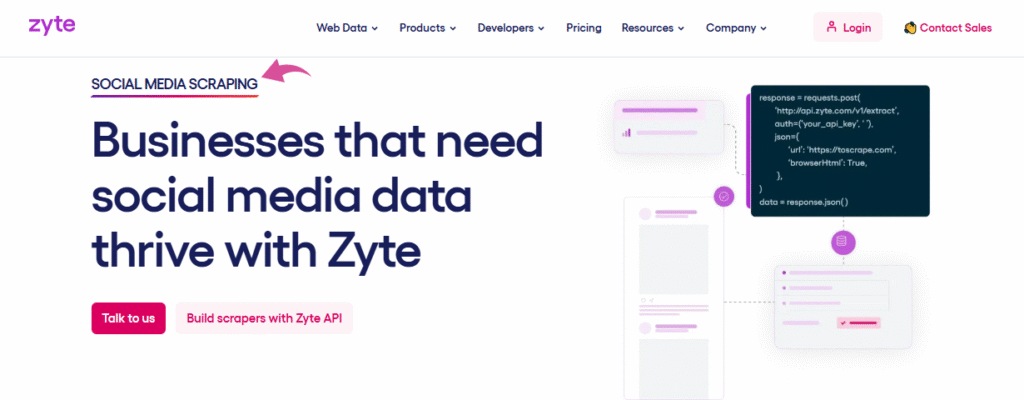
✓ Punkt kontrolny: Posty w mediach społecznościowych są wyświetlane wraz z kolumnami tekstu i zaangażowania.
Krok 3: Przejrzyj i pobierz dane
Sprawdź dane wyjściowe i wyeksportuj je jako plik json lub csv.
✅ Wynik: Masz teraz publiczne dane społecznościowe gotowe do analizy trendów lub raportowanie.
💡 Wskazówka: Przestrzegaj limitów szybkości i warunków witryny, aby zapewnić płynne działanie narzędzia do scrapowania.
Jak korzystać ze skalowalnego hostingu w chmurze Zyte
Skalowalny hosting w chmurze umożliwia wykonywanie zadań web scrapingu w infrastrukturze chmurowej, która dostosowuje się do Twoich potrzeb w zakresie danych internetowych.
Oto instrukcja krok po kroku, jak z niego korzystać.
Krok 1: Uzyskaj dostęp do ustawień hostingu w chmurze
Otwórz sekcję Skalowalny hosting w chmurze na swoim koncie.
W tym miejscu możesz zarządzać zasobami serwera dla zadań ekstrakcji.
Krok 2: Wdrażanie zadania scrapowania
Prześlij swojego spidera lub skrypt i wybierz poziom zasobów.
Oto jak to wygląda:
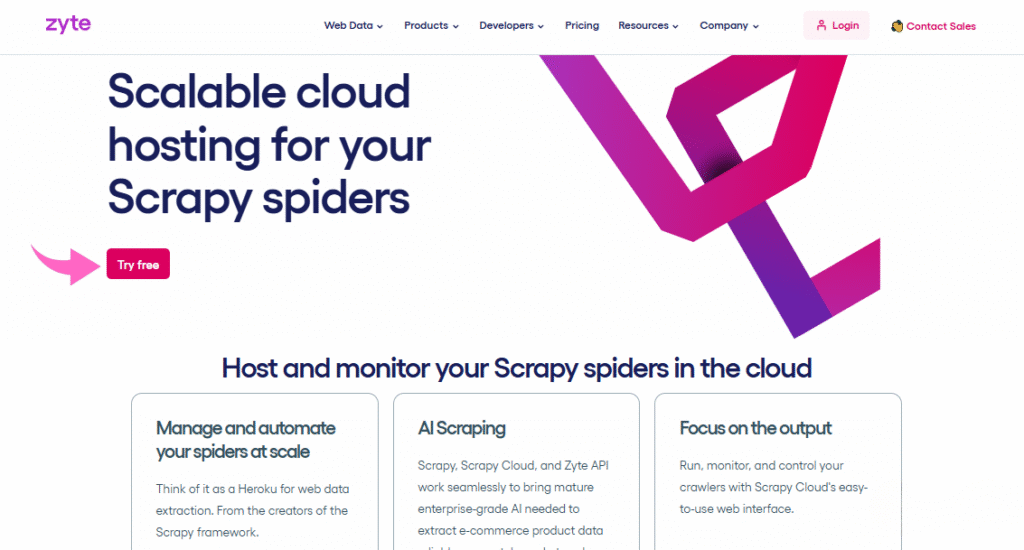
✓ Punkt kontrolny: Na pulpicie nawigacyjnym zadań wyświetlane są aktywne roboty ze statystykami wykorzystania zasobów.
Krok 3: Monitorowanie i skalowanie
Śledź postęp prac i dostosowuj zasoby w miarę wzrostu potrzeb w zakresie danych.
✅ Wynik: Twoje przetwarzanie stron internetowych odbywa się w oparciu o zarządzaną infrastrukturę chmurową bez względu na skalę.
💡 Wskazówka: Zacznij od mniejszego planu i zwiększ go dopiero, gdy poznasz faktyczną liczbę żądań.
Wskazówki i skróty dotyczące Zyte Pro
Oto moje najlepsze wskazówki po ponad sześciomiesięcznym testowaniu Zyte.
Skróty klawiaturowe
| Działanie | Skrót |
|---|---|
| Uruchom pająka | Ctrl + R |
| Zatrzymaj aktywne zadanie | Ctrl + Shift + S |
| Otwórz konsolę Zyte IDE | Ctrl + ` |
| Wyszukaj pliki projektu | Ctrl + P |
Ukryte funkcje, których większość ludzi nie dostrzega
- Środowisko IDE Zyte: Twórz, testuj i debuguj skrypty przeglądarki bezpośrednio w środowisku opartym na przeglądarce, bez konieczności przełączania się na lokalny edytor.
- Automatyczna ekstrakcja: Ekstraktor oparty na sztucznej inteligencji zwraca ustrukturyzowane dane JSON bez konieczności pisania kodu parsującego i dostosowuje się do zmian układu stron internetowych.
- Porozmawiaj z nami ZyteBot: Skorzystaj z czatu w aplikacji ZyteBot, aby uzyskać natychmiastowe odpowiedzi na pytania dotyczące konfiguracji, błędów lub najlepszych praktyk.
Typowe błędy, których należy unikać w przypadku Zyte
Błąd nr 1: Ignorowanie ustawień rotacji serwerów proxy
❌ Źle: Wysyłanie wszystkich żądań z jednego adresu IP, co powoduje zablokowanie adresów IP na stronie docelowej.
✅ Po prawej: Włącz inteligentne, rotacyjne serwery proxy, dzięki którym Zyte będzie automatycznie przełączać adresy IP, aby uniknąć wykrycia.
Błąd nr 2: Scraping bez sprawdzania pliku robots.txt
❌ Źle: Przeszukiwanie stron zablokowanych przez właściciela witryny, czego naprawa jest czasochłonna i może skutkować problemami prawnymi.
✅ Po prawej: Zawsze sprawdzaj wytyczne dotyczące pliku robots.txt i identyfikuj ścieżki, do których masz ograniczenia, zanim zaczniesz odpowiedzialnie scrapować strony internetowe.
Błąd nr 3: Brak obsługi błędów w skrypcie
❌ Źle: Pozwalając, aby Twój scraper automatycznie się zawiesił, gdy strona internetowa zwróci błąd 403 lub nastąpi przekroczenie limitu czasu.
✅ Po prawej: Dodaj obsługę błędów w swoim kodzie, aby rejestrować błędy HTTP i automatycznie ponawiać nieudane żądania.
Rozwiązywanie problemów z Zyte
Problem: żądania zwracają pustą zawartość HTML
Przyczyna: Strona docelowa używa JavaScript do dynamicznego ładowania treści.
Naprawić: Włącz renderowanie w przeglądarce w żądaniu API Zyte, aby strona w pełni załadowała się przed ekstrakcją.
Problem: Scraper blokuje się po kilku żądaniach
Przyczyna: Witryna wykrywa powtarzające się żądania z tego samego adresu IP lub agenta użytkownika.
Naprawić: Włącz inteligentną rotację serwerów proxy i dodaj niestandardowe nagłówki do swoich żądań, aby uniknąć wykrycia przez boty.
Problem: Wyodrębnione dane zawierają brakujące lub uszkodzone pola
Przyczyna: Docelowa strona zmieniła swój układ, co spowodowało awarię parsera.
Naprawić: Przełącz się na automatyczną ekstrakcję, aby sztuczna inteligencja dostosowywała się do zmian układu bez konieczności ręcznego aktualizowania kodu.
📌 Notatka: Jeśli żadna z powyższych metod nie pomoże Ci rozwiązać problemu, skontaktuj się z pomocą techniczną Zyte lub skorzystaj z czatu dostępnego 24 godziny na dobę, 7 dni w tygodniu, aby uzyskać pomoc.
Czym jest Zyte?
Zyte jest platformą do scrapowania stron internetowych, która pomaga programistom i naukowcom zajmującym się danymi wyodrębniać dane ze stron internetowych bez konieczności ręcznego stosowania blokad IP, serwerów proxy lub środków anty-bot.
Można to traktować jako centralny punkt dla wszystkich potrzeb związanych z danymi internetowymi — jedną platformę z wieloma narzędziami do każdego zadania związanego ze scrapowaniem.
Obejrzyj ten krótki przegląd:
Zawiera następujące kluczowe funkcje:
- Scraping AI: Użyj sztucznej inteligencji do wyodrębnienia ustrukturyzowanych danych z dowolnej strony internetowej bez konieczności stosowania niestandardowego kodu parsującego.
- Ekstrakcja danych e-commerce: Zbieraj na dużą skalę dane o produktach ze sklepów internetowych.
- Dane dla agenta AI: Przekaż czyste, ustrukturyzowane zbiory danych bezpośrednio do modeli AI.
- API Zyte: Zintegruj web scraping ze swoim kodem dzięki wbudowanej ochronie antybanowej.
- Wyodrębnij dane wiadomości i artykułów: Pobierz artykuły informacyjne w pełnym tekście i z metadanymi.
- Dane ze scrapowania zadań: Zbierz uporządkowane oferty pracy z serwisów poświęconych karierze zawodowej.
- Ekstrakcja danych o nieruchomościach: Wyszukaj oferty nieruchomości zawierające pola z cenami i lokalizacją.
- Scraper mediów społecznościowych: Zbieraj publiczne posty i dane profilowe do analizy.
- Skalowalny hosting w chmurze: Uruchamiaj zadania scrapowania w infrastrukturze skalowania automatycznego.
Aby zapoznać się z pełną recenzją, zobacz naszą Recenzja Zyte.
Zyte sprawdza się w przypadku każdego zespołu, który musi gromadzić strony internetowe na dużą skalę, bez konieczności zarządzania serwerami proxy lub pisania niestandardowych parserów od podstaw.
Cennik Zyte
Oto, ile kosztuje Zyte w 2026 roku:
Zyte korzysta z modelu cenowego „płatność za żądanie” opartego na stopniu złożoności witryny.
Wyodrębniona odpowiedź HTTP — cena za 1000 żądań
| Poziom witryny | Płać za zużycie | Plan za 100 dolarów | Plan 500 dolarów |
|---|---|---|---|
| Poziom 1 | $0.40 | $0.30 | $0.19 |
| Poziom 2 | $0.50 | $0.37 | $0.24 |
| Poziom 3 | $0.70 | $0.52 | $0.33 |
| Poziom 4 | $0.97 | $0.72 | $0.46 |
| Poziom 5 | $1.53 | $1.15 | $0.73 |
Wyodrębnione żądania przeglądarki — cena za 1000 żądań
| Poziom witryny | Płać za zużycie | Plan za 100 dolarów | Plan 500 dolarów |
|---|---|---|---|
| Poziom 1 | $1.80 | $1.35 | $0.85 |
| Poziom 2 | $2.80 | $2.10 | $1.33 |
| Poziom 3 | $4.80 | $3.59 | $2.27 |
| Poziom 4 | $8.79 | $6.59 | $4.17 |
| Poziom 5 | $16.78 | $12.58 | $7.96 |
Bezpłatny okres próbny: Tak — nowe konta otrzymują darmowe środki na testowanie platformy.
Gwarancja zwrotu pieniędzy: Nie — wykorzystane środki nie podlegają zwrotowi.
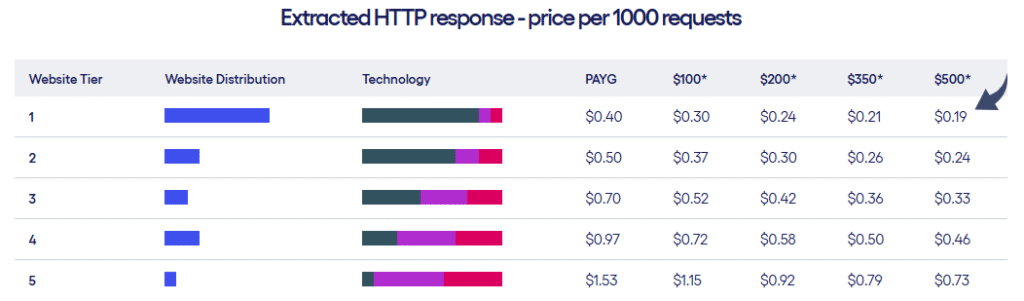
💰 Najlepszy stosunek jakości do ceny: Plan 500 USD w ramach poziomu 1 — otrzymujesz najniższą cenę za żądanie: 0,19 USD za protokół HTTP i 0,85 USD za ekstrakcję z przeglądarki.
Zyte kontra alternatywy
Jak wypada Zyte na tle konkurencji? Oto krajobraz konkurencyjny:
| Narzędzie | Najlepsze dla | Cena | Ocena |
|---|---|---|---|
| Zyte | Pełne scrapowanie sieci | 0,19 USD+/1 tys. wymagane | ⭐ 4,5 |
| Apify | Wstępnie zbudowani aktorzy scrapujący | 49 USD/mies. | ⭐ 4.6 |
| ScrapeGraphAI | Scraping grafów oparty na sztucznej inteligencji | Darmowe/otwarte oprogramowanie | ⭐ 4.3 |
| Jasne dane | Sieci proxy przedsiębiorstw | 500+ USD/mies. | ⭐ 4,5 |
| Przeglądaj AI | Scraping sieci bez kodu | 49 USD/mies. | ⭐ 4.4 |
| ScrapingBee | Proste scrapowanie API | 49 USD/mies. | ⭐ 4.4 |
| Oxylabs | Pełnomocnictwa mieszkaniowe | 99 USD/mies. | ⭐ 4,5 |
| ThorData | Rotacja zastępcza budżetu | 15 USD/mies. | ⭐ 4.2 |
| Web Scraper | Zbieranie rozszerzeń przeglądarki | Bezpłatnie/50 USD/mies. | ⭐ 4.3 |
| Skrobak helowy | Przeszukiwanie pulpitu pod kątem wizualnym | 99 dolarów jednorazowo | ⭐ 4.1 |
| Firecrawl | Ekstrakcja danych gotowa do uzyskania stopnia LLM | 19 USD/mies. | ⭐ 4.4 |
Szybkie typy:
- Najlepszy ogółem: Zyte — obsługuje wszystko, od zarządzania serwerami proxy po ekstrakcję sztucznej inteligencji, na jednej platformie.
- Najlepszy budżet: ScrapeGraphAI — oprogramowanie typu open source, bezpłatne dla programistów, którzy chcą mieć pełną kontrolę.
- Najlepsze dla początkujących: Browse AI — interfejs bez kodu umożliwiający dostęp do web scrapingu.
- Najlepsze dla przedsiębiorstw: Bright Data — ogromna sieć proxy stworzona na potrzeby operacji na dużą skalę.
🎯 Alternatywy dla Zyte
Szukasz alternatyw dla Zyte? Oto najlepsze opcje:
- 🚀 Apify: Oferuje setki gotowych aktorów do typowych zadań scrapowania, a także hojny bezpłatny pakiet dla małych projektów.
- 💰 ScrapeGraphAI: Biblioteka open-source do scrapowania AI dla programistów Python, którzy wolą pełną kontrolę bez opłat abonamentowych.
- 🏢 Jasne dane: Sieć proxy klasy korporacyjnej z ponad 72 milionami adresów IP i kompleksową platformą do gromadzenia danych.
- 👶 Przeglądaj AI: Narzędzie do scrapowania bez kodu, które umożliwia każdemu wyodrębnienie danych z sieci za pomocą wskaźnika i kliknięcia — bez konieczności kodowania.
- ⚡ ScrapingBee: Proste API obsługujące serwery proxy i przeglądarki bezgłowe, dzięki czemu można zeskrobywać dane za pomocą jednego żądania HTTP.
- 🔒 Oxylabs: Serwery proxy klasy premium do zastosowań domowych i w centrach danych, połączone z interfejsem API do scrapowania stron internetowych w celu gromadzenia danych na dużą skalę.
- 🔥 ThorData: Ekonomiczna usługa proxy z solidną rotacją i dobrym zasięgiem dla zespołów, którym zależy na cenie.
- 🔧 Web Scraper: Bezpłatne rozszerzenie przeglądarki umożliwiające wizualne tworzenie scraperów w Chrome — przydatne przy szybkich pracach.
- 🧠 Skrobak helowy: Aplikacja desktopowa do graficznego scrapowania, dostępna za jednorazową opłatą i bez opłat cyklicznych.
- 🌟 Firecrawl: Zamienia dowolną witrynę internetową w dane gotowe do LLM z czystym wyjściem w formacie Markdown — stworzone dla przepływów pracy AI.
Aby zobaczyć pełną listę, zobacz naszą Alternatywy dla Zyte przewodnik.
⚔️ Porównanie Zyte
Oto jak Zyte wypada na tle konkurencji:
- Zyte kontra Apify: Zyte wygrywa w dziedzinie technologii antybanowej i zarządzanych serwerów proxy. Apify wygrywa w dziedzinie gotowych aktorów scrapujących i rynku.
- Zyte kontra ScrapeGraphAI: Zyte jest w pełni zarządzalny i oferuje wsparcie. ScrapeGraphAI jest darmowy, ale wymaga dodatkowej konfiguracji dla programistów.
- Zyte kontra Bright Data: Oba oferują narzędzia klasy korporacyjnej. Bright Data oferuje więcej serwerów proxy, a Zyte oferuje lepszą ekstrakcję AI.
- Zyte kontra Browse AI: Zyte jest lepszy dla programistów piszących kod. Zobacz, jak AI sprawdza się w przypadku użytkowników nietechnicznych.
- Zyte kontra ScrapingBee: Zyte oferuje bardziej zaawansowane funkcje i integrację ze Scrapy. ScrapingBee jest prostszy do podstawowego scrapowania API.
- Zyte kontra Oxylabs: Obie firmy przodują w rotacji proxy. Zyte dodaje ekstrakcję AI, a Oxylabs koncentruje się na infrastrukturze proxy.
- Zyte kontra ThorData: ThorData jest tańszy w przypadku potrzeb związanych wyłącznie z proxy. Zyte oferuje narzędzia do ekstrakcji wykraczające poza same proxy.
- Zyte kontra Web Scraper: Web Scraper jest darmowy do małych zadań. Zyte obsługuje scrapowanie na dużą skalę dzięki hostingowi w chmurze.
- Zyte kontra skrobak helowy: Helium to narzędzie desktopowe, którego koszt jest jednorazowy. Zyte działa w chmurze i skaluje się do milionów stron.
- Zyte kontra Firecrawl: Firecrawl sprawdza się w przypadku wyników gotowych do LLM. Zyte obejmuje szerszy zakres zastosowań scrapowania.
Zacznij używać Zyte już teraz
Nauczyłeś się korzystać ze wszystkich głównych funkcji Zyte:
- ✅ Scraping AI
- ✅ Ekstrakcja danych e-commerce
- ✅ Dane dla agenta AI
- ✅ API Zyte
- ✅ Wyodrębnij dane z wiadomości i artykułów
- ✅ Zbieranie danych z zadań
- ✅ Ekstrakcja danych o nieruchomościach
- ✅ Scraper mediów społecznościowych
- ✅ Skalowalny hosting w chmurze
Następny krok: Wybierz jedną funkcję i wypróbuj ją teraz.
Większość ludzi zaczyna od scrapowania za pomocą sztucznej inteligencji.
Zajmie to mniej niż 5 minut.
Często zadawane pytania
Do czego służy Zyte?
Zyte to platforma do scrapowania stron internetowych, która pozwala na ekstrakcję danych ze stron internetowych na dużą skalę. Obsługuje serwery proxy, ochronę antybanową i ekstrakcję danych.
Czy korzystanie z Zyte jest darmowe?
Zyte oferuje darmowe kredyty dla nowych kont. Następnie płacisz za każde żądanie, w zależności od poziomu witryny i rodzaju żądania.
Czy API Zyte działa z Pythonem?
Tak. API Zyte współpracuje z Pythonem i integruje się bezpośrednio z frameworkiem Scrapy poprzez bibliotekę scrapy-zyte-api.
Jak Zyte radzi sobie z blokadami IP?
Zyte wykorzystuje inteligentne, rotacyjne serwery proxy, które automatycznie przełączają adresy IP. Pozwala to uniknąć wykrycia przez systemy anty-bot na docelowych stronach internetowych.
Czy Zyte może skanować strony zawierające dużo kodu JavaScript?
Tak. Zyte obsługuje renderowanie w przeglądarce, które wczytuje całą zawartość JavaScript przed wyodrębnieniem danych ze strony.













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
