
Início rápido
Este guia abrange todos os recursos do ScrapeGraphAI:
- Começando — Crie uma conta e adicione sua chave de API.
- Como usar o Smart Scraper — extrair dados estruturados de qualquer página usando um prompt de linguagem natural simples
- Como usar o Search Scraper — coletar dados da web diretamente dos resultados de pesquisa em tempo real sem precisar abrir cada link você mesmo
- Como usar o Markdownify — transformar conteúdo da web em Markdown limpo que os modelos de IA leiam sem ruídos adicionais
- Como usar o Agente Aranha — Rastrear várias páginas como um scraper multipágina para projetos de scraping maiores
- Como usar a Extração Universal de Dados — Lidar com diversas tarefas de extração de dados, incluindo dados de produtos, artigos de notícias e muito mais.
- Como usar as integrações fáceis — Conecte os dados extraídos aos seus modelos de ciência de dados e aprendizado de máquina em minutos
- Como usar o Smart Agent Scraper — leia conteúdo dinâmico em sites com uso intensivo de JavaScript que não funcionam com scrapers tradicionais
- Como usar o Agendador de Tarefas — execute operações de raspagem de dados de forma programada para que a extração se repita automaticamente.
- Como usar a interface simples — Utilize o ScrapeGraphAI de forma eficaz a partir de um painel de controle sem código, mesmo sem conhecimento técnico aprofundado.
Tempo necessário: 5 minutos por filme
Neste guia também: Dicas profissionais | Erros comuns | Solução de problemas | Preços | Alternativas
Por que confiar neste guia?
Eu utilizei o ScrapeGraphAI e testei pessoalmente todos os recursos descritos neste tutorial de como usar o ScrapeGraphAI.
Este guia passo a passo sobre como usar o ScrapeGraphAI é baseado em projetos reais de raspagem de dados, não em capturas de tela do fornecedor.

O ScrapeGraphAI é uma ferramenta com inteligência artificial que transforma a web desorganizada em um site eficiente. dados em dados estruturados rapidamente.
Ele usa modelos de linguagem complexos para ler páginas da mesma forma que uma pessoa faria.
Essa abordagem inteligente de web scraping ajuda você a simplificar a extração de dados da web em diversas tarefas.
A seguir, explico cada uma das principais funcionalidades passo a passo, com capturas de tela e dicas profissionais.
Tutorial do ScrapeGraphAI
Este tutorial sobre como usar o ScrapeGraph AI orienta você em todo o processo de coleta de dados, desde a configuração até a extração avançada de dados.
ScrapeGraph AI
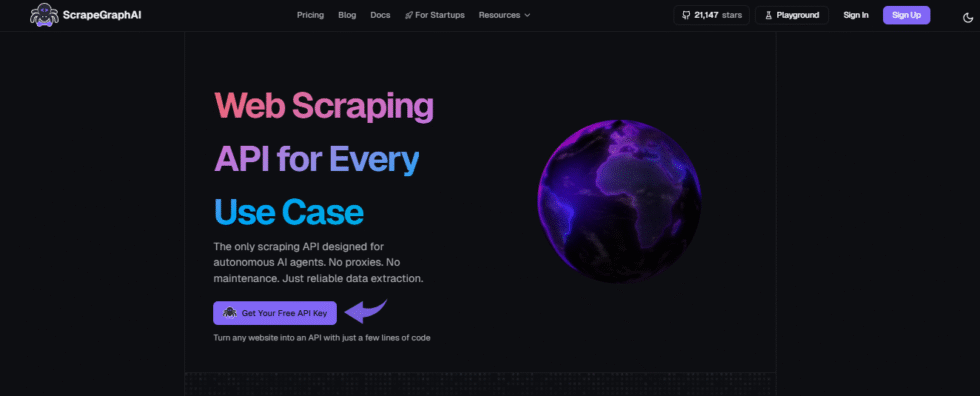
Transforme qualquer site em dados limpos e estruturados com comandos em linguagem natural. O ScrapeGraphAI combina grandes modelos de linguagem com lógica gráfica direta para extrair dados rapidamente. Comece gratuitamente, sem necessidade de cartão de crédito.
Primeiros passos com o ScrapeGraphAI
Antes de utilizar qualquer funcionalidade, conclua este processo de configuração única.
Veja primeiro esta breve visão geral:
Agora vamos analisar cada etapa.
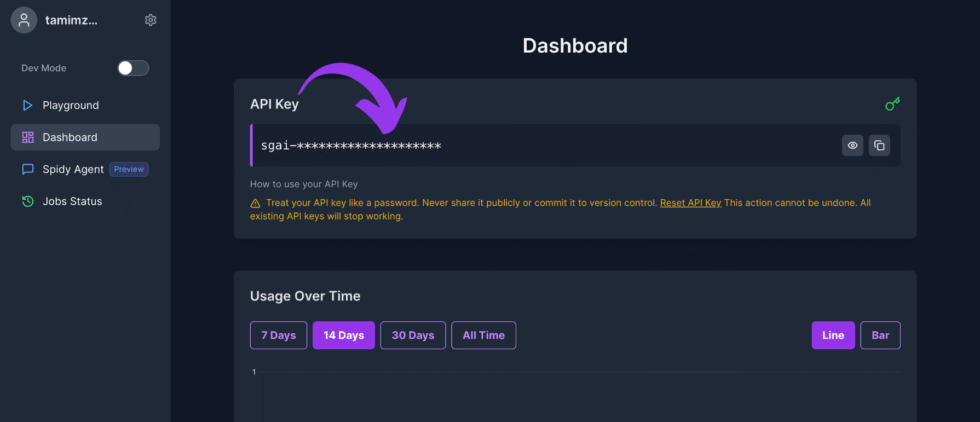
Passo 1: Crie sua conta e chave de API.
Cadastre-se no painel do ScrapeGraphAI e abra a aba "Keys" (Chaves).
Copie sua chave de API do ScrapeGraphAI, pois todas as solicitações precisam dessa chave.
✓ Ponto de verificação: Seu painel de controle exibe uma chave de API ativa.
Passo 2: Instale o ScrapeGraphAI
Crie um ambiente virtual limpo e, em seguida, instale o ScrapeGraphAI com o pip.
No seu script, adicione importar os e cliente de importação para carregar a chave da API com segurança.
Eis como o painel de controle se parece:
✓ Ponto de verificação: A biblioteca é importada sem erros.
Etapa 3: Escolha seu modelo de linguagem
Escolha um modelo de linguagem como o GPT 4o para sua primeira execução.
O ScrapeGraphAI suporta vários provedores de modelos de aprendizagem de linguagem (LLM), permitindo que você troque de modelo de IA a qualquer momento.
✅ Concluído: Agora você pode usar o ScrapeGraphAI para qualquer uma das funcionalidades abaixo.
Como usar o Scraper Inteligente do ScrapeGraphAI
Raspador Inteligente Permite extrair dados estruturados de qualquer página usando um prompt simples em linguagem natural.
Veja aqui como usá-lo passo a passo.
Passo 1: Abra o Single Page Scraper
Selecione a ferramenta de extração de dados de página única e cole um URL de destino.
Etapa 2: Escreva uma sugestão em linguagem natural
Descreva os campos que deseja extrair da página da web.
Eis como isso se parece:
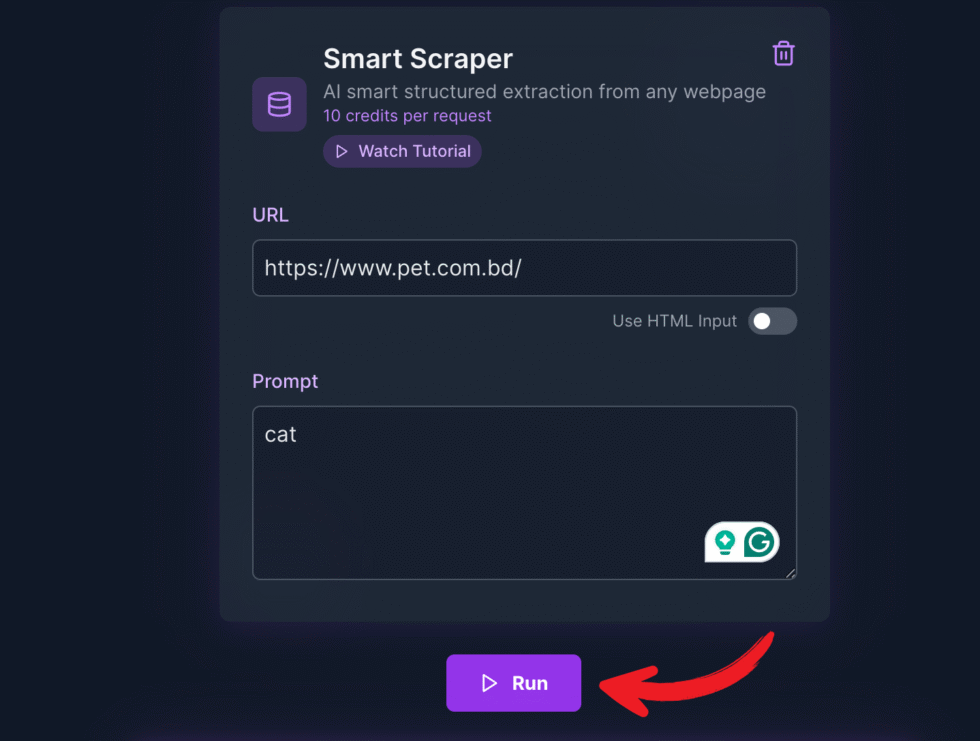
✓ Ponto de verificação: O resultado obtido corresponde aos campos solicitados.
Etapa 3: Execute e leia o JSON
Execute o programa e leia dados JSON limpos em um formato estruturado.
✅ Resultado: Você transformou uma página em dados estruturados em segundos.
💡 Dica profissional: Elabore uma solicitação detalhada com as chaves JSON exatas que você deseja para uma extração mais precisa.
Como usar o Scraper de Pesquisa do ScrapeGraphAI
Extrator de pesquisa Permite coletar dados da web diretamente dos resultados de pesquisa em tempo real, sem precisar abrir cada link individualmente.
Veja aqui como usá-lo passo a passo.
Passo 1: Insira sua consulta
Digite uma consulta e veja os resultados da pesquisa em tempo real.
Passo 2: Defina o que coletar
Indique quais dados da web devem ser extraídos de cada resultado.
Eis como isso se parece:
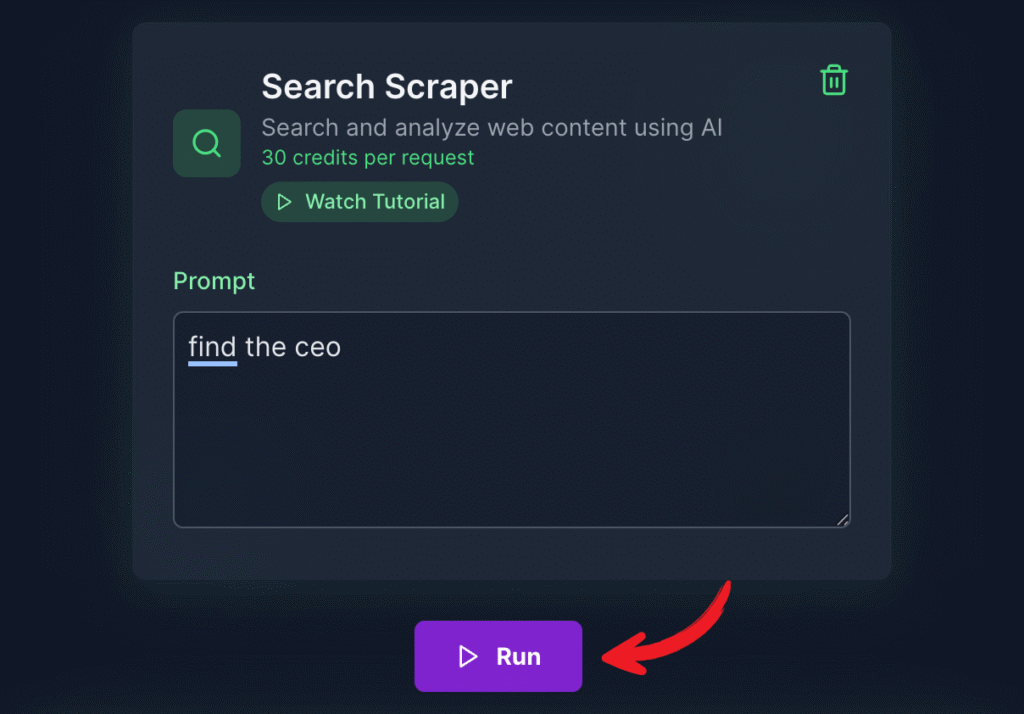
✓ Ponto de verificação: O resultado obtido corresponde aos campos solicitados.
Etapa 3: Exportar o resultado
Obtenha dados relevantes em formato JSON pronto para uso.
✅ Resultado: Você transformou resultados de pesquisa em dados web utilizáveis.
💡 Dica profissional: Primeiro, refine sua busca para que os resultados permaneçam focados e concisos.
Como usar o ScrapeGraphAI Markdownify
Markdownify Permite transformar conteúdo da web em Markdown limpo, que os modelos de IA leem sem ruídos adicionais.
Veja aqui como usá-lo passo a passo.
Passo 1: Cole o URL da página
Insira qualquer URL com estrutura HTML complexa.
Etapa 2: Converter para Markdown
O Markdownify transformará o conteúdo da web em Markdown limpo.
Eis como isso se parece:
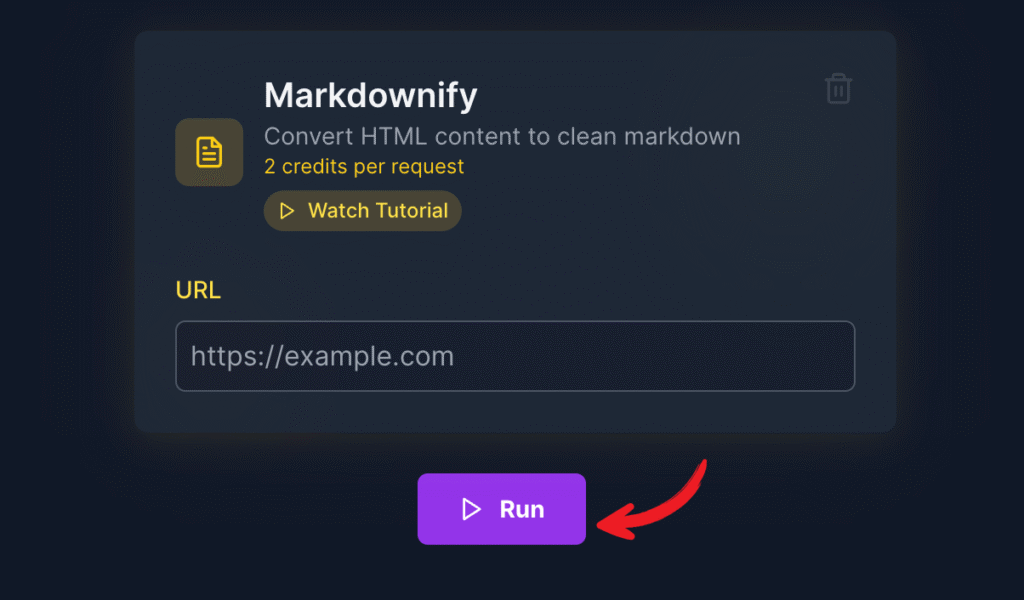
✓ Ponto de verificação: O resultado obtido corresponde aos campos solicitados.
Etapa 3: Reutilize os dados limpos
Insira os dados limpos em seu modelo ou anotações.
✅ Resultado: Você converteu uma página em um modelo limpo e pronto para uso. texto.
💡 Dica profissional: A saída em Markdown funciona muito bem como entrada para qualquer resumo com inteligência artificial.
Como usar o agente Spidy do ScrapeGraphAI
Agente Aranha Permite rastrear várias páginas como um scraper multipágina para projetos de raspagem maiores.
Veja aqui como usá-lo passo a passo.
Passo 1: Adicione sua página inicial
Dê ao Agente Aranha um link inicial para a rolagem.
Passo 2: Defina a profundidade de rastejamento
Escolha se deseja extrair dados de algumas páginas ou de muitas páginas.
Eis como isso se parece:
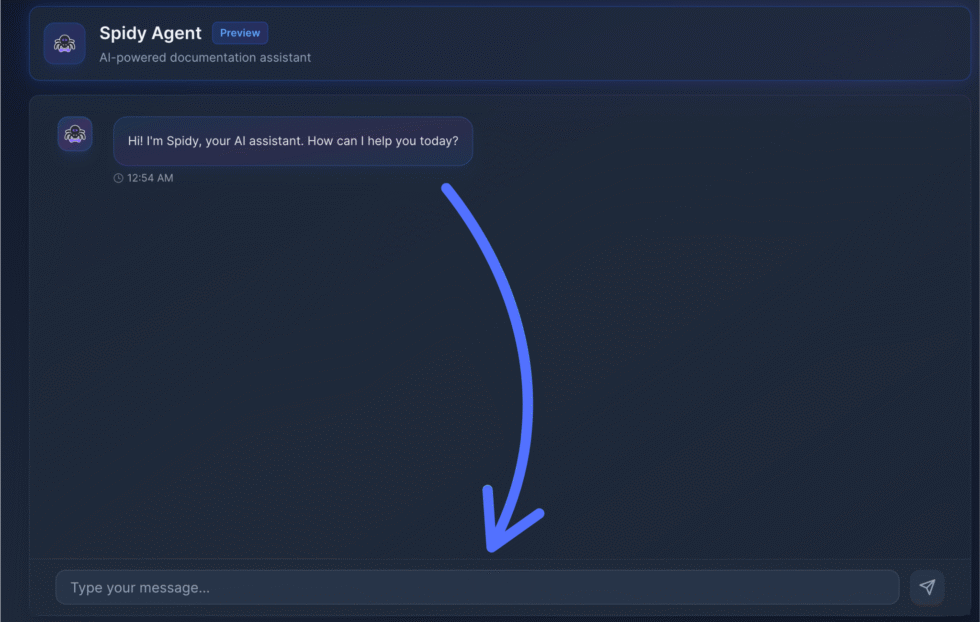
✓ Ponto de verificação: O resultado obtido corresponde aos campos solicitados.
Etapa 3: Coletar em escala
Deixe que este extrator de múltiplas páginas lide com tarefas de extração de dados em larga escala.
✅ Resultado: Você rastreou várias páginas em uma única execução.
💡 Dica profissional: Comece com algumas páginas para testar antes de executar qualquer coleta de dados em larga escala.
Como usar a Extração Universal de Dados do ScrapeGraphAI
Extração Universal de Dados Permite lidar com diversas tarefas de extração de dados, incluindo dados de produtos, artigos de notícias e muito mais.
Veja aqui como usá-lo passo a passo.
Passo 1: Escolha sua fonte
Aponte para dados de produtos, artigos de notícias ou qualquer página da web.
Etapa 2: Defina o esquema
Defina o formato estruturado que deseja que os dados extraídos sigam.
Eis como isso se parece:
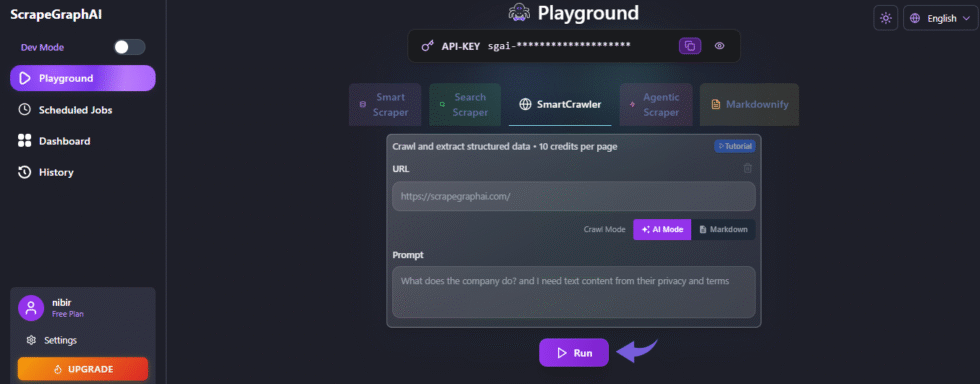
✓ Ponto de verificação: O resultado obtido corresponde aos campos solicitados.
Etapa 3: Extrair os dados
Execute as tarefas de extração de dados e revise os resultados.
✅ Resultado: Você lidou com diversas tarefas de extração de dados simultaneamente.
💡 Dica profissional: Defina um esquema Pydantic para bloquear a estrutura de cada registro.
Como usar as integrações fáceis do ScrapeGraphAI
Integrações fáceis Permite conectar os dados extraídos aos seus modelos de ciência de dados e aprendizado de máquina em minutos.
Veja aqui como usá-lo passo a passo.
Passo 1: Abra a API
Conecte-se por meio da API para seus scripts e aplicativos.
Etapa 2: Enviar dados para o fluxo subsequente
Encaminhe os dados extraídos para seus fluxos de dados.
Eis como isso se parece:
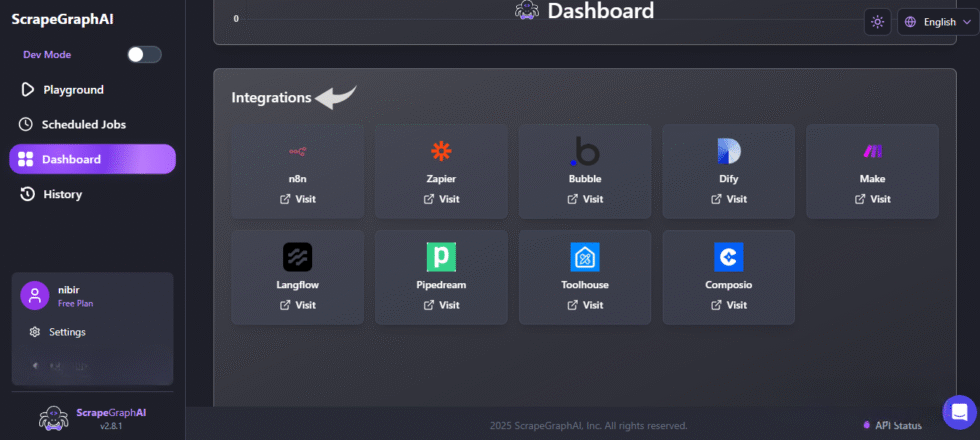
✓ Ponto de verificação: O resultado obtido corresponde aos campos solicitados.
Etapa 3: Alimente seus modelos
Entregue os dados aos modelos de aprendizado de máquina e agentes de IA.
✅ Resultado: Os dados extraídos agora fluem para sua pilha.
💡 Dica profissional: Conecte-o ao Make.com ou n8n para expandir seus fluxos de dados.
Como usar o Scraper Agentico Inteligente do ScrapeGraphAI
Raspador Agente Inteligente Permite ler conteúdo dinâmico em sites com uso intensivo de JavaScript que quebram as tradições. raspadores.
Veja aqui como usá-lo passo a passo.
Passo 1: Carregar um site complicado
Cole aqui um site que utiliza muito JavaScript e oculta seu conteúdo.
Etapa 2: Deixe o agente renderizar
O agente carrega conteúdo dinâmico antes de lê-lo.
Eis como isso se parece:
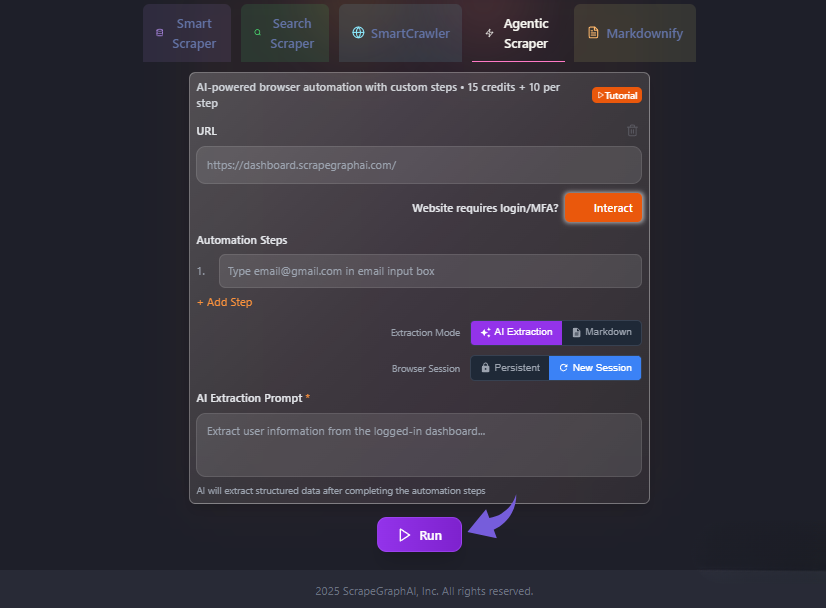
✓ Ponto de verificação: O resultado obtido corresponde aos campos solicitados.
Passo 3: Obtenha resultados estáveis
Ele se adapta quando os sites mudam, ao contrário dos scrapers tradicionais.
✅ Resultado: Você consegue ler um site com uso intensivo de JavaScript de forma clara e sem problemas.
💡 Dica profissional: Combine isso com a rotação de proxies em sites que bloqueiam bots de forma rigorosa.
Como usar o agendador de tarefas do ScrapeGraphAI
Trabalho Agendador Permite executar operações de raspagem de dados de forma programada, para que a extração se repita automaticamente.
Veja aqui como usá-lo passo a passo.
Passo 1: Criar um trabalho
Salvar uma raspagem como uma tarefa repetível.
Passo 2: Defina a cadência
Escolha a frequência com que as operações de raspagem devem ser executadas.
Eis como isso se parece:
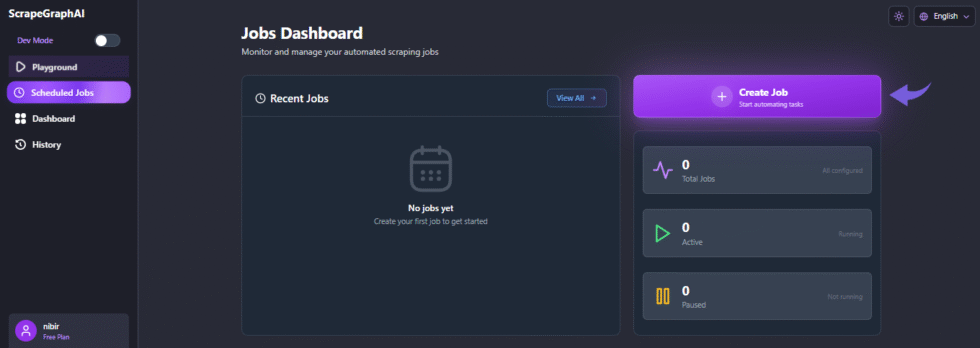
✓ Ponto de verificação: O resultado obtido corresponde aos campos solicitados.
Passo 3: Deixe correr
O processo de extração de dados se repete e armazena novos dados.
✅ Resultado: Seus dados de raspagem agora são atualizados automaticamente.
💡 Dica profissional: Organize as tarefas em intervalos para nunca acionar muitas solicitações ao mesmo tempo.
Como usar a interface simples do ScrapeGraphAI
Interface simples Permite usar o ScrapeGraphAI de forma eficaz a partir de um painel de controle sem código, sem a necessidade de conhecimentos técnicos aprofundados.
Veja aqui como usá-lo passo a passo.
Passo 1: Abra o Painel de Controle
Utilize o painel de controle com inteligência artificial, sem necessidade de programação.
Etapa 2: Construir sem código
Execute tarefas sem conhecimento técnico aprofundado.
Eis como isso se parece:
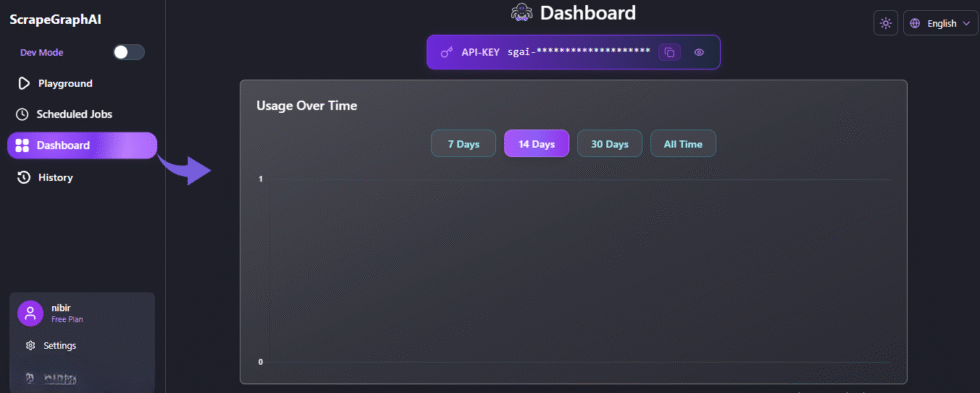
✓ Ponto de verificação: O resultado obtido corresponde aos campos solicitados.
Etapa 3: Gerencie tudo
Monitore cada coleta de dados e utilize o ScrapeGraphAI de forma eficaz a partir de uma única tela.
✅ Resultado: Você executou uma coleta completa de dados sem escrever nenhum código.
💡 Dica profissional: Salve os trabalhos nos favoritos para reutilizá-los em outros projetos de extração de dados.
Dicas e Atalhos Profissionais do ScrapeGraphAI
Após seis meses trabalhando em projetos de web scraping, aqui estão minhas melhores dicas.
Atalhos de configuração rápida
| Meta | Atalho |
|---|---|
| Depurar uma execução | Modo detalhado que permite o registro de informações detalhadas. |
| Salvar saída | Exportar para arquivo JSON ou arquivo CSV |
| Evite bloqueios | Adicionar proxies rotativos |
| Estrutura de fechadura | Esquema Pydante |
Características ocultas que a maioria das pessoas não percebe
- Registro detalhado: Uma opção detalhada que habilita o registro de logs para cada nó, facilitando muito o tratamento de erros.
- Rotação de proxy: A rotação de proxies permite que você fique dentro dos limites de taxa da API e evite bloqueios de IP em sites protegidos.
- Modelos locais: Execute modelos abertos via Ollama para extrair informações sem pagar por token.
Erros comuns a evitar no ScrapeGraphAI
Erro: Ignorar os termos do site
❌ Errado: Extrair dados sem verificar primeiro os termos do site ou as considerações legais.
✅ Direita: Leia a política do site e respeite os termos de uso antes de executar qualquer coleta de dados.
Erro: Sobrecarregar o servidor
❌ Errado: O envio de requisições é tão rápido que o site retorna erros de "muitas requisições".
✅ Direita: Adicione atrasos entre as solicitações para que você permaneça dentro dos limites de taxa da API.
Erro: Instruções vagas
❌ Errado: Escrever instruções vagas em linguagem natural que retornam dados desorganizados.
✅ Direita: Forneça os campos exatos e um esquema para obter dados limpos sempre.
Solução de problemas do ScrapeGraphAI
Problema: Erro no número de solicitações
Causa: Você atingiu os limites de taxa da API ao enviar solicitações muito rapidamente.
Consertar: Espaçe as chamadas e adicione um atraso; atualize seu plano para obter limites maiores.
Problema: Resultados em branco ou parciais
Causa: O site em questão utiliza muito JavaScript, portanto o conteúdo dinâmico é carregado tardiamente.
Consertar: Mude para o Smart Agent Scraper, que renderiza a página antes de lê-la.
Problema: Bloqueio de IP ou bloqueio de endereço IP
Causa: O site sinaliza operações de extração de dados e exibe uma página de bloqueio.
Consertar: Adicione proxies rotativos para que cada solicitação pareça ser de um visitante novo.
📌 Observação: Estas dicas abordam os desafios mais comuns; para os demais, entre em contato com o suporte do ScrapeGraphAI.
O que é o ScrapeGraphAI?
ScrapeGraphAI é uma biblioteca Python de código aberto para extração inteligente de dados da web.
Ele combina grandes modelos de linguagem (LLMs) com lógica gráfica direta para construir um pipeline de extração de dados.
Cada nó no grafo de raspagem executa uma tarefa, o que facilita a atualização de qualquer extração de dados.
Pense nisso como uma ideia inteligente. assistente que lê páginas da web e retorna dados JSON limpos.
Veja esta breve visão geral:
Inclui estas características principais:
- Raspador Inteligente: Extrair dados estruturados de qualquer página usando uma simples instrução em linguagem natural.
- Extrator de pesquisa: Colete dados da web diretamente dos resultados de pesquisa em tempo real sem precisar abrir cada link.
- Converter para Markdown: Transformar conteúdo da web em Markdown limpo que os modelos de IA leem sem ruídos adicionais.
- Agente Aranha: Rastreie várias páginas como um scraper multipágina para projetos de scraping maiores.
- Extração Universal de Dados: Lidar com diversas tarefas de extração de dados, incluindo dados de produtos, artigos de notícias e muito mais.
- Integrações fáceis: Conecte os dados extraídos aos seus modelos de ciência de dados e aprendizado de máquina em minutos.
- Raspador Inteligente e Ativo: Leia conteúdo dinâmico em sites com uso intensivo de JavaScript que não funcionam com scrapers tradicionais.
- Agendador de tarefas: Execute operações de raspagem de dados de forma programada para que a extração se repita automaticamente.
- Interface simples: Utilize o ScrapeGraphAI de forma eficaz a partir de um painel de controle sem código, mesmo sem conhecimentos técnicos avançados.
Por interpretar o contexto, consegue extrair dados relevantes mesmo quando um site altera seu layout.
Ele lê páginas da web e documentos locais, mas não transcreve arquivos de áudio.
Com instruções simples em linguagem natural, você pode utilizar dados como artigos de notícias para análise de sentimentos.
Para uma análise completa, consulte nosso artigo. Análise do ScrapeGraphAI.
Preços do ScrapeGraphAI
Eis o custo do ScrapeGraphAI em 2026:
| Plano | Preço | Ideal para |
|---|---|---|
| Livre | $0 | Testando em algumas páginas |
| Iniciante | US$ 17/mês | Tarefas de extração de dados individuais |
| Crescimento | US$ 85/mês | Projetos regulares de raspagem de dados |
| Pró | US$ 425/mês | raspagem em grande escala |
| Empresa | Personalizado | Equipes de alto volume |
Teste grátis: Sim — o plano gratuito permite que você teste a extração de dados sem custo algum.
Garantia de reembolso: Cancele a qualquer momento pelo seu painel de controle.
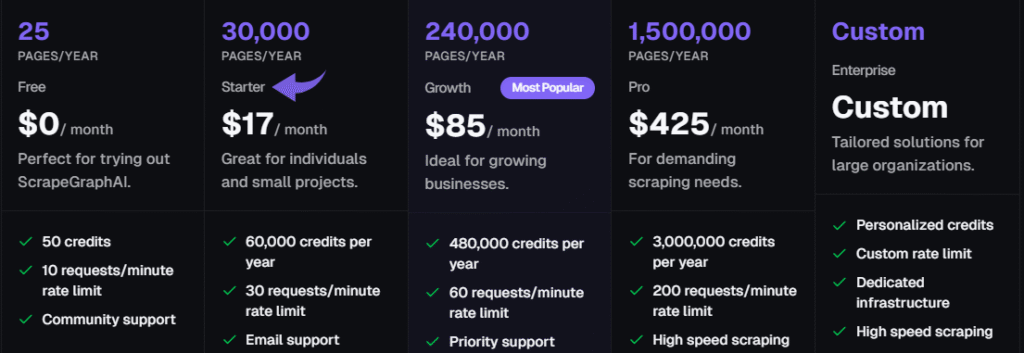
💰 Melhor custo-benefício: Crescimento — volume suficiente para projetos de coleta de dados estáveis sem custos excessivos.
ScrapeGraphAI vs. Alternativas
Como o ScrapeGraphAI se compara? Eis o panorama:
| Ferramenta | Ideal para | Preço | Avaliação |
|---|---|---|---|
| ScrapeGraphAI | extração nativa de IA | US$ 17/mês | ⭐ 4,5 |
| Scrapy | Rastreamento com foco no código | Livre | ⭐ 4,4 |
| Navegar na IA | Monitoramento sem código | US$ 48/mês | ⭐ 4,3 |
| Dados brilhantes | Rede proxy | US$ 0,50/mês | ⭐ 4,5 |
| Octoparse | raspagem visual | US$ 99/mês | ⭐ 4,3 |
| ScrapingBee | Sites com uso intensivo de renderização | US$ 49/mês | ⭐ 4,4 |
Escolhas rápidas:
- Melhor no geral: ScrapeGraphAI — a extração de linguagem natural supera os seletores rígidos.
- Melhor orçamento: Scrapy — gratuito se você souber escrever o código.
- Ideal para iniciantes: Navegue com IA — aponte e clique, sem scripts.
- Melhor para proxies: Bright Data — enorme conjunto rotativo de proxies.
🎯 Alternativas ao ScrapeGraphAI
Procurando alternativas ao ScrapeGraphAI? Aqui estão as melhores opções:
- 🚀 Scrapy: Framework Python de código aberto para desenvolvedores que desejam controle total sobre cada rastreamento.
- 👶 Navegar na IA: Ferramenta sem código que registra seus cliques e transforma qualquer site em uma API.
- 🏢 Dados brilhantes: Rede proxy empresarial com IPs rotativos em larga escala para extração de dados em grande volume.
- 🎨 Octoparse: Ferramenta visual de extração de dados do tipo "apontar e clicar" destinada a pessoas sem conhecimento de programação que estejam desenvolvendo projetos de extração de dados.
- 🔧 ScrapingBee: API que renderiza sites com uso intensivo de JavaScript, dispensando a configuração manual do navegador.
Para ver a lista completa, consulte nosso Alternativas ao ScrapeGraphAI guia.
⚔️ Comparação do ScrapeGraphAI
Veja como o ScrapeGraphAI se compara a cada concorrente:
- ScrapeGraphAI vs Scrapy: O ScrapeGraphAI vence na velocidade para o primeiro resultado; o Scrapy vence no controle bruto para programadores.
- ScrapeGraphAI vs Browse AI: O ScrapeGraphAI lida melhor com páginas mais complexas; o Browse AI é mais simples para layouts fixos e repetitivos.
- ScrapeGraphAI vs Bright Data: A Bright Data lidera em proxies; a ScrapeGraphAI lidera na transformação de páginas em dados estruturados.
- ScrapeGraphAI vs Octoparse: O ScrapeGraphAI se adapta quando os sites mudam; o Octoparse exige que você recrie os modelos.
- ScrapeGraphAI vs ScrapingBee: Ambas as ferramentas renderizam sites complexos, mas o ScrapeGraphAI também utiliza modelos de IA para analisar o conteúdo.
Comece a usar o ScrapeGraphAI agora mesmo
Você aprendeu a usar todos os principais recursos do ScrapeGraphAI:
- ✅ Raspador Inteligente
- ✅ Extrator de pesquisa
- ✅ Markdownify
- ✅ Agente Aranha
- ✅ Extração Universal de Dados
- ✅ Integrações fáceis
- ✅ Raspador Agente Inteligente
- ✅ Agendador de Tarefas
- ✅ Interface simples
Aqui estão os principais benefícios em resumo:
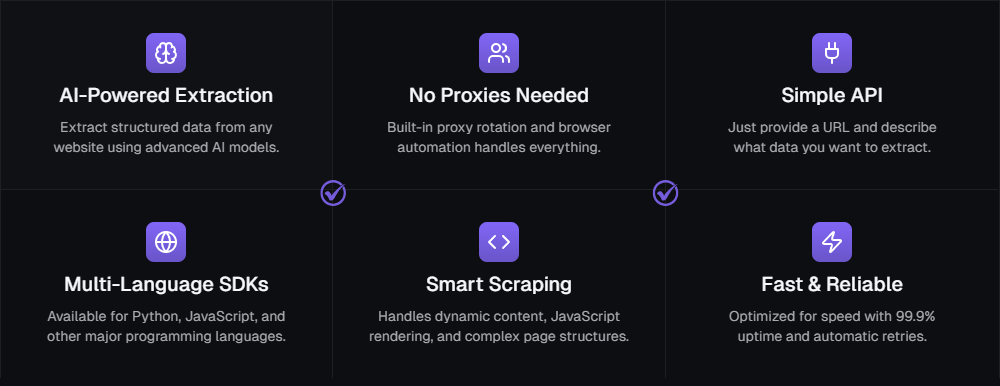
Próximo passo: Escolha uma funcionalidade e experimente agora mesmo.
A maioria das pessoas começa com o Smart Scraper, um extrator de dados de página única.
A extração de dados da sua primeira página leva menos de cinco minutos.
Perguntas frequentes
O ScrapeGraphAI é gratuito?
Sim. O plano gratuito cobre extração básica de dados da web sem custo algum, e os planos pagos começam em US$ 17/mês para quem precisa de mais volume ou recursos.
Preciso saber programar?
Não. Você pode usar o ScrapeGraphAI a partir de um painel de controle sem código com instruções em linguagem natural, embora uma API em Python esteja disponível caso você queira utilizá-la.
Quais modelos de linguagem de grande porte ele suporta?
Funciona com vários fornecedores de modelos locais (LLM), incluindo modelos da OpenAI como GPT 4o, Anthropic, Google Gemini e modelos locais através da Ollama.
Ele consegue lidar com sites que utilizam muito JavaScript?
Sim. O Smart Agent Scraper renderiza primeiro o conteúdo dinâmico, portanto, lê sites com uso intensivo de JavaScript que quebram os scrapers tradicionais.
Como faço para evitar ser bloqueado?
Respeite os termos do site, adicione atrasos para evitar erros de excesso de solicitações e use proxies rotativos para evitar bloqueios de IP durante a coleta de dados.













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
