
Démarrage rapide
Ce guide couvre toutes les fonctionnalités de ScrapeGraphAI :
- Commencer — Créez un compte et ajoutez votre clé API
- Comment utiliser Smart Scraper — extraire des données structurées de n'importe quelle page à l'aide d'une simple requête en langage naturel
- Comment utiliser un outil d'extraction de données de recherche — Collectez des données Web directement à partir des résultats de recherche en direct sans ouvrir chaque lien vous-même.
- Comment utiliser Markdownify — Transformer le contenu web en Markdown propre, lisible par les modèles d'IA sans bruit supplémentaire.
- Comment utiliser Spidy Agent — Explorer plusieurs pages grâce à un outil d'extraction de données multipages pour les projets d'extraction de données de grande envergure
- Comment utiliser l'extraction de données universelle — gérer de nombreuses tâches d'extraction de données à partir de données produits, d'articles de presse, etc.
- Comment utiliser Easy Integrations — Connectez les données extraites à vos modèles de science des données et d'apprentissage automatique en quelques minutes
- Comment utiliser Smart Agentic Scraper — Lire du contenu dynamique sur des sites utilisant beaucoup de JavaScript et qui rendent les scrapers traditionnels inopérants
- Comment utiliser le planificateur de tâches — exécuter les opérations de web scraping de manière planifiée afin que l'extraction de données se répète automatiquement.
- Comment utiliser une interface simple — utiliser efficacement ScrapeGraphAI depuis un tableau de bord sans code et sans expertise technique approfondie
Temps nécessaire : 5 minutes par fonctionnalité
Vous trouverez également dans ce guide : Conseils de pro | Erreurs courantes | Dépannage | Tarification | Alternatives
Pourquoi faire confiance à ce guide ?
J'ai utilisé ScrapeGraphAI et testé moi-même chaque fonctionnalité de ce tutoriel « Comment utiliser ScrapeGraphAI ».
Ce guide d'utilisation de ScrapeGraphAI est basé sur de véritables projets de scraping, et non sur des captures d'écran fournies par le fournisseur.

ScrapeGraphAI est un outil basé sur l'IA qui transforme les sites web désordonnés. données Conversion rapide en données structurées.
Il utilise de grands modèles de langage pour lire les pages comme le ferait une personne.
Cette approche intelligente d'extraction de données Web vous aide à simplifier l'extraction de données Web pour de nombreuses tâches.
Ci-dessous, je détaille chacune des fonctionnalités clés étape par étape, avec des captures d'écran et des conseils de pro.
Tutoriel ScrapeGraphAI
Ce tutoriel sur l'utilisation de ScrapeGraph AI vous guide tout au long du processus de web scraping, de la configuration à l'extraction de données avancée.
IA ScrapeGraph
Transformez n'importe quel site web en données structurées et propres grâce à des requêtes en langage naturel. ScrapeGraphAI associe de puissants modèles de langage à une logique graphique directe pour extraire rapidement les données. Essayez gratuitement, sans carte de crédit.
Premiers pas avec ScrapeGraphAI
Avant toute utilisation, veuillez terminer cette procédure de configuration unique.
Regardez d'abord ce bref aperçu :
Passons maintenant en revue chaque étape.
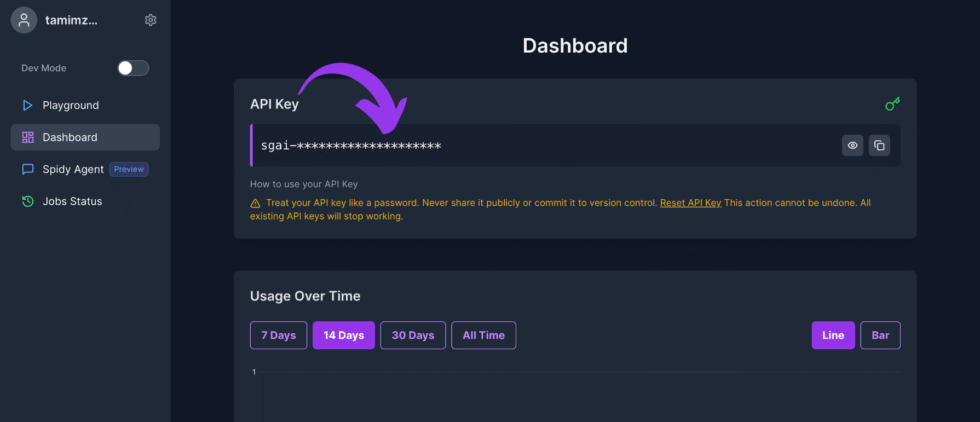
Étape 1 : Créez votre compte et votre clé API
Inscrivez-vous sur le tableau de bord ScrapeGraphAI et ouvrez l'onglet « Clés ».
Copiez votre clé API ScrapeGraphAI, car chaque requête nécessite cette clé API.
✓ Point de contrôle: Votre tableau de bord affiche une clé API active.
Étape 2 : Installer ScrapeGraphAI
Créez un environnement virtuel propre, puis installez ScrapeGraphAI avec pip.
Ajoutez à votre script importer os et client d'importation pour charger la clé API en toute sécurité.
Voici à quoi ressemble le tableau de bord :
✓ Point de contrôle: L'importation de la bibliothèque se déroule sans erreur.
Étape 3 : Choisissez votre modèle de langage
Choisissez un modèle de langage tel que GPT 4o pour votre première exécution.
ScrapeGraphAI prend en charge plusieurs fournisseurs de modèles LLM, vous permettant ainsi de changer de modèle d'IA à tout moment.
✅ Terminé : Vous pouvez désormais utiliser ScrapeGraphAI pour toutes les fonctionnalités ci-dessous.
Comment utiliser le scraper intelligent de ScrapeGraphAI
Scraper intelligent permet d'extraire des données structurées de n'importe quelle page à l'aide d'une simple invite en langage naturel.
Voici comment l'utiliser étape par étape.
Étape 1 : Ouvrir l’outil d’extraction de données de pages uniques
Sélectionnez l'outil d'extraction de données de page unique et collez une URL cible.
Étape 2 : Rédiger une consigne en langage naturel
Décrivez les champs que vous souhaitez extraire de la page web.
Voici à quoi cela ressemble :
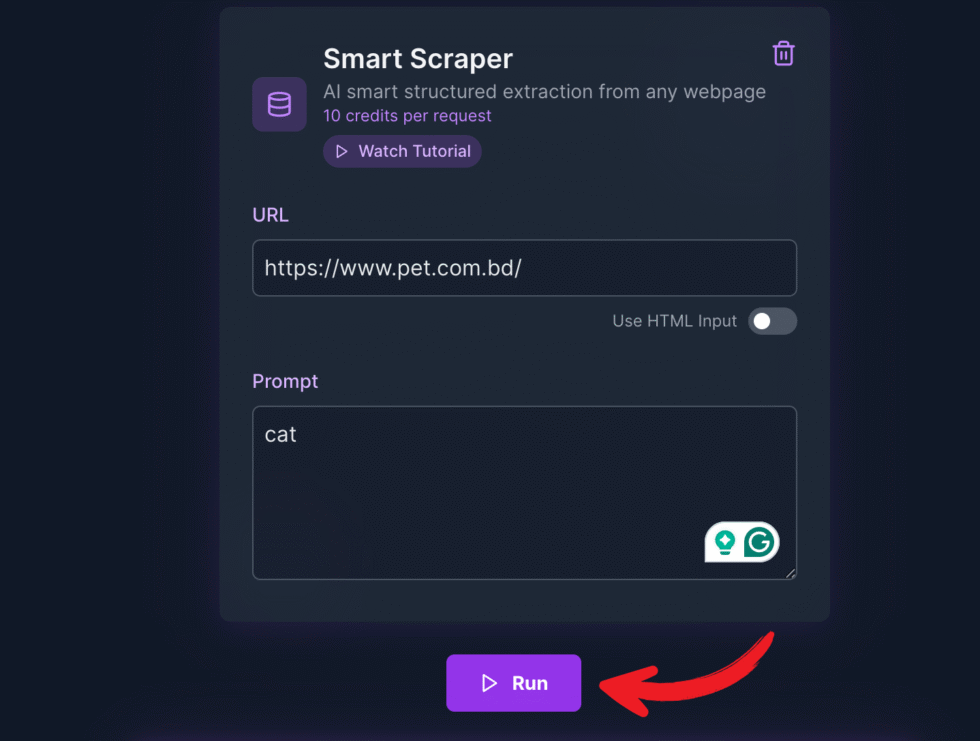
✓ Point de contrôle: Votre résultat correspond aux champs que vous avez demandés.
Étape 3 : Exécuter et lire le JSON
Exécutez-le et lisez des données JSON propres dans un format structuré.
✅ Résultat : Vous avez extrait les données structurées d'une page en quelques secondes.
💡 Conseil de pro : Rédigez une invite détaillée avec les clés JSON exactes souhaitées pour une extraction plus précise.
Comment utiliser le scraper de recherche ScrapeGraphAI
Extracteur de données de recherche vous permet de collecter des données Web directement à partir des résultats de recherche en direct sans avoir à ouvrir chaque lien vous-même.
Voici comment l'utiliser étape par étape.
Étape 1 : Saisissez votre requête
Saisissez une requête et laissez le système afficher les résultats de recherche en direct.
Étape 2 : Définir ce qu’il faut collecter
Indiquez-lui quelles données web extraire de chaque résultat.
Voici à quoi cela ressemble :
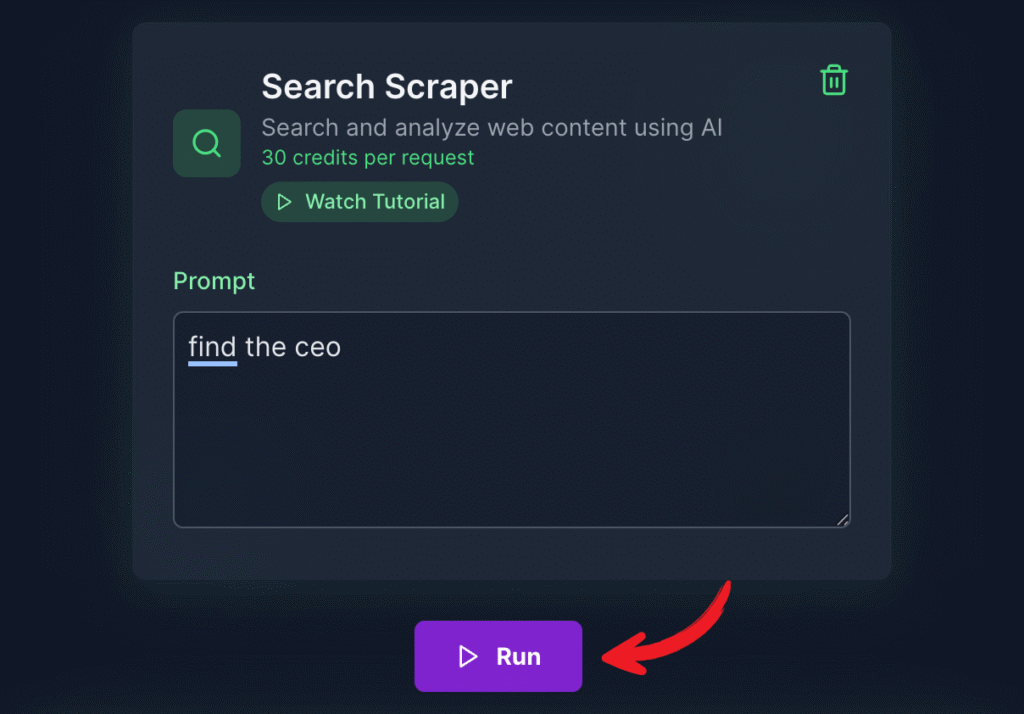
✓ Point de contrôle: Votre résultat correspond aux champs que vous avez demandés.
Étape 3 : Exporter le résultat
Récupérez des données exploitables au format JSON prêt à l'emploi.
✅ Résultat : Vous avez transformé les résultats de recherche en données web exploitables.
💡 Conseil de pro : Commencez par restreindre votre requête afin que les résultats restent ciblés et clairs.
Comment utiliser ScrapeGraphAI Markdownify
Markdownify permet de transformer le contenu web en Markdown propre, lisible par les modèles d'IA sans bruit superflu.
Voici comment l'utiliser étape par étape.
Étape 1 : Collez l’URL de la page
Insérez n'importe quelle URL avec une structure HTML complexe.
Étape 2 : Convertir en Markdown
Markdownify transformera le contenu web en Markdown propre.
Voici à quoi cela ressemble :
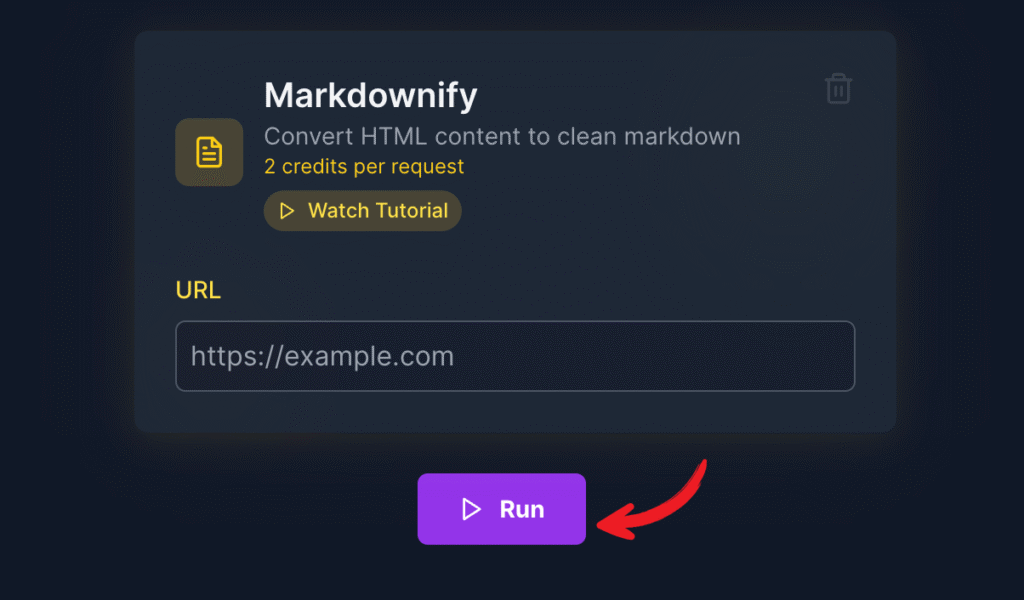
✓ Point de contrôle: Votre résultat correspond aux champs que vous avez demandés.
Étape 3 : Réutiliser les données nettoyées
Intégrez les données nettoyées dans votre modèle ou vos notes.
✅ Résultat : Vous avez converti une page en une page propre et prête à être modélisée. texte.
💡 Conseil de pro : Le format Markdown fonctionne parfaitement comme entrée pour tout résumé basé sur l'IA.
Comment utiliser l'agent Spidy de ScrapeGraphAI
Agent Spidy permet d'explorer plusieurs pages en tant qu'outil d'extraction multipage pour les projets d'extraction de données de plus grande envergure.
Voici comment l'utiliser étape par étape.
Étape 1 : Ajoutez votre page de démarrage
Fournissez à Spidy Agent un lien de départ pour le crawl.
Étape 2 : Définir la profondeur du vide sanitaire
Choisissez si vous souhaitez extraire des données de quelques pages ou de nombreuses pages.
Voici à quoi cela ressemble :
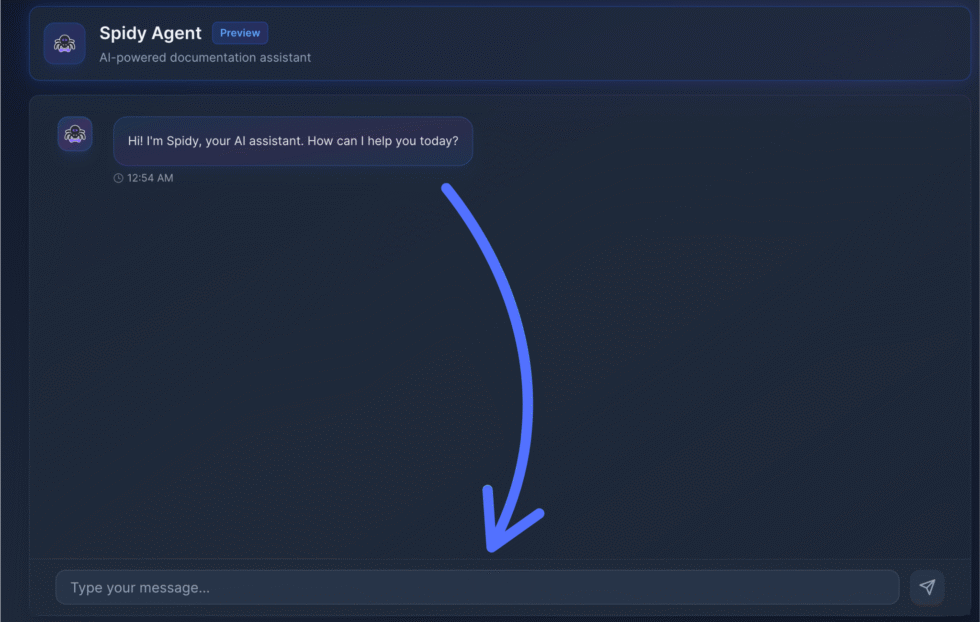
✓ Point de contrôle: Votre résultat correspond aux champs que vous avez demandés.
Étape 3 : Collecte à l’échelle
Laissez ce scraper multipage gérer les tâches de scraping à grande échelle.
✅ Résultat : Vous avez exploré plusieurs pages en une seule exécution.
💡 Conseil de pro : Commencez par tester quelques pages avant toute extraction de données à grande échelle.
Comment utiliser l'extraction de données universelle de ScrapeGraphAI
Extraction universelle de données permet de gérer de nombreuses tâches d'extraction de données à partir de données produits, d'articles de presse, et bien plus encore.
Voici comment l'utiliser étape par étape.
Étape 1 : Choisissez votre source
Pointez-le vers des données produits, des articles de presse ou n'importe quelle page web.
Étape 2 : Définir le schéma
Définissez le format structuré que vous souhaitez que les données extraites suivent.
Voici à quoi cela ressemble :
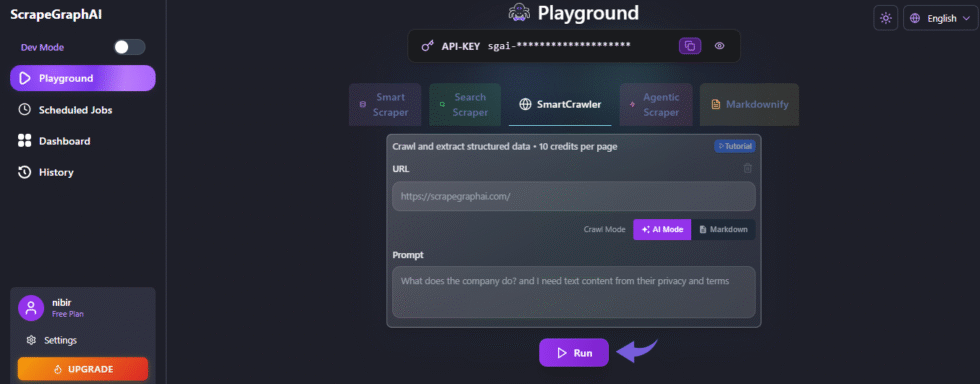
✓ Point de contrôle: Votre résultat correspond aux champs que vous avez demandés.
Étape 3 : Extraire les données
Exécutez les tâches d'extraction de données et examinez les résultats.
✅ Résultat : Vous avez géré simultanément des tâches d'extraction de données mixtes.
💡 Conseil de pro : Définissez un schéma Pydantic pour verrouiller la structure de chaque enregistrement.
Comment utiliser les intégrations faciles de ScrapeGraphAI
Intégrations faciles vous permet de connecter les données extraites à vos modèles de science des données et d'apprentissage automatique en quelques minutes.
Voici comment l'utiliser étape par étape.
Étape 1 : Ouvrir l'API
Connectez-vous via l'API pour vos scripts et applications.
Étape 2 : Envoyer les données en aval
Intégrez les données extraites dans vos pipelines de données.
Voici à quoi cela ressemble :
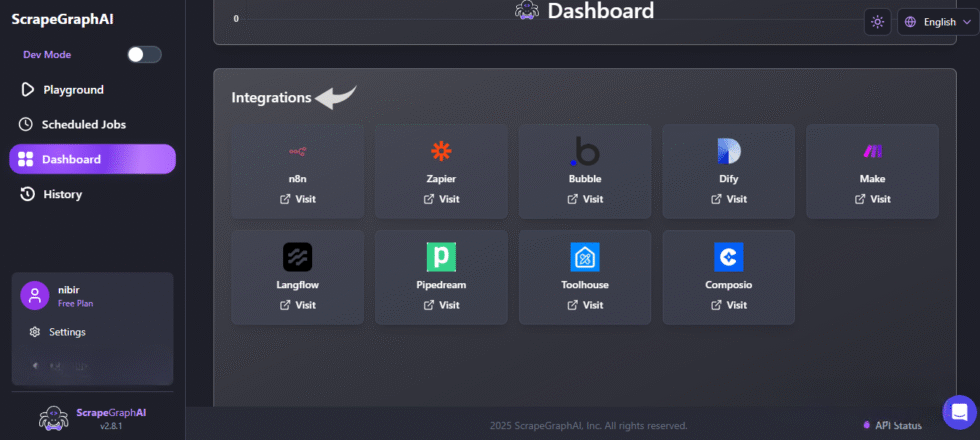
✓ Point de contrôle: Votre résultat correspond aux champs que vous avez demandés.
Étape 3 : Nourrissez vos modèles
Transmettez les données aux modèles d'apprentissage automatique et aux agents d'IA.
✅ Résultat : Vos données extraites sont maintenant intégrées à votre pile.
💡 Conseil de pro : Connectez-le à Make.com ou n8n pour étendre vos pipelines de données.
Comment utiliser le scraper intelligent ScrapeGraphAI
Récupérateur d'agents intelligents vous permet de lire du contenu dynamique sur des sites utilisant beaucoup de JavaScript et qui rompent avec les conventions traditionnelles grattoirs.
Voici comment l'utiliser étape par étape.
Étape 1 : Charger un site complexe
Collez un site web utilisant beaucoup de JavaScript et qui masque son contenu.
Étape 2 : Laisser l'agent rendre
L'agent charge le contenu dynamique avant de le lire.
Voici à quoi cela ressemble :
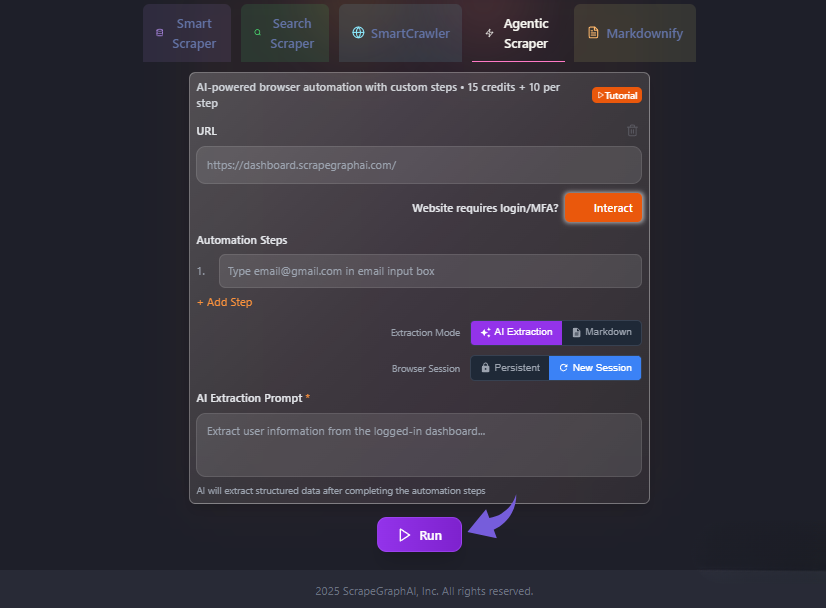
✓ Point de contrôle: Votre résultat correspond aux champs que vous avez demandés.
Étape 3 : Obtenir des résultats stables
Contrairement aux scrapers traditionnels, il s'adapte aux modifications des sites web.
✅ Résultat : Vous parvenez à lire un site web utilisant beaucoup de JavaScript sans problème.
💡 Conseil de pro : Associez-le à une rotation des proxys sur les sites qui bloquent strictement les bots.
Comment utiliser le planificateur de tâches de ScrapeGraphAI
Emploi Planificateur permet d'exécuter des opérations de web scraping de manière planifiée afin que l'extraction de données se répète automatiquement.
Voici comment l'utiliser étape par étape.
Étape 1 : Créer un emploi
Enregistrez une opération de grattage comme tâche répétable.
Étape 2 : Définir la cadence
Choisissez la fréquence d'exécution des opérations de récupération de données.
Voici à quoi cela ressemble :
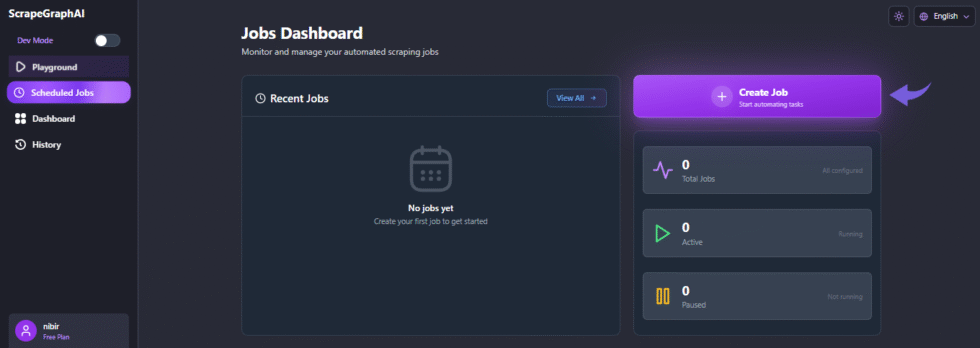
✓ Point de contrôle: Votre résultat correspond aux champs que vous avez demandés.
Étape 3 : Laissez faire
Le processus de collecte de données se répète et stocke des données actualisées.
✅ Résultat : Vos données de web scraping s'actualisent désormais automatiquement.
💡 Conseil de pro : Échelonnez les tâches pour éviter de déclencher trop de demandes simultanément.
Comment utiliser l'interface simple de ScrapeGraphAI
Interface simple vous permet d'utiliser efficacement ScrapeGraphAI depuis un tableau de bord sans code et sans expertise technique approfondie.
Voici comment l'utiliser étape par étape.
Étape 1 : Ouvrir le tableau de bord
Utilisez le tableau de bord basé sur l'IA, aucune programmation n'est requise.
Étape 2 : Créer sans coder
Exécuter des tâches sans expertise technique approfondie.
Voici à quoi cela ressemble :
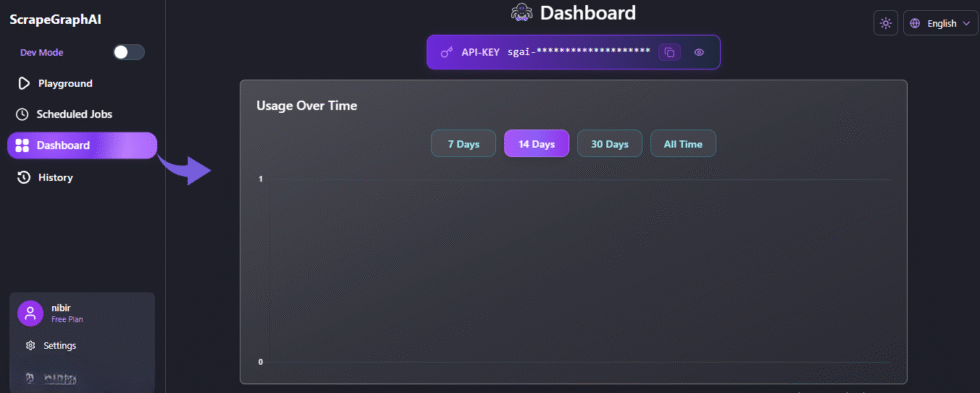
✓ Point de contrôle: Votre résultat correspond aux champs que vous avez demandés.
Étape 3 : Tout gérer
Suivez chaque extraction de données et utilisez ScrapeGraphAI efficacement depuis un seul écran.
✅ Résultat : Vous avez effectué une extraction complète de données sans écrire une seule ligne de code.
💡 Conseil de pro : Enregistrez les tâches sauvegardées pour les réutiliser dans différents projets de web scraping.
Astuces et raccourcis pour ScrapeGraphAI Pro
Après six mois de projets de démolition, voici mes meilleurs conseils.
Raccourcis de configuration rapide
| But | Raccourci |
|---|---|
| Déboguer une exécution | Mode verbeux permettant l'enregistrement détaillé |
| Enregistrer la sortie | Exporter vers un fichier JSON ou un fichier CSV |
| Évitez les blocs | Ajouter des proxys rotatifs |
| Structure de verrouillage | Schéma pydantique |
Fonctionnalités cachées que la plupart des gens ignorent
- Journalisation détaillée : Une option de journalisation détaillée qui active les journaux pour chaque nœud, facilitant ainsi la gestion des erreurs.
- Rotation par proxy : Les proxys rotatifs vous permettent de rester sous les limites de débit des API et de contourner les blocages d'adresse IP sur les sites protégés.
- Modèles locaux : Exécutez des modèles ouverts via Ollama pour extraire des informations sans payer par jeton.
Erreurs courantes à éviter avec ScrapeGraphAI
Erreur : Ignorer les conditions d'utilisation du site web
❌ Faux : Extraction de données sans vérification préalable des conditions d'utilisation du site web ni des considérations juridiques.
✅ À droite : Veuillez lire la politique du site et respecter les conditions d'utilisation du site web avant toute extraction de données.
Erreur : Surcharger le serveur
❌ Faux : Envoi de requêtes si rapide que le site renvoie des erreurs de trop nombreuses requêtes.
✅ À droite : Ajoutez des délais entre les requêtes afin de rester en dessous des limites de débit de l'API.
Erreur : Consignes vagues
❌ Faux : Rédiger des invites en langage naturel souple qui renvoient des données désordonnées.
✅ À droite : Indiquez les champs exacts et un schéma afin d'obtenir des données propres à chaque fois.
Dépannage de ScrapeGraphAI
Problème : Erreur de trop nombreuses requêtes
Cause: Vous avez atteint les limites de débit de l'API en envoyant des requêtes trop rapidement.
Réparer: Espacez vos appels et ajoutez un délai ; passez à un forfait supérieur pour bénéficier de limites plus élevées.
Problème : Résultats vides ou partiels
Cause: Le site cible utilise beaucoup de JavaScript, le contenu dynamique se charge donc tardivement.
Réparer: Passez au Smart Agentic Scraper, qui affiche la page avant de la lire.
Problème : Blocage ou blocage d’adresse IP
Cause: Le site signale les opérations de web scraping et affiche une page de blocage.
Réparer: Ajoutez des proxys rotatifs pour que chaque requête ressemble à celle d'un nouveau visiteur.
📌 Note: Ces solutions couvrent les problèmes les plus courants ; pour les autres, contactez le support de ScrapeGraphAI.
Qu'est-ce que ScrapeGraphAI ?
ScrapeGraphAI est une bibliothèque Python open source pour le web scraping intelligent.
Il associe de grands modèles de langage (LLM) à une logique graphique directe pour construire un pipeline de web scraping.
Chaque nœud du graphe de récupération exécute une tâche, ce qui facilite la mise à jour de toute extraction de données.
Considérez cela comme une intelligence assistant qui lit les pages web et renvoie des données JSON propres.
Regardez ce bref aperçu :
Il comprend les fonctionnalités clés suivantes :
- Scraper intelligent : extraire des données structurées de n'importe quelle page à l'aide d'une simple requête en langage naturel
- Extracteur de données de recherche : Collectez des données Web directement à partir des résultats de recherche en direct sans ouvrir chaque lien vous-même.
- Markdownify : Transformer le contenu web en Markdown propre, lisible par les modèles d'IA sans bruit supplémentaire.
- Agent Spidy : explorer plusieurs pages en tant qu'outil d'extraction de données multipages pour les projets d'extraction de données de grande envergure
- Extraction universelle de données : gérer de nombreuses tâches d'extraction de données à partir de données produits, d'articles de presse, etc.
- Intégrations faciles : Connectez les données extraites à vos modèles de science des données et d'apprentissage automatique en quelques minutes.
- Smart Agentic Scraper : lire du contenu dynamique sur des sites riches en JavaScript qui rendent les scrapers traditionnels inopérants
- Planificateur de tâches : Exécuter les opérations de web scraping de manière planifiée afin que l'extraction de données se répète automatiquement.
- Interface simple : Utilisez efficacement ScrapeGraphAI depuis un tableau de bord sans code et sans expertise technique approfondie.
Grâce à sa capacité à analyser le contexte, il peut extraire des données pertinentes même lorsque la mise en page d'un site web change.
Il lit les pages web et les documents locaux, mais ne transcrit pas les fichiers audio.
Avec des instructions claires en langage naturel, vous pouvez utiliser des données comme des articles de presse pour l'analyse des sentiments.
Pour une analyse complète, consultez notre Avis sur ScrapeGraphAI.
Tarification de ScrapeGraphAI
Voici le coût de ScrapeGraphAI en 2026 :
| Plan | Prix | Idéal pour |
|---|---|---|
| Gratuit | $0 | Test sur quelques pages |
| Démarreur | 17 $/mois | tâches d'extraction de données en solo |
| Croissance | 85 $/mois | Projets de grattage réguliers |
| Pro | 425 $/mois | raclage à grande échelle |
| Entreprise | Coutume | Équipes à volume élevé |
Essai gratuit : Oui, le forfait gratuit vous permet de tester l'extraction de données sans frais.
Garantie de remboursement : Annulation possible à tout moment depuis votre tableau de bord.
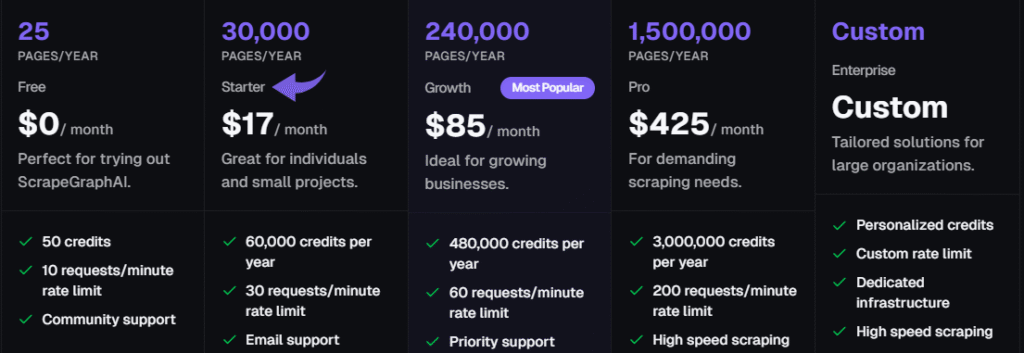
💰 Meilleur rapport qualité-prix : Croissance — un volume suffisant pour des projets de récupération réguliers sans surpayer.
ScrapeGraphAI vs Alternatives
Comment se compare ScrapeGraphAI ? Voici un aperçu :
| Outil | Idéal pour | Prix | Notation |
|---|---|---|---|
| ScrapeGraphAI | Extraction native de l'IA | 17 $/mois | ⭐ 4,5 |
| Scrapy | Exploration du code en premier | Gratuit | ⭐ 4,4 |
| Parcourir l'IA | Surveillance sans code | 48 $/mois | ⭐ 4,3 |
| Données claires | Réseau proxy | 0,50 $/mois | ⭐ 4,5 |
| Octoparse | Extraction visuelle | 99 $/mois | ⭐ 4,3 |
| ScrapingBee | Sites nécessitant un rendu important | 49 $/mois | ⭐ 4,4 |
Sélection rapide :
- Meilleur résultat global : ScrapeGraphAI — l'extraction de langage naturel surpasse les sélecteurs rigides.
- Meilleur budget : Scrapy — gratuit si vous savez écrire le code vous-même.
- Idéal pour les débutants : Navigation IA — pointer et cliquer, sans script.
- Idéal pour les proxys : Bright Data — un immense pool de proxys rotatif.
🎯 Alternatives à ScrapeGraphAI
Vous cherchez des alternatives à ScrapeGraphAI ? Voici les meilleures options :
- 🚀 Scrapy : Framework Python open source pour les développeurs qui souhaitent un contrôle total sur chaque exploration.
- 👶 Parcourir l'IA : Outil sans code qui enregistre vos clics et transforme n'importe quel site en API.
- 🏢 Données brillantes : Réseau de proxys d'entreprise avec un grand nombre d'adresses IP rotatives pour le scraping à grande échelle.
- 🎨 Octoparse : Outil d'extraction de données visuel par pointer-cliquer destiné aux non-programmeurs qui créent des projets d'extraction de données.
- 🔧 ScrapingBee : Une API qui permet d'afficher les sites web riches en JavaScript, vous évitant ainsi de configurer votre navigateur.
Pour la liste complète, consultez notre Alternatives à ScrapeGraphAI guide.
⚔️ Comparaison avec ScrapeGraphAI
Voici comment ScrapeGraphAI se compare à chacun de ses concurrents :
- ScrapeGraphAI contre Scrapy : ScrapeGraphAI l'emporte en termes de rapidité d'obtention du premier résultat ; Scrapy l'emporte en termes de contrôle brut offert aux développeurs.
- ScrapeGraphAI vs Browse AI : ScrapeGraphAI gère les pages plus complexes ; Browse AI est plus simple pour les mises en page fixes et répétitives.
- ScrapeGraphAI contre Bright Data : Bright Data est leader en matière de proxys ; ScrapeGraphAI est leader dans la transformation des pages en données structurées.
- ScrapeGraphAI contre Octoparse : ScrapeGraphAI s'adapte aux changements des sites web ; Octoparse vous oblige à reconstruire les modèles.
- ScrapeGraphAI contre ScrapingBee : Les deux systèmes permettent de traiter des sites complexes, mais ScrapeGraphAI utilise également des modèles d'IA pour analyser le contenu.
Commencez à utiliser ScrapeGraphAI dès maintenant
Vous avez appris à utiliser toutes les principales fonctionnalités de ScrapeGraphAI :
- ✅ Scraper intelligent
- ✅ Extracteur de données de recherche
- ✅ Markdownify
- ✅ Agent Spidy
- ✅ Extraction universelle de données
- ✅ Intégrations faciles
- ✅ Extracteur d'agents intelligents
- ✅ Planificateur de tâches
- ✅ Interface simple
Voici les principaux avantages en un coup d'œil :
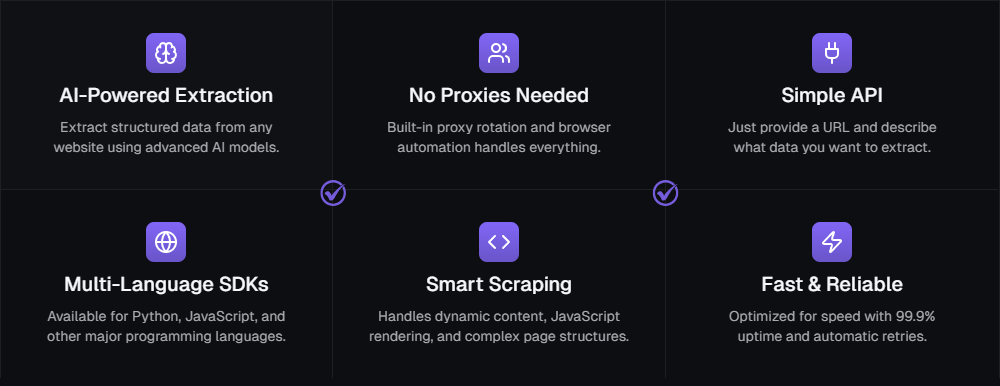
Étape suivante : Choisissez une fonctionnalité et essayez-la dès maintenant.
La plupart des gens commencent par utiliser le logiciel d'extraction de données de pages uniques Smart Scraper.
L'extraction des données de votre première page prend moins de cinq minutes.
Foire aux questions
ScrapeGraphAI est-il gratuit à utiliser ?
Oui. Le forfait gratuit couvre l'extraction de données web de base sans frais, et les forfaits payants commencent à 17 $/mois lorsque vous avez besoin de plus de volume ou de fonctionnalités.
Ai-je besoin de savoir programmer ?
Non. Vous pouvez utiliser ScrapeGraphAI depuis un tableau de bord sans code avec des invites en langage naturel, bien qu'une API Python soit disponible si vous le souhaitez.
Quels sont les grands modèles de langage qu'il prend en charge ?
Il fonctionne avec plusieurs fournisseurs de modèles LLM, notamment des modèles OpenAI comme GPT 4o, Anthropic, Google Gemini et des modèles locaux via Ollama.
Peut-il gérer les sites web utilisant beaucoup de JavaScript ?
Oui. Le Smart Agentic Scraper traite d'abord le contenu dynamique, ce qui lui permet de lire les sites riches en JavaScript qui posent problème aux scrapers traditionnels.
Comment éviter d'être bloqué ?
Respectez les conditions d'utilisation du site web, ajoutez des délais pour éviter les erreurs liées à un trop grand nombre de requêtes et utilisez des proxys rotatifs pour éviter les blocages d'adresse IP pendant le scraping.













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
