
クイックスタート
このガイドでは、ScrapeGraphAIのすべての機能について説明します。
- はじめる — アカウントを作成し、APIキーを追加してください
- Smart Scraperの使い方 — 平易な自然言語プロンプトを使用して、任意の単一ページから構造化データを取得する
- 検索スクレイパーの使い方 ― 各リンクを自分で開かずに、ライブ検索結果から直接ウェブデータを収集する
- Markdownifyの使い方 —ウェブコンテンツを、AIモデルが余計なノイズなしで読み取れるクリーンなMarkdown形式に変換する
- スパイディエージェントの使い方 大規模なスクレイピングプロジェクト向けに、マルチページスクレイパーとして複数のページをクロールする
- ユニバーサルデータ抽出の使い方 — 製品データ、ニュース記事など、さまざまなデータ抽出タスクを処理する
- Easy Integrationsの使い方 抽出したデータを数分でデータサイエンスおよび機械学習モデルに接続できます。
- Smart Agentic Scraperの使い方 — 従来のスクレイパーでは処理できないJavaScriptを多用したサイトの動的コンテンツを読み取る
- ジョブスケジューラの使い方 ― スクレイピング操作をスケジュールに基づいて実行し、データ抽出を自動的に繰り返す
- シンプルなインターフェースの使い方 — 高度な技術的専門知識がなくても、ノーコードのダッシュボードからScrapeGraphAIを効果的に活用できます。
所要時間: 各作品につき5分
このガイドには以下の内容も含まれています。 プロのヒント | よくある間違い | トラブルシューティング | 価格 | 代替案
このガイドを信頼する理由
私はScrapeGraphAIを実際に使用し、この「ScrapeGraphAIの使い方」チュートリアルに記載されているすべての機能を自分でテストしました。
ScrapeGraphAIの使い方に関するこの解説は、ベンダーのスクリーンショットではなく、実際のスクレイピングプロジェクトに基づいています。

ScrapeGraphAIは、乱雑なWebをAIで変換するツールです。 データ 構造化データに高速に変換する。
大規模な言語モデルを用いて、人間がページを読むのと同じようにページを読み上げます。
このインテリジェントなウェブスクレイピング手法は、多くのウェブスクレイピング作業において、ウェブスクレイピングを簡素化するのに役立ちます。
以下では、スクリーンショットとプロのヒントを交えながら、主要な機能を一つずつステップごとに解説します。
ScrapeGraphAIチュートリアル
このScrapeGraph AIの使い方チュートリアルでは、セットアップから高度なデータ抽出まで、スクレイピングの全プロセスを順を追って説明します。
スクレイプグラフAI
自然言語プロンプトを使って、あらゆるウェブサイトをクリーンで構造化されたデータに変換します。ScrapeGraphAIは、大規模な言語モデルと直接的なグラフロジックを組み合わせることで、データを高速に抽出します。無料で始められ、クレジットカードは不要です。
ScrapeGraphAI の利用開始
いずれかの機能を使用する前に、この初回セットアッププロセスを完了してください。
まずはこちらの簡単な概要をご覧ください。
それでは、各ステップを順を追って見ていきましょう。
ステップ1:アカウントとAPIキーを作成する
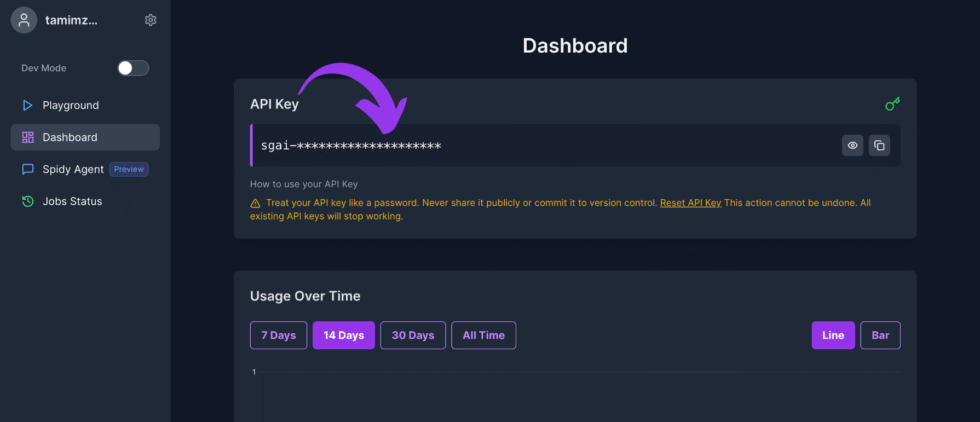
ScrapeGraphAIのダッシュボードに登録し、「キー」タブを開いてください。
ScrapeGraphAIのAPIキーをコピーしてください。すべてのリクエストにはそのAPIキーが必要です。
✓ チェックポイント: ダッシュボードに有効なAPIキーが表示されています。
ステップ2:ScrapeGraphAIをインストールする
クリーンな仮想環境を作成し、pipを使用してScrapeGraphAIをインストールします。
スクリプトに以下を追加 import os そして クライアントをインポート APIキーを安全に読み込むため。
ダッシュボードの画面は以下のようになります。
✓ チェックポイント: ライブラリはエラーなくインポートされます。
ステップ3:言語モデルを選択する
最初の実行では、GPT 40などの言語モデルを選択してください。
ScrapeGraphAIは複数のLLMプロバイダーをサポートしているため、AIモデルをいつでも切り替えることができます。
✅ 完了: ScrapeGraphAIは、以下のすべての機能にご利用いただけます。
ScrapeGraphAIスマートスクレイパーの使い方
スマートスクレイパー 自然言語による簡単なプロンプトを使用して、任意のページから構造化データを取得できます。
以下に、その使用方法をステップごとに説明します。
ステップ1:シングルページスクレイパーを開く
シングルページスクレイパーを選択し、ターゲットURLを1つ貼り付けてください。
ステップ2:自然言語プロンプトを作成する
ウェブページから抽出したいフィールドを説明してください。
これは以下のようなものです。
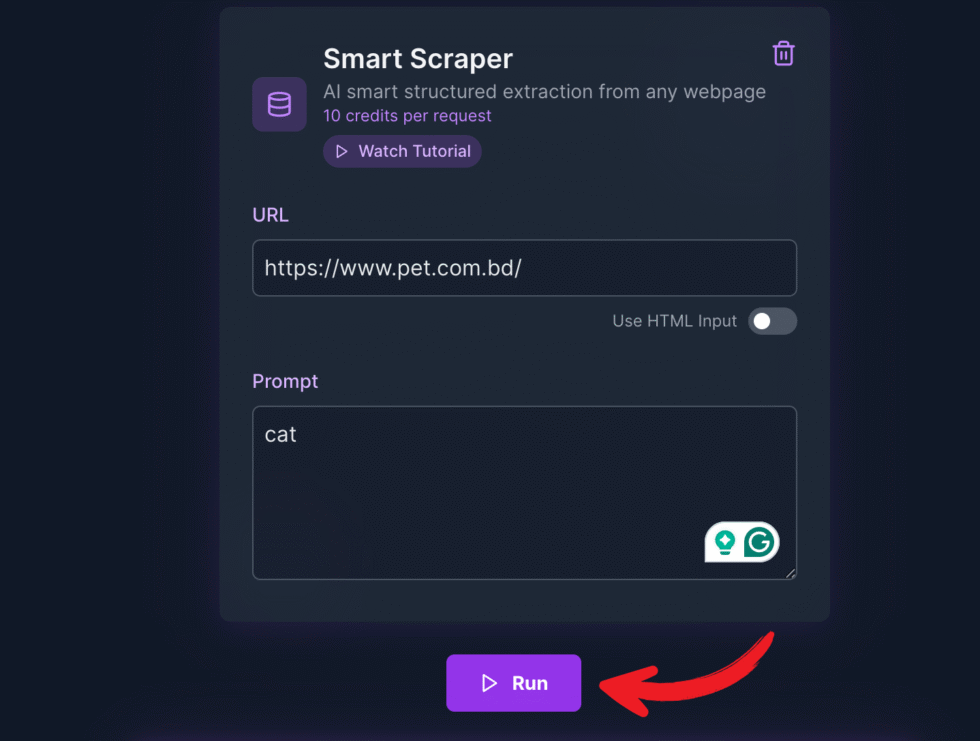
✓ チェックポイント: 出力結果は、あなたが要求したフィールドと一致しています。
ステップ3:JSONを実行して読み込む
実行すると、構造化された形式でクリーンなJSONデータが読み込まれます。
✅ 結果: あなたはわずか数秒で1ページを構造化データにスクレイピングしました。
💡 プロのヒント: より正確な抽出を行うために、必要なJSONキーを具体的に記述した詳細なプロンプトを作成してください。
ScrapeGraphAI検索スクレイパーの使い方
検索スクレイパー 個々のリンクを開かなくても、ライブ検索結果から直接ウェブデータを収集できます。
以下に、その使用方法をステップごとに説明します。
ステップ1:クエリを入力してください
クエリを入力すると、リアルタイムの検索結果が表示されます。
ステップ2:収集するものを設定する
各検索結果から抽出するウェブデータを指定します。
これは以下のようなものです。
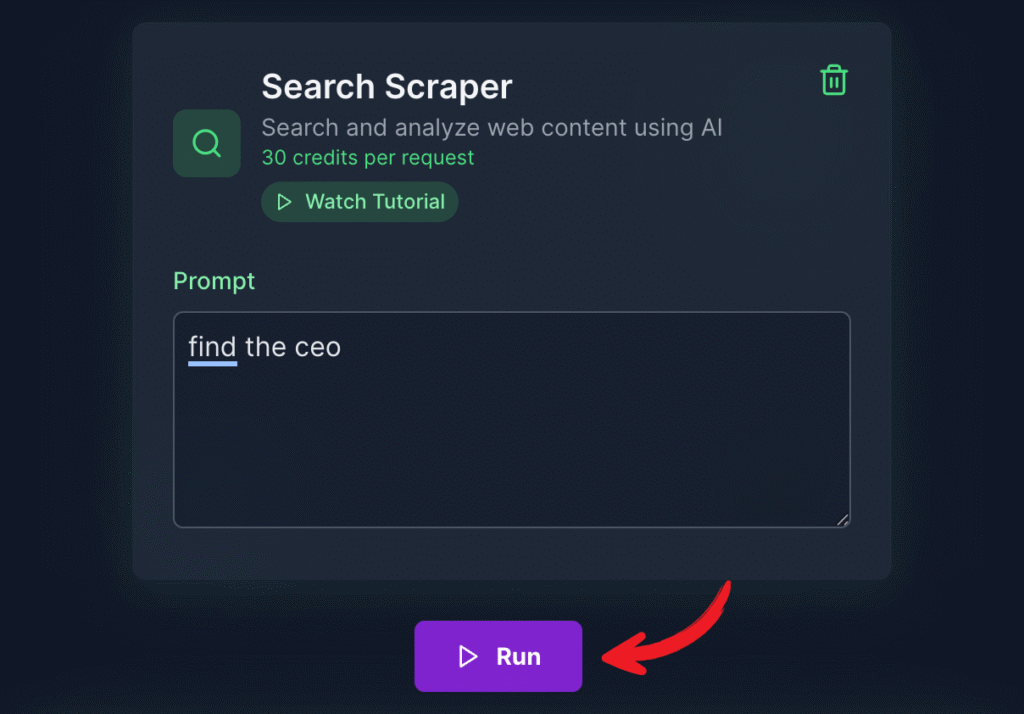
✓ チェックポイント: 出力結果は、あなたが要求したフィールドと一致しています。
ステップ3:出力をエクスポートする
すぐに使えるJSON形式で、有益なデータを取得します。
✅ 結果: あなたは検索結果を、利用可能なウェブデータに変換しました。
💡 プロのヒント: 検索結果を絞り込み、分かりやすくするために、まず検索条件を絞り込んでください。
ScrapeGraphAI Markdownifyの使い方
マークダウン化 ウェブコンテンツを、AIモデルが余計なノイズなしで読み取れるクリーンなMarkdown形式に変換できます。
以下に、その使用方法をステップごとに説明します。
ステップ1:ページのURLを貼り付ける
複雑なHTML構造を持つURLをドロップしてください。
ステップ2:マークダウンに変換する
Markdownifyは、ウェブコンテンツをクリーンなMarkdown形式に変換します。
これは以下のようなものです。
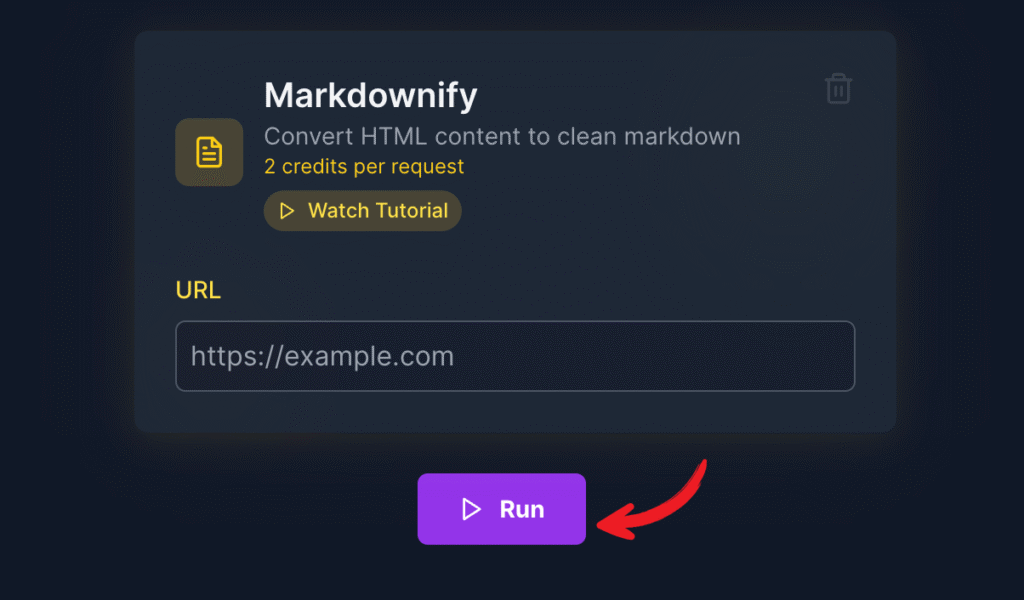
✓ チェックポイント: 出力結果は、あなたが要求したフィールドと一致しています。
ステップ3:クリーンなデータを再利用する
クリーンなデータをモデルまたはメモに入力してください。
✅ 結果: ページをクリーンでモデルに適した形式に変換しました。 文章.
💡 プロのヒント: Markdown出力は、AIを活用した要約の入力として最適です。
ScrapeGraphAI Spidy Agent の使い方
スパイディエージェント 複数のページをクロールできるマルチページスクレイパーとして機能し、大規模なスクレイピングプロジェクトに対応します。
以下に、その使用方法をステップごとに説明します。
ステップ1:スタートページを追加する
スパイディエージェントに、クロール開始用のリンクを与えてください。
ステップ2:クロール深度を設定する
数ページだけをスクレイピングするか、複数ページをスクレイピングするかを選択してください。
これは以下のようなものです。
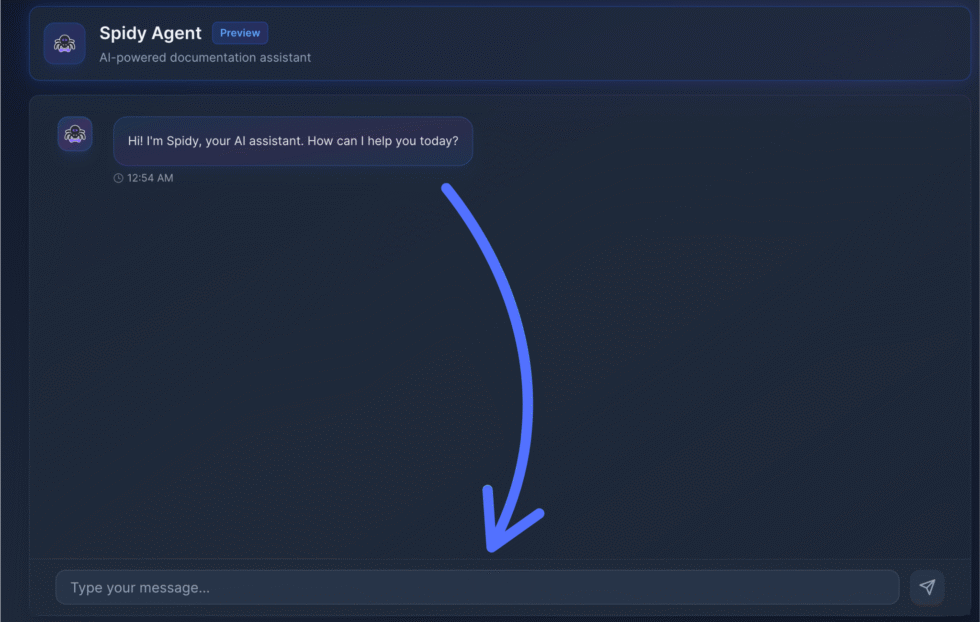
✓ チェックポイント: 出力結果は、あなたが要求したフィールドと一致しています。
ステップ3:大規模に収集する
大規模なスクレイピング作業は、このマルチページスクレイパーにお任せください。
✅ 結果: 一度の実行で複数のページをクロールしました。
💡 プロのヒント: 大規模なスクレイピングを実行する前に、まずは数ページでテストしてみましょう。
ScrapeGraphAIユニバーサルデータ抽出の使い方
ユニバーサルデータ抽出 製品データ、ニュース記事など、さまざまなデータ抽出タスクを処理できます。
以下に、その使用方法をステップごとに説明します。
ステップ1:情報源を選択する
製品データ、ニュース記事、または任意のウェブページを指定してください。
ステップ2:スキーマを定義する
抽出するデータの構造化フォーマットを設定します。
これは以下のようなものです。
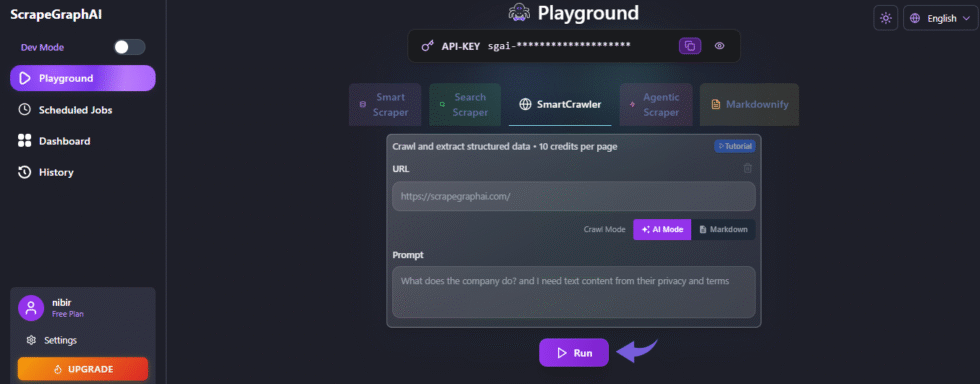
✓ チェックポイント: 出力結果は、あなたが要求したフィールドと一致しています。
ステップ3:データの取得
データ抽出タスクを実行し、出力結果を確認してください。
✅ 結果: あなたは複数のデータ抽出タスクを同時に処理しました。
💡 プロのヒント: すべてのレコードの構造を固定するために、Pydanticスキーマを定義します。
ScrapeGraphAIの簡単な連携方法
簡単な統合 抽出したデータを、データサイエンスや機械学習モデルに数分で接続できます。
以下に、その使用方法をステップごとに説明します。
ステップ1:APIを開く
API を介してスクリプトやアプリに接続してください。
ステップ2:データを下流に送信する
抽出したデータをデータパイプラインにルーティングします。
これは以下のようなものです。
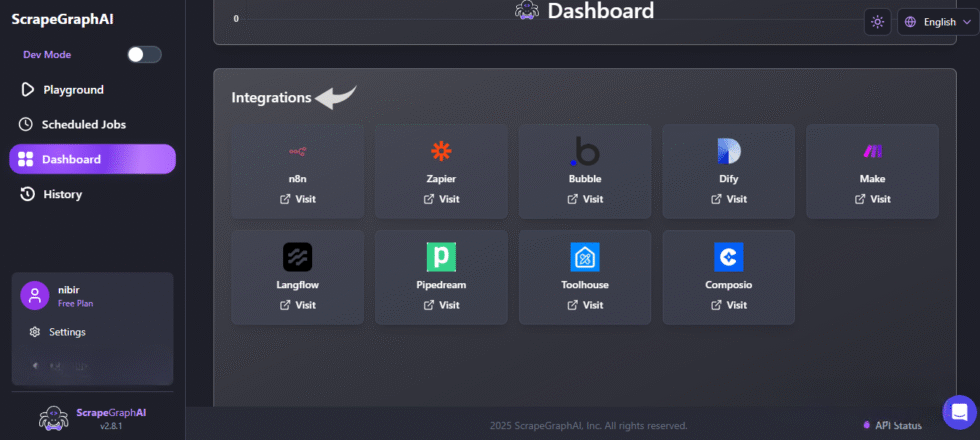
✓ チェックポイント: 出力結果は、あなたが要求したフィールドと一致しています。
ステップ3:モデルにデータを入力する
データを機械学習モデルとAIエージェントに渡す。
✅ 結果: 抽出されたデータがスタックに取り込まれます。
💡 プロのヒント: Make.comに接続するか、 n8n データパイプラインを拡張するため。
ScrapeGraphAIスマートエージェントスクレイパーの使い方
スマートエージェントスクレイパー JavaScriptを多用するサイトで動的なコンテンツを読み取れるようにする スクレーパー.
以下に、その使用方法をステップごとに説明します。
ステップ1:トリッキーなサイトを読み込む
コンテンツを隠してしまうJavaScriptを多用したサイトの画像を貼り付けてください。
ステップ2:エージェントにレンダリングさせる
エージェントは動的コンテンツを読み込む前に、それをロードします。
これは以下のようなものです。
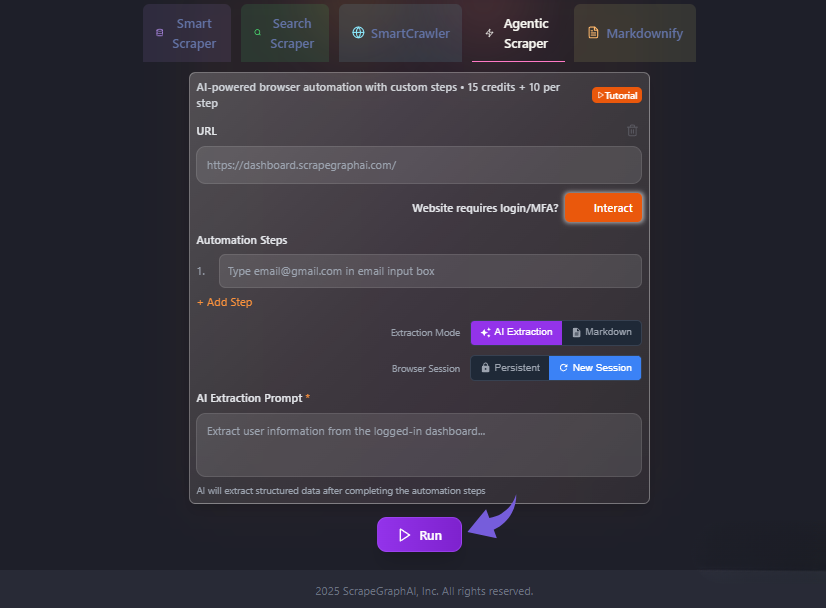
✓ チェックポイント: 出力結果は、あなたが要求したフィールドと一致しています。
ステップ3:安定した結果を得る
従来のスクレイパーとは異なり、ウェブサイトの変更に合わせて自動的に調整されます。
✅ 結果: JavaScriptを多用したサイトも、きれいに読み込める。
💡 プロのヒント: ボット対策が厳しいサイトでは、プロキシをローテーションさせるのと併用すると良いでしょう。
ScrapeGraphAIジョブスケジューラーの使い方
仕事 スケジューラ スケジュールに基づいてスクレイピング操作を実行できるため、データ抽出が自動的に繰り返されます。
以下に、その使用方法をステップごとに説明します。
ステップ1:ジョブを作成する
傷をつける作業を繰り返し可能な作業として保存する。
ステップ2:ケイデンスを設定する
スクレイピング操作を実行する頻度を選択してください。
これは以下のようなものです。
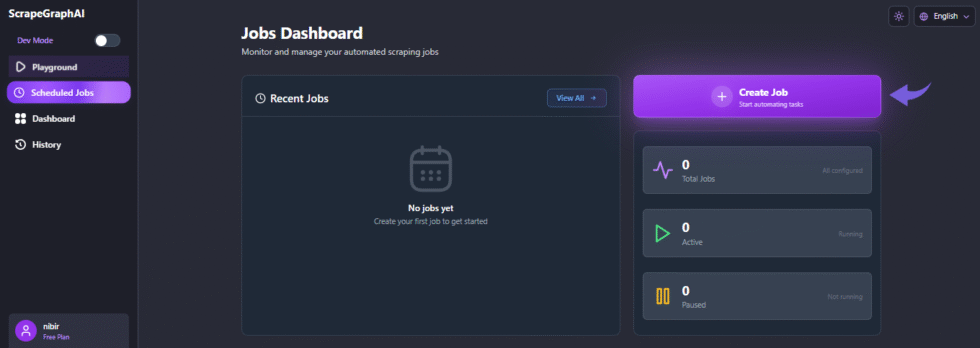
✓ チェックポイント: 出力結果は、あなたが要求したフィールドと一致しています。
ステップ3:実行させる
スクレイピング処理は繰り返され、新しいデータが保存される。
✅ 結果: スクレイピングデータは自動的に更新されるようになりました。
💡 プロのヒント: 一度に大量のリクエストが発生しないように、ジョブの実行時間をずらしてください。
ScrapeGraphAIのシンプルなインターフェースの使い方
シンプルなインターフェース ScrapeGraphAIを使えば、高度な技術的専門知識がなくても、ノーコードのダッシュボードから効果的にScrapeGraphAIを利用できます。
以下に、その使用方法をステップごとに説明します。
ステップ1:ダッシュボードを開く
AI搭載ダッシュボードをご利用ください。コードを書く必要はありません。
ステップ2:コードを書かずに構築する
高度な技術的専門知識がなくてもジョブを実行できる。
これは以下のようなものです。
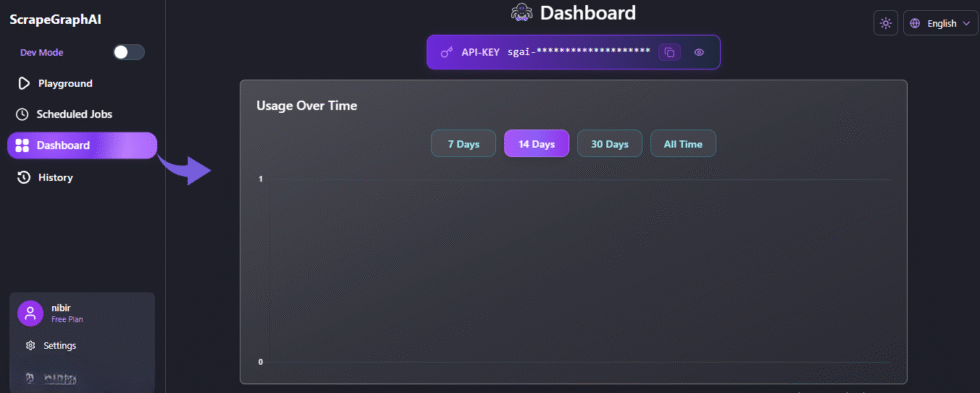
✓ チェックポイント: 出力結果は、あなたが要求したフィールドと一致しています。
ステップ3:すべてを管理する
すべてのスクレイピングを追跡し、ScrapeGraphAIを1つの画面から効果的に活用できます。
✅ 結果: あなたはコードを一切使わずに、完全なスクレイピングを実行しました。
💡 プロのヒント: 保存したジョブをブックマークしておけば、複数のスクレイピングプロジェクトで再利用できます。
ScrapeGraphAIのプロ向けヒントとショートカット
6ヶ月間スクレイピングプロジェクトに携わってきた経験から、私のとっておきのコツをご紹介します。
クイックセットアップショートカット
| ゴール | ショートカット |
|---|---|
| デバッグ実行 | 詳細なログ記録を可能にする詳細モード |
| 出力を保存する | JSONファイルまたはCSVファイルにエクスポート |
| ブロックを避ける | ローテーションプロキシを追加する |
| ロック構造 | ピダンティック図式 |
ほとんどの人が見逃す隠れた機能
- 詳細なログ記録: 各ノードの詳細なログ記録を有効にする冗長フラグ。これにより、エラー処理がはるかに容易になります。
- プロキシローテーション: プロキシをローテーションすることで、APIレート制限を回避し、保護されたサイトでのIPブロックを防ぐことができます。
- ローカルモデル: Ollama経由でオープンモデルを実行することで、トークンごとに料金を支払うことなく情報を抽出できます。
ScrapeGraphAIでよくある間違いを避ける方法
間違い:ウェブサイトの利用規約を無視する
❌ 間違い: ウェブサイトの利用規約や法的考慮事項を事前に確認せずにスクレイピングを行うこと。
✅ 右: データスクレイピングを実行する前に、サイトのポリシーを読み、ウェブサイトの利用規約を遵守してください。
間違い:サーバーに過負荷をかける
❌ 間違い: リクエストをあまりにも速く送信するため、サイトがリクエスト過多エラーを返します。
✅ 右: APIのレート制限を超えないように、リクエスト間に遅延を設けてください。
ミス:指示が曖昧
❌ 間違い: 乱雑なデータを返す、緩やかな自然言語プロンプトを作成する。
✅ 右: 毎回クリーンなデータが得られるように、正確なフィールドとスキーマを指定してください。
ScrapeGraphAIのトラブルシューティング
問題: リクエストが多すぎるエラー
原因: リクエストをあまりにも速く送信したため、APIのレート制限に達しました。
修理: 通話の間隔を空けたり、遅延時間を追加したり、より高い限度額のプランにアップグレードしたりしましょう。
問題:結果が空白または部分的
原因: 対象サイトはJavaScriptを多用しているため、動的コンテンツの読み込みが遅れる。
修理: ページを読み込む前にレンダリングするスマートエージェントスクレイパーに切り替えてください。
問題: ブロックされる、またはIPブロックされる
原因: このサイトはスクレイピング行為を検知し、ブロックページを表示します。
修理: プロキシをローテーションさせることで、各リクエストがまるで新しい訪問者からのリクエストのように見えるようにします。
📌 注記: これらは最も一般的な課題を網羅しています。その他の課題については、ScrapeGraphAIのサポートにお問い合わせください。
ScrapeGraphAIとは何ですか?
スクレイプグラフAI は、インテリジェントなウェブスクレイピングのためのオープンソースのPythonライブラリです。
これは、大規模言語モデル(LLM)と直接的なグラフロジックを組み合わせて、スクレイピングパイプラインを構築します。
スクレイピンググラフの各ノードは1つのタスクを実行するため、データ抽出の更新が容易になります。
スマートな アシスタント ウェブページを読み込み、クリーンなJSONデータを返す。
こちらの簡単な概要をご覧ください。
主な機能は以下のとおりです。
- スマートスクレイパー: 自然言語による簡単なプロンプトを使用して、任意の単一ページから構造化データを取得する
- 検索スクレイパー: 各リンクを自分で開かずに、ライブ検索結果から直接ウェブデータを収集します。
- マークダウン化: ウェブコンテンツを、AIモデルが余計なノイズなしで読み取れるクリーンなMarkdown形式に変換する。
- スパイディエージェント: 大規模なスクレイピングプロジェクト向けに、マルチページスクレイパーとして複数のページをクロールします。
- ユニバーサルデータ抽出: 製品データ、ニュース記事など、さまざまなデータ抽出タスクを処理する
- 簡単な統合: 抽出したデータを数分でデータサイエンスおよび機械学習モデルに接続できます
- スマートエージェントスクレイパー: JavaScriptを多用するサイトで動的コンテンツを読み取るため、従来のスクレイパーが機能しなくなる
- ジョブスケジューラー: スクレイピング操作をスケジュールに基づいて実行し、データ抽出を自動的に繰り返す。
- シンプルなインターフェース: ScrapeGraphAIを高度な技術的専門知識がなくても、ノーコードダッシュボードから効果的に活用する
文脈を読み取ることができるため、ウェブサイトのレイアウトが変更された場合でも、意味のあるデータを抽出できます。
ウェブページやローカル文書は読み取れますが、音声ファイルの文字起こしはできません。
平易な自然言語による指示を用いることで、ニュース記事などのデータを利用して感情分析を行うことができます。
詳細なレビューについては、こちらをご覧ください。 ScrapeGraphAIのレビュー.
ScrapeGraphAIの価格設定
ScrapeGraphAIの2026年のコストは以下のとおりです。
| プラン | 価格 | 最適な用途 |
|---|---|---|
| 無料 | $0 | いくつかのページでテストを実施 |
| スターター | 月額17ドル | 単独のデータ抽出タスク |
| 成長 | 月額85ドル | 定期的なスクレイピングプロジェクト |
| プロ | 月額425ドル | 大規模な削り取り |
| 企業 | カスタム | 大量処理チーム |
無料トライアル: はい、無料プランではデータスクレイピングを無料でテストできます。
返金保証: ダッシュボードからいつでもキャンセルできます。
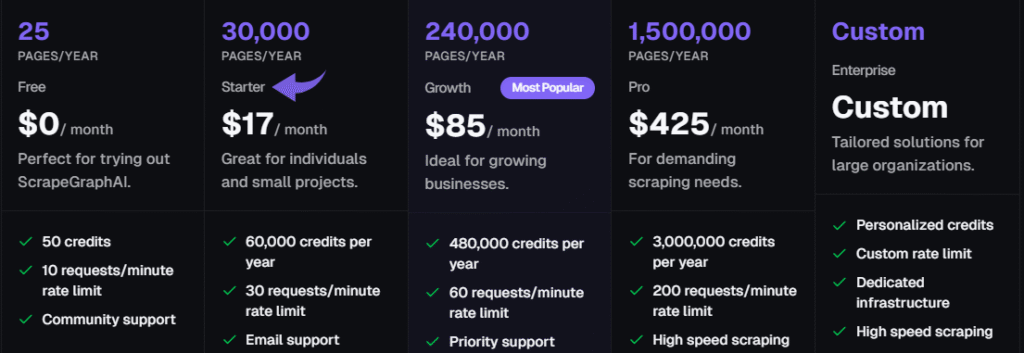
💰 最もお得な価格: 成長――過剰な費用をかけずに、安定したスクレイピングプロジェクトを実施できるだけの十分な量。
ScrapeGraphAIと代替手段の比較
ScrapeGraphAIは他社製品と比べてどうでしょうか?以下に概要を示します。
| 道具 | 最適な用途 | 価格 | 評価 |
|---|---|---|---|
| スクレイプグラフAI | AIネイティブ抽出 | 月額17ドル | ⭐ 4.5 |
| スクレイピー | コードファーストのクローリング | 無料 | ⭐ 4.4 |
| AIを閲覧する | ノーコード監視 | 月額48ドル | ⭐ 4.3 |
| ブライトデータ | プロキシネットワーク | 月額0.50ドル | ⭐ 4.5 |
| Octoparse | ビジュアルスクレイピング | 月額99ドル | ⭐ 4.3 |
| スクレイピングビー | レンダリング負荷の高いサイト | 月額49ドル | ⭐ 4.4 |
おすすめ商品:
- 総合ベスト: ScrapeGraphAI ― 自然言語抽出は、厳密なセレクターよりも優れている。
- ベスト予算: Scrapy ― 自分でコードを書けるなら無料です。
- 初心者におすすめ: AIによるブラウジング ― ポイント&クリック操作、スクリプト不要。
- プロキシに最適: Bright Data ― 巨大なローテーション型プロキシプール。
🎯 ScrapeGraphAIの代替案
ScrapeGraphAIの代替ツールをお探しですか?おすすめの選択肢をご紹介します。
- 🚀 スクレイピー: クロール処理を完全に制御したい開発者向けのオープンソースPythonフレームワーク。
- 👶 ブラウズAI: クリックを記録し、あらゆるサイトをAPIに変えるノーコードツール。
- 🏢 ブライトデータ: 大規模なスクレイピングに対応する、大量のローテーションIPを備えたエンタープライズプロキシネットワーク。
- 🎨 オクトパース: プログラミングの知識がない人でもスクレイピングプロジェクトを構築できるように設計された、視覚的なポイント&クリック操作のスクレイパー。
- 🔧 スクレイピングビー: JavaScriptを多用するサイトをレンダリングするためのAPIなので、ブラウザの設定を自分で行う必要がありません。
全リストについては、こちらをご覧ください。 ScrapeGraphAIの代替品 ガイド。
⚔️ ScrapeGraphAI との比較
ScrapeGraphAIと各競合製品との比較は以下のとおりです。
- ScrapeGraphAIとScrapyの比較: ScrapeGraphAIは最初の結果までのスピードで勝り、Scrapyはプログラマー向けの高度な制御機能で勝る。
- ScrapeGraphAIとBrowse AIの比較: ScrapeGraphAIは複雑なページを処理するのに適しており、Browse AIは固定された繰り返しレイアウトの処理にシンプルに対応します。
- ScrapeGraphAIとBright Dataの比較: Bright Dataはプロキシ分野で、ScrapeGraphAIはウェブページを構造化データに変換する分野でそれぞれリードしている。
- ScrapeGraphAIとOctoparseの比較: ScrapeGraphAIはウェブサイトの変更に合わせて自動的に適応しますが、Octoparseではテンプレートを再構築する必要があります。
- ScrapeGraphAIとScrapingBeeの比較: どちらもハードサイトをレンダリングするが、ScrapeGraphAIはAIモデルを用いてコンテンツに関する推論も行う。
今すぐScrapeGraphAIを使い始めましょう
ScrapeGraphAIの主要な機能をすべて使いこなせるようになりました。
- ✅ スマートスクレイパー
- ✅ 検索スクレイパー
- ✅ マークダウン化
- ✅ スパイディエージェント
- ✅ ユニバーサルデータ抽出
- ✅ 簡単な統合
- ✅ スマートエージェントスクレイパー
- ✅ ジョブスケジューラー
- ✅ シンプルなインターフェース
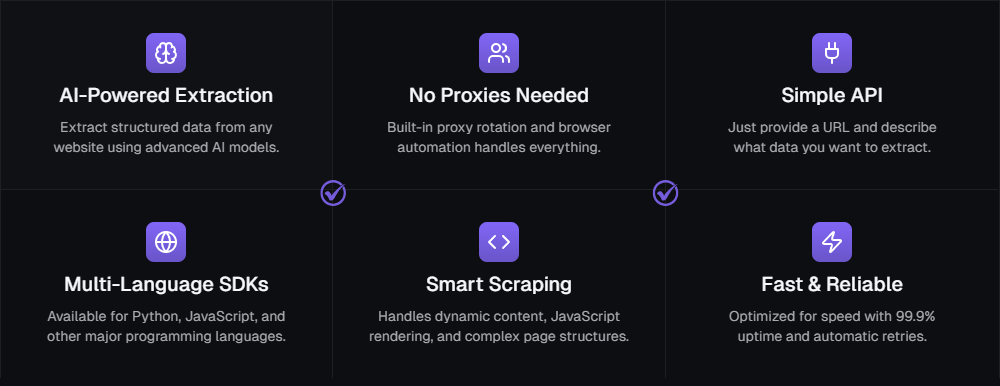
主なメリットを以下に簡単にまとめました。
次のステップ: どれか一つの機能を選んで、今すぐ試してみてください。
ほとんどの人は、Smart Scraperのシングルページスクレイパーから始めます。
最初のページからデータを抽出するのにかかる時間は5分未満です。
よくある質問
ScrapeGraphAIは無料で利用できますか?
はい。無料プランでは基本的なウェブスクレイピングが無料で利用でき、より多くのデータ量や機能が必要な場合は、月額17ドルからの有料プランをご利用いただけます。
プログラミングの知識は必要ですか?
いいえ。ScrapeGraphAIは、自然言語によるプロンプトを備えたノーコードダッシュボードから使用できますが、必要であればPython APIも利用可能です。
どの大規模言語モデルをサポートしていますか?
GPT 4o、Anthropic、Google GeminiなどのOpenAIモデルや、Ollamaを介したローカルモデルなど、複数のLLMプロバイダーと連携して動作します。
JavaScriptを多用するサイトにも対応できますか?
はい。スマートエージェントスクレイパーは動的コンテンツを優先的にレンダリングするため、従来のスクレイパーでは読み取れないJavaScriptを多用したサイトも読み取ることができます。
ブロックされないようにするにはどうすればいいですか?
ウェブサイトの利用規約を遵守し、リクエスト過多によるエラーを回避するために遅延処理を追加し、スクレイピング中にIPアドレスがブロックされないようにローテーションプロキシを使用してください。













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
