
Démarrage rapide
Ce guide d'utilisation de ScrapingBee couvre toutes ses fonctionnalités :
- Commencer — Créez votre compte et obtenez votre clé API
- Comment utiliser le web scraping par IA — extraire des informations structurées complexes de pages Web en utilisant un anglais simple
- Comment utiliser l'API de recherche Google — Extraire les résultats de recherche Google sans gérer soi-même les adresses IP des proxys
- Comment utiliser un scraper Google Shopping ? — collecter les listes de produits et le prix extrait pour n'importe quel terme de recherche
- Comment utiliser le web scraping en JavaScript — gérer le rendu JavaScript sur les pages web construites avec React ou Vue
- Comment utiliser ChatGPT Scraper — Capture des réponses et du code source des pages de chat dynamiques IA
- Comment utiliser l'API Google News Scraper — Récupérer les titres et les articles complets via de simples requêtes API
- Comment utiliser le web scraping rapide — Exécutez une extraction de données rapide pendant que ScrapingBee gère la rotation des proxys pour vous
- Comment utiliser l'API de capture d'écran programmatique — Capturer par programmation une capture d'écran de la page entière de n'importe quelle URL
- Comment utiliser Scrape Google Jobs — rassembler les offres d'emploi sous forme d'informations structurées complexes
Temps nécessaire : 5 minutes par fonctionnalité
Vous trouverez également dans ce guide : Conseils de pro | Erreurs courantes | Dépannage | Tarification | Alternatives
Pourquoi faire confiance à ce guide ?
J'utilise ScrapingBee depuis plus d'un an et j'ai testé toutes ses fonctionnalités. Ce tutoriel est basé sur une véritable expérience pratique de scraping, et non sur des captures d'écran fournies par le vendeur.

ScrapingBee est une solution basée sur le cloud. outil de grattage qui gère les aspects les plus complexes du web scraping.
Il gère les navigateurs sans interface graphique et fait tourner les proxys pour vous.
Ce guide vous montre comment utiliser chaque fonctionnalité principale étape par étape.
Avec des captures d'écran, un exemple simple et des conseils de pro tout au long du document.
Tutoriel ScrapingBee
Ce tutoriel complet sur ScrapingBee vous guide à travers chaque fonctionnalité, de votre première requête API aux astuces avancées pour les scénarios JavaScript.
ScrapingBee
Extrayez les données de n'importe quel site web sans gérer de proxy ni de navigateur sans interface graphique. ScrapingBee gère le rendu JavaScript via une API REST simple. Bénéficiez de 1 000 appels API gratuits pour commencer — aucune carte de crédit n'est requise.
Premiers pas avec ScrapingBee
Avant d'utiliser toute fonctionnalité, veuillez effectuer cette configuration unique.
Cela prend environ trois minutes.
Voici un aperçu rapide du flux de travail :
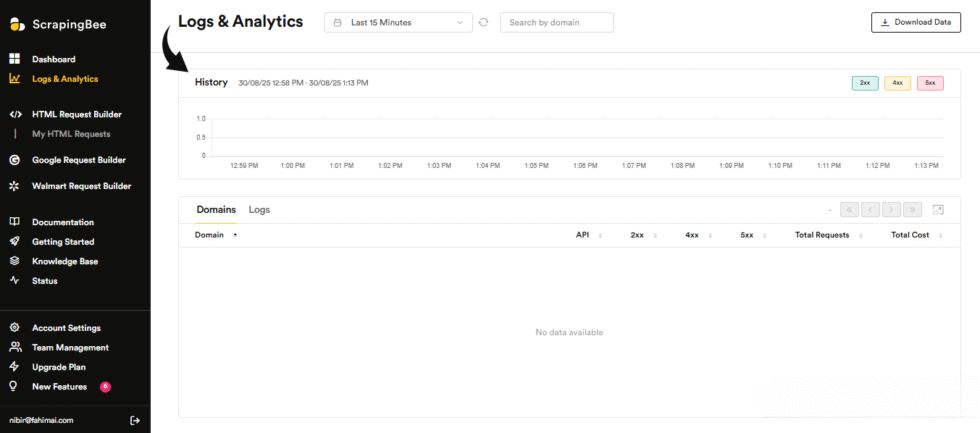
Passons maintenant en revue chaque étape.
Étape 1 : Créez votre compte
Rendez-vous sur le site Web de ScrapingBee et cliquez sur « S'inscrire ».
Saisissez le code promo ADNAN via le lien de parrainage pour obtenir un crédit API supplémentaire.
✓ Point de contrôle: Votre tableau de bord affiche votre clé API unique.
Étape 2 : Configurez votre code
En Python, exécutez pip install scrapingbee ou importez simplement requests.
La bibliothèque requests vous permet d'appeler l'API depuis n'importe quel langage de programmation.
✓ Point de contrôle: Votre environnement est prêt à envoyer des requêtes API.
Étape 3 : Passez votre premier appel
Envoyez une requête au point de terminaison https://app.scrapingbee.com/api/v1/ avec votre clé API et votre URL.
Ce simple exemple vous permet d'extraire des données de pages web avec seulement quelques lignes de code.
✅ Terminé : Vous êtes prêt à utiliser n'importe quelle fonctionnalité ci-dessous.
Comment utiliser le web scraping IA de ScrapingBee ?
Extraction de données Web par IA permet d'extraire des informations structurées complexes de pages web en utilisant un langage simple.
Voici comment l'utiliser étape par étape.
Étape 1 : Obtenez votre clé API
Inscrivez-vous et copiez votre clé API depuis le tableau de bord.
Étape 2 : Décrire les données
Ajoutez l'URL cible et rédigez une requête en langage clair.
Voici à quoi cela ressemble :
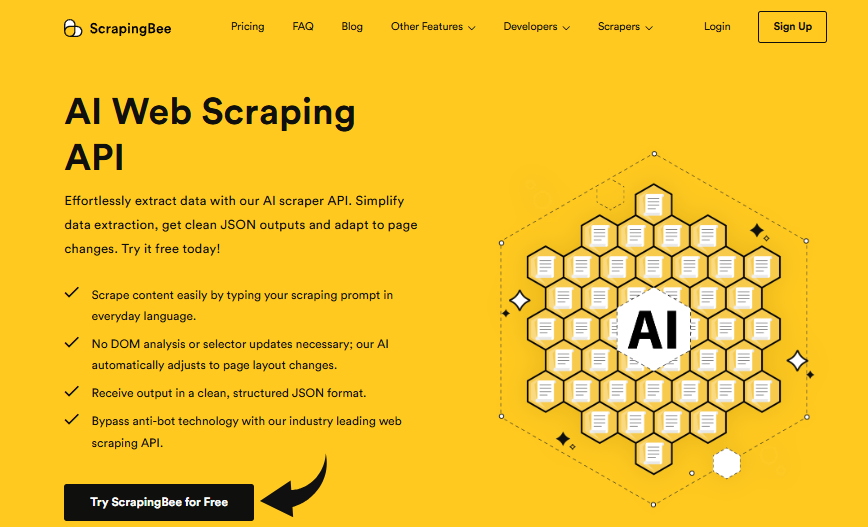
✓ Point de contrôle: Un objet JSON propre apparaît avec vos champs.
Étape 3 : Définir les règles d’extraction
Ajustez vos règles d'extraction pour capturer chaque champ avec précision.
✅ Résultat : JSON structuré sans avoir à écrire manuellement les sélecteurs CSS.
💡 Conseil de pro : Associez l'extraction par IA aux sélecteurs CSS lorsque vous avez besoin d'un contrôle précis.
Comment utiliser l'API de recherche Google de ScrapingBee ?
API de recherche Google vous permet de récupérer les résultats de recherche Google sans avoir à gérer vous-même les adresses IP des proxys.
Voici comment l'utiliser étape par étape.
Étape 1 : Choisir le point final
Adressez votre requête à l'API de recherche Google.
Étape 2 : Définir la requête
Ajoutez votre mot-clé et un pays aléatoire pour obtenir des résultats locaux.
Voici à quoi cela ressemble :
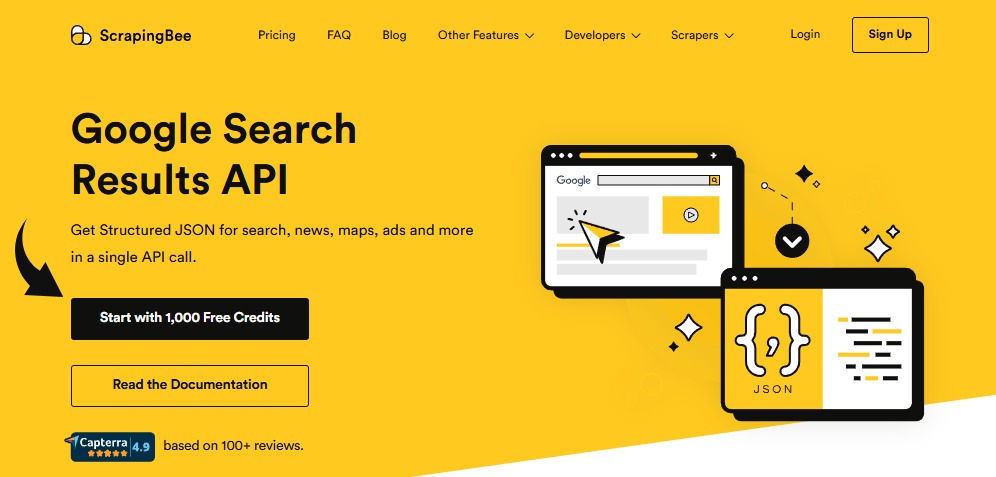
✓ Point de contrôle: Les résultats classés sont renvoyés sous forme de données structurées.
Étape 3 : Lire le JSON
Analysez la réponse avec la bibliothèque requests en Python.
✅ Résultat : Recherchez des données via un simple appel d'API REST.
💡 Conseil de pro : Utilisez le code pays pour la géolocalisation proxy premium sur chaque requête.
Comment utiliser ScrapingBee, le scraper de Google Shopping ?
Extracteur de données Google Shopping permet de collecter les listes de produits et le prix extrait pour n'importe quel terme de recherche.
Voici comment l'utiliser étape par étape.
Étape 1 : Envoyer une demande d'achat
Appelez le point de terminaison d'achat avec votre requête produit.
Étape 2 : Analyser la réponse
Associez chaque annonce à son titre, son lien et son prix extrait.
Voici à quoi cela ressemble :
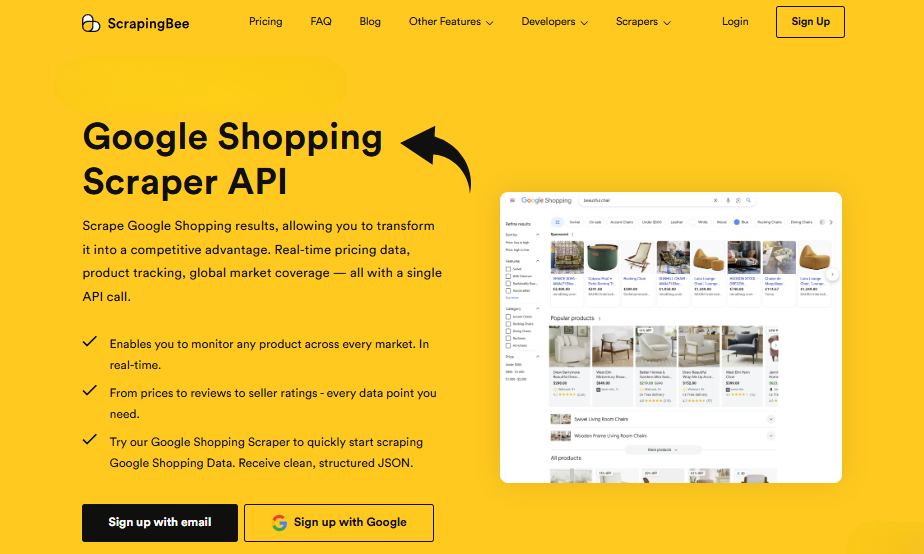
✓ Point de contrôle: Les lignes de produits sont renvoyées au format JSON propre.
Étape 3 : Exporter les résultats
Enregistrez les données au format CSV pour une analyse ultérieure.
✅ Résultat : Données de prix en temps réel, prêtes à être intégrées à n'importe quelle feuille de calcul.
💡 Conseil de pro : Planifier des exécutions pour suivre l'évolution du prix extrait au fil du temps.
Comment utiliser ScrapingBee JavaScript pour le web scraping
Extraction de données Web en JavaScript permet de gérer le rendu JavaScript sur les pages web construites avec React ou Vue.
Voici comment l'utiliser étape par étape.
Étape 1 : Activer render_js
Définissez render_js=true pour que ScrapingBee utilise les navigateurs sans interface graphique.
Étape 2 : Attendre un élément
Indiquez-lui d'attendre le chargement d'un élément particulier.
Voici à quoi cela ressemble :
✓ Point de contrôle: La page complète s'affiche avant l'extraction.
Étape 3 : Capturer le code HTML
Renvoyer le code HTML original ou le code source brut de la page après rendu.
✅ Résultat : Pages web entièrement rendues, sans pilotes web à gérer.
💡 Conseil de pro : Ajoutez un scénario JavaScript pour les clics, le défilement ou le remplissage de formulaires.
Comment utiliser le scraper ChatGPT de ScrapingBee ?
ChatGPT Grattoir permet de capturer les réponses et le code source des pages de chat dynamiques IA.
Voici comment l'utiliser étape par étape.
Étape 1 : Cibler la page
Envoyez l'URL de la page avec render_js activé.
Étape 2 : Rendu et extraction
Laissez le web scraping sans interface graphique charger la réponse, puis récupérez-la. texte.
Voici à quoi cela ressemble :
✓ Point de contrôle: La réponse générée est affichée dans le code source de la page.
Étape 3 : Enregistrer le résultat
Stockez le code HTML analysé pour un traitement ultérieur.
✅ Résultat : Texte propre extrait d'une page entièrement dynamique.
💡 Conseil de pro : Enchaînez un scénario JavaScript pour parcourir des invites à plusieurs étapes.
Comment utiliser l'API ScrapingBee Google News Scraper ?
API d'extraction de données Google News permet de récupérer les titres et les articles complets via de simples requêtes API.
Voici comment l'utiliser étape par étape.
Étape 1 : Définir le point de terminaison des actualités
Adressez votre requête à l'API Google Actualités.
Étape 2 : Ajouter des filtres
Filtrer par sujet, langue ou pays aléatoire.
Voici à quoi cela ressemble :
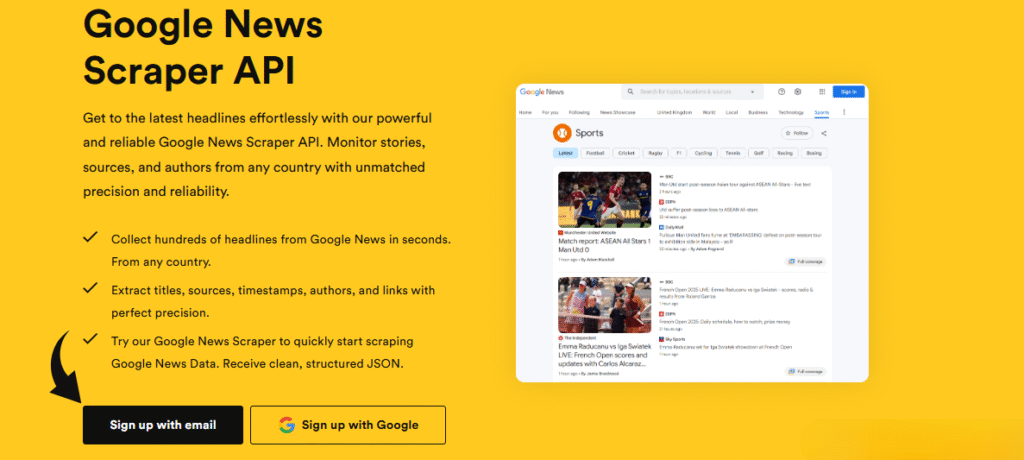
✓ Point de contrôle: Les titres correspondants sont renvoyés sous forme de données structurées.
Étape 3 : Collecter les articles
Parcourez les résultats pour rassembler chaque témoignage.
✅ Résultat : Données d'actualités fraîches directement issues de l'API scrapingbee.
💡 Conseil de pro : Faites pivoter l'indicatif du pays pour comparer la couverture régionale.
Comment utiliser ScrapingBee pour une extraction de données rapide ?
Extraction rapide de données permet d'effectuer une extraction de données rapide pendant que ScrapingBee gère la rotation des proxys pour vous.
Voici comment l'utiliser étape par étape.
Étape 1 : Élaborez votre demande
Assemblez l'URL, la clé API et les paramètres une seule fois.
Étape 2 : Exécuter des appels simultanés
Envoyer plusieurs requêtes API simultanément.
Voici à quoi cela ressemble :
✓ Point de contrôle: Les réponses sont renvoyées en parallèle.
Étape 3 : Vérifier les codes d’état
Confirmez un code HTTP 200 pour chaque code d'état renvoyé.
✅ Résultat : High-volume scraping handled on remote machines.
💡 Conseil de pro : ThreadPoolExecutor accélère considérablement l'extraction de données des pages web.
Comment utiliser l'API de capture d'écran programmatique de ScrapingBee
API de capture d'écran programmatique permet de capturer par programmation une capture d'écran de la page entière de n'importe quelle URL.
Voici comment l'utiliser étape par étape.
Étape 1 : Ajouter le drapeau de capture d’écran
Ajoutez screenshot=true à votre requête API.
Étape 2 : Choisir la page complète
Définissez full_page=true pour capturer la mise en page complète.
Voici à quoi cela ressemble :
✓ Point de contrôle: Une image pleine page s'affiche bord à bord.
Étape 3 : Télécharger l’image
Enregistrez le fichier renvoyé sur le disque.
✅ Résultat : Des captures d'écran d'une précision pixel parfaite, générées à la demande.
💡 Conseil de pro : Le paramètre full_page garantit que la page entière s'affiche d'abord.
Comment utiliser ScrapingBee pour extraire les offres d'emploi de Google
Récupérer les offres d'emploi de Google permet de rassembler les offres d'emploi sous forme d'informations structurées complexes.
Voici comment l'utiliser étape par étape.
Étape 1 : Appeler le point de terminaison des tâches
Envoyez votre rôle et votre lieu de résidence à l'API des offres d'emploi.
Étape 2 : Filtrer les annonces
Affinez les résultats par titre, entreprise ou ville.
Voici à quoi cela ressemble :
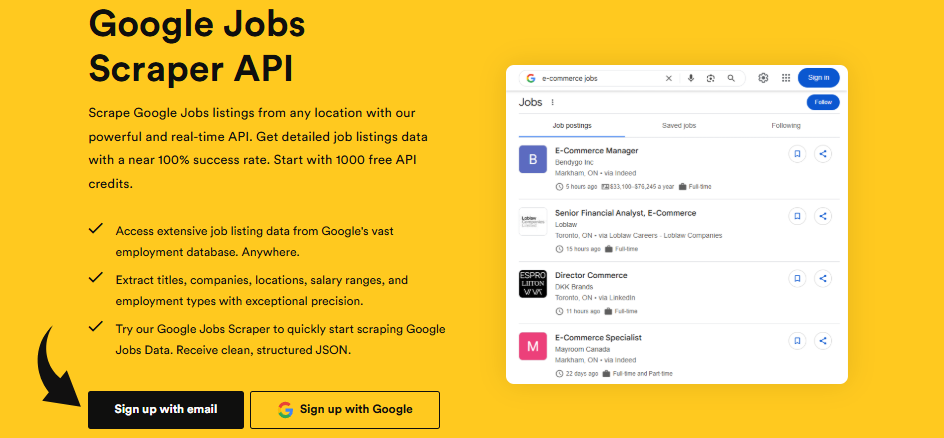
✓ Point de contrôle: Les lignes de tâches sont renvoyées au format JSON propre.
Étape 3 : Structurer les données
Analyser les champs HTML et les convertir en un tableau clair.
✅ Résultat : Données de travail prêtes à être analysées et stockées.
💡 Conseil de pro : Associez-les à des sélecteurs CSS pour récupérer des champs personnalisés.
Astuces et raccourcis pro de ScrapingBee
Après avoir testé ScrapingBee pendant plus d'un an, voici mes meilleurs conseils pour extraire des données de sites web.
Paramètres clés de l'API
| Paramètre | Ce que ça fait |
|---|---|
| render_js | Affiche du JavaScript dans les navigateurs sans interface graphique |
| proxy premium | Passage à des adresses IP de proxy résidentiel |
| code_pays | Configure la géolocalisation du proxy premium par pays aléatoire |
| bloquer les publicités | Permet de bloquer les publicités pour accélérer les requêtes |
Fonctionnalités cachées que la plupart des gens ignorent
- session_id : Les requêtes API sont acheminées via la même adresse IP pendant cinq minutes, ce qui vous permet de conserver le même code HTTP et la même session.
- return_page_source: Renvoie le code HTML original et le code source complet de la page avant l'exécution de tout script Javascript.
- En-têtes et cookies personnalisés : Envoyez vos propres en-têtes et cookies personnalisés, ou utilisez les en-têtes par défaut générés par ScrapingBee.
- Contrôle d'en-tête : Remplacer un en-tête existant par un nouvel en-tête, afficher les en-têtes générés automatiquement, puis ne conserver que certains en-têtes et supprimer les autres.
Erreurs courantes à éviter avec ScrapingBee
Erreur n° 1 : Ignorer le fichier robots.txt avant de commencer le scraping
❌ Faux : Envoyer des requêtes à n'importe quel site que vous souhaitez explorer sans vérifier les règles au préalable.
✅ À droite : Consultez le fichier robots.txt et les conditions d'utilisation avant de récupérer des données de pages web.
Erreur n° 2 : Oublier d’activer le rendu JavaScript
❌ Faux : Je m'attends à du contenu dynamique, mais j'obtiens systématiquement un code source de page vide.
✅ À droite : Définissez render_js=true pour que les navigateurs sans interface graphique chargent d'abord la page complète.
Erreur n° 3 : Envoyer uniquement les en-têtes par défaut
❌ Faux : Se fier uniquement aux en-têtes par défaut, que certains sites signalent et bloquent.
✅ À droite : Envoyez vos propres en-têtes personnalisés et un véritable paramètre d'agent utilisateur lorsque vous souhaitez extraire des données.
Dépannage de ScrapingBee
Problème : Source de page vide ou partielle
Cause: Le code JavaScript de la page ne s'est jamais exécuté, le code HTML est donc resté vide.
Réparer: Définissez render_js=true et attendez qu'un élément particulier charge la page entière.
Problème : Les requêtes sont constamment bloquées
Cause: Les adresses IP des serveurs proxy du centre de données par défaut ont été signalées par le site cible.
Réparer: Activer la rotation des proxys premium vers une nouvelle adresse IP provenant d'un pays aléatoire.
Problème : Vous voyez un code HTTP 401 ou 403
Cause: Votre clé API est incorrecte ou vous n'avez plus de crédit API.
Réparer: Confirmez la clé API, vérifiez votre code d'état et rechargez vos crédits si nécessaire.
📌 Note: Si aucune de ces solutions ne résout votre problème, contactez le support de ScrapingBee.
Qu'est-ce que ScrapingBee ?
ScrapingBee est un outil de scraping basé sur le cloud qui gère les navigateurs sans interface graphique et fait tourner les proxys pour vous.
Considérez-le comme un navigateur hébergé que vous contrôlez via une API REST.
Regardez ce bref aperçu :
Il comprend les fonctionnalités clés suivantes :
- Extraction de données Web par IA : Permet d'extraire des informations structurées complexes de pages web en utilisant un langage clair et simple.
- API de recherche Google : Permet d'extraire les résultats de recherche Google sans avoir à gérer soi-même les adresses IP des proxys.
- Extracteur de données Google Shopping : Permet de collecter les listes de produits et le prix extrait pour n'importe quel terme de recherche.
- Extraction de données Web en JavaScript : Permet de gérer le rendu JavaScript sur les pages web construites avec React ou Vue.
- Raccourci ChatGPT : Permet de capturer les réponses et le code source des pages de chat dynamiques générées par l'IA.
- API Google News Scraper : Permet de récupérer les titres et les articles complets via de simples requêtes API.
- Extraction rapide de données : Permet d'effectuer une extraction de données rapide pendant que ScrapingBee gère la rotation des proxys pour vous.
- API de capture d'écran programmatique : Permet de capturer par programmation une capture d'écran de la page entière de n'importe quelle URL.
- Récupérer les offres d'emploi de Google : Permet de rassembler les offres d'emploi sous forme d'informations structurées complexes.
Pour une analyse complète, consultez notre Avis sur ScrapingBee.
Tarification de ScrapingBee
Voici le coût de ScrapingBee en 2026 :
| Plan | Prix | Idéal pour |
|---|---|---|
| Free-lance | 49 $/mois | Développeurs indépendants et petits projets |
| Démarrer | 99 $/mois | Des équipes en pleine croissance augmentent le nombre de requêtes API |
| Entreprise | 249 $/mois | Charges de travail de web scraping à volume élevé |
| Affaires+ | 599 $/mois | Équipes d'entreprise sur des machines distantes |
Essai gratuit : Oui — 1000 appels API gratuits, aucune carte de crédit requise.
Garantie de remboursement : Annulation possible à tout moment ; facturation mensuelle sans engagement.
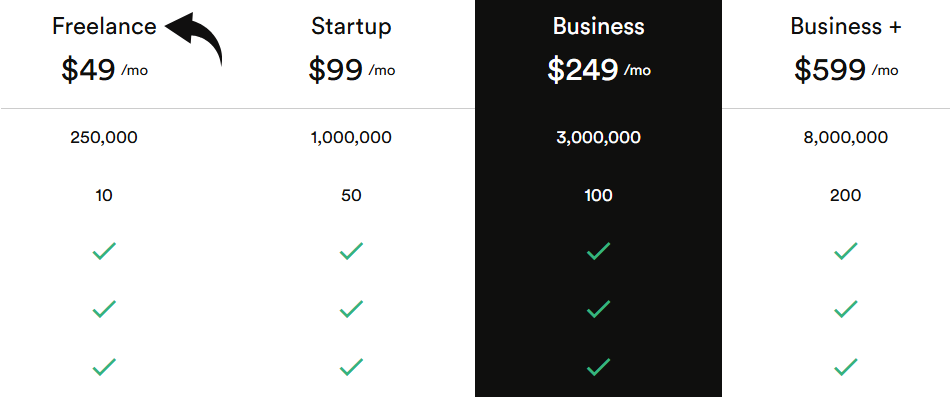
💰 Meilleur rapport qualité-prix : Startup — le meilleur compromis entre crédit API et prix pour la plupart des équipes.
ScrapingBee comparé aux alternatives
Comment ScrapingBee se compare-t-il aux autres ? Voici un aperçu du paysage concurrentiel :
Regardez cette comparaison :
| Outil | Idéal pour | Prix | Notation |
|---|---|---|---|
| ScrapingBee | Rendu JavaScript via une API REST | 49 $/mois | ⭐ 4,5 |
| Apify | acteurs de gratte-ciel prêts à l'emploi | Variable | ⭐ — |
| ScrapeGraphAI | Règles d'extraction pilotées par l'IA | Variable | ⭐ — |
| Données claires | adresses IP de proxy d'entreprise | Variable | ⭐ — |
| Parcourir IA | Pointer et cliquer sans code | Variable | ⭐ — |
| Oxylabs | proxys d'entreprise premium | Variable | ⭐ — |
| ThorData | Réseau proxy budgétaire | Variable | ⭐ — |
| Zyte | API de scraping pour développeurs | Variable | ⭐ — |
| Extracteur de données Web.io | Capture d'extension de navigateur | Variable | ⭐ — |
| Grattoir à hélium | Cartographie de site de bureau | Variable | ⭐ — |
| Firecrawl | Markdown prêt pour le LLM | Variable | ⭐ — |
Sélection rapide :
- Meilleur résultat global : ScrapingBee — une API REST pour le rendu, la recherche et les captures d'écran.
- Meilleur budget : ThorData — adresses IP proxy bon marché pour des opérations de web scraping simples.
- Idéal pour les débutants : Explorez l'IA — aucun code ni langage de programmation requis.
- Idéal pour les entreprises : Bright Data — conçu pour les opérations de web scraping massives et conformes.
🎯 Alternatives à ScrapingBee
Vous cherchez des alternatives à ScrapingBee ? Voici les meilleures options :
- 🚀 Apify : Une plateforme de scraping complète avec des acteurs prêts à l'emploi et un niveau gratuit généreux pour tester rapidement des idées.
- 🧠 ScrapeGraphAI : Un outil d'extraction de données basé sur l'IA qui transforme de simples requêtes en règles d'extraction pour des informations structurées complexes.
- 🏢 Données brillantes : Adresses IP proxy et ensembles de données de niveau entreprise conçus pour des opérations de web scraping de très grande envergure et une conformité stricte.
- 👶 Parcourir l'IA : Un outil sans code qui enregistre vos clics pour créer des scrapers sans écrire une seule ligne de code.
- 🔒 Oxylabs : Un fournisseur d'API proxy et scraper haut de gamme offrant une fiabilité à toute épreuve pour les charges de travail exigeantes des entreprises.
- 💰 ThorData : Un réseau de proxys économiques couvrant les adresses IP de proxys résidentiels et de centres de données pour les tâches de web scraping quotidiennes.
- 🔧 Zyte : Une API de scraping destinée aux développeurs, anciennement Scrapinghub, avec une gestion intelligente des interdictions et un code source de page propre.
- 🎨 Webscraper.io : Une extension de navigateur qui permet de générer visuellement des plans de site dans Chrome pour une capture de données par simple clic.
- 💼 Grattoir à hélium : Une application de web scraping pour Windows qui cartographie des sites complexes sans aucune dépendance au cloud.
- ⚡ Firecrawl : Un robot d'exploration IA qui convertit des sites entiers en Markdown propre pour alimenter de grands modèles de langage.
Pour la liste complète, consultez notre Alternatives à ScrapingBee guide.
⚔️ Comparaison de ScrapingBee
Voici comment ScrapingBee se compare à chacun de ses concurrents :
- ScrapingBee contre Apify : Apify propose une plateforme de scraping ; ScrapingBee se distingue par son accès simple à l'API REST et sa configuration plus rapide.
- ScrapingBee contre ScrapeGraphAI : ScrapeGraphAI s'appuie entièrement sur l'IA ; ScrapingBee vous offre à la fois l'extraction par IA et les sélecteurs CSS bruts.
- ScrapingBee contre Bright Data : Bright Data s'adapte aux grandes entreprises ; ScrapingBee est moins cher et plus simple pour les petites et moyennes équipes.
- ScrapingBee contre Browse AI : Browse AI convient aux non-programmeurs ; ScrapingBee est destiné aux développeurs qui souhaitent une API REST et un contrôle total.
- ScrapingBee contre Oxylabs : Oxylabs cible les grandes entreprises ; ScrapingBee propose des prix d'entrée plus bas et une courbe d'apprentissage plus facile.
- ScrapingBee contre ThorData : ThorData mise sur le prix des proxys ; ScrapingBee regroupe le rendu, les captures d’écran et l’IA dans une seule API.
- ScrapingBee contre Zyte : Zyte possède une solide expérience auprès des développeurs ; ScrapingBee est plus adapté aux projets rapides et aux petites équipes.
- ScrapingBee contre Webscraper.io : Webscraper.io s'exécute dans le navigateur ; ScrapingBee gère le rendu JavaScript côté serveur à grande échelle.
- ScrapingBee contre Helium Scraper : Helium Scraper fonctionne uniquement sur ordinateur ; ScrapingBee s’exécute dans le cloud, vous n’avez donc pas besoin de pilote web.
- ScrapingBee contre Firecrawl : Firecrawl cible les pipelines LLM ; ScrapingBee couvre un scraping plus large avec des captures d’écran et des API de recherche.
Commencez à utiliser ScrapingBee dès maintenant
Vous avez appris à utiliser toutes les principales fonctionnalités de ScrapingBee :
- ✅ Extraction de données Web par IA
- ✅ API de recherche Google
- ✅ Extracteur de données Google Shopping
- ✅ Extraction de données Web en JavaScript
- ✅ Extracteur de données ChatGPT
- ✅ API d'extraction de données Google News
- ✅ Extraction rapide de données
- ✅ API de capture d'écran programmatique
- ✅ Extraire les offres d'emploi de Google
Étape suivante : Choisissez une fonctionnalité et essayez-la dès maintenant.
La plupart des gens commencent par le web scraping par IA.
Un premier projet populaire consiste à créer un outil d'extraction de données OLX pour récupérer les annonces.
Durant le développement, ScrapingBee exécute le navigateur sur des machines distantes pour vous.
Explorez d'autres fonctionnalités une fois que votre premier scraper OLX fonctionnera.
Il faut moins de cinq minutes pour extraire les données de votre première page.
Foire aux questions
Comment fonctionne ScrapingBee ?
ScrapingBee est un outil de web scraping basé sur le cloud. Vous envoyez une requête avec votre clé API et une URL, et il renvoie la page via des navigateurs sans interface graphique tout en gérant automatiquement les proxys.
Combien coûte ScrapingBee ?
Les abonnements commencent à 49 $/mois pour Freelance, puis 99 $ pour Startup, 249 $ pour Business et 599 $ pour Business+. Un essai gratuit vous offre 1 000 appels API pour tester l'extraction de données.
Le web scraping est-il illégal ?
L'extraction de données de pages web publiques est généralement légale. Par mesure de sécurité, vérifiez toujours le fichier robots.txt et les conditions d'utilisation du site au préalable, évitez de collecter des données personnelles et respectez les limites de requêtes.
ScrapingBee prend-il en charge le rendu JavaScript ?
Oui. Définissez `render_js=true` et ScrapingBee chargera les pages web dans les navigateurs sans interface graphique. Ce rendu JavaScript fonctionne nativement sur les sites développés avec React ou Vue.
Quels langages de programmation ScrapingBee prend-il en charge ?
ScrapingBee est une API REST, vous pouvez donc l'appeler depuis Python, Node, PHP ou tout autre langage. En Python, il suffit d'importer `requests` et d'envoyer vos requêtes API.













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
