
Démarrage rapide
Ce guide couvre toutes les fonctionnalités de Firecrawl :
- Commencer — Créez un compte Firecrawl et configurez votre clé API
- Comment utiliser Scrape — Extraire des données prêtes pour le LLM à partir de pages Web individuelles
- Comment utiliser Crawl — Explorer l'intégralité des sites web et suivre chaque lien
- Comment utiliser la recherche — Rechercher des données Web en temps réel
- Comment utiliser la carte — Effectuer une recherche d'URL sur des pages individuelles
- Mode d'emploi de l'extrait — Extraire des données structurées à l'aide d'invites en langage naturel
Temps nécessaire : 5 minutes par fonctionnalité
Vous trouverez également dans ce guide : Conseils de pro | Erreurs courantes | Dépannage | Tarification | Alternatives
Pourquoi faire confiance à ce guide ?
J'utilise Firecrawl depuis plus d'un an et j'ai testé toutes les fonctionnalités décrites ici.
Ce tutoriel sur l'utilisation de Firecrawl est issu d'une véritable expérience pratique de web scraping.

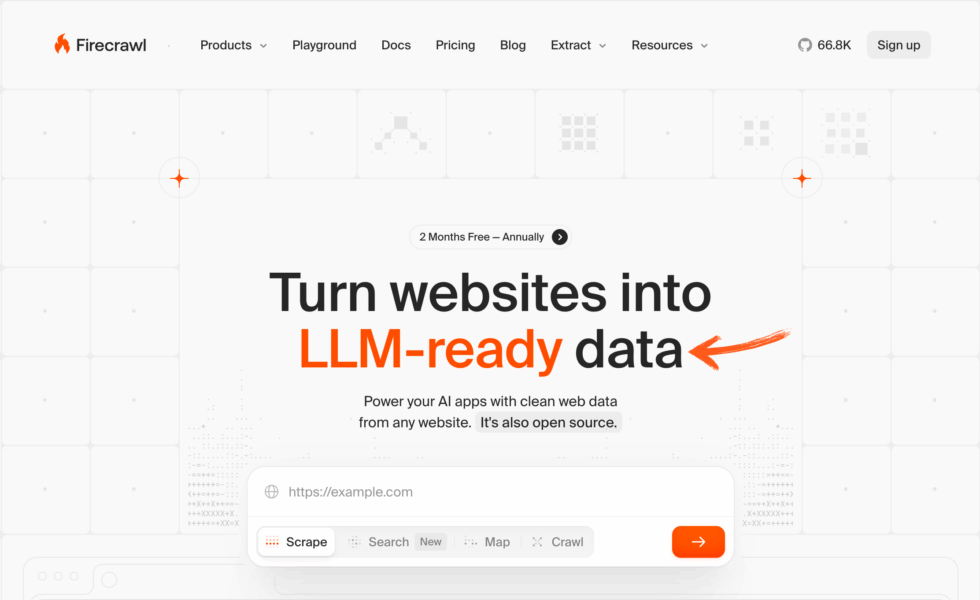
Firecrawl est un robot d'exploration Web alimenté par l'IA qui transforme les sites Web en données propres et prêtes à l'emploi.
Mais la plupart des utilisateurs n'exploitent qu'une infime partie des possibilités de cet outil polyvalent.
Ce guide vous montre comment utiliser chaque fonctionnalité principale, étape par étape, avec des captures d'écran.
Tutoriel Firecrawl
Ce tutoriel complet sur Firecrawl vous guide à travers chaque fonctionnalité, de votre première clé API aux opérations par lots avancées qui font de vous un utilisateur expert.
Firecrawl
Transformez n'importe quel site web en données structurées et propres grâce à une API unique. Firecrawl gère le rendu JavaScript, les limites de débit et la découverte d'URL pour vous fournir rapidement des données prêtes à l'emploi. Commencez avec le forfait gratuit : aucune carte de crédit n'est requise.
Premiers pas avec Firecrawl
Avant d'utiliser toute fonctionnalité, veuillez effectuer cette configuration unique.
Cela prend environ 3 minutes.
Regardez d'abord ce bref aperçu :
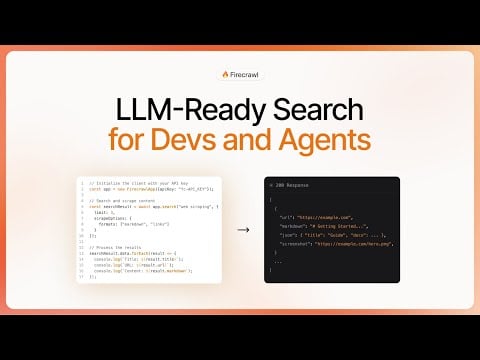
Passons maintenant en revue chaque étape.
Étape 1 : Créez votre compte
Rendez-vous sur le site web de Firecrawl à l'adresse https://www.firecrawl.dev.
Cliquez sur « S’inscrire » pour ouvrir un compte Firecrawl avec le forfait gratuit.
Saisissez votre adresse e-mail et créez un mot de passe.
✓ Point de contrôle: Vérifiez votre boîte de réception pour recevoir un courriel de confirmation.
Étape 2 : Installez et configurez votre clé API
Exécutez la commande pip install firecrawl-py pour ajouter le service API à votre projet.
Copiez votre clé API, puis enregistrez-la comme variable d'environnement pour sécurité.
Voici à quoi ressemble le tableau de bord :
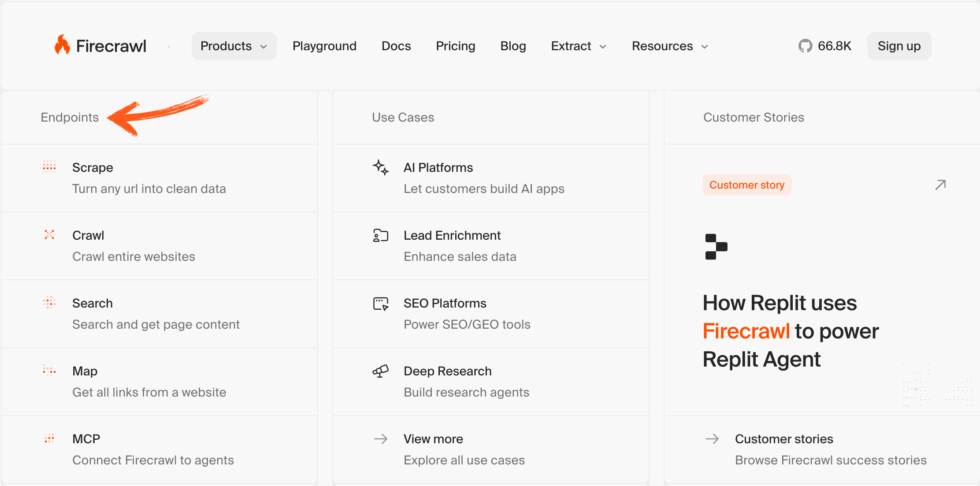
✓ Point de contrôle: Vous devriez voir le tableau de bord principal affichant votre consommation et votre clé API.
Étape 3 : Passez votre premier appel
Importez la classe FirecrawlApp et créez une instance Firecrawl avec votre clé.
Chaque requête atteint le point de terminaison de base à l'adresse https://api.firecrawl.dev/v2.
✅ Terminé : Vous êtes prêt à collecter, explorer, rechercher, cartographier et extraire des données.
Comment utiliser Firecrawl Scraper
Gratter permet d'extraire des données propres et prêtes pour le traitement LLM à partir d'une seule page en un seul appel API.
Le mode scraping cible des pages individuelles et est idéal pour extraire rapidement des informations spécifiques.
Voici comment l'utiliser étape par étape.
Maintenant, décomposons chaque étape.
Étape 1 : Obtenez votre clé API
Créez un compte Firecrawl, puis copiez votre clé API depuis le tableau de bord.
Stockez-la comme variable d'environnement afin que votre clé API reste en dehors de votre code source.
Étape 2 : Appeler le point de terminaison de récupération
Transmettez une seule URL à la méthode .scrape_url() de votre instance Firecrawl.
Vous pouvez demander un format de sortie Markdown, HTML brut ou JSON structuré.
Voici à quoi cela ressemble :
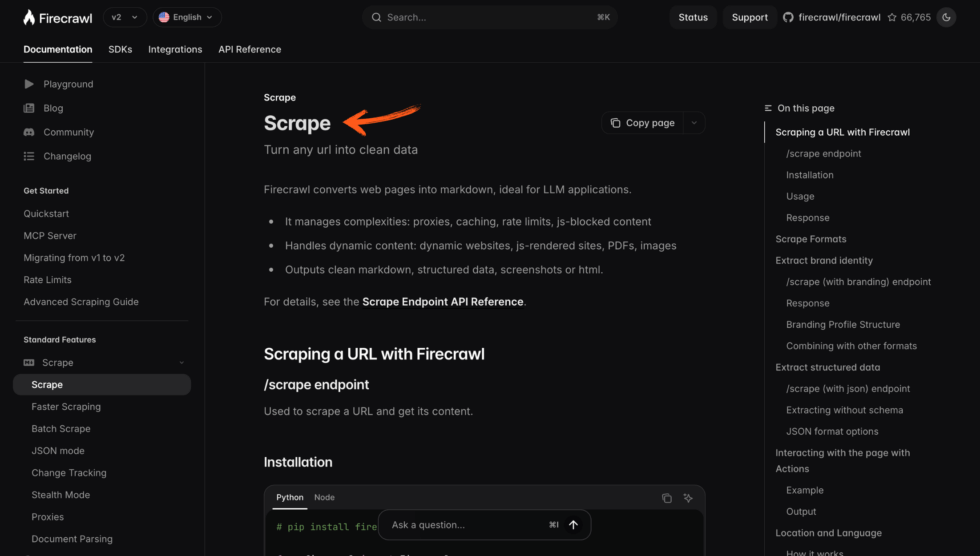
✓ Point de contrôle: Vous devriez voir un code Markdown propre pour la page actuelle, prêt pour les applications d'IA.
Étape 3 : Lire la sortie propre
Firecrawl renvoie des données propres et lisibles texte, débarrassé des balises HTML inutiles.
✅ Résultat : Vous avez transformé une des pages web en données web structurées grâce à une seule API.
💡 Conseil de pro : Définissez le paramètre max_age pour mettre en cache les résultats et éviter de réanalyser une page qui n'a pas été modifiée.
Comment utiliser Firecrawl Crawler
Crawl permet d'explorer des sites web entiers et de suivre les liens automatiquement, sans plan de site.
Le mode d'exploration vous permet d'explorer des sites web sur plusieurs pages et de collecter toutes les pages accessibles.
Voici comment l'utiliser étape par étape.
Maintenant, décomposons chaque étape.
Étape 1 : Indiquez une URL racine
Indiquez au point de terminaison d'exploration une URL de départ telle que https://example.com.
Firecrawl gère l'exploration du Web via les liens et suit les pages de manière autonome.
Étape 2 : Démarrer le travail d'exploration
Lancez la tâche d'exploration et récupérez l'identifiant de tâche renvoyé pour suivre sa progression.
Utilisez l'identifiant de la tâche pour interroger l'état d'avancement et récupérer les données analysées au fur et à mesure que chaque page est terminée.
Voici à quoi cela ressemble :
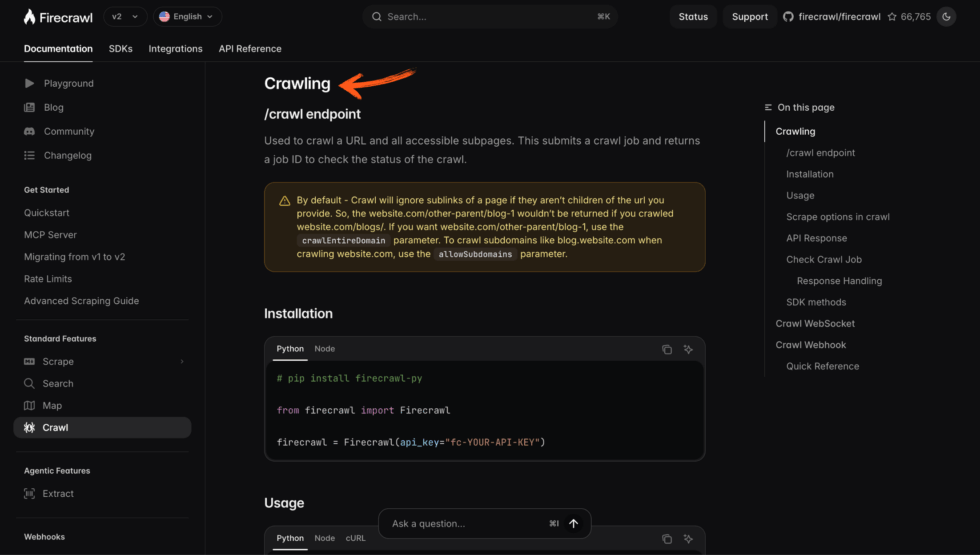
✓ Point de contrôle: Vous devriez voir des pages extraites de l'ensemble du site s'accumuler pour former des données web.
Étape 3 : Exporter les résultats
Collectez chaque page au format Markdown ou JSON structuré pour vos pipelines de données.
✅ Résultat : Vous avez capturé un site entier, même des sites web complexes avec du contenu dynamique.
💡 Conseil de pro : Firecrawl utilise le traitement par lots et les navigateurs simultanés, ce qui permet de maintenir la rapidité des opérations d'exploration importantes.
Comment utiliser le moteur de recherche Firecrawl
Recherche permet de rechercher sur le Web et d'obtenir des résultats clairs que vous pouvez directement intégrer à des agents d'IA.
La fonction de recherche vous permet d'interroger le Web et de récupérer des données Web en temps réel sous forme de texte lisible.
Voici comment l'utiliser étape par étape.
Maintenant, décomposons chaque étape.
Étape 1 : Envoyer une requête
Appelez le point de terminaison de recherche avec une requête en langage naturel simple.
Firecrawl peut effectuer des recherches sur le Web, notamment sur les sites d'actualités, les plateformes d'emploi et les sites d'avis.
Étape 2 : Choisir le format de sortie
Demandez un format Markdown ou JSON structuré pour chaque résultat.
Chaque résultat arrive sous forme de données propres, et non de code HTML brut et bruité.
Voici à quoi cela ressemble :
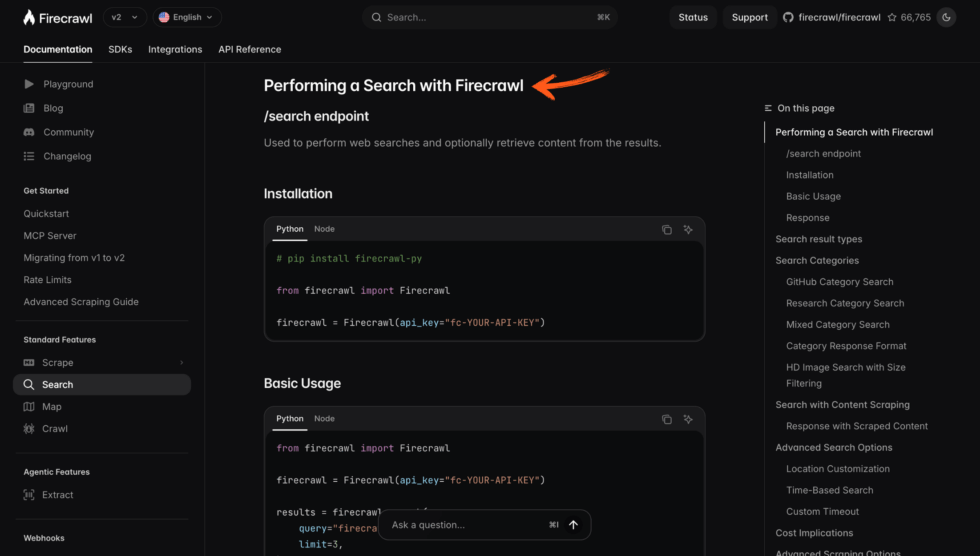
✓ Point de contrôle: Vous devriez voir les pages Web classées renvoyées sous forme de données Web structurées.
Étape 3 : Intégrez le flux dans votre application
Introduisez les données structurées dans assistants IA ou des flux de travail d'IA.
✅ Résultat : Vous avez ajouté du contenu web en direct à vos applications d'IA en un seul appel API.
💡 Conseil de pro : Associer la recherche à l'extraction pour collecter des articles de presse à des fins d'études de marché ou de veille concurrentielle.
Comment utiliser la carte avancée de Firecrawl
Carte permet d'effectuer une découverte d'URL et de transformer un domaine en une carte complète de ses pages individuelles.
Le mode carte permet de récupérer rapidement toutes les URL d'un site pour une découverte rapide des URL.
Voici comment l'utiliser étape par étape.
Maintenant, décomposons chaque étape.
Étape 1 : Soumettre le domaine
Transmettez une seule URL racine au point de terminaison de la carte.
Firecrawl renvoie tous les liens sans avoir besoin d'un plan du site.
Étape 2 : Examiner la liste des URL
Scannez les pages individuelles renvoyées avant de les extraire.
Enregistrez la liste dans un fichier CSV pour planifier l'extraction de vos données.
Voici à quoi cela ressemble :
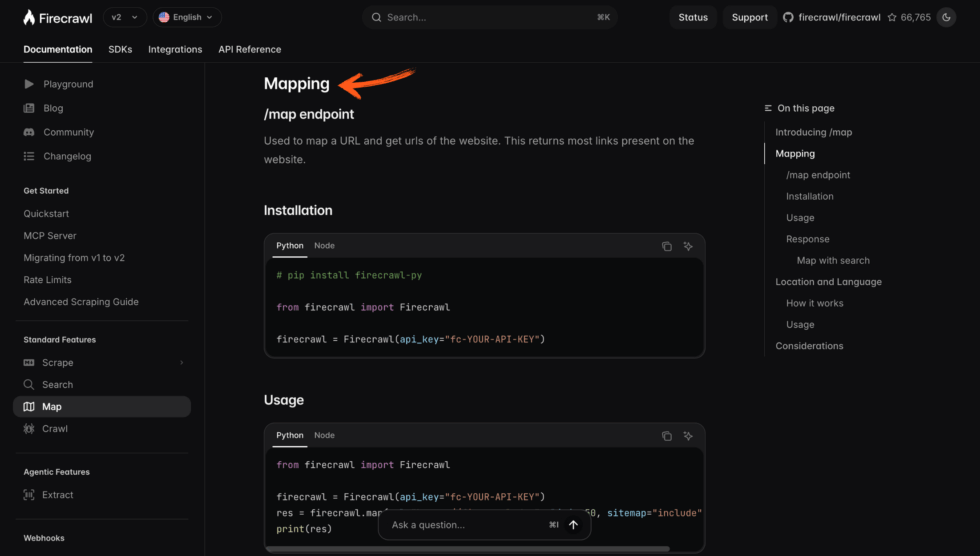
✓ Point de contrôle: Vous devriez voir un plan de site complet des pages web à partir d'une seule URL.
Étape 3 : Sélectionner les éléments à extraire
Sélectionnez les pages souhaitées, puis envoyez-les pour qu'elles soient extraites ou indexées.
✅ Résultat : Vous avez cartographié l'intégralité du site, prêt pour une extraction de données ciblée.
💡 Conseil de pro : Planifiez d'abord les pages sur les sites web dynamiques et les applications web afin d'éviter de gaspiller des crédits sur des pages inutiles.
Comment utiliser l'extracteur Firecrawl
Extrait permet d'extraire des données structurées de n'importe quelle page à l'aide d'instructions en langage naturel.
Extract utilise une analyse syntaxique basée sur l'IA pour extraire précisément les champs que vous décrivez.
Voici comment l'utiliser étape par étape.
Maintenant, décomposons chaque étape.
Étape 1 : Définir un schéma
Écrivez un modèle Pydantic avec : from pydantic import BaseModel.
L'extraction basée sur un schéma indique à Firecrawl quels champs renvoyer sous forme de JSON structuré.
Étape 2 : Décrire les données
Ajoutez des invites en langage naturel pour les champs qu'un schéma ne peut pas capturer.
Voici comment extraire des données de pages web sans écrire de règles d'analyse syntaxique.
Voici à quoi cela ressemble :
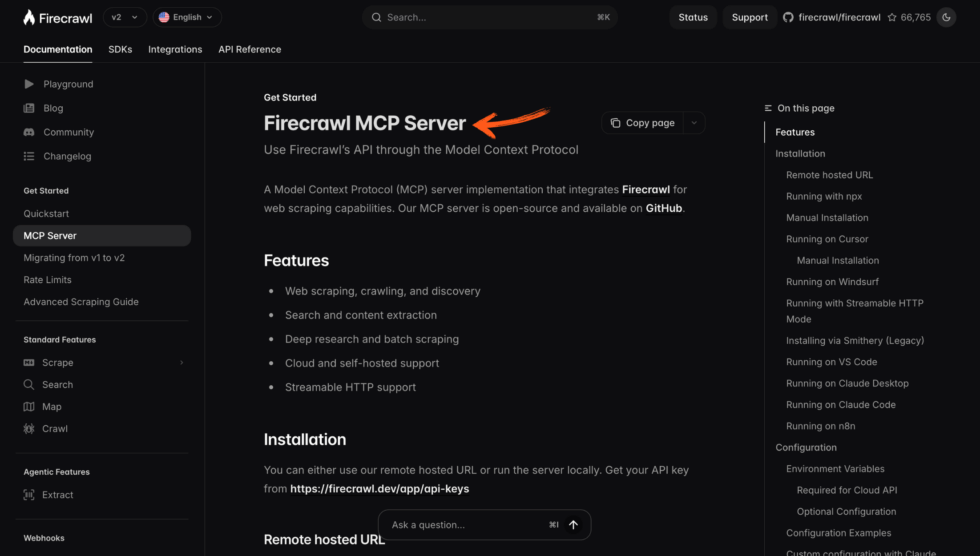
✓ Point de contrôle: Vous devriez voir des données structurées et propres au lieu de balises HTML désordonnées.
Étape 3 : Réception de JSON structuré
Firecrawl renvoie un fichier JSON structuré et propre, prêt pour l'entraînement.
✅ Résultat : Vous avez remplacé des scrapers fragiles par un seul appel d'extraction et un nettoyage de données réduit.
💡 Conseil de pro : Utilisez only_main_content, include_tags et exclude_tags pour que les données Web extraites restent ciblées.
Conseils et astuces de pro pour Firecrawl
Après avoir testé Firecrawl pendant plus d'un an, voici mes meilleurs conseils pour une extraction de données plus propre.
Raccourcis clavier
| Action | Raccourci |
|---|---|
| Course à pied dans la cour de récréation | Ctrl + Entrée |
| Copier la clé API | Ctrl + C |
| Ouvrir les documents | Ctrl + K |
| Changer le format de sortie | Languette |
Fonctionnalités cachées que la plupart des gens ignorent
- mise en cache max_age : Réutiliser les données récemment collectées pour un scraping répété plus rapide et moins coûteux.
- Actions du navigateur : Cliquez, faites défiler et saisissez du texte pour accéder au contenu rendu via JavaScript.
- Traitement par lots asynchrone : Traitez des milliers d'URL par lots sans bloquer vos applications web.
Erreurs courantes à éviter lors des visites de sécurité incendie
Erreur n° 1 : Intégrer en dur votre clé API
❌ Faux : Collez votre clé API directement dans du code partagé ou un dépôt public.
✅ À droite : Chargez la clé à partir d'une variable d'environnement afin qu'elle reste privée.
Erreur n° 2 : Explorer le monde avant de cartographier
❌ Faux : Parcourir des sites web entiers à l'aveuglette et gaspiller des crédits sur des pages inutiles.
✅ À droite : Commencez par une recherche d'URL avec une carte, puis explorez uniquement les pages dont vous avez besoin.
Erreur n° 3 : Analyser soi-même le code HTML brut
❌ Faux : Écrire des règles rigides pour nettoyer le code HTML brut et supprimer manuellement les balises HTML.
✅ À droite : Utilisez l'extraction basée sur un schéma pour obtenir directement un JSON structuré et propre.
Dépannage du Firecrawl
Problème : erreurs 401 (non autorisées)
Cause: Votre clé API est manquante ou n'a pas été chargée à partir de la variable d'environnement.
Réparer: Réexportez la clé, puis recréez votre instance Firecrawl et réessayez.
Problème : Erreurs de délai d'attente sur les sites web complexes
Cause: Le rendu de scripts JavaScript lourds ou le contenu dynamique prennent plus de temps à charger.
Réparer: Ajoutez une action d'attente pour que la page actuelle ait fini de se charger avant la capture.
Problème : Dépassement des limites de débit
Cause: Trop de requêtes simultanées avec le forfait gratuit ou un forfait inférieur.
Réparer: Opérations par lots lentes ou mise à niveau pour un plus grand nombre de navigateurs simultanés.
📌 Note: Si aucune de ces solutions ne résout votre problème, contactez le support de Firecrawl.
Qu'est-ce que Firecrawl ?
Firecrawl est un outil d'extraction de données Web basé sur l'IA qui transforme les sites Web en données propres et structurées.
Imaginez un robot d'exploration Web qui fournit aux agents d'IA du texte lisible au lieu de code HTML brut et désordonné.
Firecrawl a été développé par Mendable.ai pour réduire le gaspillage de jetons dans les applications d'IA.
Regardez ce bref aperçu :
Il comprend les fonctionnalités clés suivantes :
- Gratter: Extraire des données de pages web individuelles au format Markdown ou JSON structuré.
- Crawl: Explorer des sites web entiers et suivre des liens sans plan du site.
- Recherche: Effectuer des recherches sur le web et extraire des données fiables provenant de sites d'actualités et de sites d'évaluation.
- Carte: Découverte rapide d'URL qui transforme un domaine en un plan de site complet.
- Extrait: Extraire des données Web structurées à l'aide d'invites en langage naturel et de schémas Pydantic.
Firecrawl surpasse le web scraping traditionnel en gérant pour vous les proxys, les limites de débit et le rendu Javascript.
Contrairement aux outils traditionnels qui nécessitent Selenium, il sert les data scientists et les développeurs via un service API unique.
Pour une analyse complète, consultez notre Critique de Firecrawl.
Tarification Firecrawl
Voici le coût de Firecrawl en 2026 :
| Plan | Prix | Idéal pour |
|---|---|---|
| Gratuit | Gratuit | Tests de scraping et d'exploration sur quelques pages |
| Passe-temps | 16 $/mois | Développeurs indépendants et petits pipelines de données |
| Standard | 83 $/mois | Équipes effectuant des tâches régulières d'exploration du Web |
| Croissance | 333 $/mois | Études de marché et surveillance à grande échelle |
Essai gratuit : Oui, le forfait gratuit vous permet d'extraire des données d'un nombre limité de pages.
Garantie de remboursement : Aucune garantie formelle, mais vous pouvez passer à une formule inférieure à tout moment.
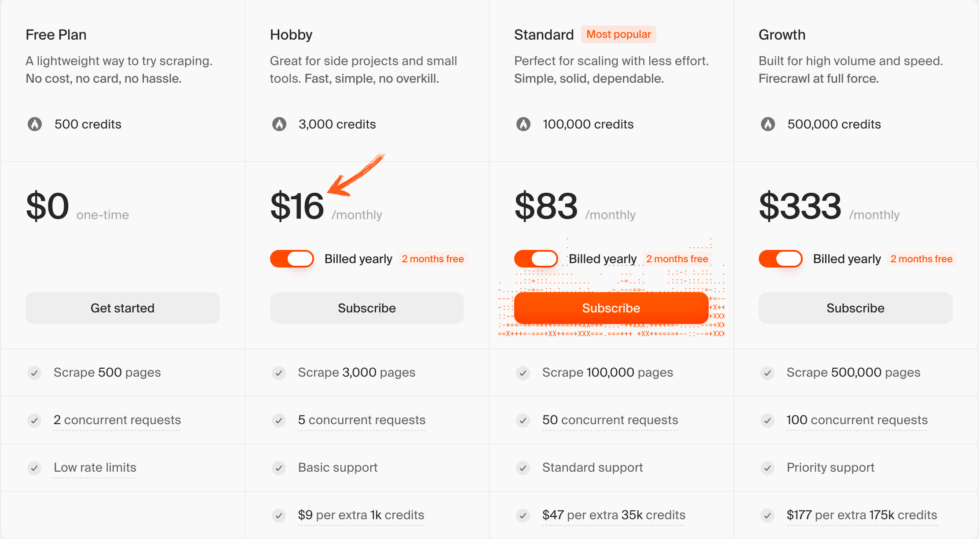
💰 Meilleur rapport qualité-prix : Standard — le meilleur équilibre entre crédits et navigateurs simultanés pour la plupart des équipes.
Firecrawl contre les alternatives
Comment Firecrawl se compare-t-il ? Voici le paysage concurrentiel :
| Outil | Idéal pour | Prix | Notation |
|---|---|---|---|
| Firecrawl | Données propres prêtes pour l'IA | 16 $/mois | ⭐ 3,5 |
| Apify | Acteurs prédéfinis | 49 $/mois | ⭐ 4,5 |
| Données claires | Échelle de substitution | $ Personnalisé | ⭐ 4,6 |
| Crawl4AI | Source libre | Gratuit | ⭐ 4,4 |
| Scrapy | Contrôle Python | Gratuit | ⭐ 4,5 |
| ScrapeGraphAI | Extraction de graphiques LLM | 20 $/mois | ⭐ 4,3 |
Sélection rapide :
- Meilleur résultat global : Firecrawl — données LLM prêtes à l'emploi les plus propres à partir d'une seule API.
- Meilleur budget : Crawl4AI — logiciel libre et gratuit pour les data scientists expérimentés.
- Idéal pour les débutants : Firecrawl — les invites en langage naturel masquent les aspects difficiles.
- Idéal pour une échelle intermédiaire : Bright Data — un vaste pool de proxys pour les sites web complexes.
🎯 Alternatives à Firecrawl
Vous cherchez des alternatives à Firecrawl ? Voici les meilleures options :
- 🚀 Apify : Place de marché d'acteurs préconfigurés pour le web scraping, idéale lorsque vous souhaitez des scrapers prêts à l'emploi via une API unique.
- 🏢 Données brillantes : Réseau de proxys d'entreprise pour les tâches d'exploration massives et la surveillance de contenu à grande échelle sur des sites web dynamiques.
- 💰 Crawl4AI : Outil d'exploration gratuit et open source qui génère des données compatibles avec LLM, idéal pour les flux de travail d'IA à petit budget et les exécutions locales.
- 🔧 Scrapy : Framework Python éprouvé offrant aux développeurs un contrôle total sur l'exploration, l'analyse syntaxique et les pipelines de données.
- 🧠 ScrapeGraphAI : Extraction basée sur des graphes et alimentée par l'IA qui cartographie la structure de la page pour l'extraction de données structurées basée sur un schéma.
Pour la liste complète, consultez notre Alternatives à Firecrawl guide.
⚔️ Comparaison avec Firecrawl
Voici comment Firecrawl se compare à chacun de ses concurrents :
- Firecrawl contre Apify : Firecrawl l'emporte grâce à sa sortie propre et prête pour llm ; Apify l'emporte grâce à sa bibliothèque de scrapers préconfigurés.
- Firecrawl contre Bright Data : Bright Data l'emporte en termes d'analyse par proxy ; Firecrawl l'emporte pour l'extraction de données structurées plus simples.
- Firecrawl contre Crawl4AI : Crawl4AI l'emporte sur le prix et l'auto-hébergement ; Firecrawl l'emporte sur les limites de débit gérées et la fiabilité.
- Firecrawl contre Scrapy : Scrapy l'emporte grâce à son contrôle de bas niveau ; Firecrawl l'emporte grâce à sa vitesse et à l'absence de configuration de proxy.
- Firecrawl contre ScrapeGraphAI : Les deux sont basés sur l'IA ; Firecrawl l'emporte en termes de couverture d'exploration, ScrapeGraphAI en termes de logique graphique.
Commencez à utiliser Firecrawl dès maintenant
Vous avez appris à utiliser toutes les principales fonctionnalités de Firecrawl :
- ✅ Gratter
- ✅ Ramper
- ✅ Recherche
- ✅ Carte
- ✅ Extrait
Étape suivante : Choisissez une fonctionnalité et essayez-la dès maintenant.
La plupart des gens commencent par Scrape.
Cela prend moins de 5 minutes.
Foire aux questions
À quoi sert Firecrawl ?
Firecrawl est un outil d'extraction de données web basé sur l'IA. Il transforme les pages web en données propres et exploitables pour les agents IA, les systèmes RAW, les études de marché et la surveillance des prix.
Peut-on utiliser Firecrawl gratuitement ?
Oui. Le forfait gratuit vous permet d'extraire des données d'un nombre limité de pages avec votre clé API, ce qui vous permet de tester l'extraction, le crawl et l'exploration avant de payer.
Comment installer Firecrawl ?
Exécutez la commande `pip install firecrawl-py`, puis définissez votre clé API comme variable d'environnement et créez une instance Firecrawl pour démarrer votre premier appel API.
En quoi Firecrawl diffère-t-il du scraping traditionnel ?
Le web scraping traditionnel nécessite Selenium et une configuration manuelle des proxys. Firecrawl gère automatiquement le rendu JavaScript, les limites de débit et le nettoyage des données via une API unique.
Firecrawl peut-il extraire des données structurées ?
Oui. Utilisez des invites en langage naturel ou un schéma Pydantic pour l'extraction basée sur un schéma, et Firecrawl renvoie du JSON structuré au lieu du HTML brut.













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
