
Início rápido
Este guia abrange todos os recursos do Helium Scraper:
- Começando — Criar conta e configuração básica
- Como usar a extração rápida — Extraia dados de qualquer página da web em etapas simples
- Como usar o fluxo de trabalho simples — Crie um fluxo de trabalho sem código para extrair dados de qualquer site.
- Como usar o Scale on Demand — Escalável sob demanda com integração e proxies
- Como usar a captura de dados complexos — Capturar dados complexos e aninhados e conteúdo JavaScript
- Como usar o Install Anywhere — Instale em qualquer computador e execute a extração de dados localmente
Tempo necessário: 5 minutos por filme
Neste guia também: Dicas profissionais | Erros comuns | Solução de problemas | Preços | Alternativas
Por que confiar neste guia?
Eu usei hélio Raspador Durante dois anos, testei todos os recursos abordados aqui. Este tutorial é fruto de experiência prática real — não de propaganda enganosa ou capturas de tela de fornecedores.

O Helium Scraper é um scraper para desktop, sem código, desenvolvido para pequenas e médias empresas. dados tarefas de extração.
Mas a maioria dos usuários apenas arranha a superfície do que essa ferramenta de apontar e clicar pode fazer.
Este guia mostra como usar o Helium Scraper e todas as suas principais funcionalidades.
Passo a passo, com capturas de tela e dicas profissionais.
Tutorial de raspador de hélio
Este tutorial completo do Helium Scraper orienta você em todas as funcionalidades, desde a configuração até dicas avançadas que o transformarão em um usuário avançado capaz de extrair dados rapidamente.
Raspador de Hélio
Extraia dados de sites visualmente, sem escrever código. O Helium Scraper usa seleção por clique para extrair dados de qualquer site no seu computador. Compra única para desktop — sem assinaturas.
Primeiros passos com o Helium Scraper
Antes de usar qualquer recurso, conclua esta configuração única.
Leva cerca de 3 minutos.
Assista primeiro a este breve relato da minha experiência pessoal:
Agora vamos analisar cada etapa.
Passo 1: Baixe e instale
Acesse o site do Helium Scraper e escolha seu plano.
Baixe o instalador e instale-o no seu computador.
✓ Ponto de verificação: O ícone do aplicativo aparece na sua área de trabalho.
Passo 2: Abra e faça login
Abra o aplicativo e confirme sua licença para ativá-lo.
O Helium Scraper funciona localmente, portanto não é necessária uma conta na nuvem.
Eis como o painel de controle se parece:
✓ Ponto de verificação: Você deverá ver o menu principal e o navegador web integrado.
Etapa 3: Crie seu primeiro projeto
Clique em Criar para iniciar um novo projeto para o site desejado.
Digite a URL que deseja extrair no navegador integrado.
✅ Concluído: Você está pronto para usar qualquer recurso abaixo.
Como usar o raspador de hélio para extração rápida
Extração rápida Permite extrair dados de qualquer página da web em apenas alguns passos simples.
Veja como usá-lo passo a passo.
O Helium Scraper funciona em qualquer site, desde uma página de resultados de mecanismos de busca como Google ou Bing até um catálogo de produtos.
Agora vamos analisar cada etapa.
Passo 1: Abra o navegador integrado
Acesse o site desejado dentro do navegador integrado.
Insira a URL que deseja extrair e carregue a página.
Etapa 2: Selecione seus pontos de dados
Ctrl+clique nos elementos desejados, como títulos ou preços de produtos.
Eis como isso se parece:
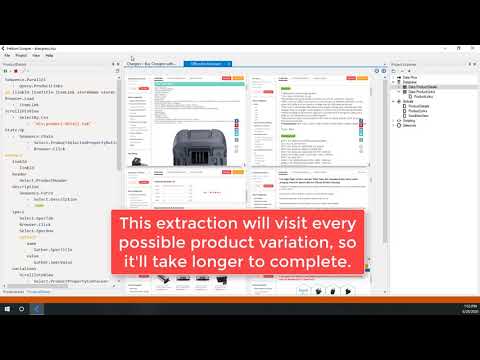
✓ Ponto de verificação: Os elementos selecionados ficam destacados no navegador.
Etapa 3: Executar e Exportar
Clique em "Extrair" e, em seguida, exporte seus dados para Excel, CSV, JSON ou SQLite.
✅ Resultado: Você extraiu dados limpos do site em minutos.
💡 Dica profissional: Ative o modo de seleção e pressione Ctrl+clique em itens semelhantes para ensinar rapidamente um padrão à ferramenta.
Como usar o Helium Scraper: Fluxo de trabalho simples
Fluxo de trabalho simples Permite criar um fluxo de trabalho de extração de dados sem código, sem precisar escrever código ou ter habilidades de programação.
Veja como usá-lo passo a passo.
Agora vamos analisar cada etapa.
Passo 1: Defina seus tipos
Crie categorias para marcar os elementos de dados que você deseja extrair.
Os tipos definem títulos de produtos, preços ou qualquer campo na página.
Passo 2: Adicionar ações
Adicione ações como clicar e navegar pela paginação.
Eis como isso se parece:
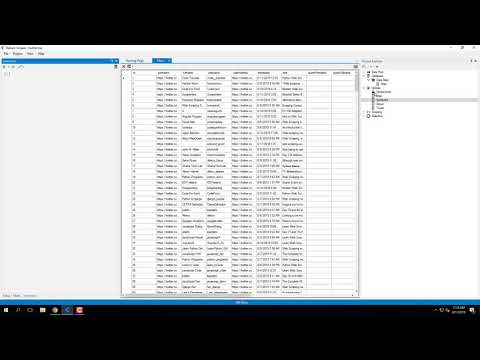
✓ Ponto de verificação: Seu fluxo de trabalho percorre as páginas sem erros.
Etapa 3: Validar o fluxo de trabalho
Teste suas opções em diferentes páginas para confirmar resultados precisos.
✅ Resultado: Você criou um processo de extração repetível com seleção por meio de cliques.
💡 Dica profissional: O recurso de arrastar e soltar construtor É útil para iniciantes; crie loops de repetição dentro das ações para lidar com extrações em larga escala.
Como usar a balança de raspador de hélio sob demanda
Escala sob demanda Permite dimensionar projetos de grande porte com integração de proxy para evitar limites de taxa e captchas.
Veja como usá-lo passo a passo.
Agora vamos analisar cada etapa.
Passo 1: Abra as configurações de proxy.
Abra o menu de configurações e encontre a seção de integração de proxy.
O Helium Scraper pode ser integrado a serviços de proxy para contornar captchas e bloqueios de IP.
Etapa 2: Insira os detalhes do proxy
Insira o endereço e a porta do proxy, confirme e ative os proxies.
Eis como isso se parece:
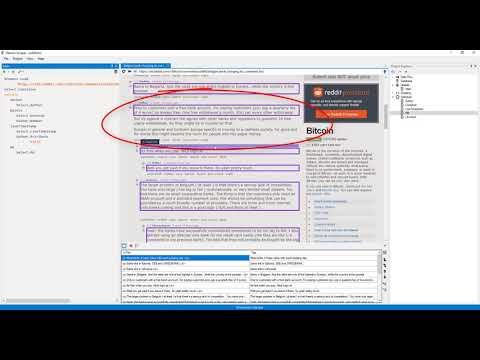
✓ Ponto de verificação: Suas solicitações são encaminhadas através do nó de saída escolhido.
Passo 3: Selecione um nó de saída
Escolha um nó de saída nos EUA ou qualquer local com proxies residenciais.
Um nó de saída de um país específico ajuda você a extrair dados com segmentação geográfica.
✅ Resultado: Você consegue realizar scraping em grande escala sem atingir o limite de 500 a 600 requisições por hora.
💡 Dica profissional: Use proxies rotacionais e sessões persistentes para projetos de scraping consistentes e de grande porte.
Como usar o Helium Scraper para capturar dados complexos
Capturar dados complexos Permite capturar dados complexos e aninhados de sites modernos que dependem de JavaScript.
Veja como usá-lo passo a passo.
Agora vamos analisar cada etapa.
Passo 1: Habilitar o tratamento de JavaScript
Permita que o Helium Scraper navegue e clique em elementos para renderizar o JavaScript.
A ferramenta também baixa imagens enquanto processa a página.
Etapa 2: Configurar a extração aninhada
Defina tipos aninhados para extrair dados de dentro de listas ou tabelas.
Eis como isso se parece:
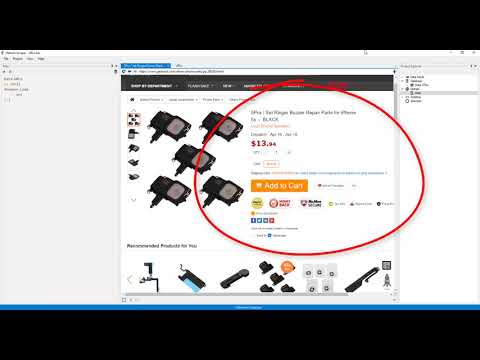
✓ Ponto de verificação: Os campos aninhados aparecem corretamente na pré-visualização dos seus dados.
Etapa 3: Usar código personalizado
Adicione JavaScript e SQL personalizados para tarefas avançadas de extração de dados.
✅ Resultado: Você capturou dados web complexos e estruturados de um site dinâmico.
💡 Dica profissional: Valide os tipos aninhados em várias páginas de exemplo antes de executar a tarefa completa.
Como usar o instalador tudo-em-um do Helium Scraper
Instale em qualquer lugar Permite instalar o aplicativo para desktop em qualquer computador e executar a extração de dados localmente.
Veja como usá-lo passo a passo.
Agora vamos analisar cada etapa.
Passo 1: Baixe o instalador
Baixe o instalador do site e execute o programa de instalação.
O processo de instalação é simples e termina em minutos.
Passo 2: Ative sua licença
Abra o aplicativo e confirme sua licença com sua senha.
Eis como isso se parece:
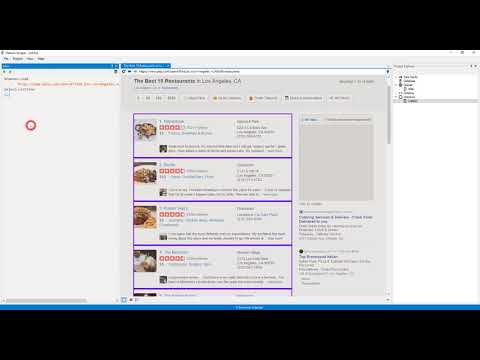
✓ Ponto de verificação: O aplicativo é iniciado e carrega o navegador integrado.
Etapa 3: Verificar recursos do sistema
Certifique-se de que seu computador tenha recursos suficientes para tarefas grandes.
O Helium Scraper é executado localmente e pode exigir recursos significativos do computador.
✅ Resultado: Você tem um raspador local pronto em sua própria máquina.
💡 Dica profissional: Para tarefas pesadas, feche outros aplicativos para que mais recursos sejam direcionados ao processo de extração.
Dicas e Atalhos Profissionais para Raspador de Hélio
Após testar o Helium Scraper por dois anos, aqui estão minhas melhores dicas para uma extração de dados mais rápida.
Atalhos de teclado
| Ação | Atalho |
|---|---|
| Selecione um elemento | Ctrl + Clique |
| Ampliar seleção | Ctrl + Shift + Clique |
| Executar extração | F5 |
| Abra as configurações do projeto | Ctrl + , |
Características ocultas que a maioria das pessoas não percebe
- JavaScript e SQL personalizados: Adicionar código para extração avançada que o menu de apontar e clicar não consegue alcançar.
- Seleção do nó de saída dos EUA: Selecione servidores proxy de uma localização específica para coletar dados de mecanismos de busca e sites com restrição geográfica.
- Repetir ciclos: Crie loops dentro das ações para navegar pela paginação e extrair listas grandes automaticamente.
Raspador de hélio: erros comuns a evitar
Erro nº 1: Ignorar a integração de proxy
❌ Errado: Envio de centenas de solicitações a partir de um único endereço IP, atingindo captchas e limites de taxa.
✅ Direita: Configure a integração de proxy com proxies rotativos para evitar o limite de 500 a 600 solicitações por hora.
Erro nº 2: Não validar seus tipos
❌ Errado: Confiar em uma página e presumir que o mesmo tipo de conteúdo funciona em todo o site.
✅ Direita: Teste cada tipo em várias páginas de exemplo para confirmar a identificação correta dos dados.
Erro nº 3: Ignorar os recursos do computador
❌ Errado: Executar uma tarefa enorme enquanto muitos outros aplicativos competem por recursos limitados.
✅ Direita: Feche outros programas para que o processo de extração obtenha os recursos necessários.
Solução de problemas do raspador de hélio
Problema: As páginas carregam em branco.
Causa: O site depende de JavaScript que ainda não terminou de renderizar.
Consertar: Deixe a ferramenta navegar e clicar nos elementos para que a página carregue completamente antes de você selecionar os dados.
Problema: Bloqueio ou Captchas
Causa: O excesso de solicitações de um mesmo endereço IP acionou as defesas do site.
Consertar: Ative os proxies nas configurações, insira o endereço e a porta e escolha um novo nó de saída.
Problema: Dados extraídos incorretamente
Causa: Seu tipo de correspondência combinou com os elementos errados em algumas páginas.
Consertar: Selecione novamente com Ctrl+clique e valide o tipo em diferentes páginas do site.
📌 Observação: Se nenhuma dessas soluções resolver o seu problema, consulte a documentação ou entre em contato com o suporte e a comunidade do Helium Scraper.
O que é um raspador de hélio?
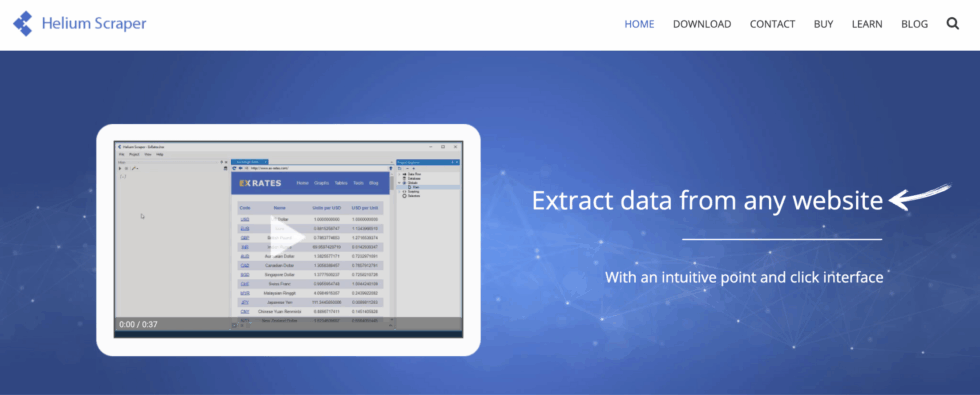
Raspador de Hélio É um scraper para desktop, sem código, que permite extrair dados da web visualmente.
Imagine como um marcador de texto inteligente — você aponta, clica e ele coleta os dados para você.
A principal diferença em relação às ferramentas em nuvem é que ela é executada localmente, o que é válido para todas as tarefas de extração de dados e ideal para casos de uso pequenos e leves.
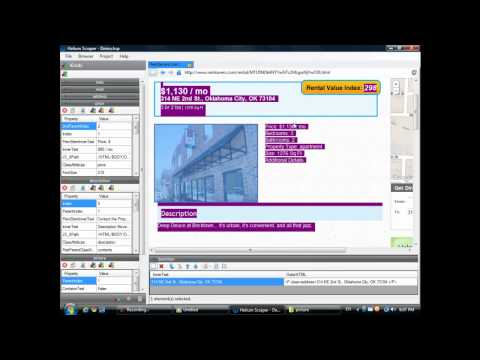
Veja esta breve visão geral:
Inclui estas características principais:
- Extração rápida: Extraia dados de qualquer página em etapas simples.
- Fluxo de trabalho simples: Crie um fluxo de trabalho sem código, sem precisar de habilidades de programação.
- Escalabilidade sob demanda: Escalabilidade com integração de proxy e um nó de saída dos EUA
- Capturar dados complexos: Capturar dados complexos e aninhados, bem como conteúdo JavaScript.
- Instale em qualquer lugar: Instale e execute a extração de dados localmente em qualquer computador.
Para uma análise completa, consulte nosso artigo. Análise do raspador de hélio.
Preços de raspadores de hélio
Eis o preço do raspador de hélio em 2026:
| Plano | Preço | Ideal para |
|---|---|---|
| Básico | $99 | Indivíduos e pequenas tarefas de raspagem |
| Profissional | $199 | Freelancers executando projetos regulares |
| Negócios | $399 | Equipes com maiores necessidades de dados |
| Empresa | $699 | Raspagem pesada e em grande escala |
Teste grátis: Sim, um período de teste gratuito permite que você experimente a ferramenta antes de comprar.
Garantia de reembolso: O preço refere-se a uma compra única para o computador, não a uma assinatura.
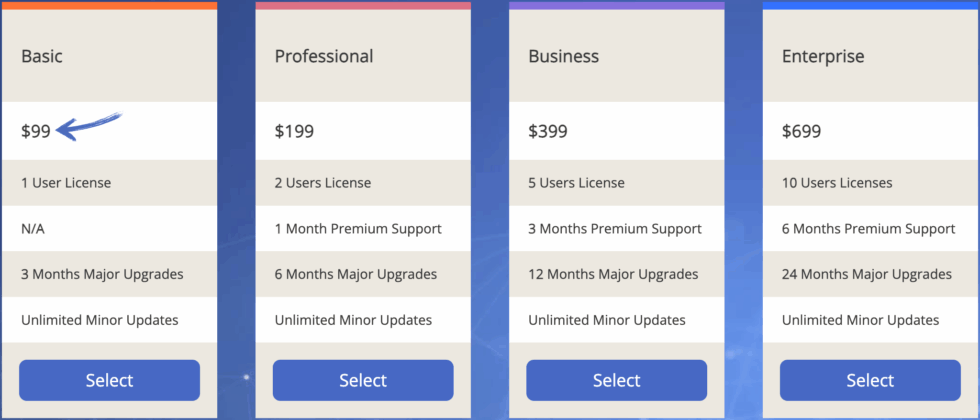
💰 Melhor custo-benefício: Profissional — o melhor plano para a maioria dos freelancers que fazem scraping regularmente.
Raspador de hélio vs. alternativas
Como o Helium Scraper se compara? Aqui está o panorama competitivo:
| Ferramenta | Ideal para | Preço | Avaliação |
|---|---|---|---|
| Raspador de Hélio | Extração local sem código | US$ 99 (pagamento único) | ⭐ 3,5 |
| Octoparse | Extração visual de nuvem | US$ 99/mês | ⭐ 4,3 |
| ParseHub | Iniciantes | US$ 189/mês | ⭐ 4,2 |
| Scrapy | Desenvolvedores | Livre | ⭐ 4,5 |
| ScrapingBee | API e escala | US$ 49/mês | ⭐ 4,4 |
| Dados brilhantes | Proxies empresariais | US$ 499/mês | ⭐ 4,6 |
Escolhas rápidas:
- Melhor no geral: Helium Scraper — visual, sem código e com preço único.
- Melhor orçamento: Scrapy — gratuito e de código aberto para quem escreve código.
- Ideal para iniciantes: ParseHub — simples e fácil de aprender.
- Melhor para comparação de escala: ScrapingBee — uma API na nuvem para tarefas automatizadas de grande porte.
🎯 Alternativas para raspadores de hélio
Procurando alternativas para o raspador de hélio? Aqui estão as melhores opções:
- 🚀 Octoparse: Um extrator visual baseado em nuvem com agendamento e automação que executa tarefas sem manter o computador ligado.
- 👶 ParseHub: Uma ferramenta fácil de usar, com configuração simples do tipo "apontar e clicar", ideal para usuários que estão começando a trabalhar com extração de dados.
- 🔧 Scrapy: Uma estrutura gratuita e de código aberto para desenvolvedores que se sentem à vontade para escrever código e criar projetos de extração de dados personalizados.
- ⚡ ScrapingBee: Uma API de web scraping na nuvem que renderiza JavaScript e lida com proxies e captchas em grande escala.
- 🏢 Dados brilhantes: Uma plataforma empresarial com extensas redes de proxies e um nó de saída nos EUA para extração com segmentação geográfica.
Para ver a lista completa, consulte nosso Alternativas ao raspador de hélio guia.
⚔️ Comparação de raspadores de hélio
Veja como o Helium Scraper se compara a cada concorrente:
- Helium Scraper vs Octoparse: O Helium Scraper se destaca pelo preço, com uma taxa única; o Octoparse vence no quesito agendamento em nuvem e execuções paralelas.
- Helium Scraper vs ParseHub: Ambas são fáceis de usar para iniciantes; o Helium Scraper é melhor para raspagem local e leve, sem custos mensais.
- Raspador de hélio vs. Scrapy: Scrapy se destaca para programadores que criam scrapers personalizados; Helium Scraper se destaca para extração visual sem código.
- Raspador de hélio vs. ScrapingBee: O ScrapingBee se destaca na automação e escalabilidade; o Helium Scraper é melhor para tarefas locais rápidas que não exigem programação.
- Raspador de hélio vs. Bright Data: A Bright Data se destaca em proxies e escalabilidade empresarial; o Helium Scraper é mais simples e muito mais barato para tarefas pequenas.
Comece a usar o Helium Scraper agora mesmo.
Você aprendeu a usar todos os principais recursos do Helium Scraper:
- ✅ Extração rápida
- ✅ Fluxo de trabalho simples
- ✅ Escalabilidade sob demanda
- ✅ Capturar dados complexos
- ✅ Instale em qualquer lugar
Próximo passo: Escolha uma funcionalidade e experimente agora mesmo.
A maioria das pessoas começa com a Extração Rápida.
Leva menos de 5 minutos.
Perguntas frequentes
Como faço para usar o Helium Scraper?
Instale o aplicativo para desktop, abra o navegador integrado, pressione Ctrl e clique nos dados que deseja categorizar, execute o processo e exporte a extração para Excel, CSV, JSON ou SQLite.
O Helium Scraper exige conhecimentos de programação?
Não. O Helium Scraper é uma ferramenta intuitiva, que não requer código e funciona com o recurso de apontar e clicar. Você seleciona os dados visualmente, sem precisar escrever código, embora recursos personalizados de JavaScript e SQL estejam disponíveis para extração de dados mais avançada.
Como funciona a integração de proxy no Helium Scraper?
Abra as configurações, insira o endereço e a porta do proxy, confirme e habilite os proxies. Escolha um nó de saída, como uma localização nos EUA, para coletar dados geolocalizados e evitar captchas.
O Helium Scraper é uma boa opção para projetos de grande porte?
É adequado para projetos de pequeno a médio porte. Para tarefas maiores, utilize proxies rotativos para evitar o limite de 500 a 600 requisições por hora, já que a ferramenta é executada localmente e utiliza seus recursos.
O Helium Scraper consegue lidar com sites em JavaScript?
Sim. Ele navega e clica em elementos para renderizar JavaScript e baixar imagens, permitindo extrair dados complexos e aninhados de sites dinâmicos modernos.













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
