
快速入门
本指南涵盖了 Helium Scraper 的所有功能:
- 入门 — 创建账户和基本设置
- 如何使用快速萃取 — 只需几个简单步骤即可从任何网页提取数据
- 如何使用简单工作流程 — 构建一个无需编写代码的工作流程,即可抓取任何网站
- 如何使用按需规模化 — 通过代理集成和代理按需扩展
- 如何使用捕获复杂数据 — 捕获复杂的嵌套数据和 JavaScript 内容
- 如何使用 Install Anywhere — 可安装在任何计算机上并本地运行爬虫程序
所需时间: 每部影片 5 分钟
本指南还包含以下内容: 专业提示 | 常见错误 | 故障排除 | 定价 | 替代方案
为什么信任本指南
我用过氦气 刮刀 我花了两年时间测试了这里介绍的所有功能。本教程源于真实的实践经验,而非营销噱头或厂商截图。

Helium Scraper 是一款面向中小型企业的桌面无代码爬虫工具。 数据 提取任务。
但大多数用户仅仅触及了这款点击式工具功能的皮毛。
本指南将向您展示如何使用 Helium Scraper 及其所有主要功能。
一步一步教你,附带截图和专业技巧。
氦气刮刀教程
本 Helium Scraper 完整教程将带您了解每个功能,从设置到高级技巧,让您成为能够快速提取数据的超级用户。
氦气刮刀
无需编写代码,即可直观地抓取网站数据。Helium Scraper 使用点击式选择功能,即可从您电脑上的任何网站提取数据。一次性桌面版购买,无需订阅。
Helium Scraper 入门指南
使用任何功能之前,请先完成此一次性设置。
大约需要3分钟。
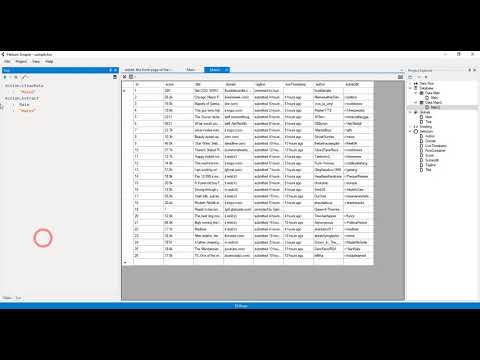
先观看这段简短的个人体验介绍:
现在让我们一步一步来。
步骤 1:下载并安装
前往 Helium Scraper 网站并选择您的套餐。
下载安装程序,然后将其安装到您的计算机上。
✓ 检查点: 应用图标会出现在您的桌面上。
步骤二:打开并登录
打开应用并确认您的许可证以激活它。
Helium Scraper 在本地运行,因此无需云帐户。
这就是仪表盘的样子:
✓ 检查点: 您应该可以看到主菜单和内置网络浏览器。
步骤 3:创建你的第一个项目
点击“创建”按钮,即可为目标站点启动一个新项目。
在内置浏览器中输入要抓取的网址。
✅ 完成: 您已准备好使用以下任何功能。
如何使用氦气刮刀快速萃取
快速提取 只需几个简单的步骤,即可从任何网页提取数据。
以下是使用步骤。
Helium Scraper 适用于任何网站,从 Google 或 Bing 搜索引擎结果页面到产品目录。
现在让我们逐一分析每个步骤。
步骤 1:打开内置浏览器
在内置浏览器中导航至目标网站。
输入要抓取的网址并加载页面。
步骤二:选择数据点
按住 Ctrl 键并单击所需的元素,例如产品标题或价格。
这就是它的样子:
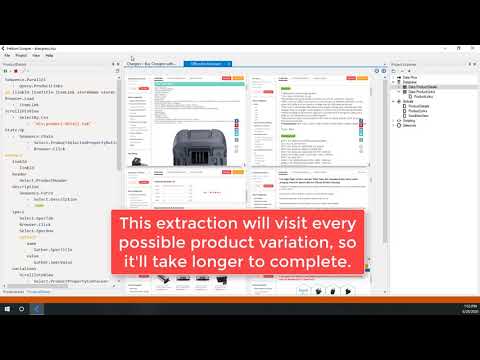
✓ 检查点: 浏览器中选中的元素会高亮显示。
步骤 3:运行并导出
点击提取,然后将数据导出到 Excel、CSV、JSON 或 SQLite。
✅ 结果: 您在几分钟内就从网站提取出了干净的数据。
💡 专业提示: 启用选择模式,然后按住 Ctrl 键并单击相似的项目,即可快速教会工具识别模式。
如何使用 Helium Scraper 简单工作流程
简单工作流程 无需编写代码或具备编程技能,即可构建无代码爬虫工作流程。
以下是使用步骤。
现在让我们逐一分析每个步骤。
第一步:定义你的类型
创建类型来标记要提取的数据元素。
种类用于定义产品标题、价格或页面上的任何字段。
步骤二:添加操作
添加点击和分页导航等操作。
这就是它的样子:
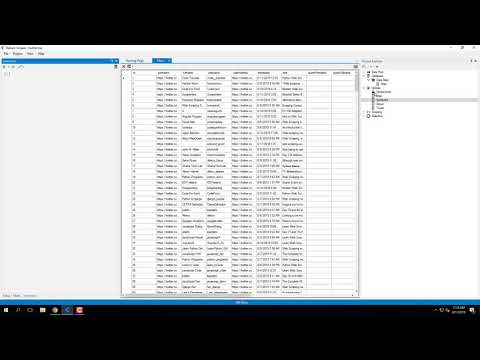
✓ 检查点: 您的工作流程运行正常,未出现任何错误。
步骤 3:验证工作流程
在不同的页面上测试你的分类,以确认结果准确。
✅ 结果: 你通过点击选择建立了一个可重复的提取流程。
💡 专业提示: 拖放 建筑商 对于初学者来说很有帮助;在操作中创建重复循环以处理大规模提取。
如何按需使用氦气刮板秤
按需扩展 允许您通过代理集成扩展大型项目,以避免速率限制和验证码。
以下是使用步骤。
现在让我们逐一分析每个步骤。
步骤 1:打开代理设置
打开设置菜单,找到代理集成部分。
Helium Scraper 可以与代理服务集成,绕过验证码和 IP 封锁。
步骤 2:输入代理详细信息
输入代理地址和端口,然后确认并启用代理。
这就是它的样子:
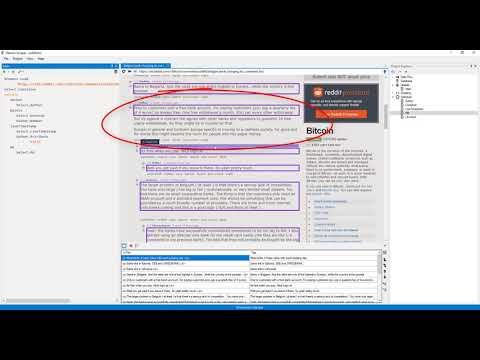
✓ 检查点: 您的请求将通过选定的出口节点进行路由。
步骤 3:选择出口节点
选择美国出口节点或任何拥有住宅代理的地点。
从特定国家/地区发出的出口节点可帮助您抓取具有地理定位的数据。
✅ 结果: 你可以大规模抓取数据,而不会达到每小时 500-600 次请求的限制。
💡 专业提示: 对于持续的、大型的抓取项目,请使用轮换代理和粘性会话。
如何使用 Helium Scraper 捕获复杂数据
捕获复杂数据 允许您从依赖 JavaScript 的现代网站中捕获复杂的嵌套数据。
以下是使用步骤。
现在让我们逐一分析每个步骤。
步骤 1:启用 JavaScript 处理
让 Helium Scraper 导航并点击元素以渲染 JavaScript。
该工具在处理页面的同时还会下载图片。
步骤 2:设置嵌套提取
定义嵌套类型以提取列表或表格中的数据。
这就是它的样子:
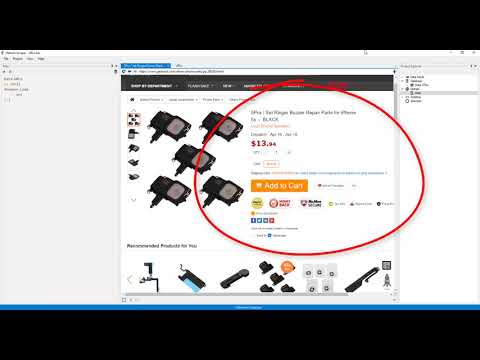
✓ 检查点: 嵌套字段在数据预览中显示正确。
步骤 3:使用自定义代码
添加自定义 JavaScript 和 SQL 以执行高级数据提取任务。
✅ 结果: 您从一个动态网站中捕获了复杂的、结构化的网络数据。
💡 专业提示: 在运行完整作业之前,先在几个示例页面上验证嵌套类型。
如何使用 Helium Scraper 一体化安装程序
随处安装 允许您在任何计算机上安装桌面应用程序并在本地运行数据抓取。
以下是使用步骤。
现在让我们逐一分析每个步骤。
步骤 1:下载安装程序
从网站下载安装程序并运行安装程序。
安装过程非常简单,几分钟即可完成。
步骤 2:激活您的许可证
打开应用程序,并使用密码确认您的许可证。
这就是它的样子:
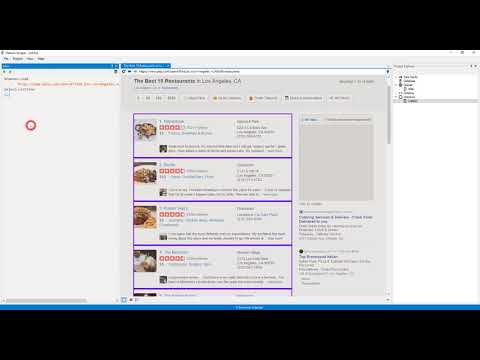
✓ 检查点: 该应用程序启动并加载内置浏览器。
步骤 3:检查系统资源
请确保您的计算机有足够的资源来处理大型任务。
Helium Scraper 在本地运行,可能需要大量的桌面资源。
✅ 结果: 你的机器上已经配备了本地刮刀。
💡 专业提示: 对于繁重的任务,请关闭其他应用程序,以便将更多资源用于提取过程。
Helium Scraper 专业技巧和快捷方式
经过两年对 Helium Scraper 的测试,以下是我提高数据提取速度的最佳技巧。
键盘快捷键
| 行动 | 捷径 |
|---|---|
| 选择一个元素 | 按住 Ctrl 键并单击 |
| 展开选择 | Ctrl + Shift + 单击 |
| 运行提取 | F5 |
| 打开项目设置 | Ctrl + , |
大多数人错过的隐藏功能
- 自定义 JavaScript 和 SQL: 添加代码以实现点击菜单无法访问的高级提取。
- 美国出口节点选择: 从特定位置选择代理来抓取受地理位置限制的搜索引擎和网站数据。
- 重复循环: 在操作中创建循环,以自动导航分页并提取大型列表。
氦气刮刀常见错误及避免方法
错误一:跳过代理集成
❌ 错误: 从同一个 IP 地址发送数百个请求,结果触发了验证码和速率限制。
✅ 右图: 设置代理集成,使用轮换代理,以避免每小时 500-600 次请求的限制。
错误二:没有认可你的类型
❌ 错误: 仅凭一个页面就断定这种模式适用于整个网站。
✅ 右图: 在多个示例页面上测试每种类型,以确认数据识别的准确性。
错误三:忽视计算机资源
❌ 错误: 在众多应用程序争夺有限资源的同时,它还在运行一个大型任务。
✅ 右图: 关闭其他程序,以便提取过程获得所需的资源。
氦气刮板故障排除
问题:页面加载时空白
原因: 该网站依赖于尚未完成渲染的 JavaScript。
使固定: 让工具导航并点击元素,以便页面完全加载后再选择数据。
问题:被阻止或遇到验证码
原因: 来自同一 IP 地址的请求过多触发了网站的防御机制。
使固定: 在设置中启用代理,输入地址和端口,然后选择一个新的出口节点。
问题:提取的数据错误
原因: 您的类型与某些页面上的元素匹配错误。
使固定: 使用 Ctrl+单击重新选择,并在网站的不同页面上验证类型。
📌 笔记: 如果以上方法均无法解决您的问题,请查看文档或联系 Helium Scraper 支持和社区。
什么是氦气刮刀?
氦气刮刀 是一款桌面端无代码爬虫,可让您以可视化的方式从网络中提取数据。
把它想象成一个智能荧光笔——你只需对准、点击,它就会为你收集数据。
与云工具的主要区别在于它是在本地运行的,这对于每个抓取任务来说都是如此,非常适合小型、轻量级的使用场景。
观看这段快速概览:
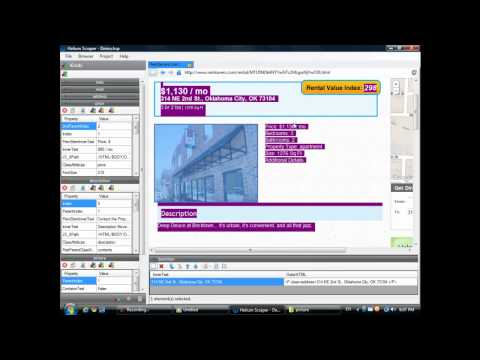
它包含以下主要特点:
- 快速提取: 只需几个简单步骤即可从任何页面提取数据
- 简单工作流程: 无需编码技能即可构建无代码工作流程
- 按需扩展: 通过代理集成和美国出口节点实现规模化
- 捕获复杂数据: 捕获复杂的嵌套数据和 JavaScript 内容
- 随处安装: 在任何计算机上安装并本地运行网络爬虫程序
如需完整评测,请参阅我们的 氦气刮刀评测.
氦气刮板定价
以下是氦气刮板在 2026 年的售价:
免费试用: 是的——免费试用版可以让您在购买前测试该工具。
退款保证: 价格为一次性购买台式机的价格,而非订阅价格。
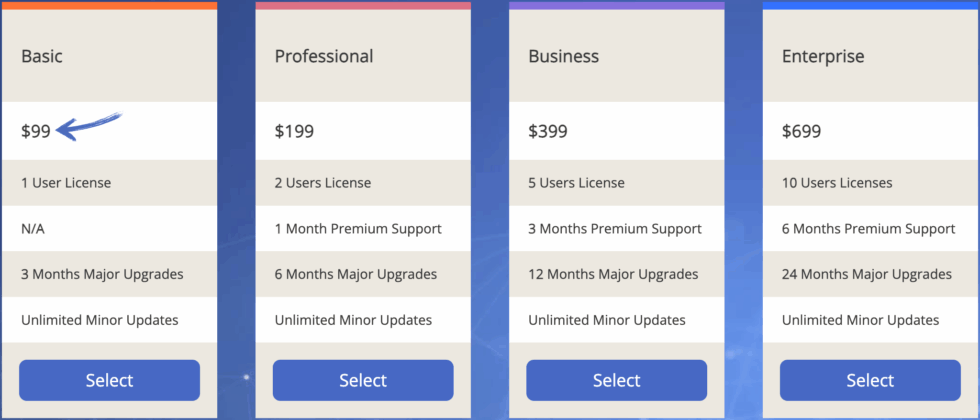
💰 性价比最高: 专业版——最适合大多数经常进行网页抓取的自由职业者。
氦气刮刀与其他替代方案
Helium Scraper 与其他产品相比如何?以下是竞争格局:
| 工具 | 最适合 | 价格 | 等级 |
|---|---|---|---|
| 氦气刮刀 | 无代码本地抓取 | 一次性支付 99 美元 | ⭐ 3.5 |
| Octoparse | 可视化云抓取 | 每月99美元 | ⭐ 4.3 |
| ParseHub | 初学者 | 每月 189 美元 | ⭐ 4.2 |
| Scrapy | 开发者 | 自由的 | ⭐ 4.5 |
| ScrapingBee | API 和规模 | 每月 49 美元 | ⭐ 4.4 |
| 明亮数据 | 企业代理 | 每月 499 美元 | ⭐ 4.6 |
快速精选:
- 综合最佳: Helium Scraper——可视化、无需代码、一次性付费。
- 最佳预算: Scrapy——面向代码编写者的免费开源软件。
- 最适合初学者: ParseHub——简单易学。
- 最适合用来衡量规模: ScrapingBee——一个用于自动化大型任务的云API。
🎯氦气刮刀替代方案
正在寻找氦气刮刀的替代方案?以下是一些最佳选择:
- 🚀 Octoparse: 一款基于云端的可视化爬虫,具有调度和 自动化 无需保持计算机开机即可运行任务。
- 👶 ParseHub: 这是一款对初学者友好的工具,设置简单,只需点击几下即可完成,非常适合数据提取新手用户。
- 🔧 Scrapy: 一个免费的开源框架,适合喜欢编写代码和构建自定义网络爬虫项目的开发者。
- ⚡ ScrapingBee: 一个云端网页抓取 API,可以渲染 JavaScript 并大规模处理代理和验证码。
- 🏢 亮数据: 一个拥有庞大代理网络和美国出口节点的企业平台,用于进行地理定向提取。
完整列表请参见我们的 氦气刮刀的替代方案 指导。
⚔️氦气刮刀对比
以下是 Helium Scraper 与各竞争对手的对比:
- Helium Scraper 对比 Octoparse: Helium Scraper 凭借一次性收费的价格优势胜出;Octoparse 则在云端调度和并行运行方面胜出。
- Helium Scraper 对比 ParseHub: 两者都适合初学者;Helium Scraper 更适合本地轻型刮削作业,且无需支付月费。
- Helium Scraper 对比 Scrapy: 对于构建自定义爬虫的程序员来说,Scrapy 是最佳选择;对于无需代码的视觉提取来说,Helium Scraper 是最佳选择。
- Helium Scraper 对比 ScrapingBee: ScrapingBee 在自动化和规模化方面表现出色;Helium Scraper 更适合无需编码的快速本地任务。
- Helium Scraper 对比 Bright Data: Bright Data 在代理和企业级规模方面领先;Helium Scraper 更简单,而且对于小型任务来说价格便宜得多。
立即开始使用 Helium Scraper
你已经学会了如何使用 Helium Scraper 的所有主要功能:
- ✅ 快速提取
- ✅ 简单的工作流程
- ✅ 按需扩展
- ✅ 捕获复杂数据
- ✅ 可安装在任何位置
下一步: 选择一项功能,立即试用。
大多数人都是从快速提取开始的。
只需不到5分钟。
常见问题解答
如何使用氦气刮刀?
安装桌面应用程序,打开内置浏览器,按住 Ctrl 键并单击要创建类型的数据,然后运行并将提取内容导出到 Excel、CSV、JSON 或 SQLite。
Helium Scraper 需要编程技能吗?
不。Helium Scraper 是一款无需编写代码、只需点击操作的工具。您可以通过可视化方式选择数据,无需编写代码;当然,它也支持自定义 JavaScript 和 SQL,可用于高级数据提取。
Helium Scraper 中的代理集成是如何工作的?
打开设置,输入代理地址和端口,确认并启用代理。选择一个出口节点(例如美国),以便抓取地理位置定向数据并避免验证码。
Helium Scraper 适合大型项目吗?
它适用于中小型项目。对于大型项目,由于该工具在本地运行并会占用您的资源,因此请使用轮换代理来避免每小时 500-600 次请求的限制。
Helium Scraper 能处理 JavaScript 网站吗?
是的。它通过导航和点击元素来渲染 JavaScript 并下载图像,从而让您从现代动态网站中提取复杂的嵌套数据。













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
