
Démarrage rapide
Ce guide couvre toutes les fonctionnalités de Zyte :
- Commencer — Créez votre compte et effectuez la configuration initiale
- Comment utiliser le scraping par IA — Extraire des données structurées de n'importe quelle page web sans écrire de code personnalisé
- Comment utiliser l'extraction de données e-commerce — Collecter à grande échelle les données produits des boutiques en ligne
- Comment utiliser les données pour un agent d'IA — Fournir des ensembles de données propres aux modèles d'IA et aux data scientists
- Comment utiliser l'API Zyte — Intégrez le web scraping à votre code via un point central.
- Comment utiliser l'extraction de données d'actualités et d'articles — Extraire le texte intégral d'articles de presse et de billets de blog
- Comment utiliser les données de récupération d'offres d'emploi — Rassemblez les offres d'emploi avec les champs salaire, intitulé et entreprise
- Comment utiliser l'extraction de données immobilières — Extraire les annonces immobilières avec les détails de prix et de localisation
- Comment utiliser un outil d'extraction de données des réseaux sociaux — Collecter les publications et les données de profils des médias sociaux publics
- Comment utiliser l'hébergement cloud évolutif — Exécuter des tâches de web scraping sur une infrastructure cloud à mise à l'échelle automatique
Temps nécessaire : 5 minutes par fonctionnalité
Vous trouverez également dans ce guide : Conseils de pro | Erreurs courantes | Dépannage | Tarification | Alternatives
Pourquoi faire confiance à ce guide ?
J'utilise Zyte depuis plus de six mois et j'ai testé toutes les fonctionnalités présentées ici. Ce tutoriel est basé sur une véritable expérience pratique, et non sur des arguments marketing ou des captures d'écran du fournisseur.

Zyte est l'un des plus puissants outils de web scraping disponible dès aujourd'hui.
Mais la plupart des utilisateurs n'exploitent qu'une infime partie de ses possibilités.
Ce guide vous montre comment utiliser chaque fonctionnalité principale.
Étape par étape, avec captures d'écran et conseils de pro.
Tutoriel Zyte
Ce tutoriel complet sur Zyte vous guide pas à pas à travers chaque fonctionnalité, de la configuration initiale aux astuces avancées qui feront de vous un utilisateur expert.
Zyte
Transformez n'importe quel site web en un site structuré données En quelques minutes, Zyte gère la protection anti-bannissement, la rotation des proxys et le rendu du navigateur pour que les développeurs puissent se concentrer sur la recherche des données pertinentes. Essayez-le gratuitement dès aujourd'hui.
Premiers pas avec Zyte
Avant d'utiliser toute fonctionnalité, veuillez effectuer cette configuration unique.
Cela prend environ 3 minutes.
Étape 1 : Créez votre compte
Rendez-vous sur le site web de Zyte et cliquez sur « S'inscrire ».
Saisissez votre adresse e-mail et créez un mot de passe pour vous connecter.
✓ Point de contrôle: Vérifiez votre boîte de réception pour recevoir un courriel de confirmation.
Étape 2 : Accéder au tableau de bord
Zyte est une plateforme web — aucun téléchargement n'est nécessaire.
Connectez-vous avec votre nouveau compte et ouvrez le tableau de bord.
Voici à quoi ressemble le tableau de bord :
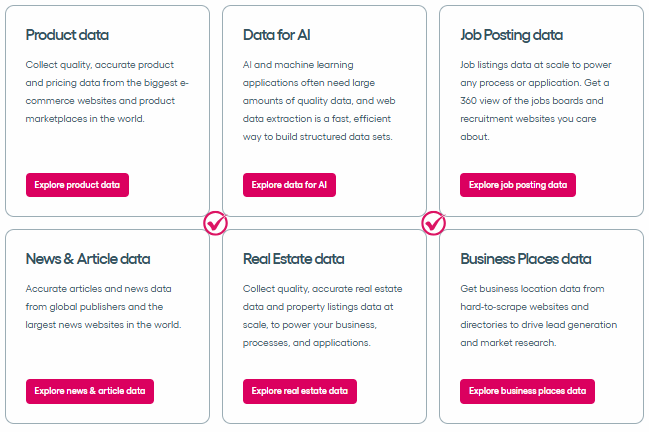
✓ Point de contrôle: Vous devriez voir le tableau de bord principal avec plusieurs outils listés.
Étape 3 : Obtenez votre clé API
Accédez aux paramètres de votre compte et copiez votre clé API.
Par exemple, vous pouvez coller cette clé dans votre script Python ou dans n'importe quel client HTTP.
✅ Terminé : Vous êtes prêt à utiliser n'importe quelle fonctionnalité ci-dessous.
Comment utiliser le scraping de Zyte AI
IA Scraping permet d'extraire des données de n'importe quel site web cible grâce à une analyse syntaxique basée sur l'IA qui gère automatiquement la complexité.
Voici comment l'utiliser étape par étape.
Étape 1 : Ouvrez l’outil d’extraction de données IA
Connectez-vous à votre tableau de bord Zyte et sélectionnez « Scraping IA ».
Le module d'extraction de données par IA lit le contenu HTML et le transforme en données structurées.
Étape 2 : Saisissez l’URL cible
Collez l'URL de la page dont vous souhaitez extraire les données.
Voici à quoi cela ressemble :
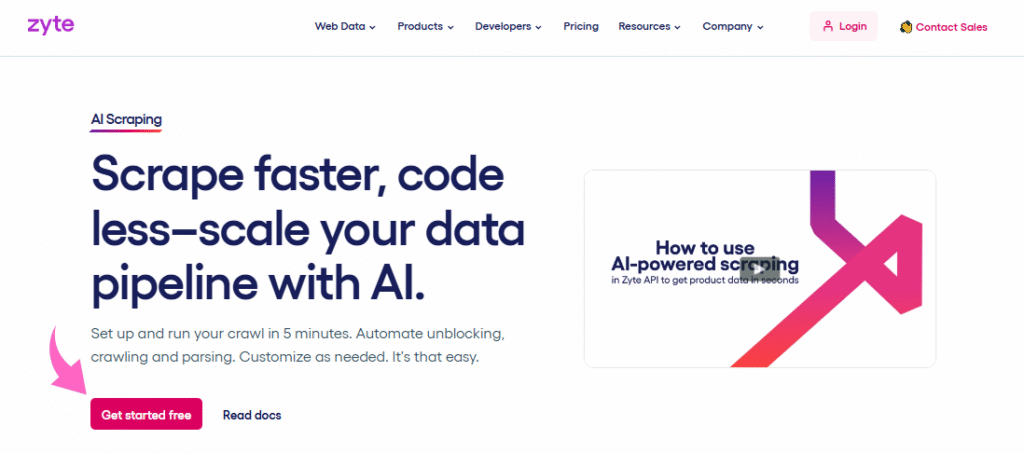
✓ Point de contrôle: Vous devriez voir un aperçu des champs extraits au format JSON.
Étape 3 : Examiner et télécharger les résultats
Vérifiez la réponse JSON extraite et exportez votre fichier.
✅ Résultat : Vous avez extrait avec précision les données de votre site web cible et pouvez désormais réaliser n'importe quel projet de web scraping.
💡 Conseil de pro : Commencez par tester sur une seule page avant de déployer le test à grande échelle sur l'ensemble du site.
Comment utiliser l'extraction de données e-commerce de Zyte
Extraction de données e-commerce vous permet de collecter des données produits provenant de sites de commerce électronique, notamment le prix, le titre et la catégorie.
Voici comment l'utiliser étape par étape.
Étape 1 : Sélectionner l'extraction du commerce électronique
Ouvrez le tableau de bord et choisissez l'outil d'extraction de données e-commerce.
Cet outil est conçu pour gérer les pages produits des principaux sites de vente en ligne.
Étape 2 : Configurer les champs du produit
Sélectionnez les informations spécifiques dont vous avez besoin : prix, titre ou catégorie.
Voici à quoi cela ressemble :
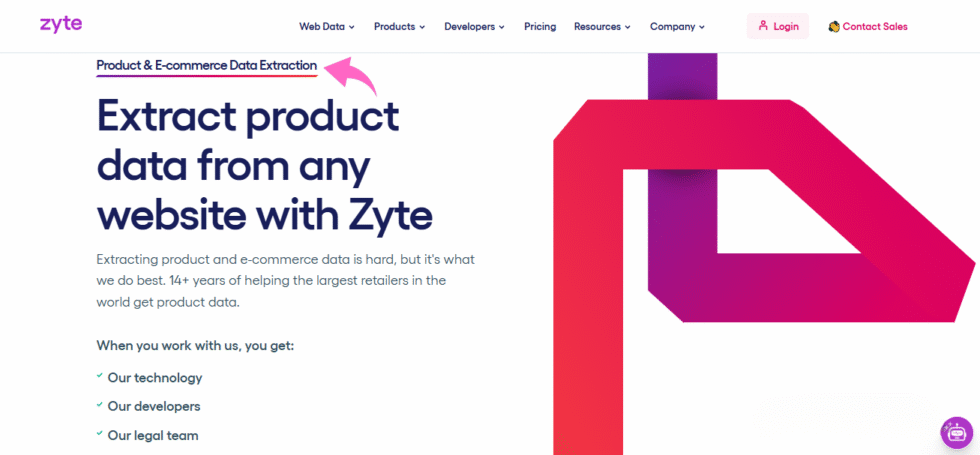
✓ Point de contrôle: Vous devriez voir des listes de produits avec des colonnes « prix » et « titre ».
Étape 3 : Exécuter et exporter
Cliquez sur « Extraire » pour lancer l'extraction et télécharger les résultats au format JSON ou CSV.
✅ Résultat : Vous disposez désormais de données produits structurées provenant de vos sites de commerce électronique cibles.
💡 Conseil de pro : Utilisez les paramètres de géolocalisation dans vos requêtes pour comparer les prix spécifiques à chaque région.
Comment utiliser l'agent d'IA Zyte
Données pour agent IA permet de fournir directement des données Web propres aux modèles d'IA et aux data scientists pour l'entraînement ou l'analyse.
Voici comment l'utiliser étape par étape.
Étape 1 : Choisir un pipeline de données
Sélectionnez l'option « Données pour l'agent IA » dans le menu principal.
Cela permet de connecter les données de votre API de web scraping à des pipelines compatibles avec l'IA.
Étape 2 : Définir le périmètre de vos données
Définissez le périmètre des données provenant des sites web que vous devez collecter.
Voici à quoi cela ressemble :
✓ Point de contrôle: Votre pipeline affiche un statut connecté avec des données en circulation.
Étape 3 : Exporter vers votre outil d’IA
Envoyez les données structurées en sortie à votre plateforme d'IA préférée.
✅ Résultat : Vous intégrez directement des données web dans vos flux de travail d'IA.
💡 Conseil de pro : Planifiez des tâches d'extraction récurrentes afin que vos modèles d'IA soient toujours entraînés sur des données fraîches.
Comment utiliser l'API Zyte
API Zyte permet d'intégrer le web scraping à votre propre code en utilisant un point d'entrée API unique avec protection anti-bannissement.
Voici comment l'utiliser étape par étape.
Étape 1 : Obtenez votre clé API
Inscrivez-vous ou connectez-vous, puis copiez votre clé API Zyte depuis le tableau de bord.
Cette clé est le point d'entrée de chaque requête API que vous effectuez.
Étape 2 : Envoyez votre première demande
Utilisez Python ou toute autre bibliothèque HTTP pour envoyer une requête au point de terminaison de l'API.
Voici à quoi cela ressemble :
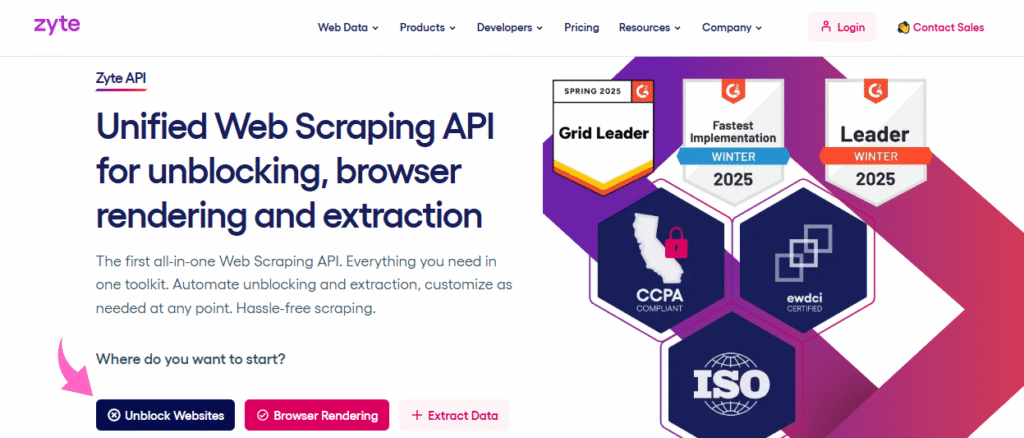
✓ Point de contrôle: Votre script renvoie un code d'état 200 avec le code HTML ou JSON de la page.
Étape 3 : Analyser la réponse
L'API renvoie du contenu HTML ou du JSON structuré selon vos paramètres ; vérifiez chaque objet de réponse pour détecter les erreurs.
✅ Résultat : Vous pouvez désormais extraire des données de sites web par programmation grâce à votre propre code.
💡 Conseil de pro : Associez l'API Zyte au framework Scrapy et aux bibliothèques scrapy-zyte-api pour un crawling à grande échelle.
Comment utiliser les données d'actualités et d'articles de Zyte Extract
Extraction des données d'actualités et d'articles vous permet de récupérer automatiquement des articles de presse et du contenu de blog. texte et l'extraction de données.
Voici comment l'utiliser étape par étape.
Étape 1 : Ouvrez l'extracteur de nouvelles
Accédez à Extraire les données des actualités et des articles dans le menu.
Cet outil est optimisé pour l'analyse des articles de presse provenant de sites d'information.
Étape 2 : Ajouter les URL sources
Collez les URL des pages d'actualités ou des flux que vous souhaitez extraire.
Voici à quoi cela ressemble :
✓ Point de contrôle: Les résultats affichent les titres des articles, leurs dates et des aperçus de leur texte.
Étape 3 : Télécharger les données de l’article
Lancez l'extraction et exportez les résultats avec le titre, la date et le texte intégral.
✅ Résultat : Vous disposez d'articles de presse structurés, prêts à être analysés ou archivés.
💡 Conseil de pro : Utilisez les filtres de catégorie pour affiner les résultats lors de vos recherches sur les grands sites d'actualités.
Comment utiliser Zyte Job Scraping Data
Données de récupération d'emplois vous permet de collecter les offres d'emploi provenant de sites de carrière avec des champs structurés tels que le titre, l'entreprise et le salaire.
Voici comment l'utiliser étape par étape.
Étape 1 : Sélectionner le scraping de tâches
Ouvrez la fonction « Collecte de données de tâches » depuis le panneau d'outils.
Ce programme d'extraction de données gère automatiquement la mise en page des sites d'offres d'emploi les plus courants.
Étape 2 : Définissez vos critères de recherche
Saisissez l'intitulé du poste, le lieu ou la catégorie que vous souhaitez cibler.
Voici à quoi cela ressemble :
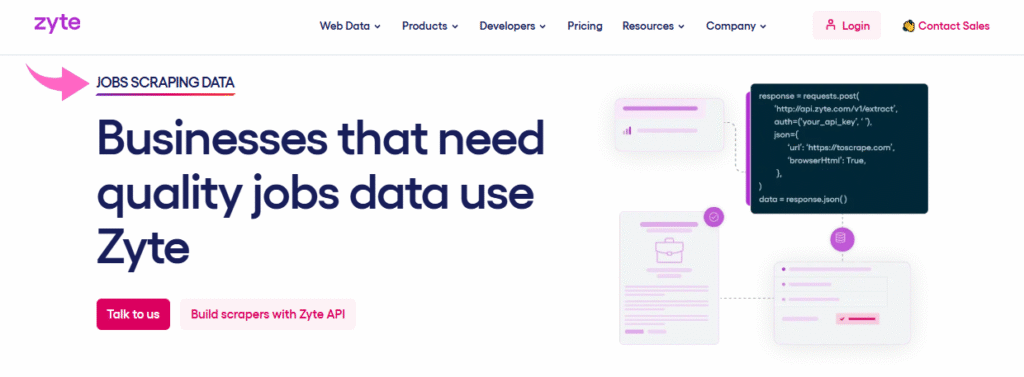
✓ Point de contrôle: Un tableau d'offres d'emploi s'affiche avec tous les champs requis.
Étape 3 : Exporter les offres d’emploi
Téléchargez les données au format CSV ou JSON pour les examiner.
✅ Résultat : Vous disposez de données propres sur les offres d'emploi pour les études de marché ou le suivi.
💡 Conseil de pro : Programmez des collectes de données hebdomadaires pour suivre l'évolution des nouvelles offres d'emploi et des tendances salariales au fil du temps.
Comment utiliser l'extraction de données immobilières Zyte
Immobilier Extraction de données permet d'extraire les annonces immobilières des sites spécialisés en incluant les champs prix, localisation et détails.
Voici comment l'utiliser étape par étape.
Étape 1 : Extraction des données immobilières ouvertes
Sélectionnez « Extraction de données immobilières » dans le tableau de bord.
Ce module analyse les pages d'annonces immobilières sur les principaux sites immobiliers.
Étape 2 : Configurer les champs de propriété
Choisissez les données dont vous avez besoin : prix, adresse ou superficie.
Voici à quoi cela ressemble :
✓ Point de contrôle: Les annonces immobilières s'affichent avec des colonnes « prix » et « emplacement ».
Étape 3 : Exporter les annonces
Téléchargez les résultats dans le format de votre choix pour analyse.
✅ Résultat : Vous disposez de données immobilières structurées pour l'analyse des investissements.
💡 Conseil de pro : Utilisez des proxys à ciblage géographique pour accéder aux annonces immobilières restreintes à une région.
Comment utiliser Zyte Social Media Scraper
Extracteur de données des réseaux sociaux vous permet de collecter des données publiques issues des médias sociaux, notamment les publications, les profils et les indicateurs d'engagement.
Voici comment l'utiliser étape par étape.
Étape 1 : Choisir un outil d’extraction de données des réseaux sociaux
Sélectionnez l'outil Social Media Scraper dans le menu.
Cela permet de gérer les profils publics et les pages de publications sur toutes les plateformes.
Étape 2 : Saisissez les URL du profil ou du hashtag
Collez les URL des pages publiques ou des sujets que vous souhaitez analyser.
Voici à quoi cela ressemble :
✓ Point de contrôle: Les publications sur les réseaux sociaux apparaissent avec des colonnes de texte et d'engagement.
Étape 3 : Examiner et télécharger les données
Vérifiez le résultat et exportez-le au format JSON ou CSV.
✅ Résultat : Vous disposez désormais de données sociales publiques prêtes pour l'analyse des tendances ou reportage.
💡 Conseil de pro : Respectez les limites de débit et les conditions d'utilisation du site pour assurer le bon fonctionnement de votre scraper.
Comment utiliser l'hébergement cloud évolutif Zyte
Hébergement cloud évolutif vous permet d'exécuter vos tâches de web scraping sur une infrastructure cloud qui évolue en fonction de vos besoins en données web.
Voici comment l'utiliser étape par étape.
Étape 1 : Accéder aux paramètres d’hébergement cloud
Ouvrez la section Hébergement cloud évolutif dans votre compte.
C'est ici que vous gérez les ressources serveur pour vos tâches d'extraction.
Étape 2 : Déployer votre tâche de scraping
Téléchargez votre robot d'exploration ou votre script et sélectionnez votre niveau de ressources.
Voici à quoi cela ressemble :
✓ Point de contrôle: Votre tableau de bord de tâches affiche les robots d'exploration actifs ainsi que les statistiques d'utilisation des ressources.
Étape 3 : Surveiller et mettre à l’échelle
Suivez l'avancement des tâches et ajustez les ressources en fonction de l'évolution de vos besoins en données.
✅ Résultat : Votre système de web scraping s'exécute sur une infrastructure cloud gérée, quelle que soit son échelle.
💡 Conseil de pro : Commencez par un forfait plus petit et augmentez-le seulement après avoir compris le volume réel de vos demandes.
Conseils et astuces Zyte Pro
Après avoir testé Zyte pendant plus de six mois, voici mes meilleurs conseils.
Raccourcis clavier
| Action | Raccourci |
|---|---|
| Exécuter l'araignée | Ctrl + R |
| Arrêter le travail actif | Ctrl + Maj + S |
| Console de l'IDE Open Zyte | Ctrl + ` |
| Rechercher des fichiers de projet | Ctrl + P |
Fonctionnalités cachées que la plupart des gens ignorent
- IDE Zyte : Écrivez, testez et déboguez des scripts de navigateur directement dans un environnement basé sur le navigateur, sans passer par un éditeur local.
- Extraction automatique : L'extracteur basé sur l'IA renvoie des données JSON structurées sans nécessiter l'écriture de code d'analyse et s'adapte aux changements de mise en page des sites web.
- Discutez avec nous via ZyteBot : Utilisez le chat intégré à l'application avec ZyteBot pour obtenir des réponses instantanées sur la configuration, les erreurs ou les questions relatives aux meilleures pratiques.
Erreurs courantes à éviter chez Zyte
Erreur n° 1 : Ignorer les paramètres de rotation du proxy
❌ Faux : L'envoi de toutes les requêtes depuis une seule adresse IP déclenche le blocage de l'accès au site web cible.
✅ À droite : Activez la rotation intelligente des proxys pour que Zyte change automatiquement d'adresse IP afin d'éviter d'être détecté.
Erreur n° 2 : Extraction de données sans consulter le fichier robots.txt
❌ Faux : L'exploration des pages bloquées par le propriétaire du site est longue à corriger et peut entraîner des problèmes juridiques.
✅ À droite : Consultez toujours les directives du fichier robots.txt et identifiez les chemins d'accès restreints avant de commencer à pratiquer le web scraping responsable.
Erreur n° 3 : Ne pas gérer les erreurs dans votre script
❌ Faux : Laisser votre scraper planter silencieusement lorsqu'une page Web renvoie une réponse 403 ou un délai d'attente dépassé.
✅ À droite : Ajoutez une gestion des erreurs à votre code pour consigner les erreurs HTTP et relancer automatiquement les requêtes ayant échoué.
Dépannage Zyte
Problème : Les requêtes renvoient un contenu HTML vide
Cause: Le site web cible utilise JavaScript pour charger le contenu de manière dynamique.
Réparer: Activez le rendu navigateur dans votre requête API Zyte afin que la page se charge entièrement avant l'extraction.
Problème : Le scraper est bloqué après quelques requêtes.
Cause: Le site détecte les requêtes répétées provenant de la même adresse IP ou du même agent utilisateur.
Réparer: Activez la rotation intelligente des proxys et ajoutez des en-têtes personnalisés à vos requêtes pour éviter la détection par les systèmes anti-bots.
Problème : Les données extraites comportent des champs manquants ou corrompus.
Cause: Le site web cible a modifié sa mise en page, ce qui a perturbé votre analyseur syntaxique.
Réparer: Passez en mode d'extraction automatique pour que l'IA s'adapte aux changements de mise en page sans que vous ayez à modifier manuellement votre code.
📌 Note: Si aucune de ces solutions ne résout votre problème, contactez l'assistance Zyte ou utilisez le chat disponible 24h/24 et 7j/7 pour obtenir de l'aide.
Qu'est-ce que Zyte ?
Zyte est une plateforme de web scraping qui aide les développeurs et les data scientists à extraire des données de sites web sans avoir à gérer manuellement les blocages d'adresses IP, les proxys ou les mesures anti-bots.
Considérez-le comme un point central pour tous vos besoins en données web — une plateforme unique avec de multiples outils pour chaque tâche d'extraction de données.
Regardez ce bref aperçu :
Il comprend les fonctionnalités clés suivantes :
- Extraction de données par IA : Utilisez l'IA pour extraire des données structurées de n'importe quelle page web sans code d'analyse personnalisé.
- Extraction de données e-commerce : Collectez à grande échelle les données produits des boutiques en ligne.
- Données pour l'agent IA : Fournissez directement aux modèles d'IA des ensembles de données propres et structurés.
- API Zyte : Intégrez le web scraping à votre propre code grâce à une protection anti-bannissement intégrée.
- Extraction des données d'actualités et d'articles : Extraire les articles de presse avec le texte intégral et les métadonnées.
- Extraction de données sur les emplois : Rassemblez des offres d'emploi structurées provenant de sites de recrutement.
- Extraction de données immobilières : Extraire les annonces immobilières contenant les champs de prix et de localisation.
- Extracteur de données des réseaux sociaux : Collecter les publications publiques et les données de profil à des fins d'analyse.
- Hébergement cloud évolutif : Exécutez des tâches de web scraping sur une infrastructure à mise à l'échelle automatique.
Pour une analyse complète, consultez notre Avis sur Zyte.
Zyte est une solution idéale pour toute équipe ayant besoin de collecter des pages web à grande échelle sans avoir à gérer de proxys ni à écrire de nouveaux analyseurs syntaxiques personnalisés.
Tarification de Zyte
Voici le prix de Zyte en 2026 :
Zyte utilise un modèle de tarification au paiement par requête basé sur les niveaux de complexité des sites web.
Réponse HTTP extraite — Prix pour 1 000 requêtes
| Niveau du site Web | Paiement à l'utilisation | Plan à 100 $ | Plan à 500 $ |
|---|---|---|---|
| Niveau 1 | $0.40 | $0.30 | $0.19 |
| Niveau 2 | $0.50 | $0.37 | $0.24 |
| Niveau 3 | $0.70 | $0.52 | $0.33 |
| Niveau 4 | $0.97 | $0.72 | $0.46 |
| Niveau 5 | $1.53 | $1.15 | $0.73 |
Requêtes de navigateur extraites — Prix pour 1 000 requêtes
| Niveau du site Web | Paiement à l'utilisation | Plan à 100 $ | Plan à 500 $ |
|---|---|---|---|
| Niveau 1 | $1.80 | $1.35 | $0.85 |
| Niveau 2 | $2.80 | $2.10 | $1.33 |
| Niveau 3 | $4.80 | $3.59 | $2.27 |
| Niveau 4 | $8.79 | $6.59 | $4.17 |
| Niveau 5 | $16.78 | $12.58 | $7.96 |
Essai gratuit : Oui — les nouveaux comptes reçoivent des crédits gratuits pour tester la plateforme.
Garantie de remboursement : Non, les crédits ne sont pas remboursables une fois utilisés.
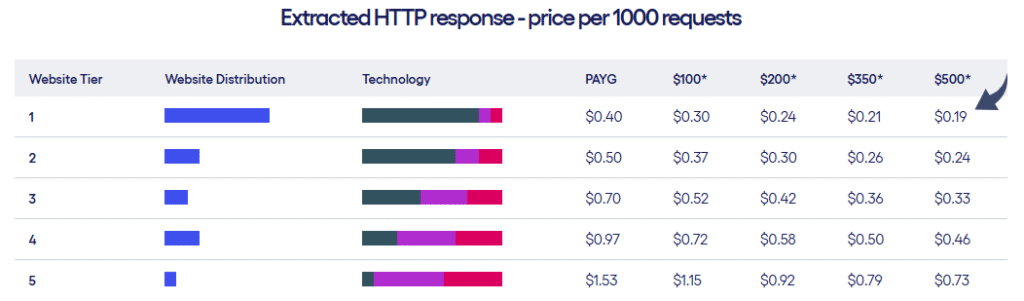
💰 Meilleur rapport qualité-prix : Forfait à 500 $ de niveau 1 : vous bénéficiez du prix le plus bas par requête, soit 0,19 $ pour HTTP et 0,85 $ pour l’extraction depuis le navigateur.
Zyte contre les alternatives
Comment Zyte se compare-t-il ? Voici le contexte concurrentiel :
| Outil | Idéal pour | Prix | Notation |
|---|---|---|---|
| Zyte | Web scraping complet | 0,19 $+/1K requis | ⭐ 4,5 |
| Apify | Acteurs de scraping pré-construits | 49 $/mois | ⭐ 4,6 |
| ScrapeGraphAI | Extraction de graphes pilotée par l'IA | Source libre/open source | ⭐ 4,3 |
| Données claires | réseaux proxy d'entreprise | 500 $ et plus par mois | ⭐ 4,5 |
| Parcourir l'IA | Extraction de données Web sans code | 49 $/mois | ⭐ 4,4 |
| ScrapingBee | Extraction de données API simple | 49 $/mois | ⭐ 4,4 |
| Oxylabs | Procurations résidentielles | 99 $/mois | ⭐ 4,5 |
| ThorData | Rotation des mandataires budgétaires | 15 $/mois | ⭐ 4.2 |
| Extracteur de données Web | Extraction de données par extension de navigateur | Gratuit / 50 $/mois | ⭐ 4,3 |
| Grattoir à hélium | Extraction visuelle de données sur ordinateur | 99 $ une seule fois | ⭐ 4.1 |
| Firecrawl | Extraction de données prêtes pour LLM | 19 $/mois | ⭐ 4,4 |
Sélection rapide :
- Meilleur résultat global : Zyte — gère tout, de la gestion des proxys à l'extraction par IA, sur une seule plateforme.
- Meilleur budget : ScrapeGraphAI — logiciel libre et gratuit pour les développeurs qui souhaitent un contrôle total.
- Idéal pour les débutants : Browse AI — une interface sans code qui rend le web scraping accessible.
- Idéal pour les entreprises : Bright Data — un réseau proxy massif conçu pour les opérations à grande échelle.
🎯 Alternatives à Zyte
Vous cherchez des alternatives à Zyte ? Voici les meilleures options :
- 🚀 Apify : Propose des centaines d'acteurs préconfigurés pour les tâches de scraping courantes, avec un niveau gratuit généreux pour les petits projets.
- 💰 ScrapeGraphAI : Bibliothèque open source d'extraction de données IA pour les développeurs Python qui préfèrent un contrôle total sans frais d'abonnement.
- 🏢 Données brillantes : Réseau proxy de niveau entreprise avec plus de 72 millions d'adresses IP et une plateforme complète de collecte de données.
- 👶 Parcourir l'IA : Un outil d'extraction de données sans code qui permet à quiconque d'extraire des données web en pointant et en cliquant — aucun codage n'est requis.
- ⚡ ScrapingBee : API simple qui gère les proxys et les navigateurs sans interface graphique, vous permettant ainsi de récupérer des données avec une seule requête HTTP.
- 🔒 Oxylabs : Des proxys résidentiels et de centres de données haut de gamme associés à une API de web scraping pour une collecte à grande échelle.
- 🔥 ThorData : Service de proxy économique avec une rotation fiable et une bonne couverture pour les équipes sensibles aux prix.
- 🔧 Extracteur de données Web : Extension gratuite pour navigateur qui vous permet de créer visuellement des scrapers directement dans Chrome — idéale pour les tâches rapides.
- 🧠 Grattoir à hélium : Application de bureau pour le scraping visuel, avec un prix d'achat unique et sans frais récurrents.
- 🌟 Firecrawl : Transforme n'importe quel site web en données prêtes pour LLM avec une sortie Markdown propre — conçu pour les flux de travail d'IA.
Pour la liste complète, consultez notre Alternatives à Zyte guide.
⚔️ Comparaison avec Zyte
Voici comment Zyte se compare à chacun de ses concurrents :
- Zyte contre Apify : Zyte l'emporte grâce à sa technologie anti-bannissement et ses proxys gérés. Apify, quant à lui, se distingue par ses acteurs de scraping préconfigurés et sa place de marché.
- Zyte contre ScrapeGraphAI : Zyte est entièrement géré et inclut un support technique. ScrapeGraphAI est gratuit, mais nécessite une configuration plus poussée pour les développeurs.
- Zyte contre Bright Data : Les deux proposent des outils de niveau professionnel. Bright Data dispose de plus de proxys, tandis que Zyte offre une meilleure extraction par IA.
- Zyte contre Browse AI : Zyte est plus adapté aux développeurs qui écrivent du code. Browse AI est plus performant pour les utilisateurs non techniques.
- Zyte contre ScrapingBee : Zyte offre des fonctionnalités plus avancées et l'intégration de Scrapy. ScrapingBee est plus simple pour l'extraction de données d'API basiques.
- Zyte contre Oxylabs : Les deux entreprises excellent dans la rotation des proxys. Zyte y ajoute l'extraction par IA, tandis qu'Oxylabs se concentre sur l'infrastructure des proxys.
- Zyte contre ThorData : ThorData est moins cher pour les besoins liés aux proxys uniquement. Zyte inclut des outils d'extraction de données qui vont au-delà des simples proxys.
- Zyte contre Web Scraper : Web Scraper est gratuit pour les petites tâches. Zyte gère le web scraping à grande échelle grâce à son hébergement cloud.
- Zyte contre Helium Scraper : Helium est un logiciel de bureau à coût unique. Zyte est une solution cloud qui peut gérer des millions de pages.
- Zyte contre Firecrawl : Firecrawl excelle dans la production de données compatibles avec LLM. Zyte couvre un éventail plus large de cas d'utilisation du web scraping.
Commencez à utiliser Zyte dès maintenant
Vous avez appris à utiliser toutes les principales fonctionnalités de Zyte :
- ✅ Extraction de données par IA
- ✅ Extraction de données e-commerce
- ✅ Données pour agent IA
- ✅ API Zyte
- ✅ Extraire les données des actualités et des articles
- ✅ Extraction de données sur les emplois
- ✅ Extraction de données immobilières
- ✅ Extracteur de données des réseaux sociaux
- ✅ Hébergement cloud évolutif
Étape suivante : Choisissez une fonctionnalité et essayez-la dès maintenant.
La plupart des gens commencent par le scraping par IA.
Cela prend moins de 5 minutes.
Foire aux questions
À quoi sert Zyte ?
Zyte est une plateforme de web scraping qui permet d'extraire des données de sites web à grande échelle. Elle gère les proxys, la protection anti-bannissement et l'extraction de données.
Zyte est-il gratuit à utiliser ?
Zyte offre des crédits gratuits pour les nouveaux comptes. Ensuite, le paiement se fait à la requête en fonction du niveau du site web et du type de requête.
L'API Zyte est-elle compatible avec Python ?
Oui. L'API Zyte fonctionne avec Python et s'intègre directement au framework Scrapy via la bibliothèque scrapy-zyte-api.
Comment Zyte gère-t-il les bannissements d'adresse IP ?
Zyte utilise des proxys intelligents à rotation automatique qui changent d'adresse IP. Cela permet d'éviter la détection par les systèmes anti-bots sur les sites web cibles.
Zyte peut-il extraire des données des pages contenant beaucoup de JavaScript ?
Oui. Zyte prend en charge le rendu côté navigateur, qui charge intégralement le contenu JavaScript avant d'extraire les données de la page.













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
