
Inicio rápido
Esta guía abarca todas las características de Firecrawl:
- Empezando — Crea una cuenta de Firecrawl y configura tu clave API.
- Cómo usar Scrape — Extraer datos listos para llm de páginas web individuales
- Cómo usar Crawl — Rastrea sitios web completos y sigue cada enlace.
- Cómo usar la búsqueda — Buscar en la web datos web en tiempo real
- Cómo usar el mapa — Ejecutar el descubrimiento de URL en páginas individuales
- Cómo usar el extracto — Extraer datos estructurados mediante indicaciones en lenguaje natural
Tiempo necesario: 5 minutos por función
También en esta guía: Consejos profesionales | Errores comunes | Solución de problemas | Precios | Alternativas
¿Por qué confiar en esta guía?
He utilizado Firecrawl durante más de un año y he probado todas las funciones que se describen aquí.
Este tutorial sobre cómo usar Firecrawl proviene de un trabajo práctico real de extracción de datos web.

Firecrawl es un rastreador web impulsado por inteligencia artificial que convierte los sitios web en datos limpios y listos para su uso en LLM.
Pero la mayoría de los usuarios apenas aprovechan una pequeña parte de lo que esta versátil herramienta puede hacer.
Esta guía te muestra cómo usar cada una de las funciones principales, paso a paso, con capturas de pantalla.
Tutorial de Firecrawl
Este completo tutorial de Firecrawl te guía a través de todas las funciones, desde tu primera clave API hasta las operaciones por lotes avanzadas que te convertirán en un usuario experto.
Firecrawl
Convierte cualquier sitio web en datos limpios y estructurados con una sola API. Firecrawl gestiona la renderización de JavaScript, los límites de velocidad y la detección de URL para que obtengas datos listos para LLM rápidamente. Empieza con el plan gratuito; no necesitas tarjeta de crédito.
Primeros pasos con Firecrawl
Antes de utilizar cualquier función, complete esta configuración inicial.
Tarda unos 3 minutos.
Vea primero este breve resumen:
Ahora vamos a repasar cada paso.
Paso 1: Crea tu cuenta
Visita el sitio web de Firecrawl en https://www.firecrawl.dev.
Haz clic en "Registrarse" para abrir una cuenta de Firecrawl en el plan gratuito.
Introduce tu correo electrónico y crea una contraseña.
✓ Control: Comprueba tu bandeja de entrada para recibir un correo electrónico de confirmación.
Paso 2: Instale y configure su clave API.
Ejecuta `pip install firecrawl-py` para agregar el servicio API a tu proyecto.
Copia tu clave API y luego guárdala como una variable de entorno para seguridad.
Así es como se ve el panel de control:
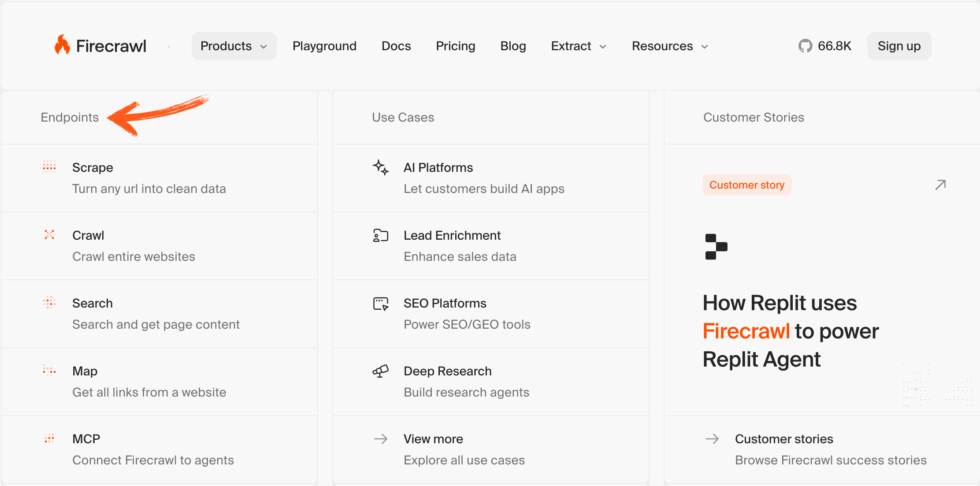
✓ Control: Deberías ver el panel principal con tu uso y clave API.
Paso 3: Haz tu primera llamada
Importa la clase FirecrawlApp y crea una instancia de firecrawl con tu clave.
Cada solicitud llega al punto final base en https://api.firecrawl.dev/v2.
✅ Hecho: Estás listo para extraer, rastrear, buscar, mapear y recopilar datos.
Cómo usar Firecrawl Scraper
Raspar Te permite extraer datos limpios y listos para LLM desde una sola página con una sola llamada a la API.
El modo de extracción se dirige a páginas individuales y es ideal para extraer detalles específicos rápidamente.
Aquí te mostramos cómo usarlo paso a paso.
Ahora vamos a desglosar cada paso.
Paso 1: Obtén tu clave API
Crea una cuenta de Firecrawl y luego copia tu clave API desde el panel de control.
Guárdala como una variable de entorno para que tu clave API no aparezca en tu código fuente.
Paso 2: Llamar al punto final de extracción de datos
Pasa una única URL al método .scrape_url() en tu instancia de firecrawl.
Puede solicitar como salida el formato Markdown, HTML sin formato o JSON estructurado.
Así es como se ve:
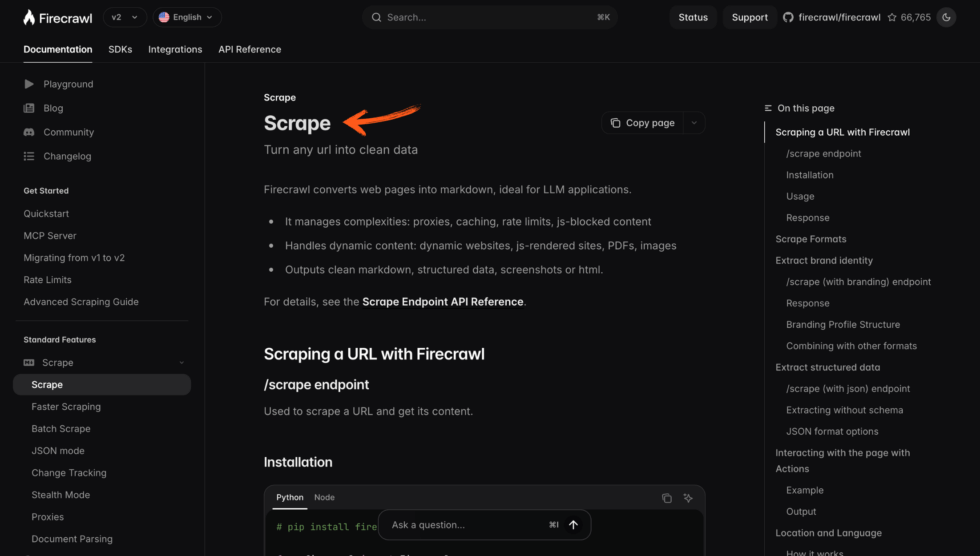
✓ Control: Deberías ver un código Markdown limpio para la página actual, listo para aplicaciones de IA.
Paso 3: Lea la salida limpia.
Firecrawl devuelve datos limpios con legibilidad texto, desprovisto de etiquetas HTML basura.
✅ Resultado: Convertiste una de las páginas web en datos web estructurados con una sola API.
💡 Consejo profesional: Establezca el parámetro max_age para almacenar en caché los resultados y omitir el rastreo de una página que no haya cambiado.
Cómo usar Firecrawl Crawler
Gatear Te permite rastrear sitios web completos y seguir enlaces automáticamente sin necesidad de un mapa del sitio.
El modo de rastreo te permite explorar sitios web a través de varias páginas y recopilar todas las páginas accesibles.
Aquí te mostramos cómo usarlo paso a paso.
Ahora vamos a desglosar cada paso.
Paso 1: Apuntar a una URL raíz
Proporcione al punto final de rastreo una URL de inicio como por ejemplo https://example.com.
Firecrawl se encarga de rastrear la web a través de enlaces y sigue las páginas por sí solo.
Paso 2: Iniciar el trabajo de rastreo
Inicie la tarea de rastreo y obtenga el ID de la tarea devuelta para realizar un seguimiento del progreso.
Utilice el ID del trabajo para consultar el estado y obtener los datos rastreados a medida que finaliza cada página.
Así es como se ve:
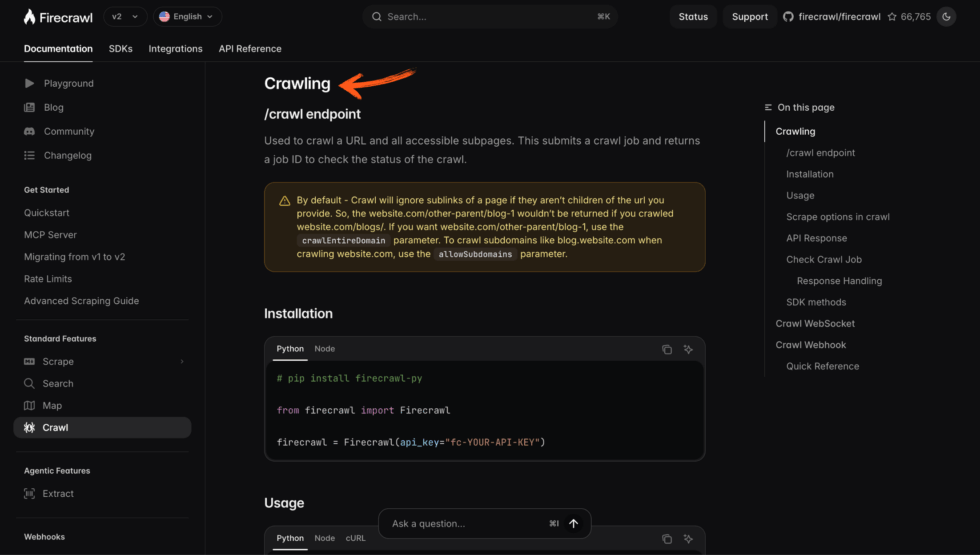
✓ Control: Deberías ver páginas extraídas de todo el sitio web que se van incorporando a los datos web.
Paso 3: Exportar los resultados
Recopile todas las páginas en formato Markdown o JSON estructurado para sus flujos de datos.
✅ Resultado: Capturaste un sitio web completo, incluso sitios web complejos con contenido dinámico.
💡 Consejo profesional: Firecrawl utiliza procesamiento por lotes y navegadores concurrentes, por lo que las operaciones de rastreo de gran tamaño se mantienen rápidas.
Cómo usar el motor de búsqueda Firecrawl
Buscar Te permite buscar en la web y obtener resultados limpios que puedes introducir directamente en agentes de IA.
La función de búsqueda te permite consultar la web y obtener datos web en tiempo real en formato de texto legible.
Aquí te mostramos cómo usarlo paso a paso.
Ahora vamos a desglosar cada paso.
Paso 1: Enviar una consulta
Llame al punto final de búsqueda con una consulta en lenguaje natural simple.
Firecrawl puede buscar en la web a través de sitios web de noticias, bolsas de trabajo y sitios de reseñas.
Paso 2: Elija el formato de salida.
Solicita el formato Markdown o JSON estructurado para cada resultado.
Todos los resultados llegan como datos limpios, no como código HTML sin procesar y con ruido.
Así es como se ve:
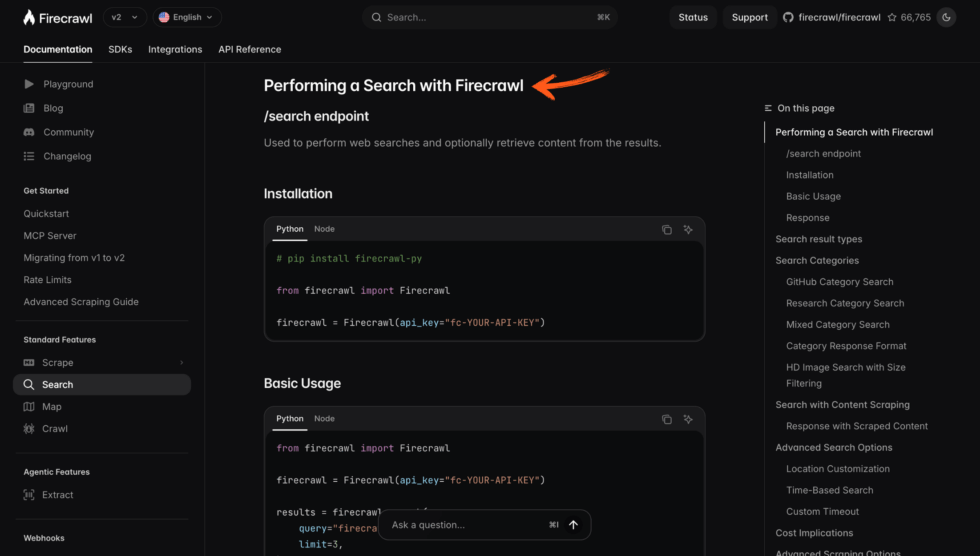
✓ Control: Deberías ver las páginas web clasificadas como datos web estructurados.
Paso 3: Intégralo en tu aplicación
Introduzca los datos estructurados en asistentes de IA o flujos de trabajo de IA.
✅ Resultado: Has añadido contenido web en directo a tus aplicaciones de IA con una sola llamada a la API.
💡 Consejo profesional: Combine la búsqueda con la extracción para recopilar artículos de noticias para estudios de mercado o inteligencia competitiva.
Cómo usar el mapa avanzado de Firecrawl
Mapa Te permite realizar un descubrimiento de URL y convertir un dominio en un mapa completo de páginas individuales.
El modo mapa recupera rápidamente todas las URL de un sitio para una búsqueda de URL más rápida.
Aquí te mostramos cómo usarlo paso a paso.
Ahora vamos a desglosar cada paso.
Paso 1: Enviar el dominio
Pase una única URL raíz al punto final del mapa.
Firecrawl devuelve todos los enlaces sin necesidad de un mapa del sitio.
Paso 2: Revisar la lista de URL
Examine las páginas individuales devueltas antes de extraer su contenido.
Guarda la lista en un archivo CSV para planificar la extracción de datos.
Así es como se ve:
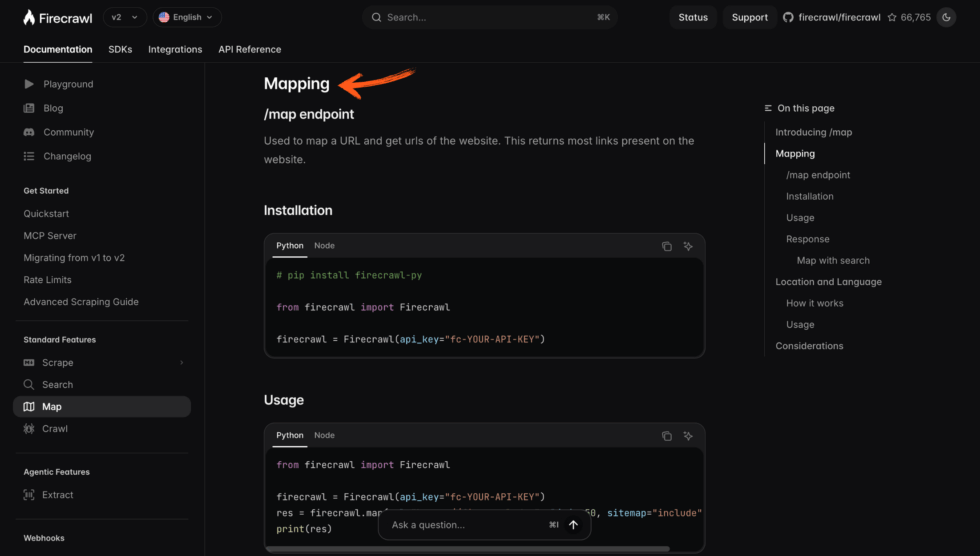
✓ Control: Deberías ver un mapa del sitio completo con todas las páginas web que aparecen en una sola URL.
Paso 3: Seleccionar qué datos extraer
Selecciona las páginas que quieras y luego envíalas para que las extraigan o las rastreen.
✅ Resultado: Has mapeado todo el sitio, preparándolo para el web scraping dirigido.
💡 Consejo profesional: En sitios web dinámicos y aplicaciones web, prioriza la visualización de mapas para evitar desperdiciar créditos en páginas que no necesitas.
Cómo usar Firecrawl Extractor
Extracto Te permite extraer datos estructurados de cualquier página mediante indicaciones en lenguaje natural.
Extract utiliza un sistema de análisis basado en inteligencia artificial para extraer exactamente los campos que usted describe.
Aquí te mostramos cómo usarlo paso a paso.
Ahora vamos a desglosar cada paso.
Paso 1: Definir un esquema
Escribe un modelo Pydantic con: from pydantic import BaseModel.
La extracción basada en esquemas le indica a Firecrawl qué campos debe devolver como JSON estructurado.
Paso 2: Describir los datos
Agregue indicaciones en lenguaje natural para los campos que un esquema no puede capturar.
Así es como se extraen datos de páginas web sin escribir reglas de análisis.
Así es como se ve:
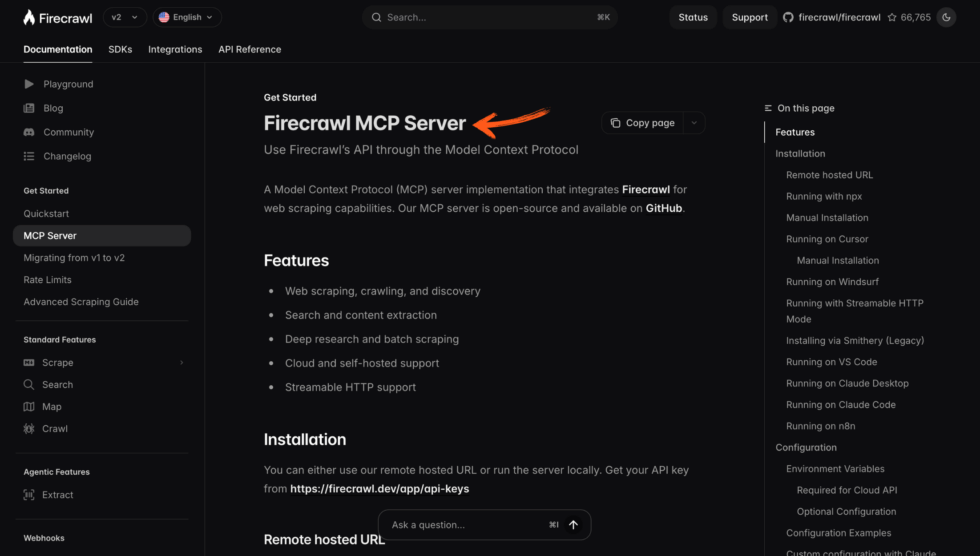
✓ Control: Deberías ver datos estructurados y ordenados en lugar de etiquetas HTML desordenadas.
Paso 3: Recibir JSON estructurado
Firecrawl devuelve un JSON estructurado y limpio, listo para ser utilizado como datos de entrenamiento.
✅ Resultado: Sustituiste los frágiles raspadores por una sola llamada de extracción y menos limpieza de datos.
💡 Consejo profesional: Utilice only_main_content, include_tags y exclude_tags para mantener los datos web extraídos centrados en el contenido principal.
Consejos y atajos profesionales para Firecrawl
Tras probar Firecrawl durante más de un año, aquí están mis mejores consejos para una extracción de datos más limpia.
Atajos de teclado
| Acción | Atajo |
|---|---|
| Corre y raspa en el patio de recreo | Ctrl + Enter |
| Copiar clave API | Ctrl + C |
| Abrir documentos | Ctrl + K |
| Cambiar formato de salida | Pestaña |
Características ocultas que la mayoría de la gente pasa por alto
- almacenamiento en caché de edad máxima: Reutilice los datos rastreados recientemente para realizar un rastreo repetido de forma más rápida y económica.
- Acciones del navegador: Haz clic, desplázate y escribe para acceder al contenido que se encuentra detrás del renderizado de JavaScript.
- Procesamiento por lotes asíncrono: Procese miles de URL mediante procesamiento por lotes sin bloquear sus aplicaciones web.
Errores comunes que debes evitar en Firecrawl
Error n.° 1: Codificar la clave API directamente en el código.
❌ Incorrecto: Pegar tu clave API directamente en el código compartido o en un repositorio público.
✅ Derecha: Carga la clave desde una variable de entorno para que permanezca privada.
Error n.° 2: Gatear antes de mapear
❌ Incorrecto: Rastrear sitios web completos a ciegas y gastar créditos en páginas basura.
✅ Derecha: Primero, realiza el descubrimiento de URL con el mapa y, a continuación, rastrea solo las páginas que necesites.
Error n.° 3: Analizar el HTML sin procesar manualmente
❌ Incorrecto: Escribir reglas rígidas para limpiar el HTML sin procesar y eliminar las etiquetas HTML manualmente.
✅ Derecha: Utilice la extracción basada en esquemas para obtener directamente un JSON estructurado y limpio.
Solución de problemas de Firecrawl
Problema: Errores 401 no autorizados
Causa: Falta tu clave API o no se ha cargado desde la variable de entorno.
Arreglar: Vuelva a exportar la clave, luego recree su instancia de firecrawl e inténtelo de nuevo.
Problema: Errores de tiempo de espera en sitios web complejos
Causa: La renderización compleja de JavaScript o el contenido dinámico tardan más en cargarse.
Arreglar: Agregue una acción de espera para que la página actual termine de cargarse antes de la captura.
Problema: Alcanzar los límites de velocidad
Causa: Demasiadas solicitudes simultáneas en el plan gratuito o en un plan de menor nivel.
Arreglar: Las operaciones por lotes son lentas o se requiere una actualización para admitir más navegadores simultáneos.
📌 Nota: Si ninguna de estas soluciones resuelve su problema, póngase en contacto con el soporte técnico de Firecrawl.
¿Qué es Firecrawl?
Firecrawl Es una herramienta de extracción de datos web basada en inteligencia artificial que convierte sitios web en datos limpios y estructurados.
Imagínelo como un rastreador web que proporciona a los agentes de IA texto legible en lugar de código HTML sin procesar y desordenado.
Firecrawl fue desarrollado por Mendable.ai para reducir el desperdicio de tokens en aplicaciones de inteligencia artificial.
Mira este breve resumen:
Incluye estas características clave:
- Raspar: Extrae datos de páginas web individuales en formato Markdown o JSON estructurado.
- Gatear: Rastrea sitios web completos y sigue enlaces sin un mapa del sitio.
- Buscar: Realiza búsquedas en la web y devuelve datos limpios de sitios web de noticias y sitios de reseñas.
- Mapa: Descubrimiento rápido de URL que convierte un dominio en un mapa del sitio completo.
- Extracto: Extraiga datos web estructurados utilizando indicaciones en lenguaje natural y esquemas de Pydantic.
Firecrawl supera al web scraping tradicional al encargarse automáticamente de los proxies, los límites de velocidad y la representación de JavaScript.
A diferencia de las herramientas tradicionales que necesitan Selenium, esta ofrece sus servicios a científicos de datos y desarrolladores a través de una única API.
Para una revisión completa, consulte nuestra Reseña de Firecrawl.
Precios de Firecrawl
Esto es lo que costará Firecrawl en 2026:
| Plan | Precio | Mejor para |
|---|---|---|
| Gratis | Gratis | Probando el rastreo y la extracción de datos en algunas páginas. |
| Pasatiempo | $16/mes | Desarrolladores independientes y pequeñas canalizaciones de datos |
| Estándar | $83/mes | Equipos que realizan tareas regulares de rastreo web |
| Crecimiento | $333/mes | Investigación y seguimiento de mercados de alto volumen |
Prueba gratuita: Sí, el plan gratuito te permite extraer información de un número limitado de páginas.
Garantía de devolución de dinero: No hay garantía formal, pero puedes optar por un plan inferior en cualquier momento.
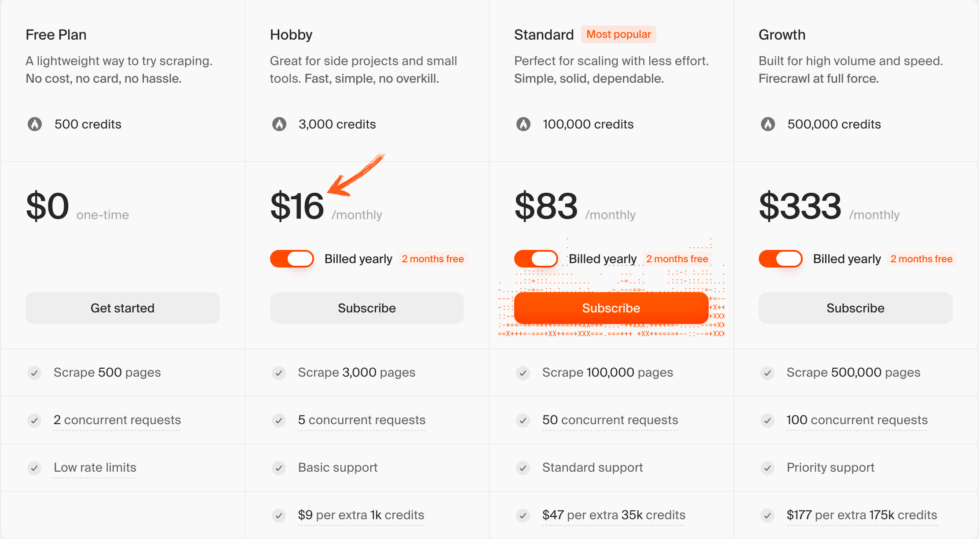
💰 Mejor relación calidad-precio: Estándar: el mejor equilibrio entre créditos y navegadores simultáneos para la mayoría de los equipos.
Firecrawl frente a alternativas
¿Cómo se compara Firecrawl? Este es el panorama competitivo:
| Herramienta | Mejor para | Precio | Clasificación |
|---|---|---|---|
| Firecrawl | Datos limpios preparados para la IA | $16/mes | ⭐ 3.5 |
| Apificar | Actores predefinidos | $49/mes | ⭐ 4.5 |
| Datos brillantes | Escala proxy | $ Personalizado | ⭐ 4.6 |
| Crawl4AI | Código abierto | Gratis | ⭐ 4.4 |
| Scrapy | Control de Python | Gratis | ⭐ 4.5 |
| ScrapeGraphAI | Extracción de gráficos LLM | $20/mes | ⭐ 4.3 |
Selecciones rápidas:
- Mejor en general: Firecrawl: datos LLM limpios y listos para usar desde una única API.
- Mejor presupuesto: Crawl4AI: software libre y de código abierto para científicos de datos que trabajan de forma práctica.
- Ideal para principiantes: Firecrawl: las indicaciones en lenguaje natural ocultan las partes difíciles.
- Lo mejor para escala de proxy: Bright Data: un enorme conjunto de servidores proxy para sitios web complejos.
🎯 Alternativas a Firecrawl
¿Buscas alternativas a Firecrawl? Aquí tienes las mejores opciones:
- 🚀 Apify: Plataforma de actores predefinidos para web scraping, ideal cuando se necesitan extractores de datos listos para usar a través de una única API.
- 🏢 Datos brillantes: Red de proxy empresarial para tareas de rastreo masivas y monitorización de contenido a gran escala en sitios web dinámicos.
- 💰 Crawl4AI: Rastreador web gratuito de código abierto que genera datos listos para LLM, ideal para flujos de trabajo de IA de bajo presupuesto y ejecuciones locales.
- 🔧 Scrapy: Marco de trabajo de Python probado en batalla que brinda a los desarrolladores control total sobre el rastreo, el análisis y las canalizaciones de datos.
- 🧠 ScrapeGraphAI: Extracción basada en grafos e impulsada por IA que mapea la estructura de la página para la extracción de datos estructurados basada en esquemas.
Para ver la lista completa, consulte nuestra Alternativas a Firecrawl guía.
⚔️ Comparación de Firecrawl
Así es como Firecrawl se compara con cada competidor:
- Firecrawl contra Apify: Firecrawl gana en cuanto a la limpieza de la salida, preinstalada en llm; Apify gana en cuanto a su biblioteca de raspadores preconstruidos.
- Firecrawl vs Bright Data: Bright Data gana en escala de datos proxy; Firecrawl gana en extracción de datos estructurados más sencillos.
- Firecrawl vs Crawl4AI: Crawl4AI gana en precio y alojamiento propio; Firecrawl gana en límites de velocidad gestionados y fiabilidad.
- Firecrawl contra Scrapy: Scrapy gana en control de bajo nivel; Firecrawl gana en velocidad y sin necesidad de configurar proxies.
- Firecrawl vs ScrapeGraphAI: Ambos funcionan con inteligencia artificial; Firecrawl gana en cobertura de rastreo, ScrapeGraphAI en lógica de grafos.
Empieza a usar Firecrawl ahora
Aprendiste a usar todas las funciones principales de Firecrawl:
- ✅ Raspar
- ✅ Gatear
- ✅ Buscar
- ✅ Mapa
- ✅ Extracto
Siguiente paso: Elige una función y pruébala ahora.
La mayoría de la gente empieza con Scrape.
Tarda menos de 5 minutos.
Preguntas frecuentes
¿Para qué se utiliza Firecrawl?
Firecrawl es una herramienta de web scraping basada en inteligencia artificial. Convierte páginas web en datos limpios y listos para su uso por agentes de IA, sistemas RAG, estudios de mercado y monitorización de precios.
¿Se puede usar Firecrawl gratis?
Sí. El plan gratuito te permite extraer datos de un número limitado de páginas con tu clave API, para que puedas probar las funciones de extracción, rastreo y obtención de datos antes de pagar.
¿Cómo instalo Firecrawl?
Ejecuta pip install firecrawl-py, luego configura tu clave API como una variable de entorno y crea una instancia de firecrawl para iniciar tu primera llamada a la API.
¿En qué se diferencia Firecrawl del raspado tradicional?
El web scraping tradicional requiere Selenium y la configuración manual de un proxy. Firecrawl gestiona automáticamente la renderización de JavaScript, los límites de velocidad y la limpieza de datos mediante un único servicio API.
¿Puede Firecrawl extraer datos estructurados?
Sí. Utilice indicaciones en lenguaje natural o un esquema Pydantic para la extracción basada en esquemas, y Firecrawl devolverá JSON estructurado en lugar de HTML sin procesar.













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
