
Démarrage rapide
Ce guide couvre toutes les fonctionnalités de Bright Data :
- Commencer — Créez votre compte et configurez la gestion des proxys
- Comment utiliser la plateforme Datasets Marketplace — Accédez instantanément aux données Web structurées et pré-collectées
- Comment utiliser l'API Web Scraper — Collecter des données Web provenant de sites populaires disposant de points d'accès prêts à l'emploi
- Comment utiliser Web Unlocker — Accédez aux pages Web bloquées grâce à l'API Web Unlocker
- Comment utiliser un réseau de proxys massif et diversifié — Le web scraping transite par des millions d'adresses IP rotatives
- Comment utiliser les proxys FAI — Bénéficiez de la vitesse d'un centre de données avec la confiance d'un véritable FAI
- Comment utiliser les proxys résidentiels — Extraire des pages sensibles via des adresses IP résidentielles légitimes
- Comment utiliser les statistiques e-commerce — Suivre les données web relatives aux produits et aux prix pour obtenir des informations sur le marché
- Comment utiliser l'API SERP — Extraire les résultats de recherche en temps réel sous forme de données structurées
- Comment utiliser l'API Crawl — Explorez des sites web entiers et alimentez vos agents IA
Temps nécessaire : 5 minutes par fonctionnalité
Vous trouverez également dans ce guide : Conseils de pro | Erreurs courantes | Dépannage | Tarification | Alternatives
Pourquoi faire confiance à ce guide ?
J'ai utilisé Bright Données J'ai testé chaque fonctionnalité pendant plus d'un an et je l'ai présentée dans ce guide de démarrage rapide. Ce tutoriel est basé sur une véritable expérience pratique de web scraping, et non sur des captures d'écran de fournisseurs.

Bright Data est l'une des plateformes de données web les plus puissantes disponibles aujourd'hui.
Mais la plupart des utilisateurs n'exploitent qu'une infime partie de ses possibilités.
Ce guide vous montre comment utiliser des données pertinentes pour chaque tâche importante.
Étape par étape, avec captures d'écran et conseils de pro.
Tutoriel Bright Data
Ce tutoriel complet sur Bright Data vous guide pas à pas à travers chaque fonctionnalité, de la configuration du compte aux conseils avancés de collecte de données pour les développeurs.
Données claires
Collectez des données web à grande échelle grâce à des proxys fiables, un navigateur dédié au scraping et des API prêtes à l'emploi. Bright Data assure une collecte de données conforme à la réglementation pour des milliers de clients. Tarification à l'usage.
Premiers pas avec Bright Data
Avant d'utiliser toute fonctionnalité, veuillez effectuer cette configuration unique.
Cela prend environ 3 minutes.
Voici les principaux avantages dont vous bénéficiez :
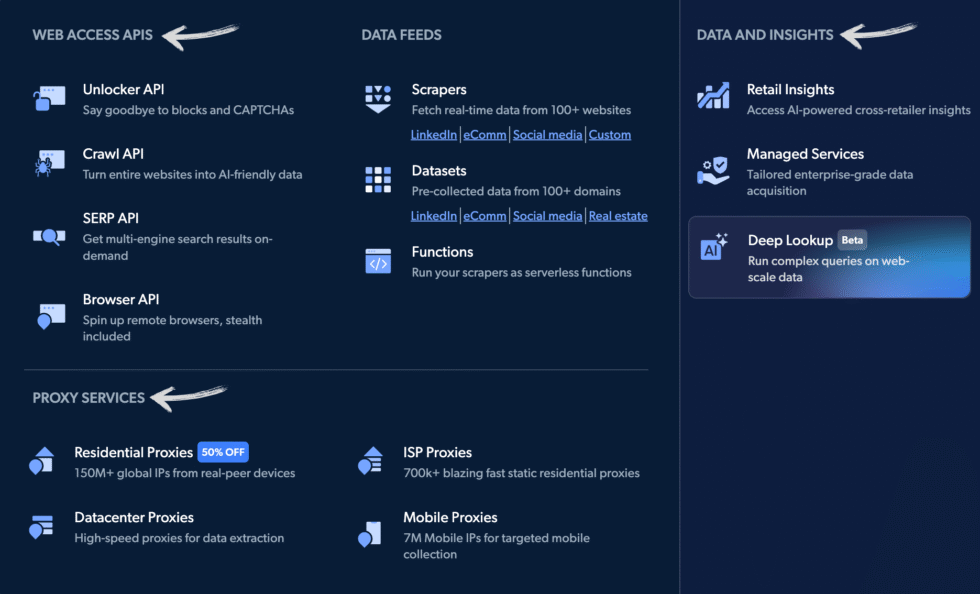
Passons maintenant en revue chaque étape.
Étape 1 : Créez votre compte
Rendez-vous sur le site web de Bright Data et cliquez sur « Démarrer l’essai gratuit ».
Saisissez votre adresse e-mail et créez un mot de passe.
Ajoutez un mode de paiement pour activer la facturation au fur et à mesure.
✓ Point de contrôle: Vérifiez votre boîte de réception pour recevoir un courriel de confirmation.
Étape 2 : Ouvrez votre tableau de bord
Une fois connecté, vous arrivez sur le tableau de bord principal.
Voici à quoi ressemble le tableau de bord :
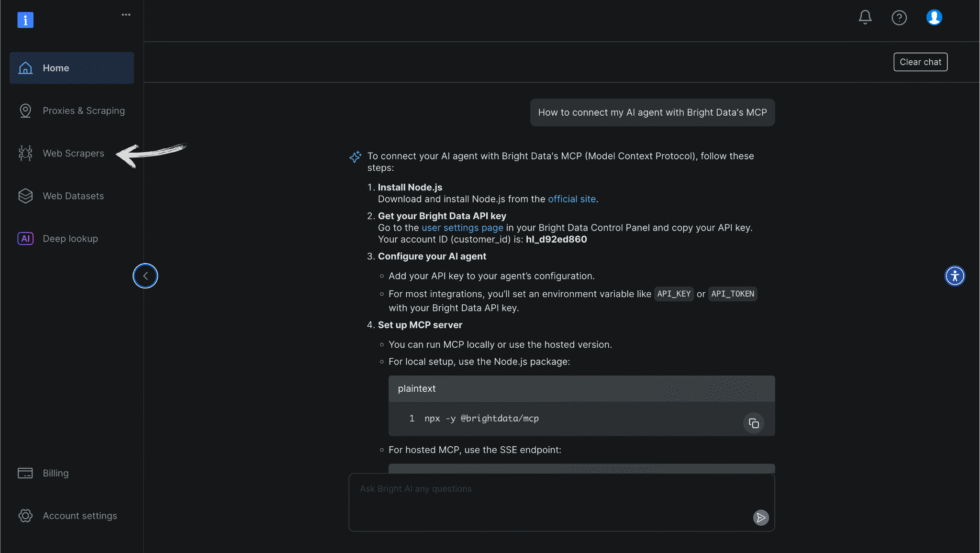
✓ Point de contrôle: Vous devriez voir les onglets « Gestion des proxys » et « Produits ».
Étape 3 : Créez votre première zone
Accédez à Ajouter une zone et donnez-lui un nom significatif.
Renseignez les détails de la zone, puis enregistrez pour terminer le processus.
Cela enregistre vos identifiants de proxy pour chaque requête.
✅ Terminé : Vous êtes prêt à utiliser n'importe quelle fonctionnalité ci-dessous.
Comment utiliser la plateforme de jeux de données Bright Data ?
Marché des ensembles de données vous permet d'exploiter des données Web structurées et pré-collectées sans exécuter un seul outil d'extraction de données.
Voici comment l'utiliser étape par étape.
Étape 1 : Ouvrez la plateforme Datasets Marketplace
Depuis le tableau de bord, cliquez sur Jeux de données et parcourir le catalogue.
Étape 2 : Choisir un ensemble de données
Filtrez par domaine, pays ou catégorie pour trouver une correspondance personnalisée.
Voici à quoi cela ressemble :
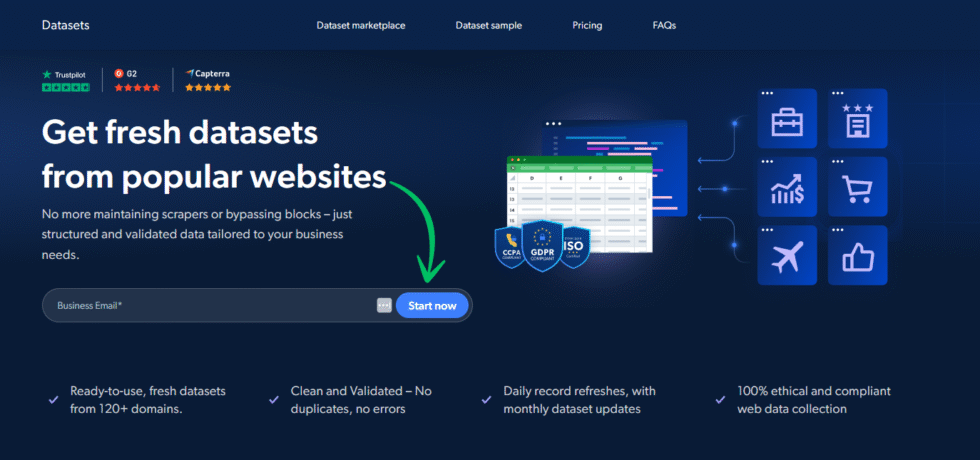
✓ Point de contrôle: Vérifiez que l'écran de la plateforme de jeux de données se charge correctement.
Étape 3 : Télécharger ou planifier
Exportez le fichier au format CSV ou JSON, ou configurez des actualisations en temps réel.
✅ Résultat : Vous disposez de données web fraîches, prêtes à l'emploi en quelques minutes.
💡 Conseil de pro : Abonnez-vous à un ensemble de données pour une livraison programmée et ainsi conserver automatiquement vos informations à jour.
Comment utiliser l'API Bright Data Web Scraper
API d'extraction de données Web permet de collecter des données Web provenant de sites populaires à l'aide de points de terminaison prêts à l'emploi et d'une logique JavaScript.
Voici comment l'utiliser étape par étape.
Étape 1 : Choisir une cible
Recherchez dans la bibliothèque de modèles le site web dont vous souhaitez extraire les données.
Étape 2 : Configurer la requête
Définissez les paramètres, puis envoyez les requêtes via le point de terminaison de l'API.
Voici à quoi cela ressemble :
✓ Point de contrôle: Vérifiez que l'écran de l'API de web scraping se charge correctement.
Étape 3 : Recevoir des données structurées
Analysez la réponse et intégrez-la à vos outils ou à votre suite décisionnelle.
✅ Résultat : Votre système de web scraping s'exécute sur une infrastructure de navigateur gérée, sans aucun serveur à maintenir.
💡 Conseil de pro : Utilisez les webhooks pour les tâches volumineuses afin que la plateforme vous envoie les données au fur et à mesure de leur exécution.
Comment utiliser Bright Data Web Unlocker
Déverrouillage Web permet d'accéder automatiquement aux pages Web bloquées tandis que la plateforme gère le blocage par robots.
Voici comment l'utiliser étape par étape.
Étape 1 : Créer une zone de déverrouillage
Dans la section Proxies et Scraping, ajoutez une nouvelle zone Web Unlocker.
Étape 2 : Envoyez votre URL
Acheminez les requêtes vers l'API Web Unlocker avec vos identifiants.
Voici à quoi cela ressemble :
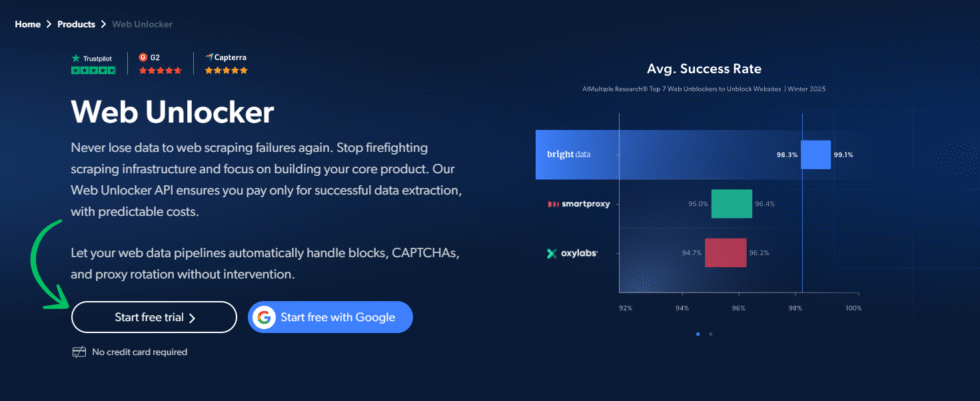
✓ Point de contrôle: Vérifiez que l'écran de déverrouillage Web se charge correctement.
Étape 3 : Obtenir du code HTML propre
L'outil renvoie des pages rendues, en contournant les CAPTCHA et les blocages.
✅ Résultat : Vous bénéficiez d'un accès web fiable à des pages qui rejettent normalement les robots.
💡 Conseil de pro : Définissez un paramètre de pays pour évaluer le contenu géolocalisé et anticiper les blocages régionaux.
Comment utiliser le réseau proxy massif et diversifié de Bright Data
Réseau de proxys massif et diversifié permet d'acheminer les requêtes à travers des millions d'adresses IP pour un web scraping résilient et à grande échelle.
Voici comment l'utiliser étape par étape.
Étape 1 : Ouvrir la gestion des proxys
Accédez au panneau de gestion des proxys dans votre tableau de bord.
Étape 2 : Sélectionnez un type de proxy
Comparer les adresses IP résidentielles, de centres de données, de FAI et mobiles selon le cas d'utilisation.
Voici à quoi cela ressemble :
✓ Point de contrôle: Vérifiez que l'écran du réseau proxy massif et diversifié se charge correctement.
Étape 3 : Connexion et test
Copiez les identifiants du proxy et effectuez un test de connexion rapide.
✅ Résultat : Votre trafic transite désormais par différentes adresses IP afin d'éviter toute détection.
💡 Conseil de pro : Adaptez le type de proxy au site cible ; les adresses IP des centres de données offrent la meilleure vitesse de connexion. sécurité.
Comment utiliser les proxys FAI de Bright Data
Proxies FAI vous permet de combiner la vitesse des adresses IP des centres de données avec la fiabilité des adresses IP des véritables fournisseurs d'accès Internet.
Voici comment l'utiliser étape par étape.
Étape 1 : Activer une zone FAI
Créez une zone proxy FAI depuis le tableau de bord.
Étape 2 : Définir le ciblage
Choisissez un pays et définissez vos domaines pour un accès personnalisé.
Voici à quoi cela ressemble :
✓ Point de contrôle: Vérifiez que l'écran des proxys FAI se charge correctement.
Étape 3 : Intégrer le proxy
Ajoutez les identifiants à votre navigateur ou script de scraping.
✅ Résultat : Vous disposez de proxys rapides et à faible consommation de bande passante, optimisés pour une collecte stable.
💡 Conseil de pro : Réservez les adresses IP des fournisseurs d'accès Internet aux comptes et aux connexions pour lesquels une identité stable est primordiale.
Comment utiliser les proxys résidentiels Bright Data
Procurations résidentielles permet d'extraire des données sensibles de pages web via de véritables adresses IP résidentielles sur de nombreux domaines.
Voici comment l'utiliser étape par étape.
Étape 1 : Créer une zone résidentielle
Ajouter une zone proxy résidentielle dans la gestion des proxys.
Étape 2 : Choisir les cibles géographiques
Sélectionnez un ciblage au niveau du pays et de la ville pour un accès conforme.
Voici à quoi cela ressemble :
✓ Point de contrôle: Vérifiez que l'écran des proxys résidentiels se charge correctement.
Étape 3 : Exécutez votre scraper
Branchez le point de terminaison dans Selenium, Puppeteer ou Playwright.
✅ Résultat : Vos requêtes ressemblent à celles de vrais utilisateurs naviguant depuis de vrais domiciles.
💡 Conseil de pro : Sur les sites difficiles, alternez les adresses IP à chaque requête afin de maintenir un taux de réussite élevé en temps réel.
Comment utiliser les données e-commerce de Bright Data
Perspectives du commerce électronique vous permet d'extraire des données Web sur les produits, les prix et les avis pour obtenir des informations sur le marché et la concurrence.
Voici comment l'utiliser étape par étape.
Étape 1 : Sélectionner un fournisseur de détail
Choisissez les domaines de commerce électronique que vous souhaitez surveiller.
Étape 2 : Définir les points de données
Sélectionnez les champs à extraire, tels que le prix, le stock et les évaluations.
Voici à quoi cela ressemble :
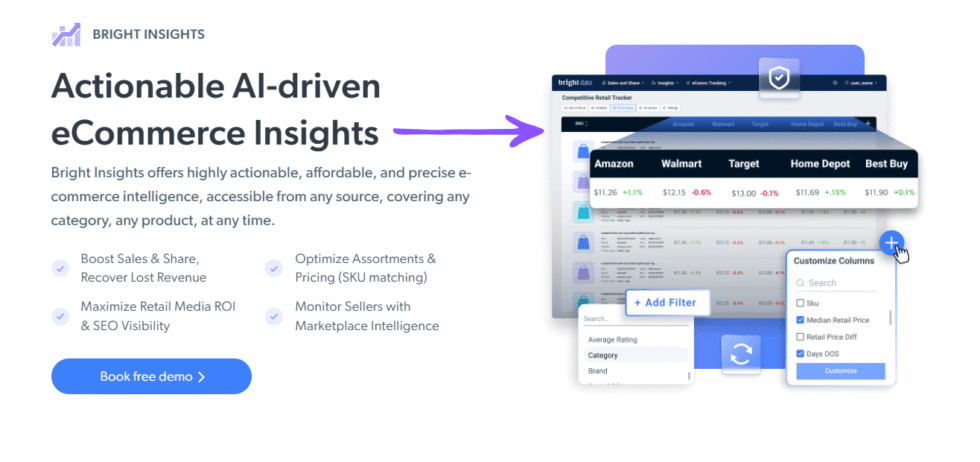
✓ Point de contrôle: Vérifiez que l'écran des statistiques e-commerce se charge correctement.
Étape 3 : Planifier la collecte
Définissez une fréquence d'actualisation pour suivre les changements au fil du temps.
✅ Résultat : Vous recevez un flux personnalisé de signaux e-commerce pour vos clients.
💡 Conseil de pro : Intégrez ces données dans vos outils de BI pour repérer les tendances tarifaires et garder une longueur d'avance sur vos concurrents.
Comment utiliser l'API SERP de Bright Data
API SERP permet de collecter à grande échelle les résultats des moteurs de recherche en temps réel sous forme de données Web structurées.
Voici comment l'utiliser étape par étape.
Étape 1 : Ouvrir la zone SERP
Créez une zone API SERP depuis votre tableau de bord.
Étape 2 : Élaborez votre requête
Définissez le mot-clé, le pays et l'appareil pour chaque requête.
Voici à quoi cela ressemble :
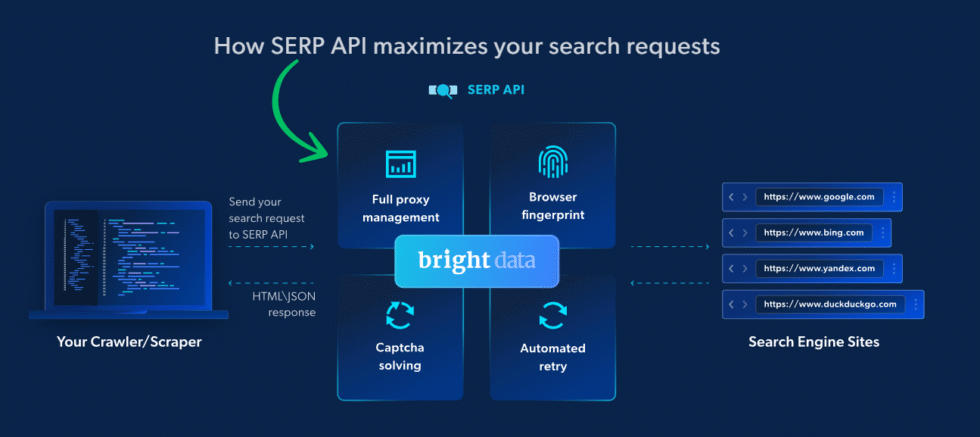
✓ Point de contrôle: Vérifiez que l'écran de l'API SERP se charge correctement.
Étape 3 : Collecter les résultats
Recevez les classements, les publicités et les extraits analysés au format JSON.
✅ Résultat : Vous disposez d'informations de recherche prêtes pour SEO et la vérification des annonces.
💡 Conseil de pro : Effectuer des requêtes en boucle par pays pour évaluer l'évolution des classements à travers le monde.
Comment utiliser l'API Bright Data Crawl
API Crawl permet d'explorer des sites web entiers et de nettoyer manuellement les données web pour vos agents IA.
Voici comment l'utiliser étape par étape.
Étape 1 : Définir une URL de départ
Saisissez la page de départ et la profondeur d'exploration.
Étape 2 : Définir les règles
Filtrez par chemin d'accès, type de fichier ou domaine pour cibler l'exploration.
Voici à quoi cela ressemble :
✓ Point de contrôle: Vérifiez que l'écran de l'API de crawl se charge correctement.
Étape 3 : Exporter les données
Téléchargez les pages indexées ou diffusez-les sur votre plateforme.
✅ Résultat : Vos agents IA reçoivent des données web à l'échelle du site pour les tâches complexes.
💡 Conseil de pro : Associez l'API Crawl au navigateur de scraping lorsque les pages nécessitent un rendu JavaScript complet.
Conseils et astuces de Bright Data Pro
Après avoir testé Bright Data pendant plus d'un an, voici mes meilleurs conseils pour les développeurs.
Victoires rapides
| But | Action |
|---|---|
| Évitez le blocage | Activer la rotation automatique de l'adresse IP |
| Des rampes plus rapides | Utilisez les requêtes asynchrones et les webhooks |
| Afficher JavaScript | Exécutez le navigateur de scraping |
| Réduire les coûts | Choisissez des adresses IP de centres de données sur des sites à sécurité légère. |
Fonctionnalités cachées que la plupart des gens ignorent
- API du navigateur : Exécutez la logique de scraping sur des navigateurs cloud gérés pour gérer des tâches complexes sans avoir besoin de votre propre infrastructure de navigateur.
- Fonctions de récupération de données : Écrivez du code JavaScript personnalisé qui s'exécute côté serveur, afin d'extraire uniquement les données web dont vous avez besoin.
- Intégrations : Le panneau de contrôle prend en charge Selenium, Puppeteer et Playwright, ce qui vous permet de réutiliser des scripts existants pour interagir avec des pages web en direct.
Erreurs courantes à éviter selon Bright Data
Erreur n° 1 : Utiliser le mauvais type de proxy
❌ Faux : Envoyer toutes les requêtes via des adresses IP résidentielles, même sur des pages simples.
✅ À droite : Évaluez d'abord le site cible, puis choisissez le type de proxy adapté à son niveau de sécurité.
Erreur n° 2 : Ignorer les limites de débit
❌ Faux : Envoi simultané de milliers de requêtes et déclenchement de blocages.
✅ À droite : Utilisez les requêtes asynchrones et les webhooks pour que les tâches volumineuses s'exécutent sans interruption.
Erreur n° 3 : Omettre le navigateur de scraping
❌ Faux : Extraction de données de pages web riches en JavaScript à l'aide de simples requêtes HTTP.
✅ À droite : Lancez le navigateur de scraping pour que le contenu dynamique s'affiche avant de l'extraire.
Dépannage des données brillantes
Problème : Les requêtes sont constamment bloquées
Cause: Le site cible détecte vos adresses IP ou votre empreinte numérique.
Réparer: Passez aux proxys résidentiels et activez l'API Web Unlocker pour cette zone.
Problème : Les pages se chargent vides
Cause: Le contenu s'affiche avec JavaScript après la réponse initiale.
Réparer: Utilisez le navigateur de scraping pour que la page entière s'affiche avant d'extraire les données.
Problème : Erreur de connexion au proxy
Cause: Vos identifiants ou paramètres de zone sont incorrects.
Réparer: Revérifiez le nom de la zone, le pays cible et les informations d'identification dans la gestion des proxys.
📌 Note: Si aucune de ces solutions ne résout votre problème, contactez le support technique de Bright Data.
Qu'est-ce que Bright Data ?
Données claires est une plateforme de données web qui vous aide à collecter à grande échelle des informations accessibles au public sur différents domaines.
Imaginez une boîte à outils composée de proxys, d'API et d'un navigateur d'extraction de données, adaptée à chaque tâche de collecte. Vous pouvez ainsi extraire des données d'une seule page ou de millions.
Elle promeut des pratiques conformes au RGPD et au CCPA.
Regardez ce bref aperçu :
Il comprend les fonctionnalités clés suivantes :
- Marché des ensembles de données : Données web pré-collectées et structurées, prêtes à être téléchargées.
- API d'extraction de données Web : Des points d'accès prêts à l'emploi pour collecter des données provenant de sites populaires.
- Déverrouillage Web : Déblocage automatique des pages web difficiles d'accès.
- Réseau de proxys massif et diversifié : Adresses IP résidentielles, FAI, centres de données et mobiles.
- Proxies FAI : La vitesse d'un centre de données associée à la confiance d'un véritable fournisseur d'accès Internet.
- Procurations résidentielles : Adresses IP résidentielles authentiques pour cibles sensibles.
- Perspectives du commerce électronique : Suivi des produits et des prix pour une meilleure compréhension du marché.
- API SERP : Résultats des moteurs de recherche en temps réel sous forme de données.
- API d'exploration : Exploration globale du site pour alimenter vos agents IA.
Pour une analyse complète, consultez notre Avis sur Bright Data.
Tarification de Bright Data
Voici le coût de Bright Data en 2026 :
La tarification est à la consommation, facturée principalement par Go ou par requête.
| Plan | Prix | Idéal pour |
|---|---|---|
| Débloqueur Web | $1.05 | Contournement automatique des blocs sur les pages uniques |
| API d'extraction de données Web | $0.79 | Points d'accès prêts à l'emploi pour les sites populaires |
| API SERP | $1.05 | collecte de données sur les résultats des moteurs de recherche |
| API du navigateur | $5.88 | Rendu complet avec le navigateur automation |
| Ensembles de données | $2.5 | Données Web structurées pré-collectées |
| Fonctions de récupération | $2.8 | logique de récupération JavaScript personnalisée |
| Procurations résidentielles | $2.94 | Sites sensibles nécessitant de véritables adresses IP |
| Proxies FAI illimités | $1.3 | Identité stable à la vitesse du centre de données |
| Proxies de centre de données illimités | $0.90 | Cibles de sécurité légères à grande vitesse |
| Proxies mobiles | $5.88 | Accès Web spécifique aux appareils mobiles |
| Perspectives brillantes | $1000 | Analyses e-commerce prêtes à l'emploi |
| Scraper personnalisé | $400 | Des solutions sur mesure créées par l'équipe de Bright Data |
Essai gratuit : Oui, des essais gratuits sont disponibles pour la plupart des produits.
Paiement à l'utilisation : Oui, sans plan d'engagement pour une mise à l'échelle flexible.
💰 Meilleur rapport qualité-prix : API Web Scraper à 0,79 $ — la solution la plus économique pour accéder aux données Web structurées.
Données claires contre les alternatives
Comment se positionne Bright Data par rapport à la concurrence ? Voici un aperçu du paysage concurrentiel :
| Outil | Idéal pour | Prix | Notation |
|---|---|---|---|
| Données claires | Échelle et variété de propriété intellectuelle | à partir de 0,90 $/Go | ⭐ 4,5 |
| Oxylabs | proxys à l'échelle de l'entreprise | à partir de 4 $/Go | ⭐ 4,5 |
| Smartproxy | petites équipes abordables | à partir de 3,5 $/Go | ⭐ 4,4 |
| Zyte | Extraction automatique | à partir de 0,40 $/req | ⭐ 4,3 |
| ScrapingBee | API de scraping simple | à partir de 49 $/mois | ⭐ 4,4 |
Sélection rapide :
- Meilleur résultat global : Bright Data — le plus vaste choix d'adresses IP et de fonctionnalités
- Meilleur budget : Smartproxy — des tarifs avantageux pour les petites équipes
- Idéal pour les débutants : ScrapingBee — configuration simple de l'API de scraping
- Idéal pour l'extraction automatique : Zyte — analyseur syntaxique intelligent pour les développeurs
🎯 Alternatives aux données brillantes
Vous cherchez des alternatives à Bright Data ? Voici les meilleures options :
- 🚀 Oxylabs : Un concurrent sérieux disposant d'un vaste réseau de mandataires résidentiels et d'une qualité professionnelle. outils de web scraping pour les charges de travail importantes de collecte de données.
- 💰 Smartproxy : Un fournisseur de proxy économique avec un tableau de bord plus simple, idéal pour les petites équipes qui débutent des projets de web scraping.
- 🧠 Zyte : Une plateforme destinée aux développeurs, dotée d'une extraction automatique intelligente et d'une analyse syntaxique pilotée par l'IA pour les données web structurées.
- 👶 ScrapingBee : Une API de scraping conviviale pour les débutants, compatible avec les navigateurs sans interface graphique et le rendu avec une configuration minimale.
Pour la liste complète, consultez notre Alternatives à Bright Data guide.
⚔️ Comparaison des données Bright
Voici comment Bright Data se compare à chacun de ses concurrents :
- Bright Data contre Oxylabs : Oxylabs égale Bright Data en termes d'échelle, mais le navigateur et le catalogue de jeux de données de Bright Data lui confèrent un ensemble de fonctionnalités plus large.
- Bright Data contre Smartproxy : Smartproxy l'emporte sur le prix et la facilité d'utilisation, tandis que Bright Data se distingue par son volume d'adresses IP brutes et ses fonctionnalités avancées de déblocage.
- Bright Data contre Zyte : Zyte est leader en matière d'extraction automatique, mais Bright Data offre davantage de types de proxys et une couverture géographique plus étendue.
- Bright Data contre ScrapingBee : ScrapingBee est plus facile à utiliser pour les petits travaux, tandis que Bright Data est plus adapté aux tâches complexes et offre une réelle valeur ajoutée à grande échelle.
Commencez à utiliser Bright Data dès maintenant
Vous avez appris à utiliser des données pertinentes pour chaque fonctionnalité majeure :
- ✅ Place de marché des ensembles de données
- ✅ API de web scraping
- ✅ Déverrouillage Web
- ✅ Réseau de proxys massif et diversifié
- ✅ Proxies FAI
- ✅ Procurations résidentielles
- ✅ Perspectives e-commerce
- ✅ API SERP
- ✅ API d'exploration
Étape suivante : Choisissez une fonctionnalité et essayez-la dès maintenant.
La plupart des gens commencent par la plateforme Datasets Marketplace.
Cela prend moins de 5 minutes et vous met sur la voie d'une réelle création de valeur.
Foire aux questions
Bright Data est-il digne de confiance ?
Oui. Bright Data est une plateforme de données web leader du secteur, à laquelle font confiance des milliers d'entreprises, et dont les pratiques sont conformes aux réglementations RGPD et CCPA.
À quoi sert Bright Data ?
Bright Data est utilisé pour l'extraction de données web et la collecte de données sur différents domaines, alimentant les études de marché, le référencement, les analyses e-commerce, la vérification des publicités et les données web pour les agents d'IA.
Combien coûte Bright Data ?
La tarification est à la consommation. Les proxys commencent à environ 0,90 $ par Go, l'API Web Scraper à 0,79 $, et les services gérés comme Bright Insights sont plus chers.
Comment utiliser le proxy Bright Data ?
Créez une zone proxy dans votre tableau de bord, choisissez un type de proxy, donnez-lui un nom significatif, copiez les identifiants, puis ajoutez-les à votre scraper ou à votre navigateur.
Quel navigateur est le meilleur pour le scraping ?
Le navigateur de web scraping de Bright Data est conçu pour le web scraping. Il fonctionne sur une infrastructure de navigateur cloud et est compatible avec Selenium, Puppeteer et Playwright pour les tâches complexes.













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
