
Inicio rápido
Esta guía cubre todas las funciones de Zyte:
- Empezando — Crea tu cuenta y completa la configuración inicial.
- Cómo utilizar la extracción de datos mediante IA — Extrae datos estructurados de cualquier página web sin escribir código personalizado.
- Cómo utilizar la extracción de datos de comercio electrónico — Recopilar datos de productos de tiendas online a gran escala
- Cómo utilizar los datos para un agente de IA — Suministrar conjuntos de datos limpios a los modelos de IA y a los científicos de datos.
- Cómo usar la API de Zyte — Agregue web scraping a su código a través de un punto central.
- Cómo utilizar la función Extraer datos de noticias y artículos — Extrae el texto completo de artículos de noticias y entradas de blog.
- Cómo utilizar la extracción de datos de trabajos — Recopilar ofertas de empleo con información sobre salario, puesto y sector de la empresa.
- Cómo utilizar la extracción de datos inmobiliarios — Extraer listados de propiedades con detalles de precios y ubicación.
- Cómo usar un extractor de datos de redes sociales — Recopilar publicaciones públicas en redes sociales y datos de perfil.
- Cómo utilizar el alojamiento en la nube escalable — Ejecutar trabajos de web scraping en una infraestructura de nube con escalado automático
Tiempo necesario: 5 minutos por función
También en esta guía: Consejos profesionales | Errores comunes | Solución de problemas | Precios | Alternativas
¿Por qué confiar en esta guía?
He usado Zyte durante más de seis meses y he probado todas las funciones que se describen aquí. Este tutorial se basa en mi experiencia práctica real, no en publicidad engañosa ni en capturas de pantalla de proveedores.

Zyte es uno de los más poderosos herramientas de extracción de datos web Disponible hoy.
Pero la mayoría de los usuarios solo aprovechan una pequeña parte de lo que puede hacer.
Esta guía le muestra cómo utilizar todas las funciones principales.
Paso a paso, con capturas de pantalla y consejos profesionales.
Tutorial de Zyte
Este completo tutorial de Zyte te guía paso a paso por todas las funciones, desde la configuración inicial hasta consejos avanzados que te convertirán en un usuario experto.
Zyte
Convierta cualquier sitio web en estructurado datos En cuestión de minutos. Zyte se encarga de la protección antibaneo, la rotación de proxies y la renderización del navegador para que los desarrolladores puedan centrarse en encontrar los datos correctos. Comienza tu prueba gratuita hoy mismo.
Primeros pasos con Zyte
Antes de utilizar cualquier función, complete esta configuración inicial.
Tarda unos 3 minutos.
Paso 1: Crea tu cuenta
Visita el sitio web de Zyte y haz clic en "Registrarse".
Introduce tu correo electrónico y crea una contraseña para iniciar sesión.
✓ Control: Comprueba tu bandeja de entrada para recibir un correo electrónico de confirmación.
Paso 2: Acceda al panel de control
Zyte es una plataforma web; no requiere descarga.
Inicia sesión con tu nueva cuenta y abre el panel de control.
Así es como se ve el panel de control:
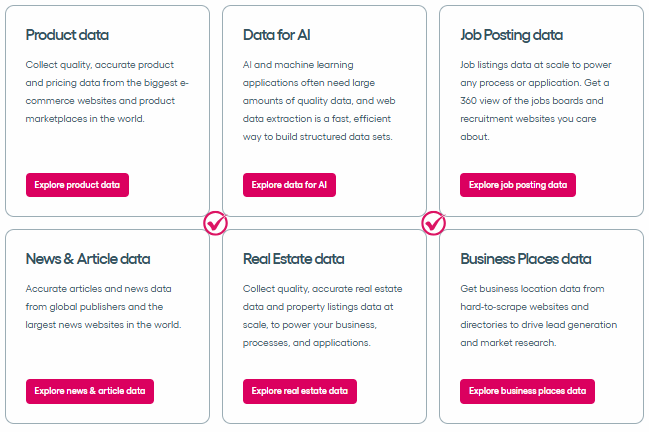
✓ Control: Deberías ver el panel principal con varias herramientas listadas.
Paso 3: Obtén tu clave API
Acceda a la configuración de su cuenta y copie su clave API.
Por ejemplo, puedes pegar esta clave en tu script de Python o en cualquier cliente HTTP.
✅ Hecho: Estás listo para usar cualquiera de las funciones a continuación.
Cómo usar el web scraping de Zyte AI
Extracción de datos mediante IA Te permite extraer datos de cualquier sitio web objetivo mediante un análisis basado en inteligencia artificial que gestiona la complejidad automáticamente.
Aquí te mostramos cómo usarlo paso a paso.
Paso 1: Abra la herramienta de extracción de datos de IA.
Inicia sesión en tu panel de control de Zyte y selecciona Extracción de datos mediante IA.
El programa de extracción de datos mediante IA lee el contenido HTML y lo convierte en datos estructurados.
Paso 2: Introduce tu URL de destino
Pega la URL de la página que deseas extraer.
Así es como se ve:
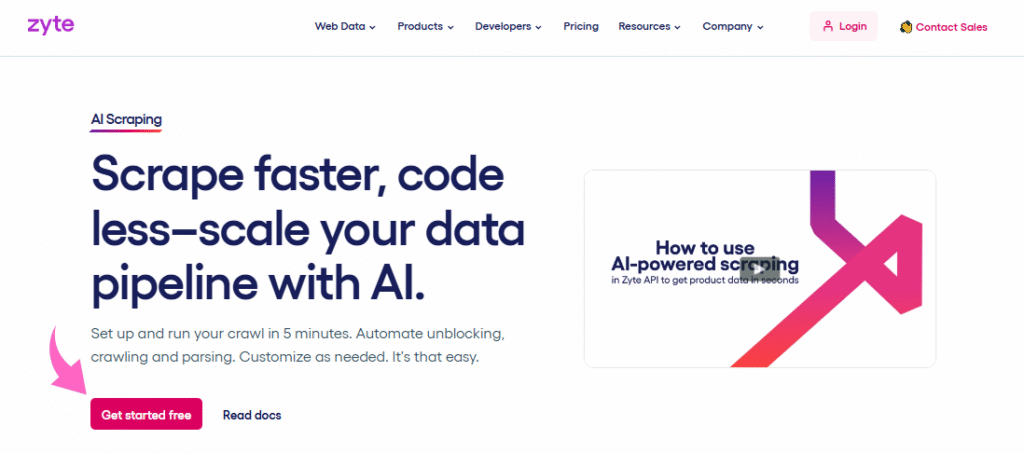
✓ Control: Deberías ver una vista previa de los campos extraídos en formato JSON.
Paso 3: Revisar y descargar los resultados.
Comprueba la respuesta JSON extraída y exporta el archivo.
✅ Resultado: Has extraído con precisión los datos de tu sitio web objetivo y ahora puedes crear cualquier proyecto de web scraping.
💡 Consejo profesional: Empiece con una sola página para realizar pruebas antes de implementarlas a gran escala en todo el sitio web.
Cómo utilizar la extracción de datos de comercio electrónico de Zyte
Extracción de datos de comercio electrónico Te permite recopilar datos de productos de sitios de comercio electrónico, incluyendo precio, título y detalles de la categoría.
Aquí te mostramos cómo usarlo paso a paso.
Paso 1: Seleccione Extracción de comercio electrónico
Abre el panel de control y selecciona la herramienta de extracción de datos de comercio electrónico.
Esta herramienta está diseñada para gestionar las páginas de productos de los principales sitios web de compras.
Paso 2: Configurar los campos del producto
Seleccione la información específica que necesita: precio, título o categoría.
Así es como se ve:
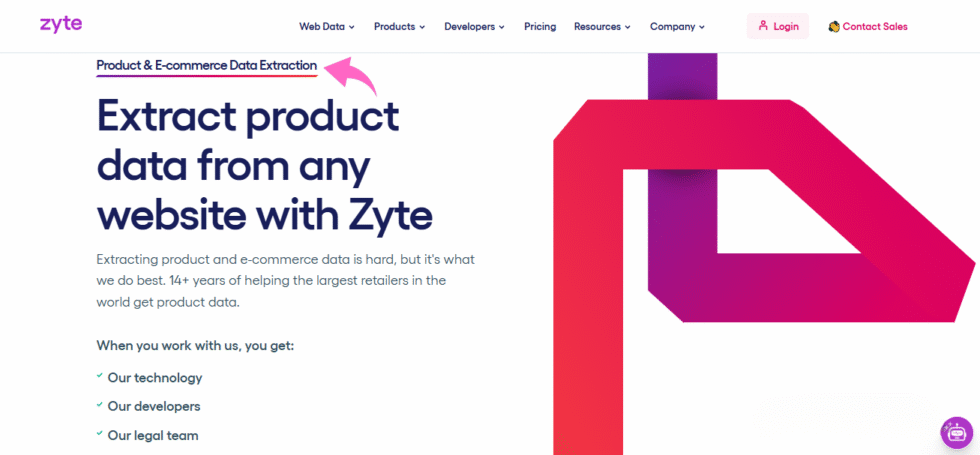
✓ Control: Deberías ver listados de productos con columnas de precio y título.
Paso 3: Ejecutar y exportar
Haz clic en "Extraer" para iniciar el proceso y descargar los resultados en formato JSON o CSV.
✅ Resultado: Ahora dispone de datos estructurados de productos procedentes de sus sitios de comercio electrónico objetivo.
💡 Consejo profesional: Utilice parámetros de geolocalización en sus solicitudes para comparar precios específicos de cada región.
Cómo usar el agente de IA de Zyte
Datos para el agente de IA Te permite alimentar directamente con datos web limpios a modelos de IA y científicos de datos para su entrenamiento o análisis.
Aquí te mostramos cómo usarlo paso a paso.
Paso 1: Elija una canalización de datos
Seleccione la opción Datos para el agente de IA en el menú principal.
Esto conecta la salida de tu API de web scraping con flujos de trabajo preparados para la IA.
Paso 2: Defina el alcance de sus datos
Define el alcance de los datos de los sitios web que necesitas recopilar.
Así es como se ve:
✓ Control: Su canalización muestra un estado de conexión con flujo de datos.
Paso 3: Exportar a su herramienta de IA
Envía los datos estructurados a tu plataforma de IA preferida.
✅ Resultado: Estás introduciendo datos web directamente en tus flujos de trabajo de IA.
💡 Consejo profesional: Programe tareas de extracción recurrentes para que sus modelos de IA siempre se entrenen con datos nuevos.
Cómo usar la API de Zyte
API de Zyte Te permite integrar el web scraping en tu propio código utilizando un único punto de entrada API con protección antibaneo.
Aquí te mostramos cómo usarlo paso a paso.
Paso 1: Obtén tu clave API
Regístrate o inicia sesión y, a continuación, copia tu clave API de Zyte desde el panel de control.
Esta clave es el punto de entrada para cada solicitud de API que realice.
Paso 2: Envía tu primera solicitud
Utilice Python o cualquier biblioteca HTTP para enviar una solicitud al punto final de la API.
Así es como se ve:
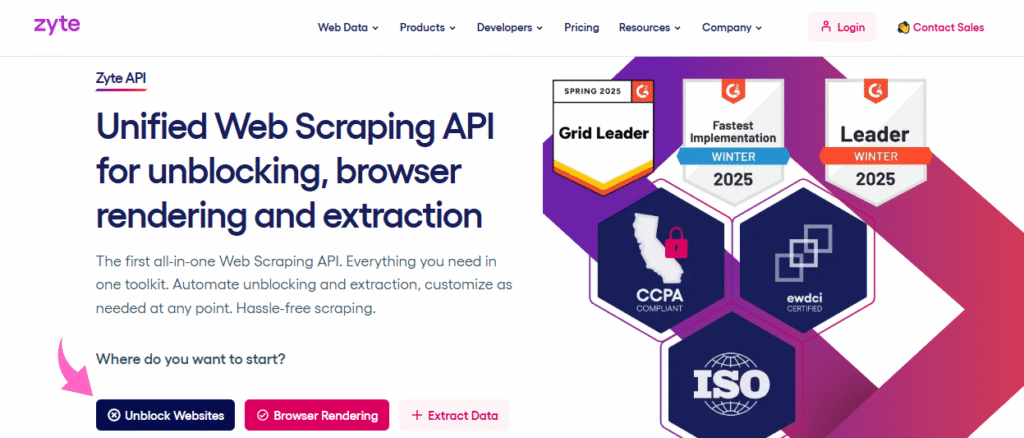
✓ Control: Tu script devuelve un estado 200 con el HTML o JSON de la página.
Paso 3: Analizar la respuesta
La API devuelve contenido HTML o JSON estructurado según la configuración; compruebe si hay errores en cada objeto de respuesta.
✅ Resultado: Ahora puedes extraer datos de sitios web mediante programación con tu propio código.
💡 Consejo profesional: Para el rastreo a gran escala, combine la API de Zyte con el framework Scrapy y las bibliotecas scrapy-zyte-api.
Cómo usar Zyte Extract Noticias y datos de artículos
Extraer datos de noticias y artículos te permite extraer artículos de noticias y contenido de blogs de forma automática texto y extracción de datos.
Aquí te mostramos cómo usarlo paso a paso.
Paso 1: Abra el extractor de noticias.
Navegue hasta Extraer datos de noticias y artículos en el menú.
Esta herramienta está optimizada para analizar artículos de noticias procedentes de sitios web de medios de comunicación.
Paso 2: Agregar URL de origen
Pega las URL de las páginas o fuentes de noticias que deseas extraer.
Así es como se ve:
✓ Control: En los resultados se muestran los títulos de los artículos, las fechas y fragmentos de texto.
Paso 3: Descargar los datos del artículo
Ejecuta la extracción y exporta los resultados con título, fecha y texto completo.
✅ Resultado: Dispones de artículos de noticias estructurados, listos para su análisis o archivo.
💡 Consejo profesional: Utilice filtros de categoría al realizar búsquedas en grandes sitios web de noticias.
Cómo usar Zyte Job Scraping Data
Extracción de datos de trabajos Te permite recopilar ofertas de empleo de sitios web de empleo con campos estructurados como puesto, empresa y salario.
Aquí te mostramos cómo usarlo paso a paso.
Paso 1: Seleccionar el trabajo de extracción de datos
Abra la función de extracción de datos de trabajos desde el panel de herramientas.
Este programa de extracción de datos gestiona automáticamente los diseños más comunes de las bolsas de trabajo.
Paso 2: Define tus criterios de búsqueda
Ingrese el puesto de trabajo, la ubicación o la categoría a la que desea dirigirse.
Así es como se ve:
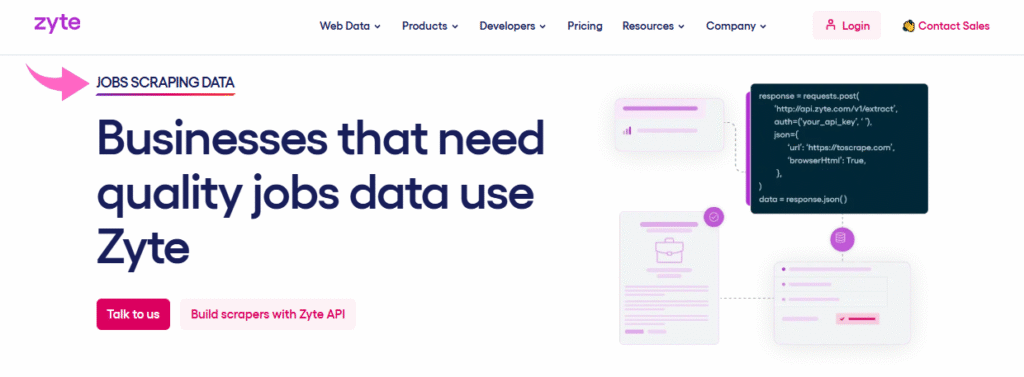
✓ Control: Aparece una tabla con las ofertas de empleo y todos los campos solicitados.
Paso 3: Exportar las ofertas de empleo
Descargue los datos como un archivo csv o json para su revisión.
✅ Resultado: Dispones de datos limpios sobre ofertas de empleo para realizar estudios de mercado o seguimiento.
💡 Consejo profesional: Programe revisiones semanales para monitorear las nuevas ofertas de empleo y las tendencias salariales a lo largo del tiempo.
Cómo utilizar la extracción de datos inmobiliarios de Zyte
Bienes raíces Extracción de datos Te permite extraer listados de propiedades de sitios web inmobiliarios con campos de precio, ubicación y detalles.
Aquí te mostramos cómo usarlo paso a paso.
Paso 1: Abrir la extracción de bienes raíces
Seleccione Extracción de datos inmobiliarios en el panel de control.
Este módulo analiza las páginas de listados de propiedades en los principales sitios web inmobiliarios.
Paso 2: Configurar los campos de propiedad
Seleccione los datos que necesita: precio, dirección o superficie en metros cuadrados.
Así es como se ve:
✓ Control: Los listados de propiedades muestran columnas con precio y ubicación.
Paso 3: Exportar listados
Descargue los resultados en el formato que prefiera para su análisis.
✅ Resultado: Dispones de datos inmobiliarios estructurados para el análisis de inversiones.
💡 Consejo profesional: Utilice servidores proxy con segmentación geográfica para acceder a listados de propiedades restringidos por región.
Cómo usar el extractor de datos de redes sociales Zyte
Extractor de datos de redes sociales Te permite recopilar datos públicos de redes sociales, incluyendo publicaciones, perfiles y métricas de interacción.
Aquí te mostramos cómo usarlo paso a paso.
Paso 1: Elige el extractor de datos de redes sociales
Seleccione la herramienta de extracción de datos de redes sociales en el menú.
Esto gestiona los perfiles públicos y las páginas de publicaciones en todas las plataformas.
Paso 2: Introduce las URL de tu perfil o hashtag.
Pega las URL de las páginas públicas o temas que deseas extraer.
Así es como se ve:
✓ Control: Las publicaciones en redes sociales aparecen con columnas de texto e interacción.
Paso 3: Revisar y descargar los datos.
Verifique el resultado y expórtelo como un archivo JSON o CSV.
✅ Resultado: Ahora dispone de datos sociales públicos listos para el análisis de tendencias o reportando.
💡 Consejo profesional: Respeta los límites de uso y los términos del sitio para que tu programa de extracción de datos funcione correctamente.
Cómo usar el alojamiento en la nube escalable de Zyte
Alojamiento en la nube escalable Te permite ejecutar tus tareas de extracción de datos web en una infraestructura en la nube que se adapta a tus necesidades de datos web.
Aquí te mostramos cómo usarlo paso a paso.
Paso 1: Acceda a la configuración de alojamiento en la nube.
Abra la sección de Alojamiento en la Nube Escalable en su cuenta.
Aquí es donde se administran los recursos del servidor para las tareas de extracción.
Paso 2: Implementa tu trabajo de web scraping
Sube tu araña web o script y selecciona tu nivel de recursos.
Así es como se ve:
✓ Control: El panel de control de tu trabajo muestra los rastreadores activos con estadísticas de uso de recursos.
Paso 3: Monitorear y escalar
Supervise el progreso de los proyectos y ajuste los recursos a medida que aumenten sus necesidades de datos.
✅ Resultado: El proceso de extracción de datos web se ejecuta en una infraestructura de nube gestionada a cualquier escala.
💡 Consejo profesional: Empiece con un plan más pequeño y auméntelo solo después de comprender el volumen real de solicitudes.
Consejos y atajos de Zyte Pro
Tras probar Zyte durante más de seis meses, aquí están mis mejores consejos.
Atajos de teclado
| Acción | Atajo |
|---|---|
| Corre araña | Ctrl + R |
| Detener el trabajo activo | Ctrl + Shift + S |
| Abra la consola del IDE Zyte | Ctrl + ` |
| Buscar archivos del proyecto | Ctrl + P |
Características ocultas que la mayoría de la gente pasa por alto
- Entorno de desarrollo integrado (IDE) Zyte: Escribe, prueba y depura scripts de navegador directamente en un entorno basado en navegador sin necesidad de cambiar a un editor local.
- Extracción automática: El extractor impulsado por IA devuelve datos JSON estructurados sin necesidad de escribir código de análisis y se adapta cuando los sitios web cambian de diseño.
- Chatea con nosotros en ZyteBot: Utiliza el chat integrado en la aplicación con ZyteBot para obtener respuestas instantáneas sobre la configuración, errores o preguntas sobre las mejores prácticas.
Errores comunes que debes evitar con Zyte
Error n.° 1: Ignorar la configuración de rotación del proxy.
❌ Incorrecto: El envío de todas las solicitudes desde una única dirección IP provoca el bloqueo de dicha dirección en el sitio web de destino.
✅ Derecha: Habilita los proxies rotativos inteligentes para que Zyte cambie automáticamente de IP y evite ser detectado.
Error n.º 2: Rastrear sin comprobar el archivo robots.txt
❌ Incorrecto: El rastreo de páginas que el propietario del sitio ha bloqueado es una tarea que consume mucho tiempo y puede ocasionar problemas legales.
✅ Derecha: Siempre revise las directrices de robots.txt e identifique las rutas restringidas antes de comenzar a practicar el web scraping de forma responsable.
Error n.° 3: No gestionar los errores en tu script.
❌ Incorrecto: Permitir que tu programa de extracción de datos falle silenciosamente cuando una página web devuelva una respuesta 403 o de tiempo de espera agotado.
✅ Derecha: Agrega manejo de errores a tu código para registrar errores HTTP y reintentar automáticamente las solicitudes fallidas.
Solución de problemas de Zyte
Problema: Las solicitudes devuelven contenido HTML vacío.
Causa: El sitio web de destino utiliza JavaScript para cargar el contenido de forma dinámica.
Arreglar: Habilita la representación del navegador en tu solicitud a la API de Zyte para que la página se cargue completamente antes de la extracción.
Problema: El programa de extracción de datos se bloquea después de algunas solicitudes.
Causa: El sitio detecta solicitudes repetidas desde la misma IP o agente de usuario.
Arreglar: Active la rotación inteligente de proxies y añada encabezados personalizados a sus solicitudes para evitar la detección por parte de los sistemas antibot.
Problema: Los datos extraídos tienen campos faltantes o dañados.
Causa: El sitio web de destino cambió su diseño, lo que provocó que su analizador sintáctico dejara de funcionar.
Arreglar: Cambia a Extracción Automática para que la IA se adapte a los cambios de diseño sin necesidad de actualizar manualmente tu código.
📌 Nota: Si ninguna de estas soluciones resuelve su problema, póngase en contacto con el soporte técnico de Zyte o utilice el chat disponible las 24 horas del día, los 7 días de la semana, para obtener ayuda.
¿Qué es Zyte?
Zyte Es una plataforma de web scraping que ayuda a desarrolladores y científicos de datos a extraer información de sitios web sin tener que lidiar manualmente con bloqueos de IP, proxies o medidas antibot.
Piénsalo como un punto central para todas tus necesidades de datos web: una plataforma con múltiples herramientas para cada tarea de extracción de datos.
Mira este breve resumen:
Incluye estas características clave:
- Raspado de IA: Utilice la IA para extraer datos estructurados de cualquier página web sin necesidad de código de análisis personalizado.
- Extracción de datos de comercio electrónico: Recopilar datos de productos de tiendas online a gran escala.
- Datos para el agente de IA: Introduzca conjuntos de datos limpios y estructurados directamente en los modelos de IA.
- API de Zyte: Integra el web scraping en tu propio código con protección antibaneo incorporada.
- Extraer datos de noticias y artículos: Obtén artículos de noticias con texto completo y metadatos.
- Extracción de datos de trabajos: Recopila ofertas de empleo estructuradas de sitios web de empleo.
- Extracción de datos inmobiliarios: Extrae información de listados de propiedades que contengan campos de precio y ubicación.
- Extractor de datos de redes sociales: Recopilar publicaciones públicas y datos de perfil para su análisis.
- Alojamiento en la nube escalable: Ejecuta las tareas de extracción de datos en una infraestructura de escalado automático.
Para una revisión completa, consulte nuestra Reseña de Zyte.
Zyte resulta ideal para cualquier equipo que necesite recopilar páginas web a gran escala sin tener que gestionar proxies ni escribir analizadores personalizados desde cero.
Precios de Zyte
Esto es lo que costará Zyte en 2026:
Zyte utiliza un modelo de precios de pago por solicitud basado en niveles de complejidad del sitio web.
Respuesta HTTP extraída: precio por cada 1000 solicitudes
| Nivel de sitio web | Pagar según se usa | Plan de $100 | Plan de $500 |
|---|---|---|---|
| Nivel 1 | $0.40 | $0.30 | $0.19 |
| Nivel 2 | $0.50 | $0.37 | $0.24 |
| Nivel 3 | $0.70 | $0.52 | $0.33 |
| Nivel 4 | $0.97 | $0.72 | $0.46 |
| Nivel 5 | $1.53 | $1.15 | $0.73 |
Solicitudes de navegador extraídas: precio por cada 1000 solicitudes
| Nivel de sitio web | Pagar según se usa | Plan de $100 | Plan de $500 |
|---|---|---|---|
| Nivel 1 | $1.80 | $1.35 | $0.85 |
| Nivel 2 | $2.80 | $2.10 | $1.33 |
| Nivel 3 | $4.80 | $3.59 | $2.27 |
| Nivel 4 | $8.79 | $6.59 | $4.17 |
| Nivel 5 | $16.78 | $12.58 | $7.96 |
Prueba gratuita: Sí, las nuevas cuentas obtienen créditos gratuitos para probar la plataforma.
Garantía de devolución de dinero: No, los créditos no son reembolsables una vez utilizados.
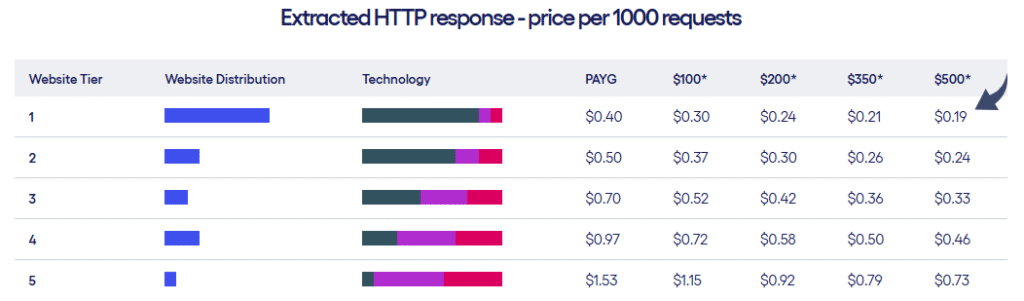
💰 Mejor relación calidad-precio: Plan de $500 en el Nivel 1: obtendrá el precio más bajo por solicitud, a $0.19 para HTTP y $0.85 para extracción del navegador.
Zyte frente a alternativas
¿Cómo se compara Zyte? Este es el panorama competitivo:
| Herramienta | Mejor para | Precio | Clasificación |
|---|---|---|---|
| Zyte | Extracción de datos web completa | $0.19+/1K requerido | ⭐ 4.5 |
| Apificar | Actores de extracción predefinidos | $49/mes | ⭐ 4.6 |
| ScrapeGraphAI | Extracción de datos gráficos mediante IA | Código libre/abierto | ⭐ 4.3 |
| Datos brillantes | Redes proxy empresariales | Más de 500 dólares al mes | ⭐ 4.5 |
| Explorar IA | Extracción de datos web sin código | $49/mes | ⭐ 4.4 |
| Abeja raspadora | Extracción de datos de API sencilla | $49/mes | ⭐ 4.4 |
| Oxylabs | Poderes de residencia | $99/mes | ⭐ 4.5 |
| Datos de Thor | Rotación de los representantes presupuestarios | $15/mes | ⭐ 4.2 |
| Raspador web | Extracción de datos de extensiones de navegador | Gratis/50 $/mes | ⭐ 4.3 |
| Raspador de helio | Extracción visual de datos de escritorio | $99 por única vez | ⭐ 4.1 |
| Firecrawl | Extracción de datos preparada para LLM | $19/mes | ⭐ 4.4 |
Selecciones rápidas:
- Mejor en general: Zyte lo gestiona todo, desde la administración de proxies hasta la extracción de datos mediante IA, en una sola plataforma.
- Mejor presupuesto: ScrapeGraphAI: código abierto y gratuito para desarrolladores que deseen tener control total.
- Ideal para principiantes: Browse AI: una interfaz sin código que facilita el acceso al web scraping.
- Ideal para empresas: Bright Data: una enorme red de servidores proxy diseñada para operaciones a gran escala.
🎯 Alternativas a Zyte
¿Buscas alternativas a Zyte? Aquí tienes las mejores opciones:
- 🚀 Apify: Ofrece cientos de actores predefinidos para tareas comunes de extracción de datos, con un generoso plan gratuito para proyectos pequeños.
- 💰 ScrapeGraphAI: Librería de extracción de datos mediante IA de código abierto para desarrolladores de Python que prefieren tener el control total sin pagar cuotas de suscripción.
- 🏢 Datos brillantes: Red proxy de nivel empresarial con más de 72 millones de direcciones IP y una plataforma completa de recopilación de datos.
- 👶 Explorar la IA: Un programa sin código que permite a cualquier persona extraer datos web simplemente apuntando y haciendo clic; no se requiere programación.
- ⚡ Abeja raspadora: API sencilla que gestiona proxies y navegadores sin interfaz gráfica para que puedas extraer datos con una sola solicitud HTTP.
- 🔒 Oxylabs: Proxies residenciales y de centros de datos premium combinados con una API de web scraping para la recopilación de datos a gran escala.
- 🔥 ThorData: Servicio de proxy económico con una rotación sólida y buena cobertura para equipos sensibles al precio.
- 🔧 Raspador web: Extensión gratuita para navegador que te permite crear extractores de datos visualmente dentro de Chrome; ideal para trabajos rápidos.
- 🧠 Raspador de helio: Aplicación de escritorio para la extracción visual de datos con un precio de compra único y sin cuotas recurrentes.
- 🌟 Firecrawl: Convierte cualquier sitio web en datos listos para LLM con una salida Markdown limpia, diseñado para flujos de trabajo de IA.
Para ver la lista completa, consulte nuestra Alternativas a Zyte guía.
⚔️ Comparación de Zyte
Así es como Zyte se compara con cada competidor:
- Zyte vs Apify: Zyte gana gracias a su tecnología antibaneo y sus proxies gestionados. Apify gana gracias a sus actores de web scraping preconfigurados y su mercado.
- Zyte vs ScrapeGraphAI: Zyte es un servicio totalmente gestionado con soporte técnico. ScrapeGraphAI es gratuito, pero requiere una configuración más compleja por parte del desarrollador.
- Zyte vs Bright Data: Ambas ofrecen herramientas de nivel empresarial. Bright Data tiene más proxies, mientras que Zyte ofrece una mejor extracción mediante IA.
- Zyte vs. Browse AI: Zyte es mejor para desarrolladores que escriben código. Descubre los logros de la IA para usuarios no técnicos.
- Zyte vs ScrapingBee: Zyte ofrece funciones más avanzadas e integración con Scrapy. ScrapingBee es más sencillo para el web scraping básico de API.
- Zyte vs Oxylabs: Ambas destacan en la rotación de servidores proxy. Zyte añade extracción mediante IA, mientras que Oxylabs se centra en la infraestructura de proxy.
- Zyte vs ThorData: ThorData es más económico para necesidades que solo requieren proxies. Zyte incluye herramientas de extracción que van más allá de los proxies.
- Zyte vs. Web Scraper: Web Scraper es gratuito para tareas pequeñas. Zyte se encarga del web scraping a gran escala con alojamiento en la nube.
- Zyte vs. Helium Scraper: Helium es una herramienta de escritorio con un coste único. Zyte está basada en la nube y admite millones de páginas.
- Zyte contra Firecrawl: Firecrawl destaca por su salida lista para LLM. Zyte abarca un abanico más amplio de casos de uso de web scraping.
Empieza a usar Zyte ahora
Aprendiste a usar todas las funciones principales de Zyte:
- ✅ Extracción de datos mediante IA
- ✅ Extracción de datos de comercio electrónico
- ✅ Datos para el agente de IA
- ✅ API de Zyte
- ✅ Extraer datos de noticias y artículos
- ✅ Extracción de datos de trabajos
- ✅ Extracción de datos inmobiliarios
- ✅ Extractor de datos de redes sociales
- ✅ Alojamiento en la nube escalable
Siguiente paso: Elige una función y pruébala ahora.
La mayoría de la gente empieza con el web scraping mediante IA.
Tarda menos de 5 minutos.
Preguntas frecuentes
¿Para qué se utiliza Zyte?
Zyte es una plataforma de web scraping que permite extraer datos de sitios web a gran escala. Gestiona proxies, protección antibaneo y extracción de datos.
¿Zyte es de uso gratuito?
Zyte ofrece créditos gratuitos para cuentas nuevas. Después, se paga por cada solicitud según el nivel del sitio web y el tipo de solicitud.
¿La API de Zyte funciona con Python?
Sí. La API de Zyte funciona con Python y se integra directamente con el framework Scrapy a través de la biblioteca scrapy-zyte-api.
¿Cómo gestiona Zyte los bloqueos de IP?
Zyte utiliza proxies rotativos inteligentes que cambian de dirección IP automáticamente. Esto evita que los sistemas antibots lo detecten en los sitios web objetivo.
¿Puede Zyte extraer información de páginas con mucho JavaScript?
Sí. Zyte admite la renderización del navegador, que carga el contenido JavaScript por completo antes de extraer los datos de la página.













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
