
Inicio rápido
Esta guía abarca todas las funciones de ScrapeGraphAI:
- Empezando — Crea una cuenta y añade tu clave API.
- Cómo usar Smart Scraper — Extrae datos estructurados de cualquier página mediante una sencilla instrucción en lenguaje natural.
- Cómo usar Search Scraper — Recopila datos web directamente de los resultados de búsqueda en tiempo real sin tener que abrir cada enlace manualmente.
- Cómo usar Markdownify — transformar el contenido web en Markdown limpio que los modelos de IA puedan leer sin ruido adicional.
- Cómo usar el agente Spidy — Rastrea varias páginas como un extractor de múltiples páginas para proyectos de extracción más grandes.
- Cómo utilizar la extracción universal de datos — gestionar numerosas tareas de extracción de datos en datos de productos, artículos de noticias y más
- Cómo usar integraciones sencillas — Conecta los datos extraídos a tus modelos de ciencia de datos y aprendizaje automático en minutos.
- Cómo usar Smart Agentic Scraper — leer contenido dinámico en sitios con mucho JavaScript que rompen los raspadores tradicionales
- Cómo usar el programador de tareas — Ejecutar operaciones de raspado de forma programada para que la extracción de datos se repita automáticamente.
- Cómo usar una interfaz sencilla — Utilice ScrapeGraphAI de forma eficaz desde un panel de control sin código y sin necesidad de conocimientos técnicos avanzados.
Tiempo necesario: 5 minutos por función
También en esta guía: Consejos profesionales | Errores comunes | Solución de problemas | Precios | Alternativas
¿Por qué confiar en esta guía?
He utilizado ScrapeGraphAI y he probado personalmente todas las funciones de este tutorial sobre cómo usar ScrapeGraphAI.
Este tutorial sobre cómo usar ScrapeGraphAI proviene de proyectos reales de extracción de datos, no de capturas de pantalla de proveedores.

ScrapeGraphAI es una herramienta impulsada por IA que transforma la web desordenada. datos en datos estructurados rápidamente.
Utiliza modelos de lenguaje complejos para leer las páginas como lo haría una persona.
Este método inteligente de extracción de datos web le ayuda a simplificar la extracción de datos web en diversas tareas.
A continuación, explico paso a paso cada una de las características clave, con capturas de pantalla y consejos profesionales.
Tutorial de ScrapeGraphAI
Este tutorial sobre cómo usar ScrapeGraph AI te guía a través de todo el proceso de extracción de datos, desde la configuración hasta la extracción avanzada de datos.
ScrapeGraph IA
Convierte cualquier sitio web en datos estructurados y limpios mediante comandos en lenguaje natural. ScrapeGraphAI combina modelos de lenguaje complejos con lógica gráfica directa para extraer datos rápidamente. Empieza gratis, sin necesidad de tarjeta de crédito.
Primeros pasos con ScrapeGraphAI
Antes de utilizar cualquier función, complete este proceso de configuración inicial.
Vea primero este breve resumen:
Ahora vamos a repasar cada paso.
Paso 1: Crea tu cuenta y tu clave API.
Regístrate en el panel de control de ScrapeGraphAI y abre la pestaña de claves.
Copia tu clave API de ScrapeGraphAI, ya que cada solicitud requiere esa clave API.
✓ Control: Tu panel de control muestra una clave API activa.
Paso 2: Instalar ScrapeGraphAI
Crea un entorno virtual limpio y, a continuación, instala ScrapeGraphAI con pip.
En tu script añade importar sistema operativo y importar cliente para cargar la clave API de forma segura.
Así es como se ve el panel de control:
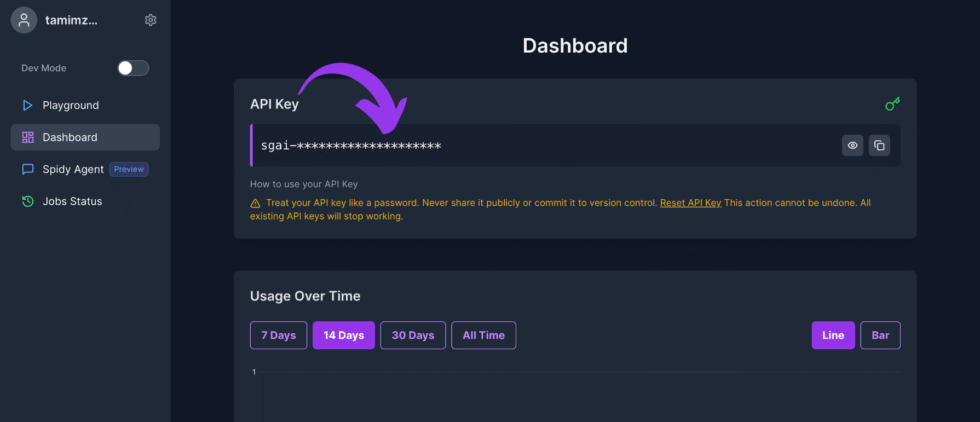
✓ Control: La biblioteca se importa sin errores.
Paso 3: Elige tu modelo de lenguaje
Para tu primera ejecución, elige un modelo de lenguaje como GPT-4o.
ScrapeGraphAI admite varios proveedores de modelos LLM, por lo que puedes cambiar de modelo de IA en cualquier momento.
✅ Hecho: Ahora puedes usar ScrapeGraphAI para cualquiera de las siguientes funciones.
Cómo usar el raspador inteligente ScrapeGraphAI
Raspador inteligente Te permite extraer datos estructurados de cualquier página mediante una sencilla instrucción en lenguaje natural.
Aquí te explicamos cómo usarlo paso a paso.
Paso 1: Abra el extractor de páginas individuales.
Seleccione el extractor de páginas individuales y pegue una URL de destino.
Paso 2: Escribe una consigna en lenguaje natural
Describe los campos que deseas extraer de la página web.
Así es como se ve:
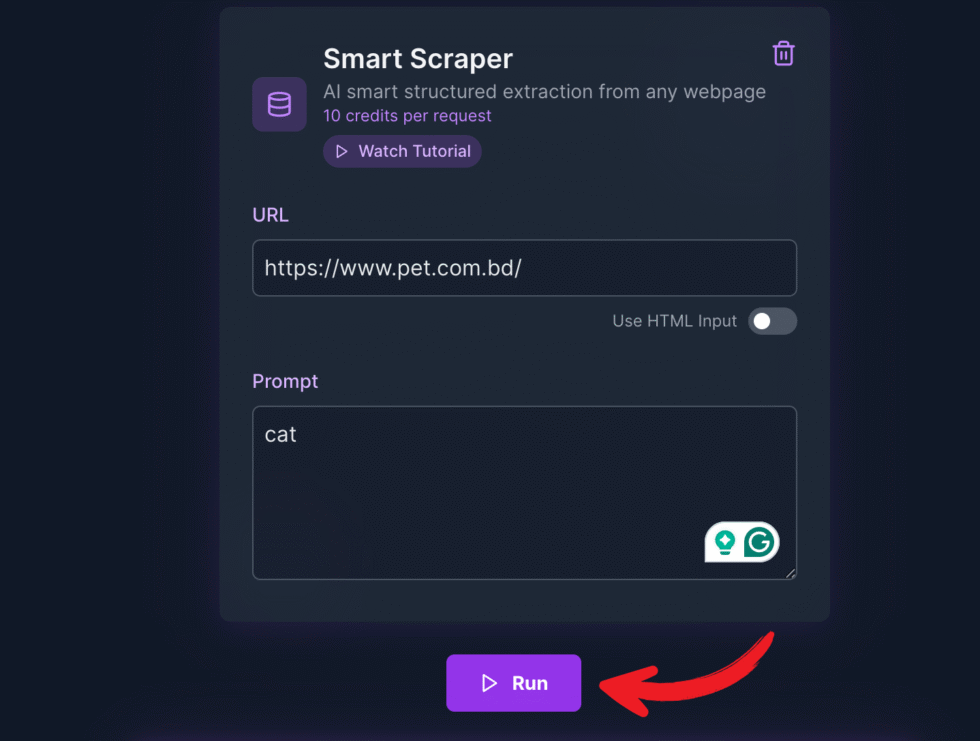
✓ Control: El resultado coincide con los campos que solicitaste.
Paso 3: Ejecutar y leer el JSON
Ejecútalo y lee datos JSON limpios en un formato estructurado.
✅ Resultado: Extrajiste datos estructurados de una página en segundos.
💡 Consejo profesional: Escriba una solicitud detallada con las claves JSON exactas que necesita para una extracción más precisa.
Cómo usar el extractor de búsqueda ScrapeGraphAI
Rastreador de búsqueda Te permite recopilar datos web directamente de los resultados de búsqueda en tiempo real sin tener que abrir cada enlace manualmente.
Aquí te explicamos cómo usarlo paso a paso.
Paso 1: Introduzca su consulta
Escribe una consulta y deja que muestre los resultados de búsqueda en tiempo real.
Paso 2: Definir qué se va a recolectar
Indícale qué datos web debe extraer de cada resultado.
Así es como se ve:
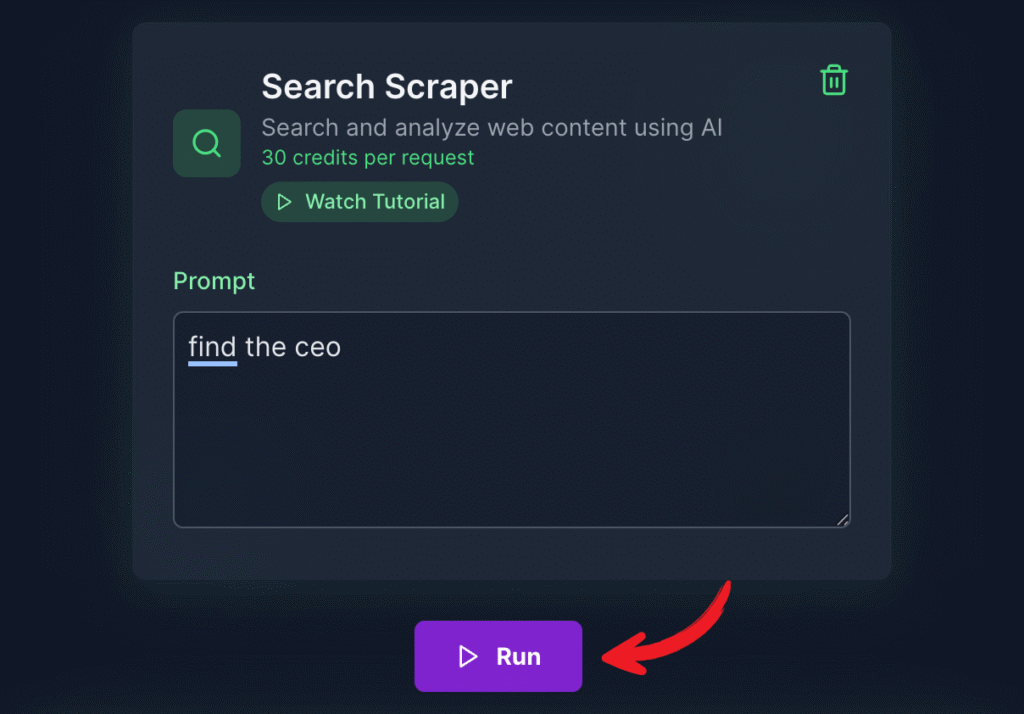
✓ Control: El resultado coincide con los campos que solicitaste.
Paso 3: Exportar el resultado
Obtenga datos relevantes en formato JSON listo para usar.
✅ Resultado: Convertiste los resultados de búsqueda en datos web útiles.
💡 Consejo profesional: Primero, limita tu consulta para que los resultados sean concisos y claros.
Cómo usar ScrapeGraphAI Markdownify
Markdownify Te permite transformar el contenido web en formato Markdown limpio que los modelos de IA pueden leer sin ruido adicional.
Aquí te explicamos cómo usarlo paso a paso.
Paso 1: Pegue la URL de la página.
Inserta cualquier URL con una estructura HTML compleja.
Paso 2: Convertir a Markdown
Markdownify transformará el contenido web en formato Markdown limpio.
Así es como se ve:
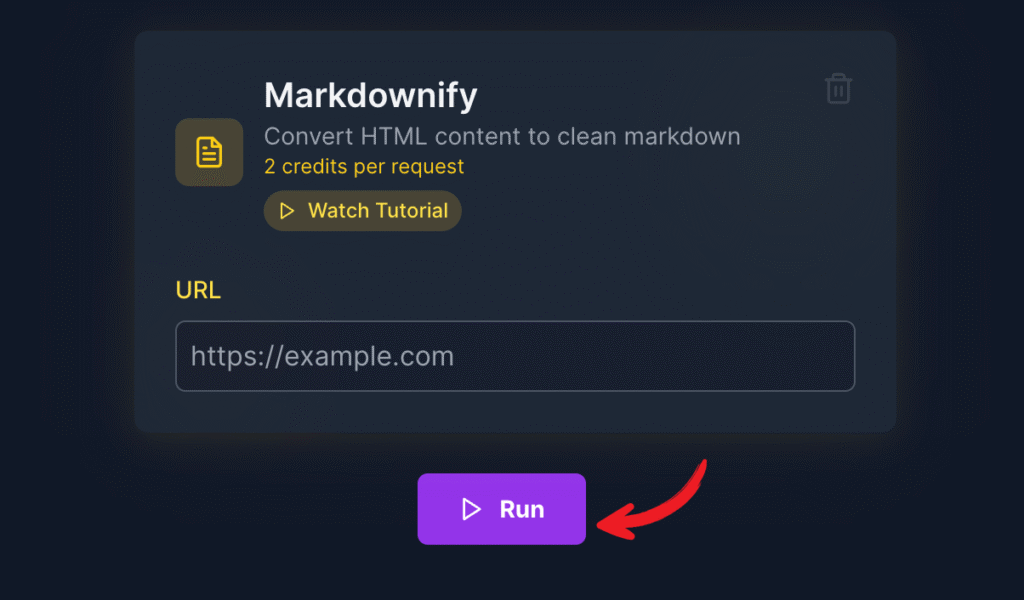
✓ Control: El resultado coincide con los campos que solicitaste.
Paso 3: Reutilizar los datos limpios
Introduce los datos limpios en tu modelo o notas.
✅ Resultado: Convertiste una página en un modelo limpio y listo para usar. texto.
💡 Consejo profesional: La salida en formato Markdown funciona de maravilla como entrada para cualquier resumen impulsado por IA.
Cómo usar el agente Spidy de ScrapeGraphAI
Agente Spidy Te permite rastrear varias páginas como un extractor de datos multipágina para proyectos de extracción de datos más grandes.
Aquí te explicamos cómo usarlo paso a paso.
Paso 1: Añade tu página de inicio
Dale a Spidy Agent un enlace de inicio para el desplazamiento.
Paso 2: Ajustar la profundidad de arrastre
Elige si deseas extraer información de unas pocas páginas o de muchas páginas.
Así es como se ve:
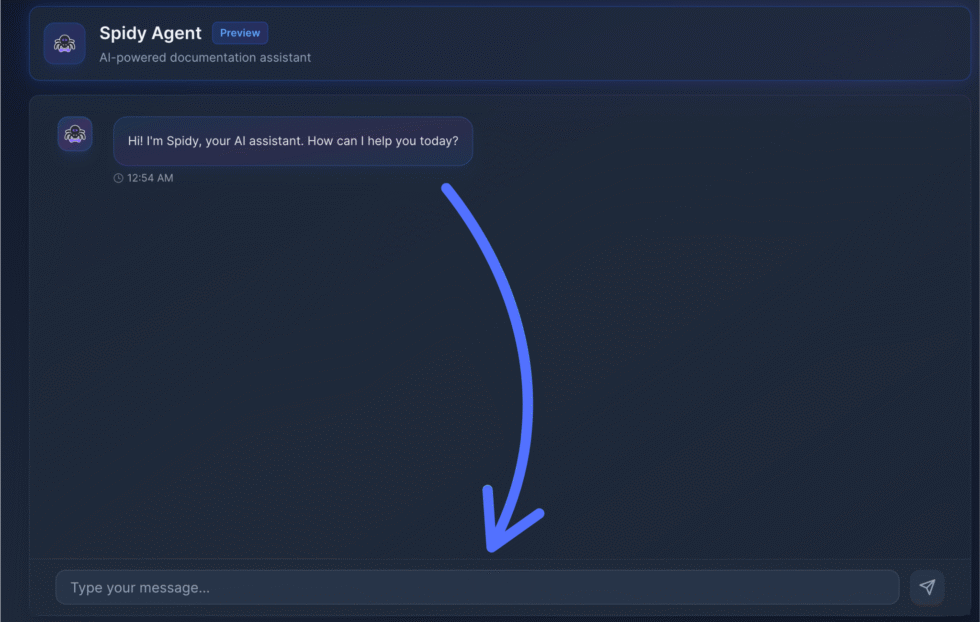
✓ Control: El resultado coincide con los campos que solicitaste.
Paso 3: Recolectar a escala
Deja que este programa de extracción de datos de múltiples páginas se encargue de trabajos de extracción a gran escala.
✅ Resultado: Has rastreado varias páginas en una sola ejecución.
💡 Consejo profesional: Comience con unas pocas páginas para realizar pruebas antes de cualquier extracción de datos a gran escala.
Cómo usar ScrapeGraphAI Universal Data Extraction
Extracción universal de datos Te permite gestionar numerosas tareas de extracción de datos en datos de productos, artículos de noticias y mucho más.
Aquí te explicamos cómo usarlo paso a paso.
Paso 1: Elige tu fuente
Apúntalo a los datos del producto, artículos de noticias o cualquier página web.
Paso 2: Definir el esquema
Establezca el formato estructurado que desea que sigan los datos extraídos.
Así es como se ve:
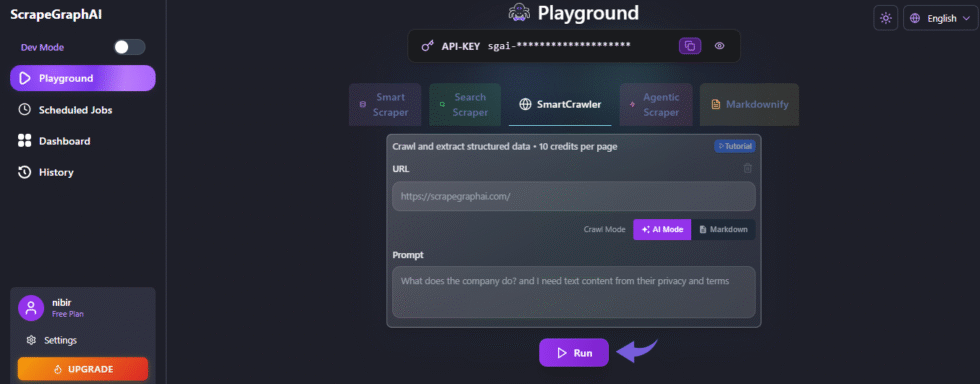
✓ Control: El resultado coincide con los campos que solicitaste.
Paso 3: Extraer los datos
Ejecute las tareas de extracción de datos y revise los resultados.
✅ Resultado: Gestionaste simultáneamente diversas tareas de extracción de datos.
💡 Consejo profesional: Defina un esquema Pydantic para bloquear la estructura de cada registro.
Cómo usar las integraciones sencillas de ScrapeGraphAI
Integraciones sencillas Te permite conectar los datos extraídos a tus modelos de ciencia de datos y aprendizaje automático en cuestión de minutos.
Aquí te explicamos cómo usarlo paso a paso.
Paso 1: Abra la API
Conéctate a través de la API para tus scripts y aplicaciones.
Paso 2: Enviar datos al flujo descendente
Dirige los datos extraídos a tus flujos de datos.
Así es como se ve:
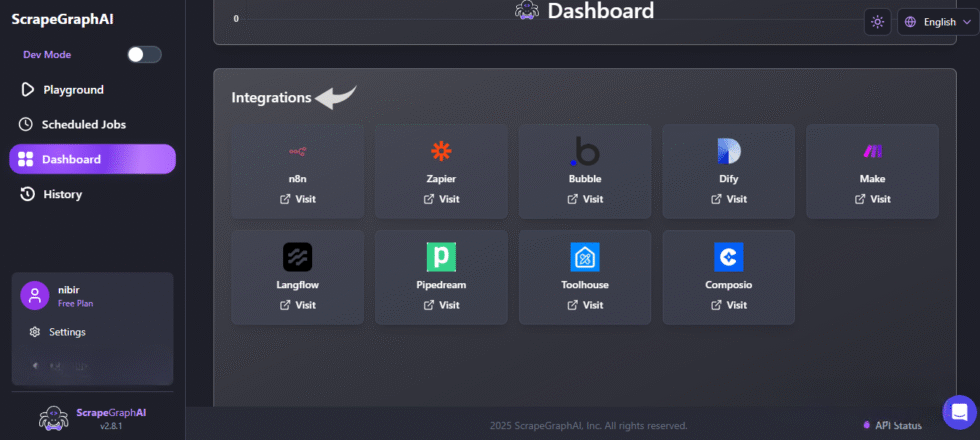
✓ Control: El resultado coincide con los campos que solicitaste.
Paso 3: Alimenta a tus modelos
Entregue los datos a los modelos de aprendizaje automático y a los agentes de IA.
✅ Resultado: Los datos extraídos ahora fluyen hacia tu pila.
💡 Consejo profesional: Conéctalo a Make.com o n8n para ampliar sus flujos de datos.
Cómo usar el raspador inteligente de agentes ScrapeGraphAI
Rastreador agenico inteligente te permite leer contenido dinámico en sitios con mucho JavaScript que rompen con lo tradicional. raspadores.
Aquí te explicamos cómo usarlo paso a paso.
Paso 1: Cargar un sitio complicado
Pega un sitio web con mucho JavaScript que oculte su contenido.
Paso 2: Deje que el agente renderice
El agente carga el contenido dinámico antes de leerlo.
Así es como se ve:
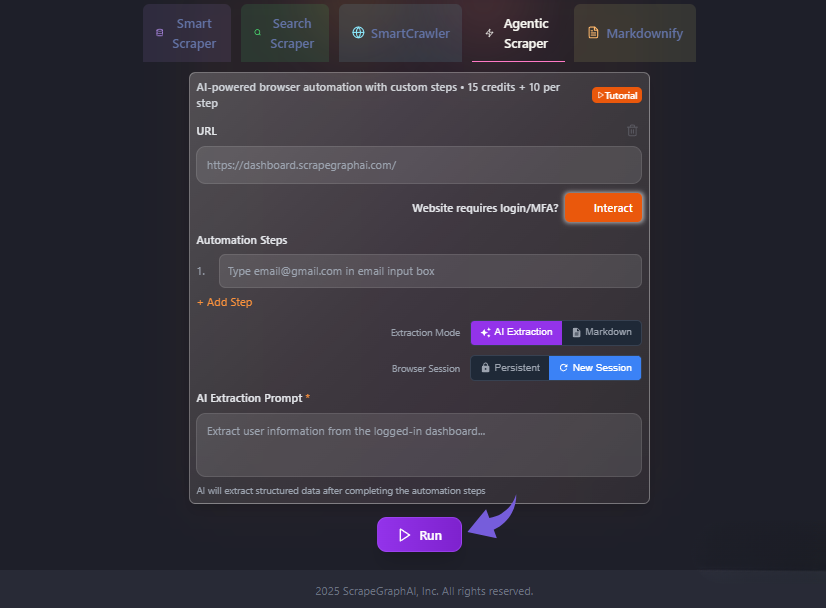
✓ Control: El resultado coincide con los campos que solicitaste.
Paso 3: Obtener resultados estables
Se adapta cuando los sitios web cambian, a diferencia de los programas de extracción de datos tradicionales.
✅ Resultado: Puedes leer un sitio web con mucho JavaScript sin problemas.
💡 Consejo profesional: Combínalo con proxies rotativos en sitios que bloquean los bots de forma estricta.
Cómo usar el programador de tareas de ScrapeGraphAI
Trabajo Programador Te permite ejecutar operaciones de web scraping de forma programada, de modo que la extracción de datos se repita automáticamente.
Aquí te explicamos cómo usarlo paso a paso.
Paso 1: Crear un trabajo
Guarda una extracción de datos como una tarea repetible.
Paso 2: Establecer la cadencia
Elige con qué frecuencia deben ejecutarse las operaciones de extracción de datos.
Así es como se ve:
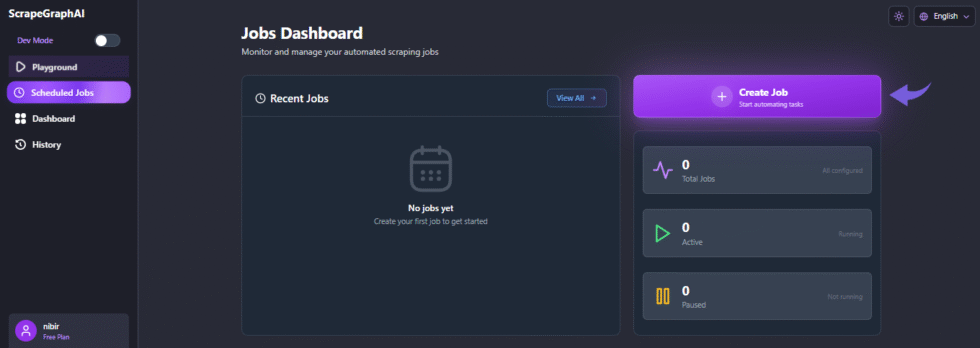
✓ Control: El resultado coincide con los campos que solicitaste.
Paso 3: Déjalo funcionar
El proceso de extracción de datos se repite y almacena información actualizada.
✅ Resultado: Ahora, los datos que extraes se actualizan automáticamente.
💡 Consejo profesional: Organiza las tareas de forma escalonada para no generar demasiadas solicitudes a la vez.
Cómo usar la interfaz sencilla de ScrapeGraphAI
Interfaz sencilla Te permite usar ScrapeGraphAI de forma eficaz desde un panel de control sin código y sin necesidad de tener amplios conocimientos técnicos.
Aquí te explicamos cómo usarlo paso a paso.
Paso 1: Abra el panel de control
Utilice el panel de control con inteligencia artificial; no se necesita código.
Paso 2: Construir sin código
Ejecuta tareas sin necesidad de conocimientos técnicos avanzados.
Así es como se ve:
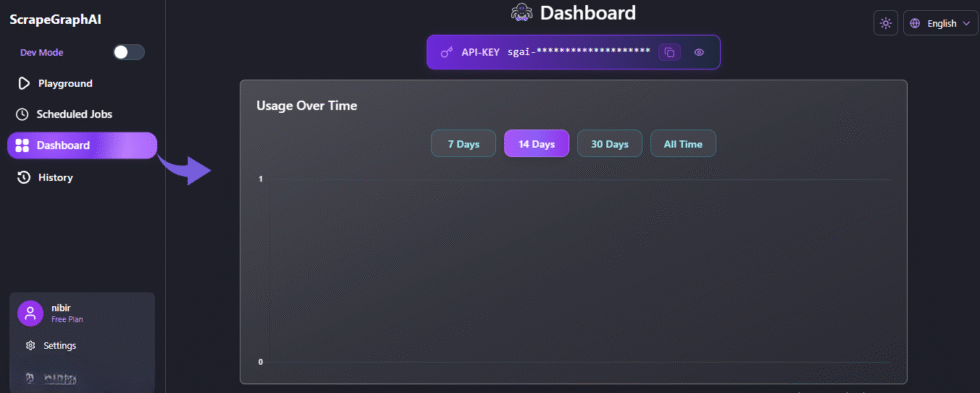
✓ Control: El resultado coincide con los campos que solicitaste.
Paso 3: Gestionar todo
Realiza un seguimiento de cada extracción de datos y utiliza ScrapeGraphAI de forma eficaz desde una sola pantalla.
✅ Resultado: Realizaste un web scraping completo sin código.
💡 Consejo profesional: Guarda los trabajos que hayas guardado para reutilizarlos en diferentes proyectos de extracción de datos.
Consejos y atajos profesionales para ScrapeGraphAI
Después de seis meses trabajando en proyectos de scrapbooking, aquí están mis mejores consejos.
Accesos directos de configuración rápida
| Meta | Atajo |
|---|---|
| Depurar una ejecución | Modo detallado que permite un registro de eventos detallado. |
| Guardar salida | Exportar a archivos JSON o CSV. |
| Evite los bloqueos | Agregar proxies rotativos |
| Estructura de cerradura | Esquema Pydantic |
Características ocultas que la mayoría de la gente pasa por alto
- Registro detallado: Un indicador que permite el registro detallado de cada nodo, facilitando así el manejo de errores.
- Rotación de proxy: Los proxies rotativos te permiten mantenerte dentro de los límites de velocidad de la API y evitar los bloqueos de IP en sitios protegidos.
- Modelos locales: Ejecuta modelos abiertos a través de Ollama para extraer información sin pagar por token.
Errores comunes que debes evitar en ScrapeGraphAI
Error: Ignorar los términos del sitio web
❌ Incorrecto: Extraer datos sin antes consultar los términos y condiciones del sitio web o las consideraciones legales.
✅ Derecha: Lea la política del sitio y respete los términos del sitio web antes de realizar cualquier extracción de datos.
Error: Acosar al servidor
❌ Incorrecto: Se envían solicitudes tan rápido que el sitio devuelve errores de demasiadas solicitudes.
✅ Derecha: Añade retrasos entre las solicitudes para no superar los límites de velocidad de la API.
Error: Indicaciones vagas
❌ Incorrecto: Redactar preguntas en lenguaje natural poco estructuradas que generen datos desordenados.
✅ Derecha: Proporcione los campos exactos y un esquema para obtener datos limpios en cada ocasión.
Solución de problemas de ScrapeGraphAI
Problema: Error de demasiadas solicitudes
Causa: Has alcanzado los límites de velocidad de la API al enviar solicitudes demasiado rápido.
Arreglar: Espacia las llamadas y añade un retardo; actualiza tu plan para obtener límites más altos.
Problema: Resultados en blanco o parciales
Causa: El sitio web objetivo utiliza mucho JavaScript, por lo que el contenido dinámico se carga con retraso.
Arreglar: Cambia al Smart Agentic Scraper, que renderiza la página antes de leerla.
Problema: Bloqueo o bloqueo de IP
Causa: El sitio detecta las operaciones de extracción de datos y muestra una página de bloqueo.
Arreglar: Añade proxies rotativos para que cada solicitud parezca la de un visitante nuevo.
📌 Nota: Estas soluciones cubren los problemas más comunes; para el resto, póngase en contacto con el soporte de ScrapeGraphAI.
¿Qué es ScrapeGraphAI?
ScrapeGraphAI Es una biblioteca de Python de código abierto para el web scraping inteligente.
Combina grandes modelos de lenguaje (LLM) con lógica gráfica directa para construir un sistema de extracción de datos.
Cada nodo en el gráfico de extracción de datos ejecuta una tarea, lo que facilita la actualización de cualquier extracción de datos.
Piénsalo como una idea inteligente asistente que lee páginas web y devuelve datos JSON limpios.
Mira este breve resumen:
Incluye estas características clave:
- Raspador inteligente: Extrae datos estructurados de cualquier página mediante una sencilla instrucción en lenguaje natural.
- Rastreador de búsqueda: Obtén datos web directamente de los resultados de búsqueda en tiempo real sin abrir cada enlace manualmente.
- Markdownify: transformar el contenido web en Markdown limpio que los modelos de IA puedan leer sin ruido adicional
- Agente Spidy: Rastrea múltiples páginas como un extractor de múltiples páginas para proyectos de extracción más grandes.
- Extracción universal de datos: Gestionar numerosas tareas de extracción de datos en datos de productos, artículos de noticias y más.
- Integraciones fáciles: Conecta los datos extraídos a tus modelos de ciencia de datos y aprendizaje automático en minutos.
- Rastreador agenico inteligente: leer contenido dinámico en sitios con mucho JavaScript que rompen los raspadores tradicionales
- Programador de trabajos: Ejecutar operaciones de raspado de forma programada para que la extracción de datos se repita automáticamente.
- Interfaz sencilla: Utilice ScrapeGraphAI de forma eficaz desde un panel de control sin código y sin necesidad de conocimientos técnicos avanzados.
Gracias a su capacidad para interpretar el contexto, puede extraer datos relevantes incluso cuando un sitio web cambia su diseño.
Lee páginas web y documentos locales, aunque no transcribe archivos de audio.
Con instrucciones sencillas en lenguaje natural, puedes utilizar datos como artículos de noticias para realizar análisis de sentimiento.
Para una revisión completa, consulte nuestra Reseña de ScrapeGraphAI.
Precios de ScrapeGraphAI
Este es el precio de ScrapeGraphAI en 2026:
| Plan | Precio | Mejor para |
|---|---|---|
| Gratis | $0 | Pruebas en algunas páginas |
| Motor de arranque | $17/mes | Tareas de extracción de datos individuales |
| Crecimiento | $85/mes | Proyectos de raspado regulares |
| Pro | $425/mes | Raspado a gran escala |
| Empresa | Costumbre | Equipos de alto volumen |
Prueba gratuita: Sí, el plan gratuito te permite probar la extracción de datos sin coste alguno.
Garantía de devolución de dinero: Cancela cuando quieras desde tu panel de control.
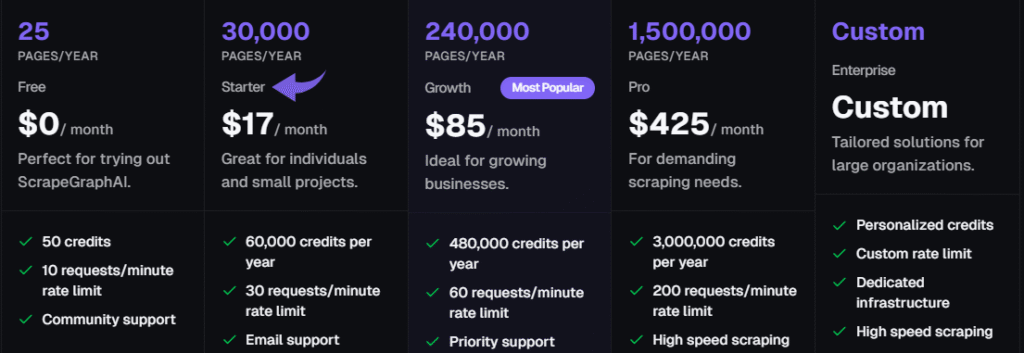
💰 Mejor relación calidad-precio: Crecimiento: volumen suficiente para proyectos de raspado constantes sin pagar de más.
ScrapeGraphAI frente a alternativas
¿Cómo se compara ScrapeGraphAI? Este es el panorama:
| Herramienta | Mejor para | Precio | Clasificación |
|---|---|---|---|
| ScrapeGraphAI | extracción nativa de IA | $17/mes | ⭐ 4.5 |
| Scrapy | Rastreo basado en código | Gratis | ⭐ 4.4 |
| Explorar IA | Monitorización sin código | $48/mes | ⭐ 4.3 |
| Datos brillantes | Red proxy | $0.50/mes | ⭐ 4.5 |
| Octoparse | Extracción visual de datos | $99/mes | ⭐ 4.3 |
| Abeja raspadora | Sitios con mucha carga de renderizado | $49/mes | ⭐ 4.4 |
Selecciones rápidas:
- Mejor en general: ScrapeGraphAI: la extracción de lenguaje natural supera a los selectores rígidos.
- Mejor presupuesto: Scrapy es gratis si sabes escribir el código tú mismo.
- Ideal para principiantes: Navega por la IA: apunta y haz clic, sin necesidad de scripts.
- Ideal para proxies: Bright Data: enorme grupo de servidores proxy rotativos.
🎯 Alternativas a ScrapeGraphAI
¿Buscas alternativas a ScrapeGraphAI? Aquí tienes las mejores opciones:
- 🚀 Scrapy: Marco de trabajo de Python de código abierto para desarrolladores que desean tener control total sobre cada rastreo web.
- 👶 Explorar la IA: Herramienta sin código que registra tus clics y convierte cualquier sitio web en una API.
- 🏢 Datos brillantes: Red de proxy empresarial con direcciones IP rotativas masivas para el web scraping a gran escala.
- 🎨 Octoparse: Herramienta visual de extracción de datos mediante apuntar y hacer clic, diseñada para personas sin conocimientos de programación que estén desarrollando proyectos de extracción de datos.
- 🔧 Abeja raspadora: API que renderiza sitios con mucho JavaScript para que no tengas que configurar tu propio navegador.
Para ver la lista completa, consulte nuestra Alternativas a ScrapeGraphAI guía.
⚔️ Comparación de ScrapeGraphAI
Así es como ScrapeGraphAI se compara con cada uno de sus competidores:
- ScrapeGraphAI vs Scrapy: ScrapeGraphAI gana en velocidad para obtener el primer resultado; Scrapy gana en control puro para los programadores.
- ScrapeGraphAI vs Browse AI: ScrapeGraphAI maneja páginas más desordenadas; Browse AI es más sencillo para diseños fijos y repetitivos.
- ScrapeGraphAI vs Bright Data: Bright Data es líder en proxies; ScrapeGraphAI es líder en la conversión de páginas en datos estructurados.
- ScrapeGraphAI vs Octoparse: ScrapeGraphAI se adapta cuando los sitios web cambian; Octoparse requiere que reconstruyas las plantillas.
- ScrapeGraphAI vs ScrapingBee: Ambos analizan sitios web complejos, pero ScrapeGraphAI también razona sobre el contenido con modelos de IA.
Empiece a usar ScrapeGraphAI ahora
Aprendiste a usar todas las funciones principales de ScrapeGraphAI:
- ✅ Raspador inteligente
- ✅ Rastreador de búsqueda
- ✅ Markdownify
- ✅ Agente Spidy
- ✅ Extracción universal de datos
- ✅ Integraciones sencillas
- ✅ Rastreador agenico inteligente
- ✅ Planificador de tareas
- ✅ Interfaz sencilla
Aquí están los principales beneficios de un vistazo:
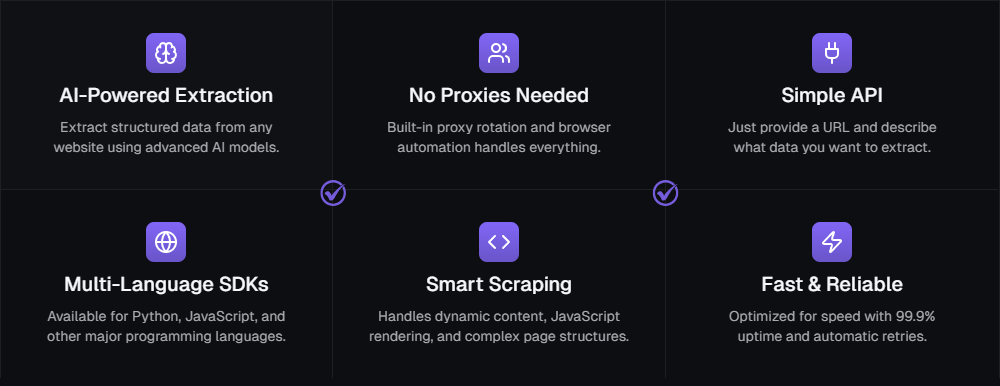
Siguiente paso: Elige una función y pruébala ahora.
La mayoría de la gente empieza con el extractor de datos de una sola página Smart Scraper.
Extraer los datos de tu primera página lleva menos de cinco minutos.
Preguntas frecuentes
¿Es ScrapeGraphAI de uso gratuito?
Sí. El plan gratuito incluye la extracción básica de datos web sin coste alguno, y los planes de pago comienzan en 17 $/mes cuando se necesita mayor volumen o funciones adicionales.
¿Necesito saber programar?
No. Puedes usar ScrapeGraphAI desde un panel de control sin código con indicaciones en lenguaje natural, aunque también tienes disponible una API de Python si la necesitas.
¿Qué modelos de lenguaje grandes admite?
Funciona con múltiples proveedores de modelos LLM, incluidos modelos de OpenAI como GPT-4o, Anthropic, Google Gemini y modelos locales a través de Ollama.
¿Puede manejar sitios con mucho JavaScript?
Sí. El raspador inteligente Agentic primero procesa el contenido dinámico, por lo que lee sitios con mucho JavaScript que no funcionan con los raspadores tradicionales.
¿Cómo puedo evitar que me bloqueen?
Respeta los términos del sitio web, agrega retrasos para evitar errores por exceso de solicitudes y utiliza proxies rotativos para evitar bloqueos de IP durante el rastreo web.













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
