
Inicio rápido
Esta guía cubre todas las funciones de Helium Scraper:
- Empezando — Crear cuenta y configuración básica
- Cómo utilizar la extracción rápida — Extrae datos de cualquier página web en sencillos pasos.
- Cómo usar un flujo de trabajo simple — Crea un flujo de trabajo sin código para extraer datos de cualquier sitio web.
- Cómo usar Scale on Demand — Escalabilidad bajo demanda con integración de proxies y proxies
- Cómo utilizar la función Capturar datos complejos — Capturar datos complejos y anidados, así como contenido JavaScript.
- Cómo usar Install Anywhere — Instálalo en cualquier ordenador y ejecuta el web scraping localmente.
Tiempo necesario: 5 minutos por función
También en esta guía: Consejos profesionales | Errores comunes | Solución de problemas | Precios | Alternativas
¿Por qué confiar en esta guía?
He usado helio Raspador Durante dos años, probé todas las funciones que se describen aquí. Este tutorial se basa en experiencia práctica real, no en publicidad engañosa ni en capturas de pantalla de proveedores.

Helium Scraper es un programa de raspado de escritorio sin código diseñado para pequeñas y medianas empresas. datos tareas de extracción.
Pero la mayoría de los usuarios solo exploran superficialmente todo el potencial de esta herramienta intuitiva.
Esta guía te muestra cómo usar Helium Scraper y todas sus funciones principales.
Paso a paso, con capturas de pantalla y consejos profesionales.
Tutorial sobre raspadores de helio
Este completo tutorial de Helium Scraper te guía a través de todas las funciones, desde la configuración inicial hasta consejos avanzados que te convertirán en un usuario experto capaz de extraer datos rápidamente.
Raspador de helio
Extrae datos de sitios web visualmente sin escribir código. Helium Scraper utiliza la selección mediante clic para extraer datos de cualquier sitio web en tu ordenador. Compra única para escritorio, sin suscripciones.
Primeros pasos con Helium Scraper
Antes de utilizar cualquier función, complete esta configuración inicial.
Tarda unos 3 minutos.
Primero, mira este breve recorrido basado en mi experiencia personal:
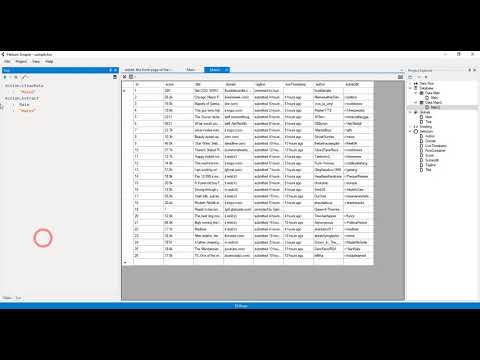
Ahora vamos a repasar cada paso.
Paso 1: Descargar e instalar
Visita la página web de Helium Scraper y elige tu plan.
Descarga el instalador y luego instálalo en tu ordenador.
✓ Control: El icono de la aplicación aparece en tu escritorio.
Paso 2: Abrir e iniciar sesión
Abre la aplicación y confirma tu licencia para activarla.
Helium Scraper se ejecuta localmente, por lo que no se necesita una cuenta en la nube.
Así es como se ve el panel de control:
✓ Control: Deberías ver el menú principal y el navegador web integrado.
Paso 3: Crea tu primer proyecto
Haz clic en Crear para iniciar un nuevo proyecto para el sitio web de destino.
Introduce la URL que deseas extraer en el navegador integrado.
✅ Hecho: Estás listo para usar cualquiera de las funciones a continuación.
Cómo usar el raspador de helio para una extracción rápida
Extracción rápida Te permite extraer datos de cualquier página web en tan solo unos sencillos pasos.
Aquí te mostramos cómo usarlo paso a paso.
Helium Scraper funciona en cualquier sitio web, desde una página de resultados de búsqueda de Google o Bing hasta un catálogo de productos.
Ahora vamos a desglosar cada paso.
Paso 1: Abra el navegador integrado.
Navegue hasta el sitio web de destino dentro del navegador integrado.
Introduce la URL que deseas extraer y carga la página.
Paso 2: Seleccione sus puntos de datos
Pulsa la tecla Ctrl y selecciona los elementos que desees, como los títulos de los productos o los precios.
Así es como se ve:
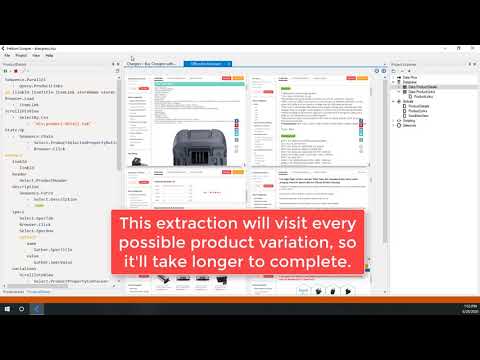
✓ Control: Los elementos seleccionados se resaltan en el navegador.
Paso 3: Ejecutar y exportar
Pulsa "Extraer" y, a continuación, exporta tus datos a Excel, CSV, JSON o SQLite.
✅ Resultado: Extrajiste datos limpios del sitio en minutos.
💡 Consejo profesional: Habilita el modo de selección y haz clic con la tecla Ctrl presionada en elementos similares para enseñarle rápidamente un patrón a la herramienta.
Cómo usar el flujo de trabajo simple de Helium Scraper
Flujo de trabajo simple Te permite crear un flujo de trabajo de web scraping sin código, sin necesidad de escribir código ni tener conocimientos de programación.
Aquí te mostramos cómo usarlo paso a paso.
Ahora vamos a desglosar cada paso.
Paso 1: Define tus tipos
Crea tipos para marcar los elementos de datos que deseas extraer.
Los tipos definen los títulos de los productos, los precios o cualquier campo de la página.
Paso 2: Agregar acciones
Añade acciones como hacer clic y navegar por la paginación.
Así es como se ve:
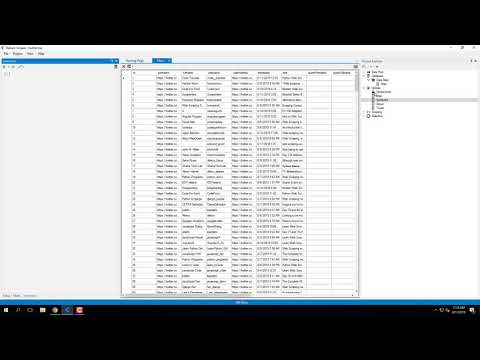
✓ Control: Tu flujo de trabajo se ejecuta a través de las páginas sin errores.
Paso 3: Validar el flujo de trabajo
Prueba tus tipos en diferentes páginas para confirmar que los resultados son precisos.
✅ Resultado: Has creado un proceso de extracción repetible mediante la selección con el ratón.
💡 Consejo profesional: La función de arrastrar y soltar constructor Es útil para principiantes; crea bucles repetitivos dentro de las acciones para manejar extracciones a gran escala.
Cómo usar la báscula raspadora de helio bajo demanda
Escalabilidad bajo demanda Te permite escalar grandes proyectos con integración de proxy para evitar límites de velocidad y captchas.
Aquí te mostramos cómo usarlo paso a paso.
Ahora vamos a desglosar cada paso.
Paso 1: Abra la configuración del proxy.
Abre el menú de configuración y busca la sección de integración de proxy.
Helium Scraper puede integrarse con servicios proxy para eludir los captchas y los bloqueos de IP.
Paso 2: Introduzca los detalles del proxy.
Introduzca la dirección y el puerto del proxy, confirme y habilite los proxies.
Así es como se ve:
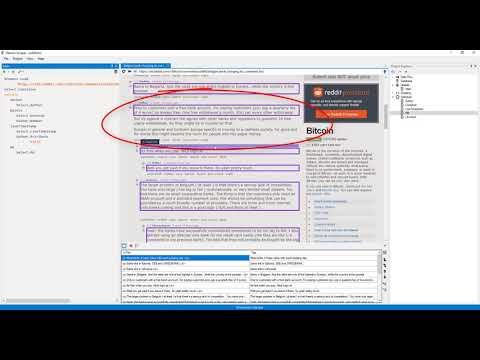
✓ Control: Sus solicitudes se enrutan a través del nodo de salida seleccionado.
Paso 3: Seleccione un nodo de salida
Elija un nodo de salida de EE. UU. o cualquier ubicación con servidores proxy residenciales.
Un nodo de salida de un país específico te ayuda a extraer datos geolocalizados.
✅ Resultado: Puedes realizar web scraping a gran escala sin alcanzar el límite de 500-600 solicitudes por hora.
💡 Consejo profesional: Utilice proxies rotativos y sesiones persistentes para proyectos de web scraping grandes y consistentes.
Cómo usar Helium Scraper para capturar datos complejos
Capturar datos complejos Te permite capturar datos complejos y anidados de sitios modernos que dependen de JavaScript.
Aquí te mostramos cómo usarlo paso a paso.
Ahora vamos a desglosar cada paso.
Paso 1: Habilitar el manejo de JavaScript
Deja que Helium Scraper navegue y haga clic en los elementos para renderizar JavaScript.
La herramienta también descarga imágenes mientras procesa la página.
Paso 2: Configurar la extracción anidada
Defina tipos anidados para extraer datos dentro de listas o tablas.
Así es como se ve:
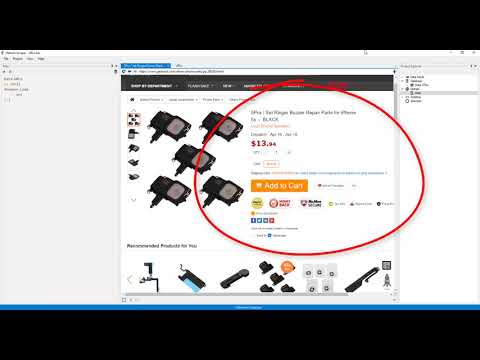
✓ Control: Los campos anidados aparecen correctamente en la vista previa de datos.
Paso 3: Usar código personalizado
Agregue código JavaScript y SQL personalizado para tareas avanzadas de extracción de datos.
✅ Resultado: Has capturado datos web complejos y estructurados de un sitio dinámico.
💡 Consejo profesional: Valide los tipos anidados en varias páginas de ejemplo antes de ejecutar el proceso completo.
Cómo usar el instalador todo en uno Helium Scraper
Instalar en cualquier lugar Te permite instalar la aplicación de escritorio en cualquier ordenador y ejecutar el web scraping localmente.
Aquí te mostramos cómo usarlo paso a paso.
Ahora vamos a desglosar cada paso.
Paso 1: Descargue el instalador
Descarga el instalador desde el sitio web y ejecuta la instalación.
El proceso de instalación es sencillo y finaliza en minutos.
Paso 2: Activa tu licencia
Abre la aplicación y confirma tu licencia con tu contraseña.
Así es como se ve:
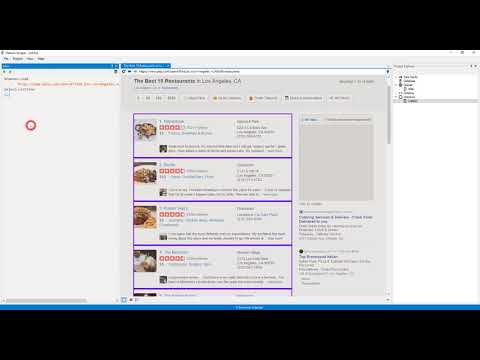
✓ Control: La aplicación se inicia y carga el navegador integrado.
Paso 3: Comprobar los recursos del sistema
Asegúrate de que tu ordenador tenga suficientes recursos para tareas grandes.
Helium Scraper se ejecuta localmente y puede requerir una cantidad considerable de recursos del ordenador.
✅ Resultado: Tienes un raspador local listo en tu propia máquina.
💡 Consejo profesional: Para tareas pesadas, cierra otras aplicaciones para que se destinen más recursos al proceso de extracción.
Consejos y atajos profesionales para el raspador de helio
Tras probar Helium Scraper durante dos años, aquí están mis mejores consejos para una extracción de datos más rápida.
Atajos de teclado
| Acción | Atajo |
|---|---|
| Seleccione un elemento | Ctrl + clic |
| Ampliar una selección | Ctrl + Mayús + Clic |
| Ejecutar extracción | F5 |
| Abrir configuración del proyecto | Ctrl + , |
Características ocultas que la mayoría de la gente pasa por alto
- JavaScript y SQL personalizados: Agregue código para la extracción avanzada a la que no se puede acceder mediante el menú de selección con el ratón.
- Selección del nodo de salida de EE. UU.: Seleccione servidores proxy de una ubicación específica para extraer datos de sitios web y motores de búsqueda con restricción geográfica.
- Repetir bucles: Crea bucles dentro de las acciones para navegar por la paginación y extraer listas grandes automáticamente.
Errores comunes que se deben evitar al usar un raspador de helio
Error n.° 1: Omitir la integración del proxy
❌ Incorrecto: Enviar cientos de solicitudes desde una sola IP y encontrar captchas y límites de velocidad.
✅ Derecha: Configure la integración de proxies con proxies rotativos para evitar el límite de 500-600 solicitudes por hora.
Error n.° 2: No validar a tus semejantes
❌ Incorrecto: Confiar en una página y asumir que el mismo comportamiento se da en todo el sitio web.
✅ Derecha: Pruebe cada tipo en varias páginas de ejemplo para confirmar la identificación precisa de los datos.
Error n.º 3: Ignorar los recursos informáticos
❌ Incorrecto: Ejecutar una tarea de gran envergadura mientras muchas otras aplicaciones compiten por recursos limitados.
✅ Derecha: Cierra los demás programas para que el proceso de extracción obtenga los recursos que necesita.
Solución de problemas del raspador de helio
Problema: Las páginas se cargan en blanco.
Causa: El sitio web utiliza JavaScript que aún no ha terminado de renderizarse.
Arreglar: Deja que la herramienta navegue y haga clic en los elementos para que la página se cargue por completo antes de seleccionar los datos.
Problema: Bloqueo o Captchas
Causa: Demasiadas solicitudes desde una misma IP activaron las defensas del sitio.
Arreglar: Habilita los proxies en la configuración, introduce la dirección y el puerto, y elige un nuevo nodo de salida.
Problema: Se extrajeron datos incorrectos.
Causa: Tu tipo coincidió con los elementos incorrectos en algunas páginas.
Arreglar: Vuelva a seleccionar con Ctrl+clic y valide el tipo en diferentes páginas del sitio.
📌 Nota: Si ninguna de estas soluciones resuelve su problema, consulte la documentación o póngase en contacto con el soporte y la comunidad de Helium Scraper.
¿Qué es Helium Scraper?
Raspador de helio Es un programa de escritorio que no requiere código y que permite extraer datos de la web de forma visual.
Imagínalo como un rotulador inteligente: apuntas, haces clic y recopila los datos por ti.
La principal diferencia con las herramientas en la nube es que se ejecuta localmente, lo cual es cierto para cada tarea de extracción de datos y resulta ideal para casos de uso pequeños y sencillos.
Mira este breve resumen:
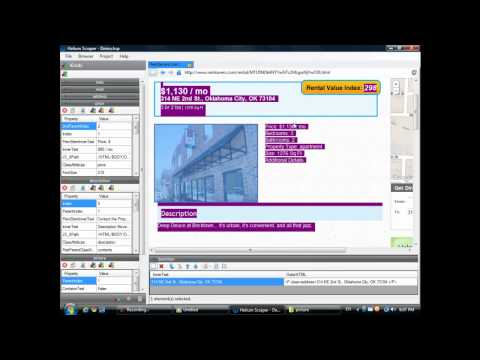
Incluye estas características clave:
- Extracción rápida: Extrae datos de cualquier página en sencillos pasos.
- Flujo de trabajo simple: Crea un flujo de trabajo sin código y sin necesidad de conocimientos de programación.
- Escalabilidad bajo demanda: Escalabilidad con integración de proxy y nodo de salida en EE. UU.
- Captura de datos complejos: Captura datos complejos y anidados, así como contenido JavaScript.
- Instalar en cualquier lugar: Instala y ejecuta el web scraping localmente en cualquier ordenador.
Para una revisión completa, consulte nuestra Reseña del raspador de helio.
Precios de raspadores de helio
Esto es lo que costará Helium Scraper en 2026:
| Plan | Precio | Mejor para |
|---|---|---|
| Básico | $99 | Personas y pequeñas tareas de raspado |
| Profesional | $199 | Trabajadores autónomos ejecutar proyectos regulares |
| Negocio | $399 | Equipos con mayores necesidades de datos |
| Empresa | $699 | Raspado pesado y a gran escala |
Prueba gratuita: Sí, una prueba gratuita te permite probar la herramienta antes de comprarla.
Garantía de devolución de dinero: El precio corresponde a una compra única para ordenador, no a una suscripción.
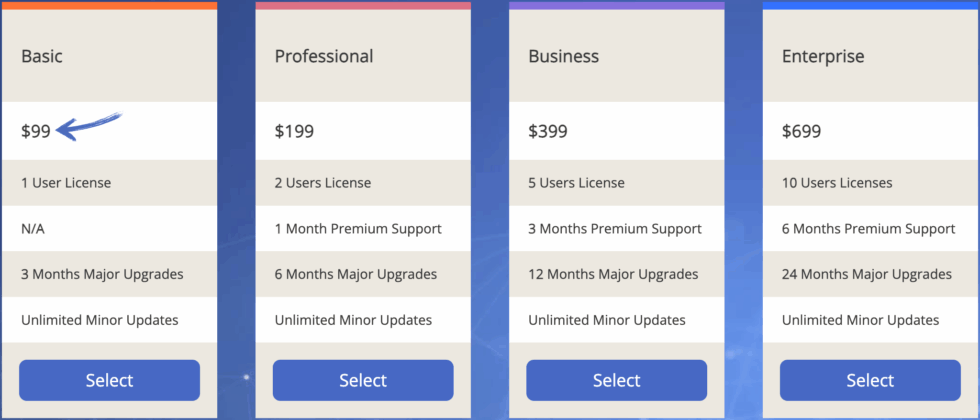
💰 Mejor relación calidad-precio: Profesional: el mejor plan para la mayoría de los freelancers que realizan web scraping con regularidad.
Raspador de helio frente a alternativas
¿Cómo se compara Helium Scraper? Este es el panorama competitivo:
| Herramienta | Mejor para | Precio | Clasificación |
|---|---|---|---|
| Raspador de helio | Extracción de datos local sin código | $99 por única vez | ⭐ 3.5 |
| Octoparse | Extracción visual de datos de la nube | $99/mes | ⭐ 4.3 |
| ParseHub | Principiantes | $189/mes | ⭐ 4.2 |
| Scrapy | Desarrolladores | Gratis | ⭐ 4.5 |
| Abeja raspadora | API y escalabilidad | $49/mes | ⭐ 4.4 |
| Datos brillantes | Proxies empresariales | $499/mes | ⭐ 4.6 |
Selecciones rápidas:
- Mejor en general: Helium Scraper: visual, sin necesidad de código y con un precio único.
- Mejor presupuesto: Scrapy: gratuito y de código abierto para quienes escriben código.
- Ideal para principiantes: ParseHub: sencillo y fácil de aprender.
- Lo mejor para medir el tamaño: ScrapingBee: una API en la nube para tareas automatizadas de gran envergadura.
🎯 Alternativas al raspador de helio
¿Buscas alternativas al raspador de helio? Aquí tienes las mejores opciones:
- 🚀 Octoparse: Un extractor visual basado en la nube con programación y automatización que ejecuta tareas sin mantener el ordenador encendido.
- 👶 ParseHub: Una herramienta fácil de usar para principiantes, con una configuración sencilla mediante clics, ideal para usuarios que se inician en la extracción de datos.
- 🔧 Scrapy: Un framework gratuito de código abierto para desarrolladores con experiencia en la escritura de código y la creación de proyectos de web scraping personalizados.
- ⚡ Abeja raspadora: Una API de web scraping en la nube que renderiza JavaScript y gestiona proxies y captchas a gran escala.
- 🏢 Datos brillantes: Una plataforma empresarial con extensas redes de servidores proxy y un nodo de salida en EE. UU. para la extracción de datos geolocalizada.
Para ver la lista completa, consulte nuestra Alternativas al raspador de helio guía.
⚔️ Comparativa de raspadores de helio
Así es como Helium Scraper se compara con cada uno de sus competidores:
- Raspador de helio vs. Octoparse: Helium Scraper gana por su precio con una tarifa única; Octoparse gana por su programación en la nube y sus ejecuciones paralelas.
- Helium Scraper vs ParseHub: Ambos son aptos para principiantes; Helium Scraper es mejor para raspar superficies pequeñas y de forma localizada, sin costes mensuales.
- Raspador de helio vs Scrapy: Scrapy es la mejor opción para programadores que crean web scrapers personalizados; Helium Scraper es la mejor opción para la extracción visual sin código.
- Helium Scraper vs ScrapingBee: ScrapingBee destaca por su automatización y escalabilidad; Helium Scraper es mejor para tareas locales rápidas sin necesidad de programar.
- Helium Scraper vs. Bright Data: Bright Data es líder en proxies y escalabilidad empresarial; Helium Scraper es más sencillo y mucho más económico para tareas pequeñas.
Empiece a usar Helium Scraper ahora
Aprendiste a usar todas las funciones principales de Helium Scraper:
- ✅ Extracción rápida
- ✅ Flujo de trabajo sencillo
- ✅ Escalabilidad bajo demanda
- ✅ Capturar datos complejos
- ✅ Instálalo en cualquier lugar
Siguiente paso: Elige una función y pruébala ahora.
La mayoría de la gente empieza con la extracción rápida.
Tarda menos de 5 minutos.
Preguntas frecuentes
¿Cómo utilizo Helium Scraper?
Instala la aplicación de escritorio, abre el navegador integrado, haz clic con la tecla Ctrl presionada en los datos que deseas clasificar, luego ejecuta la extracción y expórtala a Excel, CSV, JSON o SQLite.
¿Helium Scraper requiere conocimientos de programación?
No. Helium Scraper es una herramienta sin código, que funciona con solo hacer clic. Puedes seleccionar los datos visualmente sin escribir código, aunque dispone de JavaScript y SQL personalizados para la extracción avanzada de datos.
¿Cómo funciona la integración de proxies en Helium Scraper?
Abre la configuración, introduce la dirección y el puerto del proxy, confirma y habilita los proxies. Elige un nodo de salida, como una ubicación en EE. UU., para extraer datos geolocalizados y evitar los captchas.
¿Es Helium Scraper adecuado para proyectos de gran envergadura?
Es adecuado para proyectos pequeños y medianos. Para trabajos grandes, utilice proxies rotativos para evitar el límite de 500-600 solicitudes por hora, ya que la herramienta se ejecuta localmente y utiliza sus recursos.
¿Puede Helium Scraper procesar sitios web con JavaScript?
Sí. Navega y hace clic en elementos para renderizar JavaScript y descargar imágenes, lo que permite extraer datos complejos y anidados de sitios web dinámicos modernos.













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
