
Быстрый старт
В этом руководстве описаны все функции веб-скрейпера:
- Начиная — Создание учетной записи и базовая настройка
- Как использовать интерфейс «наведи и щелкни» — Создавайте парсеры визуально, не написав ни строчки кода.
- Как использовать функцию извлечения данных — Извлекать структурированные данные с любой страницы сайта
- Как использовать обработку сайтов с JavaScript — Парсинг динамических страниц, загружающих контент с помощью JavaScript.
- Как использовать настраиваемые данные — Перед экспортом отрегулируйте и очистите удаленные строки.
- Как использовать функцию экспорта данных — Сохраните результаты в формате CSV, XLSX или JSON.
Необходимое время: 5 минут на каждый фильм
Также в этом руководстве: Полезные советы | Распространенные ошибки | Поиск неисправностей | Цены | Альтернативы
Почему стоит доверять этому руководству?
Я использую Web Scraper уже более шести месяцев и протестировал каждую функцию, описанную в этом руководстве. Эта статья основана на реальном практическом опыте, а не на маркетинговых уловках.

Web Scraper — один из самых простых в освоении инструментов для веб-скрейпинга, созданных на основе веб-браузеров. данные экстракция.
Но большинство пользователей лишь поверхностно знакомы с его возможностями.
В этом руководстве пошагово показано, как использовать веб-скрейпер.
Каждая функция сопровождается скриншотами и полезными советами.
Учебное пособие по веб-скрейпингу
В этом подробном руководстве по использованию Web Scraper вы шаг за шагом изучите все его функции, от первоначальной настройки до продвинутых методов, которые сделают вас опытным пользователем.
Веб-скрейпер
Парсьте сайты прямо из браузера без написания кода. Web Scraper позволяет извлекать данные с любого веб-сайта и экспортировать их в форматы CSV, XLSX или JSON. Начните бесплатно — кредитная карта не требуется.
Начало работы с веб-скрейпером
Перед использованием любой функции выполните эту одноразовую настройку.
Это займет около 3 минут.
Сначала посмотрите этот краткий обзор:
Теперь давайте рассмотрим каждый шаг.
Шаг 1: Создайте свою учетную запись
Откройте в браузере веб-сайт Web Scraper по адресу https://webscraper.io/.
Нажмите «Зарегистрироваться» или «Начать бесплатную пробную версию».
Введите свой адрес электронной почты и создайте пароль для настройки учетной записи.
✓ Контрольная точка: Проверьте свой входящие для получения подтверждающего письма.
Шаг 2: Установите расширение для браузера.
Откройте Chrome Web Store и найдите расширение "Web Scraper".
Нажмите «Добавить в Chrome» и подтвердите загрузку.
Расширение также работает на настольных компьютерах под управлением Windows, macOS и Linux.
Вот как выглядит панель управления:
✓ Контрольная точка: В инструментах разработчика вы должны увидеть вкладку «Веб-скрейпер».
Шаг 3: Завершение первоначальной настройки
Откройте инструменты разработчика (F12) и перейдите на вкладку «Веб-скрейпер», чтобы загрузить интерфейс.
Создайте свою первую карту сайта, вставив URL-адрес сайта, с которого вы хотите получить данные.
✅ Готово: Вы готовы использовать любую из функций ниже.
Как использовать веб-скрейпер с интерфейсом «наведи и щелкни»
Интерфейс "наведи и щелкни" Позволяет визуально создать парсер, выбрав нужные элементы на странице.
Вот пошаговая инструкция по его использованию.
Шаг 1: Откройте редактор карты сайта.
Перейдите в браузере на сайт, с которого хотите выполнить парсинг.
Откройте инструменты разработчика и перейдите на вкладку «Веб-скрейпер», чтобы начать.
Шаг 2: Визуальный выбор элементов
Нажмите «Добавить новый селектор» и выберите тип селектора.
Щелкните непосредственно по элементам страницы, которые вы хотите скопировать.
Web Scraper выделяет нужные элементы и предлагает вам CSS-селекторы.
Например, при нажатии на название товара автоматически генерируется соответствующий селектор.
Вот как это выглядит:
✓ Контрольная точка: Вы должны увидеть зелёную подсветку выбранных элементов.
Шаг 3: Сохраните выбранный селектор
Нажмите «Завершить выбор», а затем нажмите «Сохранить выбор» для подтверждения.
Парсер хранит шаблон CSS-селекторов для поиска элементов на каждой странице.
✅ Результат: Ваш визуальный парсер готов к извлечению данных без написания кода.
💡 Полезный совет: Используйте функцию «Предварительный просмотр элементов», чтобы убедиться, что ваши селекторы получают правильные данные, прежде чем запускать полный сбор данных.
Как использовать веб-скрейпер для извлечения данных
Извлечение данных Позволяет автоматически извлекать структурированные данные с любой веб-страницы.
Вот пошаговая инструкция по его использованию.
Шаг 1: Настройте селекторы
Настройте селекторы для каждой точки данных — текстссылка, изображение или заголовок HTML.
Используйте дерево селекторов для навигации по вложенным элементам в структуре страницы.
Шаг 2: Выполните очистку
Нажмите «Скрапинг» и установите интервал запросов и задержку загрузки страницы.
Парсер отправляет запросы на каждый URL-адрес и запускает процесс извлечения данных.
Вот как это выглядит:
✓ Контрольная точка: В окне предварительного просмотра должны отобразиться строки извлеченных данных.
Шаг 3: Проанализируйте результаты.
Нажмите “Просматривать«Для просмотра извлеченных данных в табличном представлении».
Убедитесь, что каждый столбец соответствует данным, которые вы хотите собрать.
✅ Результат: У вас есть чистые, структурированные данные, готовые к экспорту.
💡 Полезный совет: Установите задержку в 2 секунды между запросами, чтобы избежать срабатывания ограничений на целевом веб-сайте.
Как использовать веб-скрейпер для обработки сайтов с JavaScript
Обработка сайтов с JavaScript Позволяет парсить динамические страницы, загружающие контент с помощью JavaScript.
Вот пошаговая инструкция по его использованию.
Шаг 1: Определение динамического контента
Проверьте, загружаются ли данные на странице после первоначального HTML-кода, проанализировав дерево узлов.
Возможно, вам потребуется вручную просмотреть HTML-элементы, чтобы определить, какие из них загружаются с задержкой.
Если контент отображается только после выполнения JavaScript, вам необходима эта функция.
Шаг 2: Включите рендеринг JavaScript.
В Web Scraper Cloud выберите «Полная отрисовка JavaScript» в настройках карты сайта.
Установите время ожидания загрузки страницы таким образом, чтобы все элементы полностью отобразились до начала сбора данных.
Вот как это выглядит:
✓ Контрольная точка: В окне предварительного просмотра должно отображаться динамически загружаемое содержимое.
Шаг 3: Тестирование и запуск
Проведите тестовый сбор данных на одной странице, чтобы убедиться, что скрипт захватывает все элементы.
После проверки выполните полный сбор данных со всех целевых страниц сайта.
✅ Результат: Теперь вы можете извлекать данные с сайтов, активно использующих JavaScript, как профессионал.
💡 Полезный совет: Если на сайте используется бесконечная прокрутка, добавьте селектор «Прокрутка вниз», чтобы загрузить весь контент до начала сбора данных.
Как использовать веб-скрейпер для настройки данных
Настройка данных Позволяет корректировать, очищать и изменять собранные данные перед их сохранением.
Вот пошаговая инструкция по его использованию.
Шаг 1: Откройте предварительный просмотр данных.
После завершения сбора данных нажмите кнопку «Просмотреть», чтобы открыть таблицу с исходными данными.
Просмотрите каждый столбец и отметьте строки, которые нуждаются в очистке.
Шаг 2: Примените регулярные выражения или текстовые фильтры.
Используйте опцию «Регулярные выражения» в селекторе для анализа и удаления ненужного текста.
По сути, это гибкий алгоритм сопоставления с шаблоном, который очищает данные на месте.
Вот как это выглядит:
✓ Контрольная точка: Теперь в столбцах данных должны отображаться только очищенные значения.
Шаг 3: Переименуйте и измените порядок столбцов.
Отредактируйте названия селекторов, чтобы присвоить каждому столбцу понятную и привычную метку заголовка.
Измените порядок селекторов в карте сайта в соответствии с конечной структурой выходных данных.
✅ Результат: Ваши данные очищены, размечены и готовы к экспорту или анализу.
💡 Полезный совет: Используйте флажок «Несколько» в селекторе, чтобы сохранить все совпадающие элементы в виде отдельных строк в выходных данных.
Как использовать веб-скрейпер для экспорта данных
Экспорт данных Позволяет сохранять результаты парсинга в виде CSV-файла, XLSX-файла или JSON-файла.
Вот пошаговая инструкция по его использованию.
Шаг 1: Завершите очистку.
Дождитесь завершения сбора данных, затем нажмите «Просмотреть», чтобы предварительно просмотреть данные.
Убедитесь, что все строки и столбцы содержат ожидаемые вами значения.
Шаг 2: Выберите формат экспорта
Нажмите кнопку «Экспорт» и выберите формат CSV, XLSX или JSON из списка.
Для большинства пользователей CSV-файлы являются наиболее гибким и широко поддерживаемым вариантом.
Вот как это выглядит:
✓ Контрольная точка: В вашем браузере должно появиться сообщение о загрузке.
Шаг 3: Сохраните файл
Выберите папку на своем компьютере и сохраните экспортированный файл.
Откройте файл в Excel, Google Sheets или любой другой программе, поддерживающей чтение CSV-файлов, чтобы проверить и распечатать данные.
✅ Результат: Собранные данные сохраняются локально и готовы к использованию.
💡 Полезный совет: В Web Scraper Cloud используйте API или веб-хук для автоматической отправки экспортированных данных в Dropbox или Google Drive.
Советы и полезные приемы для профессионального веб-скрейпинга
После более чем шести месяцев тестирования Web Scraper, вот мои лучшие советы.
Отзывы пользователей на форумах подтверждают, что эти сочетания клавиш позволяют сэкономить больше всего времени.
Клавиатурные сочетания
| Действие | Быстрый доступ |
|---|---|
| Открыть инструменты разработчика | Ф12 |
| Проверить элемент | Ctrl + Shift + C |
| Переключить консоль | Эск |
| Обновить страницу | Ctrl + R |
Скрытые функции, которые большинство людей упускают из виду.
- Импорт/экспорт карты сайта: Скопируйте и вставьте JSON-карту сайта, чтобы быстро клонировать парсер или поделиться ею со своей командой в виде публикации в папке проекта.
- Селектор пагинации: Добавьте селектор ссылок для кнопок «Далее», чтобы автоматически перемещаться по многостраничным результатам поиска и собирать данные со всех страниц.
- Плановое удаление данных: Используйте Web Scraper Cloud для выполнения сбора данных по заданному расписанию и получения актуальной информации на вашу электронную почту или веб-перехватчик сервиса.
Распространенные ошибки при использовании веб-скрейперов, которых следует избегать.
Ошибка №1: Слишком быстрая обработка без задержек.
❌ Неправильно: Запуск сбора данных происходит без задержки, что приводит к блокировке IP-адресов и появлению сообщений об ошибках от сервера.
✅ Справа: Установите минимальную задержку в 2000 мс между запросами, чтобы имитировать модели поведения пользователей в интернете.
Ошибка №2: Использование неправильного типа селектора
❌ Неправильно: Использование селектора «Текст» необходимо для извлечения значений ссылок href или URL-адресов изображений из элементов.
✅ Справа: Подберите тип селектора в соответствии с вашими данными — используйте «Link» для URL-адресов и «Image» для изображений.
Ошибка №3: Игнорирование правил robots.txt.
❌ Неправильно: Парсинг страниц блокируется файлом robots.txt, что может привести к юридическим проблемам для бизнеса.
✅ Справа: Перед началом сбора данных всегда проверяйте файл robots.txt, чтобы соблюдать требования законодательства и избежать проблем.
Устранение неполадок веб-скрейперов
Проблема: Парсер возвращает пустые данные.
Причина: CSS-селекторы нацелены на элементы, которых больше нет на странице.
Исправить: Проверьте страницу еще раз в браузере, обновите селекторы и выполните тестовый сбор данных.
Проблема: не загружается содержимое JavaScript.
Причина: Бесплатное расширение для браузера не может выполнять JavaScript на страницах, которым он необходим.
Исправить: Переключитесь на Web Scraper Cloud, который поддерживает полноценную отрисовку JavaScript для динамических сайтов.
Проблема: IP-адрес блокируется в процессе сбора данных.
Причина: Отправка слишком большого количества запросов слишком быстро активирует антиботовую защиту целевого сайта.
Исправить: Увеличьте задержку как минимум до 3 секунд и используйте ротацию прокси, если она доступна.
📌 Примечание: Если ни один из этих способов не решит вашу проблему, обратитесь в службу поддержки Web Scraper за ответом на ваш конкретный вопрос.
Что такое веб-скрейпер?
Веб-скрейпер это веб скребок Это позволяет извлекать данные с любого веб-сайта с помощью вашего браузера.
Представьте это как умный инструмент копирования и вставки для всего интернета, который организует данные в строки и столбцы.
Посмотрите этот краткий обзор:
В его состав входят следующие ключевые особенности:
- Интерфейс "наведи и щелкни": Создавайте парсеры визуально, без написания кода на Python или любом другом языке программирования.
- Извлечение данных: Автоматическое извлечение текста, ссылок и URL-адресов изображений с любой веб-страницы.
- Обработка сайтов с использованием JavaScript: Парсинг динамического контента, загружаемого с помощью JavaScript или Ajax-запросов.
- Настройка данных: Очистите, отфильтруйте и отредактируйте полученные данные перед сохранением.
- Экспорт данных: Загрузите результаты в формате CSV, XLSX или JSON одним щелчком мыши.
Полный обзор смотрите в нашем разделе Обзор веб-скрейпера.
Цены на веб-скрейперы
Вот сколько будет стоить Web Scraper в 2026 году:
| План | Цена | Лучше всего подходит для |
|---|---|---|
| Бесплатно | Бесплатно | Обычные пользователи тестируют небольшие задачи по сбору данных. |
| Проект | 40 долларов в месяц | Фрилансеры выполнение регулярных задач по сбору данных |
| Профессиональный | 80 долларов в месяц | Командам требуется несколько одновременно работающих парсеров. |
| Шкала | 167 долларов в месяц | Агентства, занимающиеся извлечением больших объемов данных. |
| Предприятие | Обычай | Крупные компании с индивидуальными потребностями в сборе данных. |
Бесплатный уровень: Да, расширение для браузера совершенно бесплатно и не имеет ограничений по времени.
Гарантия возврата денег: Для возврата средств за оплаченные тарифные планы обратитесь в службу поддержки в течение 14 дней.
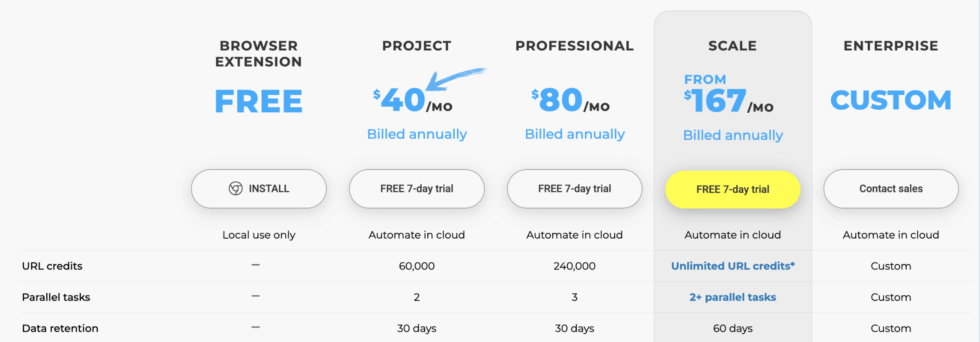
💰 Лучшее соотношение цены и качества: План проекта — предоставляет возможность сбора данных из облачных сервисов и планирования запусков по самой низкой цене.
Веб-скрейперы против альтернатив
Как Web Scraper выглядит на фоне конкурентов? Вот конкурентная среда:
| Инструмент | Лучше всего подходит для | Цена | Рейтинг |
|---|---|---|---|
| Веб-скрейпер | Парсинг данных через браузер | Бесплатно+ | ⭐ 3.5 |
| Октопарс | Визуальный парсинг без использования кода | 89 долларов в месяц | ⭐ 4.3 |
| ParseHub | Сложные многоуровневые скрапы | 189 долларов в месяц | ⭐ 4.2 |
| Скребок | Разработчики Python в больших масштабах | Бесплатно | ⭐ 4.5 |
| Апофит | Сбор данных из облаков с участием актёров | 49 долларов в месяц | ⭐ 4.4 |
Краткий выбор:
- Лучший вариант в целом: Web Scraper — бесплатный тариф и простое расширение для браузера, подходящее для большинства пользователей.
- Оптимальный бюджет: Scrapy — полностью бесплатный и открытый проект для разработчиков на Python.
- Лучший вариант для начинающих: Octoparse — интерфейс с функцией перетаскивания и встроенными шаблонами.
- Лучше всего подходит для сбора данных из облаков: Apify — влиятельные игроки и доступ к API в мире веб-скрейпинга
🎯 Альтернативы веб-скрейперам
Ищете альтернативы веб-скрейперам? Вот лучшие варианты:
- 🚀 Октопарс: Парсер без кода с визуальным рабочим процессом. строительготовые шаблоны и облачные сервисы для предприятий любого размера.
- 💰 ParseHub: Обрабатывает сложные сайты с многоуровневой навигацией и AJAX-загрузкой, отлично подходит для пользователей, которым требуется расширенное извлечение данных без написания кода.
- 🔧 Скребок: Открытый Python-фреймворк, созданный для разработчиков, которым нужен полный контроль, прекрасная интеграция с Soup и масштабный парсинг данных.
- ⚡ Апифы: Облачная платформа с маркетплейсом готовых парсеров и гибким API для разработчиков и команд по всему миру.
Полный список смотрите в нашем Альтернативы веб-скрейперам гид.
⚔️ Сравнение веб-скрейперов
Вот как Web Scraper выглядит в сравнении с каждым из конкурентов:
- Web Scraper против Octoparse: Web Scraper — бесплатное приложение, работающее непосредственно в браузере; Octoparse предлагает больше возможностей благодаря своему настольному приложению и облачным инструментам для более крупных проектов.
- Web Scraper против ParseHub: ParseHub обеспечивает более глубокую навигацию по сайту; Web Scraper выигрывает по цене и простоте для быстрого сбора данных с одной страницы.
- Web Scraper vs Scrapy: Scrapy предоставляет разработчикам полный контроль через скрипт Python; Web Scraper лучше подходит для тех, кто не умеет программировать и предпочитает визуальный подход.
- Web Scraper против Apify: Apify преуспевает в облачных решениях. автоматизация и доступ к API; Web Scraper проще в использовании для пользователей, которые просто заходят в свой браузер и начинают работу.
Начните использовать веб-скрейпер прямо сейчас!
Вы научились использовать все основные функции веб-скрейпера:
- ✅ Интерфейс "наведи и щелкни"
- ✅ Извлечение данных
- ✅ Обработка сайтов с JavaScript
- ✅ Настройка данных
- ✅ Экспорт данных
Следующий шаг: Выберите одну функцию и попробуйте прямо сейчас.
Большинство людей начинают с интерфейса «наведи и щелкни».
Это займет меньше 5 минут.
Часто задаваемые вопросы
Можно ли бесплатно использовать Web Scraper?
Да. Расширение для браузера Web Scraper бесплатное. Платные облачные тарифы начинаются от 40 долларов в месяц и включают запланированные операции сбора данных и доступ к API.
Может ли веб-скрейпер обрабатывать страницы, отображаемые с помощью JavaScript?
Да, но только в Web Scraper Cloud. Бесплатное расширение для браузера не выполняет JavaScript. Облачные тарифы поддерживают полноценную отрисовку JavaScript.
В каких форматах веб-скрейпер может экспортировать данные?
Web Scraper позволяет экспортировать данные в форматы CSV, XLSX или JSON. Пользователи облачной платформы также могут получать доступ к данным через API или веб-перехватчик.
Нужны ли мне навыки программирования для использования веб-скрейпера?
Нет. Web Scraper использует интерфейс «наведи и щелкни». Вы выбираете элементы визуально — никакой Python, Beautiful Soup или другой код не требуется.
Законен ли веб-скрейпинг?
В целом, да, для общедоступных данных. Всегда проверяйте файл robots.txt и условия использования сайта. Избегайте сбора личных или конфиденциальных данных.













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
