
빠른 시작
이 가이드에서는 Firecrawl의 모든 기능을 다룹니다.
- 시작하기 — Firecrawl 계정을 만들고 API 키를 설정하세요.
- 스크래퍼 사용 방법 — 단일 웹 페이지에서 llm 준비 데이터 가져오기
- 크롤 사용 방법 — 웹사이트 전체를 크롤링하고 모든 링크를 따라갑니다.
- 검색 사용 방법 — 실시간 웹 데이터를 웹에서 검색하세요
- 지도 사용 방법 — 개별 페이지에 걸쳐 URL 검색을 실행합니다.
- 추출물 사용 방법 — 자연어 프롬프트를 사용하여 구조화된 데이터 추출
소요 시간: 각 작품당 5분
이 가이드에는 다음 내용도 포함되어 있습니다. 프로 팁 | 흔히 저지르는 실수 | 문제 해결 | 가격 | 대안
이 가이드를 신뢰해야 하는 이유
저는 1년 넘게 Firecrawl을 사용해 왔으며 여기에 소개된 모든 기능을 테스트해 보았습니다.
이 Firecrawl 사용법 튜토리얼은 실제 웹 스크래핑 작업을 바탕으로 작성되었습니다.

Firecrawl은 AI 기반 웹 크롤러로, 웹사이트를 깔끔하고 LLM(Long Library Management)에 적합한 데이터로 변환합니다.
하지만 대부분의 사용자는 이 다재다능한 도구가 할 수 있는 일의 극히 일부만을 활용할 뿐입니다.
이 가이드는 모든 주요 기능을 단계별로 사용하는 방법을 스크린샷과 함께 보여줍니다.
파이어크롤 튜토리얼
이 완벽한 Firecrawl 튜토리얼은 첫 API 키 생성부터 고급 배치 작업에 이르기까지 모든 기능을 단계별로 안내하여 여러분을 파워 유저로 만들어 드립니다.
파이어크롤
Firecrawl은 단일 API를 사용하여 모든 웹사이트를 깔끔하고 구조화된 데이터로 변환합니다. JavaScript 렌더링, 속도 제한 및 URL 검색을 처리하여 LLM(Long-Term Management)에 바로 사용할 수 있는 데이터를 빠르게 얻을 수 있도록 지원합니다. 무료 플랜으로 시작해 보세요. 신용 카드 정보는 필요하지 않습니다.
Firecrawl 시작하기
어떤 기능을 사용하기 전에 먼저 이 일회성 설정을 완료하십시오.
약 3분 정도 걸립니다.
먼저 이 간단한 개요 영상을 시청하세요.
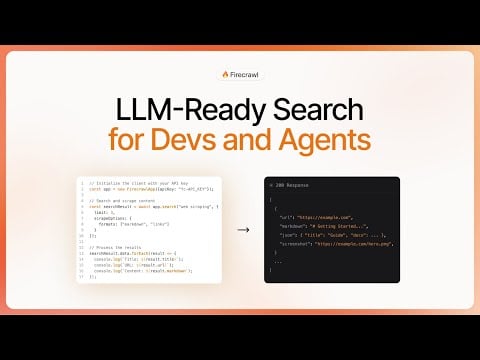
이제 각 단계를 하나씩 살펴보겠습니다.
1단계: 계정 생성
Firecrawl 웹사이트(https://www.firecrawl.dev)로 이동하세요.
무료 플랜으로 Firecrawl 계정을 만들려면 '가입하기'를 클릭하세요.
이메일 주소를 입력하고 비밀번호를 만드세요.
✓ 검문소: 확인하세요 받은 편지함 확인 이메일을 보내드립니다.
2단계: API 키를 설치하고 설정하세요
`pip install firecrawl-py` 명령어를 실행하여 API 서비스를 프로젝트에 추가하세요.
API 키를 복사한 다음 환경 변수로 저장하세요. 보안.
대시보드는 다음과 같습니다.
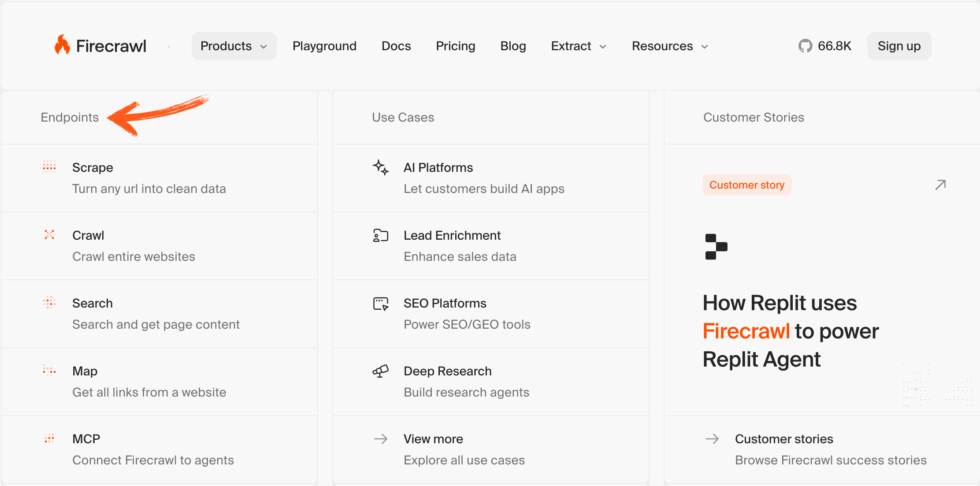
✓ 검문소: 메인 대시보드에서 사용량과 API 키를 확인할 수 있습니다.
3단계: 첫 번째 전화 걸기
FirecrawlApp 클래스를 임포트하고 키를 사용하여 Firecrawl 인스턴스를 생성합니다.
모든 요청은 https://api.firecrawl.dev/v2에 있는 기본 엔드포인트로 전달됩니다.
✅ 완료: 이제 데이터를 스크래핑, 크롤링, 검색, 매핑 및 추출할 준비가 되었습니다.
파이어크롤 스크레이퍼 사용 방법
긁다 이 기능을 사용하면 단 한 번의 API 호출로 단일 페이지에서 깔끔하고 LLM에서 바로 사용할 수 있는 데이터를 가져올 수 있습니다.
스크랩 모드는 개별 페이지를 대상으로 하며 특정 정보를 빠르게 추출하는 데 이상적입니다.
다음은 단계별 사용 방법입니다.
이제 각 단계를 자세히 살펴보겠습니다.
1단계: API 키를 받으세요
Firecrawl 계정을 생성한 다음 대시보드에서 API 키를 복사하세요.
API 키가 코드에 직접 노출되지 않도록 환경 변수로 저장하세요.
2단계: 스크래핑 엔드포인트를 호출합니다.
Firecrawl 인스턴스의 .scrape_url() 메서드에 단일 URL을 전달하세요.
출력 형식으로 마크다운, 원시 HTML 또는 구조화된 JSON을 요청할 수 있습니다.
이것이 어떤 모습인지 보여드리겠습니다:
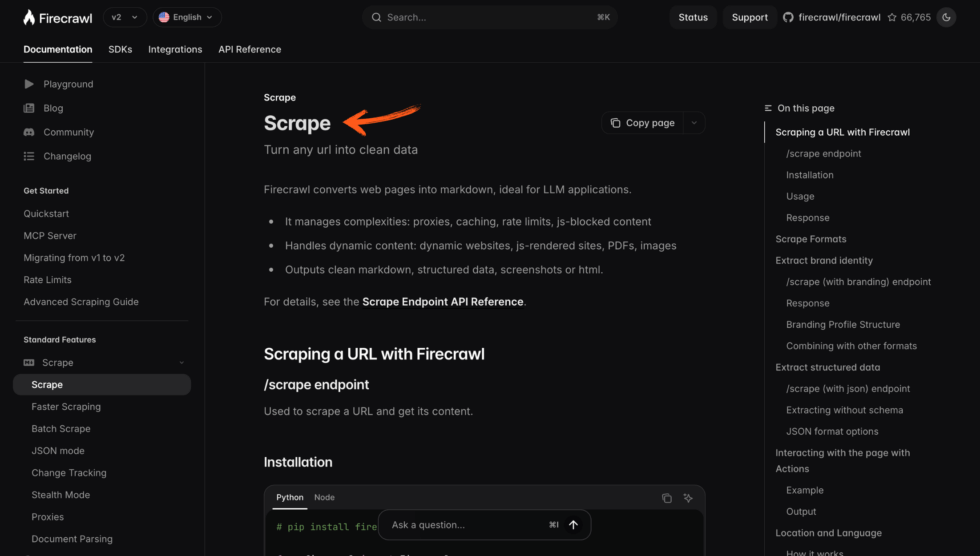
✓ 검문소: 현재 페이지의 마크다운 형식이 깔끔하게 정리되어 AI 애플리케이션에서 바로 사용할 수 있는 상태인지 확인하세요.
3단계: 정리된 출력 결과를 읽습니다.
Firecrawl은 읽기 쉬운 형태로 깔끔한 데이터를 반환합니다. 텍스트불필요한 HTML 태그가 제거되었습니다.
✅ 결과: 단일 API를 사용하여 웹 페이지 중 하나를 구조화된 웹 데이터로 변환했습니다.
💡 꿀팁: max_age 매개변수를 설정하여 결과를 캐시하고 변경되지 않은 페이지의 재스크래핑을 건너뛸 수 있습니다.
Firecrawl Crawler 사용 방법
기다 사이트맵 없이도 웹사이트 전체를 크롤링하고 링크를 자동으로 따라갈 수 있습니다.
크롤링 모드를 사용하면 여러 페이지에 걸쳐 웹사이트를 크롤링하고 접근 가능한 모든 페이지를 수집할 수 있습니다.
다음은 단계별 사용 방법입니다.
이제 각 단계를 자세히 살펴보겠습니다.
1단계: 루트 URL을 지정합니다.
크롤링 엔드포인트에 https://example.com과 같은 시작 URL을 지정하세요.
Firecrawl은 링크를 통해 웹 크롤링을 처리하고 자체적으로 페이지를 추적합니다.
2단계: 크롤링 작업 시작
크롤링 작업을 시작하고 반환된 작업 ID를 가져와 진행 상황을 추적하세요.
작업 ID를 사용하여 페이지 로드가 완료될 때마다 상태를 확인하고 크롤링된 데이터를 가져옵니다.
이것이 어떤 모습인지 보여드리겠습니다:
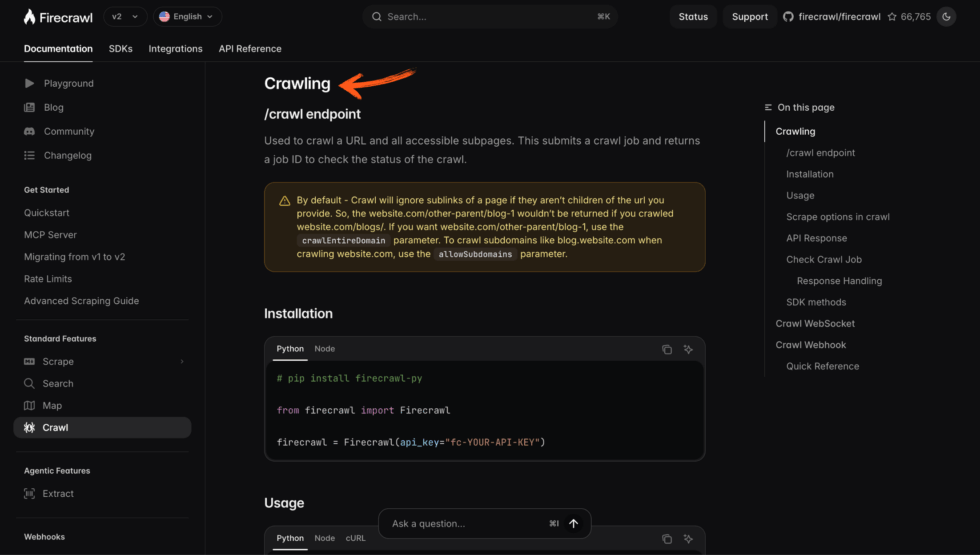
✓ 검문소: 사이트 전체에서 스크랩된 페이지들이 웹 데이터에 통합되는 것을 확인할 수 있을 것입니다.
3단계: 결과 내보내기
데이터 파이프라인을 위해 모든 페이지를 마크다운 또는 구조화된 JSON 형식으로 수집하세요.
✅ 결과: 복잡한 동적 콘텐츠가 포함된 웹사이트를 포함하여 전체 사이트를 캡처할 수 있습니다.
💡 꿀팁: Firecrawl은 배치 처리와 동시 브라우저 사용을 통해 대규모 크롤링 작업도 빠른 속도로 처리합니다.
Firecrawl 검색 엔진 사용 방법
찾다 웹을 검색하고 AI 에이전트에 바로 입력할 수 있는 깔끔한 결과를 반환할 수 있습니다.
검색 기능을 사용하면 웹에 쿼리를 입력하고 실시간 웹 데이터를 읽기 쉬운 텍스트 형식으로 가져올 수 있습니다.
다음은 단계별 사용 방법입니다.
이제 각 단계를 자세히 살펴보겠습니다.
1단계: 문의 보내기
검색 엔드포인트를 일반 자연어 쿼리로 호출합니다.
Firecrawl은 뉴스 웹사이트, 구인 게시판, 리뷰 사이트 등 다양한 웹 사이트를 검색할 수 있습니다.
2단계: 출력 형식 선택
각 결과에 대해 마크다운 형식 또는 구조화된 JSON 형식으로 요청하세요.
모든 결과는 노이즈가 섞인 원시 HTML이 아닌, 깔끔한 데이터 형태로 제공됩니다.
이것이 어떤 모습인지 보여드리겠습니다:
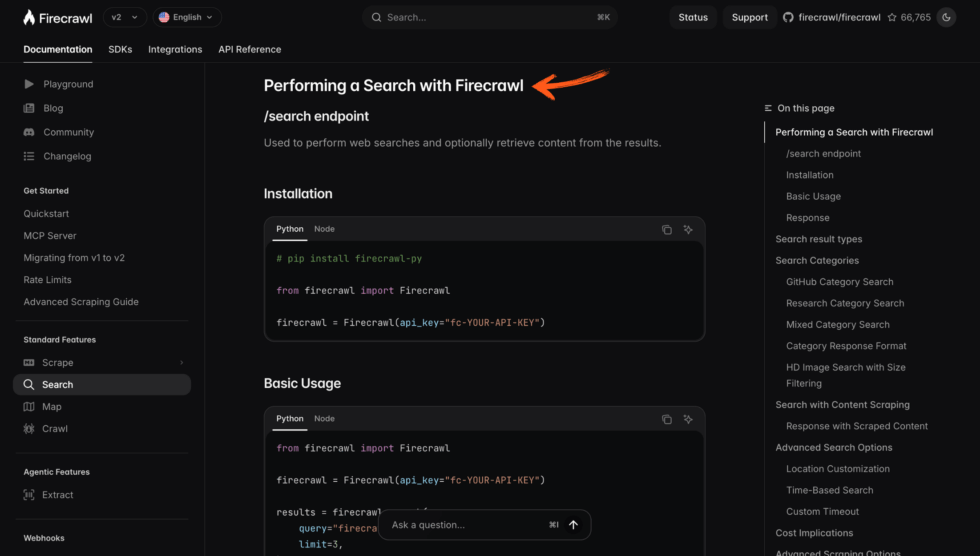
✓ 검문소: 순위가 매겨진 웹 페이지가 구조화된 웹 데이터 형태로 반환되는 것을 확인할 수 있습니다.
3단계: 앱에 파이프라인 연결
구조화된 데이터를 입력하세요 AI 어시스턴트 또는 AI 워크플로우.
✅ 결과: 단 한 번의 API 호출로 AI 애플리케이션에 실시간 웹 콘텐츠를 추가했습니다.
💡 꿀팁: 검색과 추출 기능을 함께 사용하여 시장 조사 또는 경쟁 정보 수집을 위한 뉴스 기사를 수집하세요.
Firecrawl 고급 지도 사용 방법
지도 이 기능을 사용하면 URL 검색을 실행하여 하나의 도메인을 개별 페이지의 전체 지도로 변환할 수 있습니다.
지도 모드는 사이트의 모든 URL을 신속하게 검색하여 빠른 URL 탐색을 가능하게 합니다.
다음은 단계별 사용 방법입니다.
이제 각 단계를 자세히 살펴보겠습니다.
1단계: 도메인 제출
지도 엔드포인트에 루트 URL 하나만 전달하세요.
Firecrawl은 사이트맵 없이도 모든 링크를 반환합니다.
2단계: URL 목록 검토
스크래핑하기 전에 반환된 개별 페이지를 스캔하세요.
데이터 추출 계획을 세우기 위해 목록을 CSV 파일로 저장하세요.
이것이 어떤 모습인지 보여드리겠습니다:
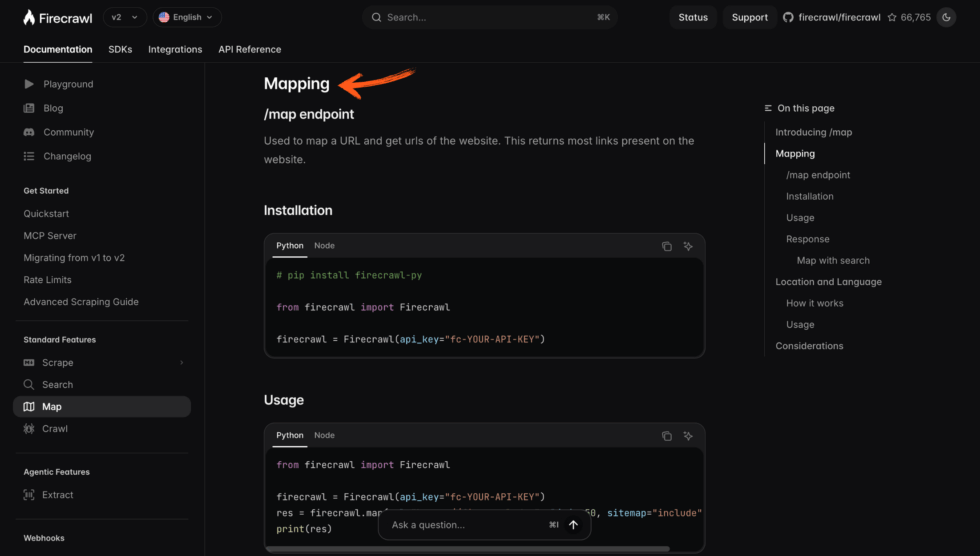
✓ 검문소: 하나의 URL에서 웹페이지 전체 사이트맵을 볼 수 있어야 합니다.
3단계: 스크랩할 항목 선택
원하는 페이지를 선택한 다음 스크래핑 또는 크롤링 작업을 수행하도록 보내세요.
✅ 결과: 사이트 전체를 매핑하여 타겟팅 웹 스크래핑을 위한 준비를 마쳤습니다.
💡 꿀팁: 동적 웹사이트 및 웹 앱에서 먼저 매핑하여 필요 없는 페이지에 크레딧이 낭비되는 것을 방지하세요.
Firecrawl Extractor 사용 방법
발췌 자연어 프롬프트를 사용하여 모든 페이지에서 구조화된 데이터를 추출할 수 있습니다.
Extract는 AI 기반 구문 분석을 사용하여 사용자가 설명한 필드를 정확하게 추출합니다.
다음은 단계별 사용 방법입니다.
이제 각 단계를 자세히 살펴보겠습니다.
1단계: 스키마 정의
`from pydantic import BaseModel`을 사용하여 Pydantic 모델을 작성하세요.
스키마 기반 추출은 Firecrawl에게 어떤 필드를 구조화된 JSON으로 반환해야 하는지 알려줍니다.
2단계: 데이터 설명
스키마에서 캡처할 수 없는 필드에 대해 자연어 프롬프트를 추가합니다.
이것이 바로 구문 분석 규칙을 작성하지 않고 웹 페이지에서 데이터를 추출하는 방법입니다.
이것이 어떤 모습인지 보여드리겠습니다:
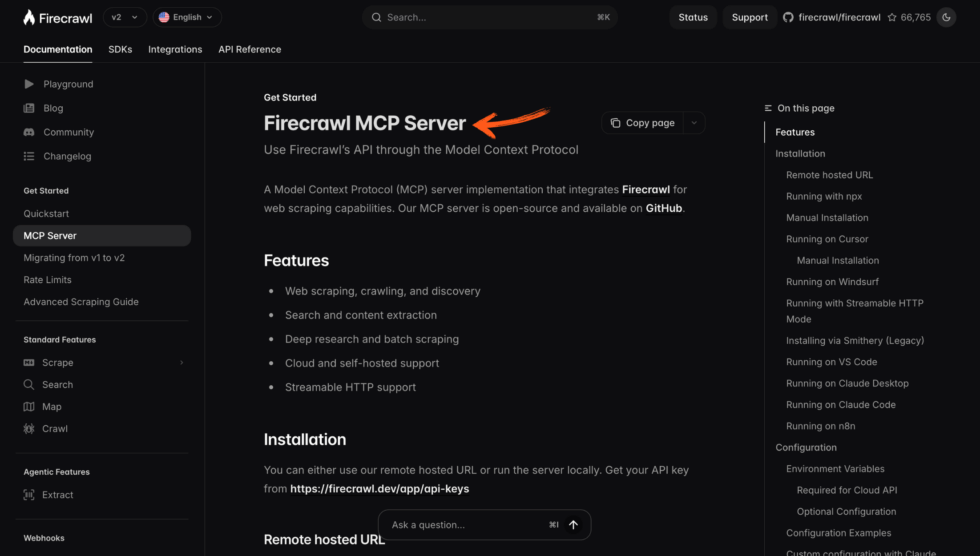
✓ 검문소: 지저분한 HTML 태그 대신 깔끔하게 구조화된 데이터가 표시되어야 합니다.
3단계: 구조화된 JSON 수신
Firecrawl은 학습 데이터에 바로 사용할 수 있는 깔끔하고 구조화된 JSON을 반환합니다.
✅ 결과: 취약한 스크래퍼를 단일 추출 호출과 간소화된 데이터 정리 방식으로 대체했습니다.
💡 꿀팁: 추출된 웹 데이터의 초점을 유지하려면 only_main_content, include_tags 및 exclude_tags 옵션을 사용하세요.
Firecrawl 전문가 팁 및 단축키
1년 넘게 Firecrawl을 사용해 본 결과, 더욱 깔끔한 데이터 추출을 위한 최고의 팁을 공유합니다.
키보드 단축키
| 행동 | 지름길 |
|---|---|
| 놀이터에서 긁힘 자국을 내다 | Ctrl + Enter |
| API 키 복사 | Ctrl + C |
| 오픈도구 | Ctrl + K |
| 출력 형식을 전환합니다. | 꼬리표 |
대부분의 사람들이 놓치는 숨겨진 기능들
- max_age 캐싱: 최근에 크롤링한 데이터를 재사용하여 더 빠르고 저렴하게 반복 스크래핑하세요.
- 브라우저 작업: 클릭, 스크롤, 입력 등을 통해 자바스크립트 렌더링 뒤에 숨겨진 콘텐츠에 접근할 수 있습니다.
- 비동기 배치 처리: 웹 앱 차단 없이 일괄 처리를 통해 수천 개의 URL을 처리하세요.
화재 현장 탐사 시 흔히 저지르는 실수, 피해야 할 것들
실수 #1: API 키를 하드코딩하는 것
❌ 틀림: API 키를 공유 코드나 공개 저장소에 직접 붙여넣는 행위.
✅ 오른쪽: 환경 변수에서 키를 불러와서 개인 정보 보호를 강화합니다.
두 번째 실수: 매핑 전에 크롤링을 하는 것
❌ 틀림: 웹사이트 전체를 묻지도 따지지도 않고 크롤링하며 쓸모없는 페이지에 크레딧을 낭비하는 행위.
✅ 오른쪽: 먼저 맵을 사용하여 URL 검색을 실행한 다음 필요한 페이지만 크롤링하세요.
실수 #3: HTML 원본을 직접 파싱하는 것
❌ 틀림: HTML 원본을 정리하고 HTML 태그를 수동으로 제거하기 위해 불안정한 규칙을 작성합니다.
✅ 오른쪽: 스키마 기반 추출을 사용하여 깔끔하고 구조화된 JSON을 직접 얻으세요.
Firecrawl 문제 해결
문제: 401 권한 없음 오류
원인: API 키가 없거나 환경 변수에서 불러와지지 않았습니다.
고치다: 키를 다시 내보낸 다음 Firecrawl 인스턴스를 다시 생성하고 다시 시도하십시오.
문제: 복잡한 웹사이트에서 타임아웃 오류 발생
원인: 자바스크립트 렌더링이 많거나 동적 콘텐츠를 표시하면 로딩 시간이 더 오래 걸립니다.
고치다: 현재 페이지 로딩이 완료될 때까지 기다렸다가 캡처하는 동작을 추가하세요.
문제: 요청 제한에 도달함
원인: 무료 플랜이나 그보다 낮은 등급의 플랜에서 한 번에 너무 많은 요청을 하면 오류가 발생할 수 있습니다.
고치다: 배치 작업 속도가 느리거나 동시 접속 브라우저 수가 많아지면 업그레이드가 필요할 수 있습니다.
📌 메모: 이러한 방법으로도 문제가 해결되지 않으면 Firecrawl 지원팀에 문의하십시오.
파이어크롤(Firecrawl)이란 무엇인가요?
파이어크롤 AI 기반 웹 스크래핑 도구로, 웹사이트를 깔끔하고 구조화된 데이터로 변환합니다.
웹 크롤러가 인공지능 에이전트에게 지저분한 원시 HTML 대신 읽기 쉬운 텍스트를 제공하는 것과 같다고 생각하면 됩니다.
Firecrawl은 Mendable.ai에서 AI 애플리케이션의 토큰 낭비를 줄이기 위해 개발되었습니다.
이 간단한 개요를 시청하세요:
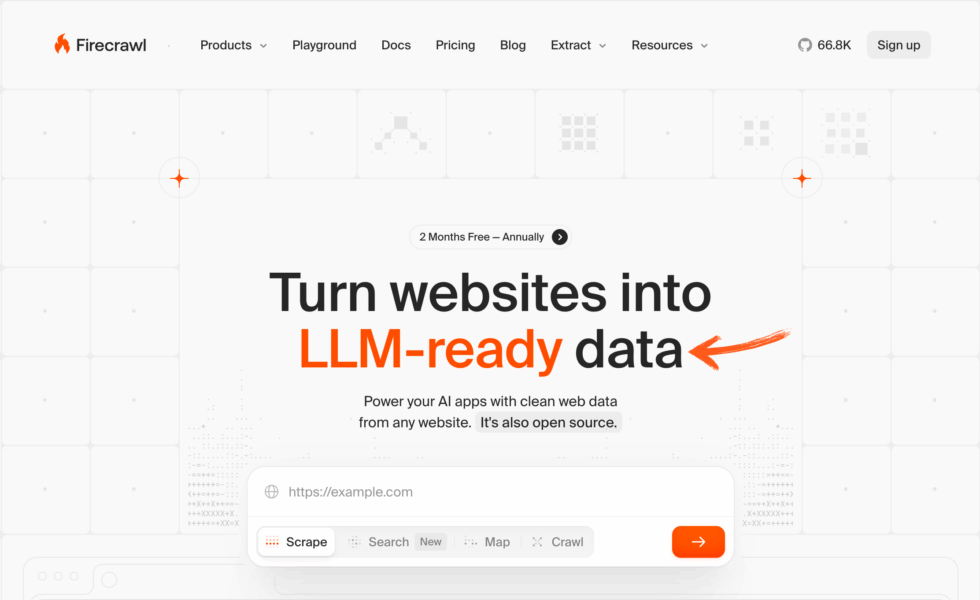
이 제품에는 다음과 같은 주요 기능이 포함되어 있습니다.
- 긁다: 웹 페이지별 데이터를 마크다운 형식 또는 구조화된 JSON 형식으로 추출합니다.
- 기다: 사이트맵 없이 웹사이트 전체를 크롤링하고 링크를 따라갑니다.
- 찾다: 뉴스 웹사이트와 리뷰 사이트에서 정제된 데이터를 검색하여 제공합니다.
- 지도: 하나의 도메인으로 전체 사이트맵을 생성하는 빠른 URL 검색 기능.
- 발췌: 자연어 프롬프트와 Pydantic 스키마를 사용하여 구조화된 웹 데이터를 추출합니다.
Firecrawl은 프록시, 속도 제한 및 자바스크립트 렌더링을 자동으로 처리하여 기존 웹 스크래핑 방식보다 뛰어난 성능을 제공합니다.
Selenium을 필요로 하는 기존 도구와 달리, 이 도구는 단일 API 서비스를 통해 데이터 과학자와 개발자에게 필요한 기능을 제공합니다.
자세한 내용은 저희 웹사이트를 참조하세요. 파이어크롤 리뷰.
파이어크롤 가격
다음은 2026년 Firecrawl의 가격입니다.
| 계획 | 가격 | 가장 적합한 대상 |
|---|---|---|
| 무료 | 무료 | 몇몇 페이지에서 스크래핑 및 크롤링 테스트를 진행합니다. |
| 취미 | 월 16달러 | 1인 개발자와 소규모 데이터 파이프라인 |
| 기준 | 월 83달러 | 정기적인 웹 크롤링 작업을 실행하는 팀 |
| 성장 | 월 333달러 | 대규모 시장 조사 및 모니터링 |
무료 체험: 네, 무료 플랜으로는 제한된 수의 페이지만 스크래핑할 수 있습니다.
환불 보장: 공식적인 보장은 없지만, 언제든지 다운그레이드할 수 있습니다.
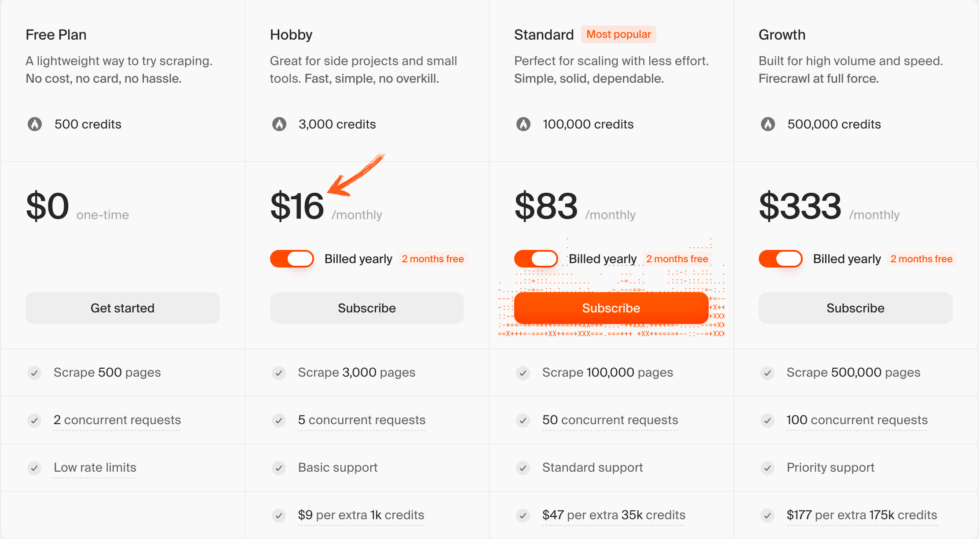
💰 최고의 가성비: 표준 — 대부분의 팀에게 크레딧과 동시 접속 브라우저 수의 최적의 균형을 제공합니다.
파이어크롤 vs 대안
Firecrawl은 다른 제품과 비교했을 때 어떤가요? 경쟁 구도는 다음과 같습니다.
| 도구 | 가장 적합한 대상 | 가격 | 평가 |
|---|---|---|---|
| 파이어크롤 | AI 활용에 적합한 깨끗한 데이터 | 월 16달러 | ⭐ 3.5 |
| 아피파이 | 사전 구축된 액터 | 월 49달러 | ⭐ 4.5 |
| 브라이트 데이터 | 프록시 스케일 | $ 사용자 정의 | ⭐ 4.6 |
| 크롤4AI | 오픈 소스 | 무료 | ⭐ 4.4 |
| 스크래피 | 파이썬 컨트롤 | 무료 | ⭐ 4.5 |
| 스크래프그래프AI | LLM 그래프 스크래핑 | 월 20달러 | ⭐ 4.3 |
빠른 추천:
- 종합 최고상: Firecrawl — 단일 API에서 가장 깔끔한 LLM 준비 데이터를 제공합니다.
- 최고의 가성비: Crawl4AI — 실무형 데이터 과학자를 위한 무료 오픈 소스 플랫폼입니다.
- 초보자에게 가장 적합: Firecrawl — 자연어 프롬프트가 어려운 부분을 숨겨줍니다.
- 프록시 확장에 가장 적합함: Bright Data - 복잡한 웹사이트를 위한 대규모 프록시 풀.
🎯 파이어크롤 대안
Firecrawl 대안을 찾고 계신가요? 최고의 옵션들을 소개합니다:
- 🚀 아피파이: 웹 스크래핑을 위한 사전 제작된 액터들을 모아놓은 마켓플레이스로, 단일 API를 통해 바로 사용할 수 있는 스크래퍼를 원할 때 유용합니다.
- 🏢 밝은 데이터: 대규모 크롤링 작업 및 동적 웹사이트 전반에 걸친 콘텐츠 모니터링을 위한 엔터프라이즈 프록시 네트워크입니다.
- 💰 Crawl4AI: 무료 오픈소스 크롤러로, LLM 형식에 맞는 데이터를 출력하며, 저예산 AI 워크플로우 및 로컬 실행에 적합합니다.
- 🔧 스크래피: 검증된 파이썬 프레임워크로 개발자에게 크롤링, 파싱 및 데이터 파이프라인에 대한 완벽한 제어 권한을 제공합니다.
- 🧠 스크래프그래프AI: 그래프 기반의 AI 기반 추출 방식으로, 페이지 구조를 매핑하여 스키마 기반 구조화 데이터 추출을 수행합니다.
전체 목록은 다음을 참조하세요. 파이어크롤 대안 가이드.
⚔️ 파이어크롤 비교
다음은 Firecrawl이 각 경쟁업체와 비교했을 때 어떤 위치에 있는지 보여주는 표입니다.
- Firecrawl과 Apify 비교: Firecrawl은 깔끔하고 llm 파일 처리 준비가 완료된 출력물에서 우위를 점하고, Apify는 미리 구축된 스크래퍼 라이브러리에서 우위를 점합니다.
- Firecrawl과 Bright Data 비교: Bright Data는 프록시 규모에서 우위를 점하고, Firecrawl은 보다 간단한 구조화된 데이터 추출에서 우위를 점합니다.
- Firecrawl과 Crawl4AI 비교: Crawl4AI는 가격과 자체 호스팅 측면에서 우위를 점하고, Firecrawl은 관리형 접속량 제한과 안정성 측면에서 우위를 점합니다.
- 파이어크롤 vs 스크래피: Scrapy는 낮은 수준의 컨트롤에서 승리하고, Firecrawl은 속도와 프록시 설정이 필요 없는 점에서 승리합니다.
- Firecrawl과 ScrapeGraphAI 비교: 둘 다 AI 기반이지만, Firecrawl은 크롤링 범위에서, ScrapeGraphAI는 그래프 로직에서 우위를 점합니다.
지금 바로 Firecrawl을 사용해 보세요
Firecrawl의 주요 기능을 모두 사용하는 방법을 배웠습니다.
- ✅ 긁어내다
- ✅ 기어가기
- ✅ 검색
- ✅ 지도
- ✅ 추출
다음 단계: 기능 하나를 선택해서 지금 바로 사용해 보세요.
대부분의 사람들은 Scrape로 시작합니다.
5분도 채 걸리지 않습니다.
자주 묻는 질문
Firecrawl은 무엇에 사용되나요?
Firecrawl은 AI 기반 웹 스크래핑 도구입니다. 웹 페이지를 AI 에이전트, RAG 시스템, 시장 조사 및 가격 모니터링에 사용할 수 있는 깔끔하고 LLM(라일 라이프사이클 관리)에 적합한 데이터로 변환합니다.
Firecrawl을 무료로 사용할 수 있나요?
네. 무료 플랜을 사용하면 API 키로 제한된 수의 페이지를 스크래핑할 수 있으므로, 결제 전에 스크래핑, 크롤링 및 데이터 추출 기능을 테스트해 볼 수 있습니다.
Firecrawl은 어떻게 설치하나요?
`pip install firecrawl-py` 명령을 실행한 다음, API 키를 환경 변수로 설정하고 Firecrawl 인스턴스를 생성하여 첫 번째 API 호출을 시작하세요.
Firecrawl은 기존 스크래핑 방식과 어떻게 다른가요?
기존 웹 스크래핑 방식은 Selenium과 수동 프록시 설정이 필요합니다. Firecrawl은 하나의 API 서비스를 통해 자바스크립트 렌더링, 속도 제한, 데이터 정리 등을 자동으로 처리합니다.
Firecrawl은 구조화된 데이터를 추출할 수 있습니까?
예. 자연어 프롬프트 또는 Pydantic 스키마를 사용하여 스키마 기반 추출을 수행하면 Firecrawl은 원시 HTML 대신 구조화된 JSON을 반환합니다.













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
