
クイックスタート
このガイドでは、Webスクレイパーのすべての機能について説明します。
- はじめる — アカウント作成と基本設定
- ポイントアンドクリックインターフェースの使い方 — コードを書かずに視覚的にスクレイパーを構築
- 抽出データの使用方法 — サイト上の任意のページから構造化データを取得する
- Handle JavaScriptサイトの使い方 — JavaScriptでコンテンツを読み込む動的ページをスクレイピングする
- カスタマイズデータの使用方法 エクスポート前に、スクレイピングした行を調整してクリーンアップします。
- エクスポートデータの使用方法 結果をCSVファイル、XLSXファイル、またはJSONファイルとして保存します。
所要時間: 各作品につき5分
このガイドには以下の内容も含まれています。 プロのヒント | よくある間違い | トラブルシューティング | 価格 | 代替案
このガイドを信頼する理由
私はWeb Scraperを6ヶ月以上使用し、このチュートリアルで紹介するすべての機能をテストしました。この記事は、マーケティングのための誇張表現ではなく、実際の使用経験に基づいています。

Web Scraper は、ブラウザベースの初心者向けガイドツールの中でも最も使いやすいものの 1 つです。 データ 抽出。
しかし、ほとんどのユーザーは、その機能のごく一部しか活用していない。
このガイドでは、ウェブスクレイパーの使い方をステップバイステップで説明します。
すべての機能について、スクリーンショットと役立つヒントが添えられています。
ウェブスクレイピングチュートリアル
このWebスクレイパーの使い方に関する完全チュートリアルでは、初期設定から高度なテクニックまで、すべての機能をステップバイステップで解説し、パワーユーザーになるためのノウハウを提供します。
ウェブスクレイパー
ブラウザから直接、コード不要でウェブサイトをスクレイピングできます。Web Scraperを使えば、あらゆるウェブサイトからデータを抽出し、CSV、XLSX、JSON形式でエクスポートできます。無料で始められます。クレジットカードは不要です。
ウェブスクレイパー入門
いずれかの機能を使用する前に、この初回設定を完了してください。
約3分かかります。
まずはこちらの簡単な概要をご覧ください。
それでは、各ステップを順を追って見ていきましょう。
ステップ1:アカウントを作成する
ブラウザでWeb Scraperのウェブサイト(https://webscraper.io/)にアクセスしてください。
「サインアップ」または「無料トライアルを開始」をクリックしてください。
アカウントを設定するには、メールアドレスを入力し、パスワードを作成してください。
✓ チェックポイント: チェックしてください 受信トレイ 確認メールをお送りします。
ステップ2:ブラウザ拡張機能をインストールする
Chromeウェブストアを開き、「Web Scraper」を検索して拡張機能を見つけてください。
「Chromeに追加」をクリックしてダウンロードを確認してください。
この拡張機能は、Windows、macOS、Linuxのデスクトップ環境でも動作します。
ダッシュボードの画面は以下のようになります。
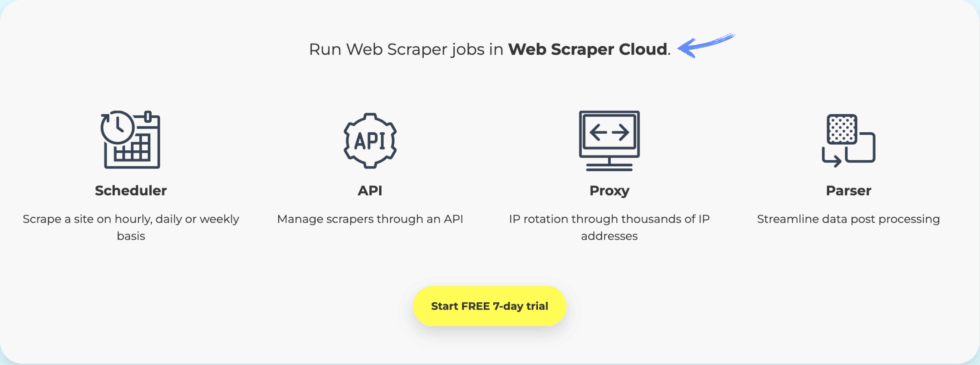
✓ チェックポイント: DevToolsに「Webスクレイパー」タブが表示されるはずです。
ステップ3:初期設定を完了する
DevTools(F12)を開き、「Web Scraper」タブをクリックしてインターフェースを読み込みます。
スクレイピングしたいサイトのURLを貼り付けて、最初のサイトマップを作成してください。
✅ 完了: これで、以下のすべての機能をご利用いただけます。
Webスクレイパーのポイントアンドクリックインターフェースの使い方
ポイントアンドクリックインターフェース ページ上の適切な要素を選択することで、視覚的にスクレイパーを作成できます。
以下に、その使用方法をステップごとに説明します。
ステップ1:サイトマップエディターを開く
ブラウザで、スクレイピングしたいサイトにアクセスしてください。
DevToolsを開き、「Webスクレイパー」タブをクリックして開始します。
ステップ2:要素を視覚的に選択する
「新しいセレクタを追加」をクリックして、セレクタの種類を選択してください。
スクレイピングしたいページ要素を直接クリックしてください。
Web Scraperは適切な要素をハイライト表示し、CSSセレクターを提案します。
例えば、商品名をクリックすると、対応するセレクターが自動的に生成されます。
これがその様子です。
✓ チェックポイント: 選択した要素に緑色のハイライトが表示されるはずです。
ステップ3:セレクターを保存する
「選択完了」をクリックし、次に「セレクタを保存」を押して確定します。
スクレイパーは、各ページ上の要素を見つけるためのCSSセレクターパターンを保存します。
✅ 結果: ビジュアルスクレイパーを使えば、コードを書かずにデータを抽出できます。
💡 プロのヒント: フルスクレイピングを実行する前に、「要素プレビュー」を使用してセレクタが正しいデータを取得していることを確認してください。
Webスクレイパーを使用してデータを抽出する方法
データの抽出 あらゆるウェブページから構造化データを自動的に抽出できます。
以下に、その使用方法をステップごとに説明します。
ステップ1:セレクターを設定する
各データポイントのセレクターを設定する — 文章リンク、画像、またはHTMLヘッダー。
セレクタツリーを使用して、ページ構造内のネストされた要素をナビゲートします。
ステップ2:スクレイピングを実行する
「スクレイピング」をクリックし、リクエスト間隔とページ読み込み遅延を設定してください。
スクレイパーは各URLにリクエストを送信し、データ抽出プロセスを開始します。
これがその様子です。
✓ チェックポイント: プレビュー画面に抽出されたデータの行が表示されるはずです。
ステップ3:結果を確認する
クリック“ブラウズ抽出したデータをテーブルビューで確認します。
すべての列が、収集したいデータと一致していることを確認してください。
✅ 結果: エクスポート可能な、整理された構造化データが準備できました。
💡 プロのヒント: ターゲットウェブサイトのレート制限に引っかからないように、リクエスト間に2秒の遅延を設定してください。
Webスクレイパーを使用してJavaScriptサイトを処理する方法
JavaScriptサイトを処理する JavaScriptを使用してコンテンツを読み込む動的なページをスクレイピングできます。
以下に、その使用方法をステップごとに説明します。
ステップ1:動的コンテンツを特定する
ノードツリーを監視することで、ページが最初のHTMLの後にデータを読み込んでいるかどうかを確認します。
どのHTML要素が遅れて読み込まれるかを確認するには、HTML要素を手動で操作する必要がある場合があります。
コンテンツがJavaScriptの実行後にのみ表示される場合は、この機能が必要です。
ステップ2:JavaScriptレンダリングを有効にする
Web Scraper Cloudでは、サイトマップ設定で「完全なJavaScriptレンダリング」を選択してください。
スクレイピングが開始される前にすべての要素が完全にレンダリングされるように、ページ読み込みの待機時間を設定してください。
これがその様子です。
✓ チェックポイント: プレビューには、動的に読み込まれたコンテンツが表示されるはずです。
ステップ3:テストと実行
スクリプトがすべての要素をキャプチャしていることを確認するために、単一ページに対してテストスクレイピングを実行してください。
検証が完了したら、サイト上のすべての対象ページに対して完全なスクレイピングを実行します。
✅ 結果: これで、JavaScriptを多用するサイトからプロのようにデータを抽出できます。
💡 プロのヒント: サイトが無限スクロールを使用している場合は、スクレイピングを開始する前にすべてのコンテンツを読み込むために「スクロールダウン」セレクタを追加してください。
Webスクレイパーを使用してデータをカスタマイズする方法
データのカスタマイズ スクレイピングしたデータを保存する前に、調整、クリーニング、および変更を行うことができます。
以下に、その使用方法をステップごとに説明します。
ステップ1:データプレビューを開く
スクレイピングが完了したら、「参照」をクリックして生データテーブルを表示します。
各列を確認し、整理が必要な行をメモしてください。
ステップ2:正規表現またはテキストフィルターを適用する
セレクターの「Regex」オプションを使用して、不要なテキストを解析および削除します。
これは基本的に、データをその場でクリーンアップする柔軟なパターンマッチングです。
これがその様子です。
✓ チェックポイント: これで、データ列にはクリーンな値のみが表示されるはずです。
ステップ3:列の名前変更と並べ替え
セレクタ名を編集して、各列に分かりやすく親しみやすいヘッダーラベルを付けましょう。
サイトマップ内のセレクターの順序を、最終的な出力構造に合わせて変更してください。
✅ 結果: データは整理され、ラベル付けされており、エクスポートまたは分析の準備ができています。
💡 プロのヒント: セレクターの「複数」チェックボックスを使用すると、一致するすべての要素が出力で別々の行として取得されます。
Webスクレイパーのエクスポートデータの使用方法
データのエクスポート スクレイピングした結果をCSVファイル、XLSXファイル、またはJSONファイルとして保存できます。
以下に、その使用方法をステップごとに説明します。
ステップ1:削り残しを仕上げる
スクレイピングが完了するまで待ってから、「参照」をクリックしてデータをプレビューしてください。
すべての行と列に、期待どおりの値が含まれていることを確認してください。
ステップ2:エクスポート形式を選択する
エクスポートボタンをクリックし、フォーマット一覧からCSV、XLSX、またはJSONを選択してください。
ほとんどのユーザーにとって、CSVは最も柔軟で広くサポートされている形式です。
これがその様子です。
✓ チェックポイント: ブラウザにダウンロードを促すメッセージが表示されるはずです。
ステップ3:ファイルを保存する
コンピューター上のフォルダーを選択し、エクスポートしたファイルを保存してください。
Excel、Googleスプレッドシート、またはCSVファイルを読み込めるツールでファイルを開き、データを確認して印刷してください。
✅ 結果: 収集したデータはローカルに保存され、すぐに使用できます。
💡 プロのヒント: Web Scraper Cloudでは、APIまたはWebhookを使用して、エクスポートしたデータをDropboxまたはGoogle Driveに自動的に送信できます。
ウェブスクレイパーのプロ向けヒントとショートカット
Web Scraperを6ヶ月以上テストした結果、私が得た最高のヒントをご紹介します。
フォーラムでのユーザーからのフィードバックによると、これらのショートカットが最も時間を節約できることが確認されています。
キーボードショートカット
| アクション | ショートカット |
|---|---|
| 開発者ツールを開く | F12 |
| 要素を検査する | Ctrl + Shift + C |
| コンソールの切り替え | ESC |
| ページを再読み込み | Ctrl + R |
ほとんどの人が見逃す隠れた機能
- サイトマップのインポート/エクスポート: JSONサイトマップをコピー&ペーストすることで、スクレイパーをすばやく複製したり、プロジェクトフォルダ内の投稿としてチームと共有したりできます。
- ページネーションセレクター: 「次へ」ボタンにリンクセレクターを追加して、複数ページの検索結果を自動的にナビゲートし、すべてのページをスクレイピングします。
- スケジュールされたスクレイピング: Web Scraper Cloud を使用すると、設定したスケジュールでスクレイピングを実行し、最新のデータを受信ボックスまたはサービス Webhook に配信できます。
ウェブスクレイピングでよくある間違いを避ける方法
間違いその1:遅延なしに速すぎるスクレイピング
❌ 間違い: 遅延なくスクレイピングを実行すると、IPアドレスのブロックやサーバーからのエラー応答が発生します。
✅ 右: 人間のブラウジングパターンを模倣するため、リクエスト間の最小遅延時間を2000ミリ秒に設定してください。
間違いその2:間違ったセレクタータイプを使用している
❌ 間違い: 要素から href リンク値や画像 URL を抽出する必要がある場合は、「Text」セレクタを使用します。
✅ 右: セレクターの種類をデータに合わせてください。URLには「Link」、画像には「Image」を使用します。
間違いその3:robots.txtのルールを無視する
❌ 間違い: robots.txtによってブロックされたページをスクレイピングすることは、企業にとって法的問題につながる可能性があります。
✅ 右: スクレイピングを行う前に、必ずrobots.txtファイルを確認して、法令遵守を徹底し、問題の発生を回避してください。
ウェブスクレイパーのトラブルシューティング
問題:スクレイパーが空のデータを返す
原因: CSSセレクタは、ページ上に既に存在しない要素を対象としています。
修理: ブラウザでページを再確認し、セレクタを更新して、テストスクレイピングを実行してください。
問題: JavaScriptコンテンツが読み込まれない
原因: 無料のブラウザ拡張機能は、JavaScriptが必要なページでJavaScriptを実行できません。
修理: 動的なサイト向けに完全なJavaScriptレンダリングをサポートするWeb Scraper Cloudに切り替えましょう。
問題:スクレイピング中にIPアドレスがブロックされる
原因: 短時間にあまりにも多くのリクエストを送信すると、ターゲットサイトのアンチボット保護機能が作動します。
修理: 遅延設定を少なくとも3秒に増やし、可能であればプロキシローテーションを使用してください。
📌 注記: これらの方法で問題が解決しない場合は、Web Scraperのサポートにお問い合わせいただき、具体的な問題に対する回答をお求めください。
ウェブスクレイパーとは何ですか?
ウェブスクレイパー ウェブ 削り取りツール ブラウザを使ってあらゆるウェブサイトからデータを抽出できる機能です。
ウェブ全体を対象とした、データを行と列に整理するスマートなコピー&ペーストツールのようなものだと考えてください。
こちらの簡単な概要をご覧ください。
主な機能は以下のとおりです。
- ポイントアンドクリックインターフェース: Pythonやその他のコードを書かずに、視覚的にスクレイパーを構築します。
- データ抽出: 任意のウェブページからテキスト、リンク、画像URLを自動的に抽出します。
- JavaScriptサイトを処理する: JavaScriptまたはAjaxリクエストを介して読み込まれる動的コンテンツをスクレイピングする
- データのカスタマイズ: 保存する前に、スクレイピングした出力をクリーンアップ、フィルタリング、および変更します。
- データのエクスポート: ワンクリックで結果をCSV、XLSX、またはJSON形式でダウンロードできます。
詳細なレビューについては、こちらをご覧ください。 ウェブスクレイパーのレビュー.
ウェブスクレイパーの価格設定
2026年におけるWebスクレイパーのコストは以下のとおりです。
| プラン | 価格 | 最適な用途 |
|---|---|---|
| 無料 | 無料 | 一般ユーザーが小規模なスクレイピング作業をテスト |
| プロジェクト | 月額40ドル | フリーランサー 定期的なスクレイピングタスクを実行する |
| プロ | 月額80ドル | 複数の同時スクレイパーを必要とするチーム |
| 規模 | 月額167ドル | 大量データ抽出を扱う機関 |
| 企業 | カスタム | カスタムスクレイピングのニーズを持つ大企業 |
無料プラン: はい、ブラウザ拡張機能は完全に無料で、時間制限もありません。
返金保証: 有料プランの払い戻しをご希望の場合は、14日以内にサポートまでご連絡ください。
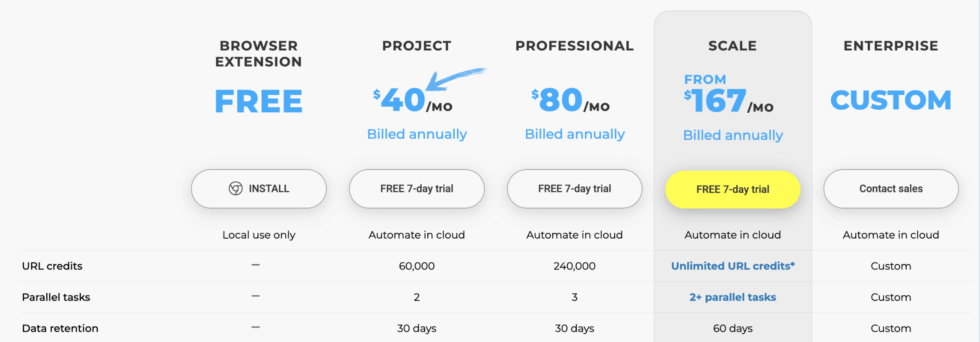
💰 最もお得な価格: プロジェクトプラン ― クラウドスクレイピングとスケジュール実行を最低価格で提供します。
ウェブスクレイパーと代替手段の比較
Web Scraperは他社と比べてどうでしょうか?競合状況は以下のとおりです。
| 道具 | 最適な用途 | 価格 | 評価 |
|---|---|---|---|
| ウェブスクレイパー | ブラウザベースのスクレイピング | 無料+ | ⭐ 3.5 |
| Octoparse | ノーコードビジュアルスクレイピング | 月額89ドル | ⭐ 4.3 |
| Parsehub | 複雑な多層構造のスクレイピング | 月額189ドル | ⭐ 4.2 |
| スクレイピー | 大規模なPython開発者 | 無料 | ⭐ 4.5 |
| アピファイ | 俳優を使ったクラウドスクレイピング | 月額49ドル | ⭐ 4.4 |
おすすめ商品:
- 総合ベスト: ウェブスクレイパー ― ほとんどのユーザーにとって無料プランと使いやすいブラウザ拡張機能
- ベスト予算: Scrapy ― Python開発者向けの完全無料のオープンソースツール
- 初心者におすすめ: Octoparse — ドラッグ&ドロップインターフェースと組み込みテンプレート
- クラウドスクレイピングに最適: Apify ― ウェブスクレイピングの世界における強力なアクターとAPIアクセス
🎯 ウェブスクレイパーの代替手段
ウェブスクレイパーの代替ツールをお探しですか?おすすめのツールをご紹介します。
- 🚀 オクトパース: 視覚的なワークフローを備えたノーコードスクレイパー ビルダーあらゆる規模の企業向けに、既製のテンプレートやクラウドサービスを提供しています。
- 💰 パースハブ: 多階層ナビゲーションとAJAX読み込みを備えた複雑なサイトにも対応し、コードを書かずに高度なデータ抽出を必要とするユーザーに最適です。
- 🔧 スクレイピー: 完全な制御、優れたSoupとの統合、そして大規模なスクレイピングを求める開発者向けに構築されたオープンソースのPythonフレームワーク。
- ⚡ Apify: 既製のスクレイパーが揃ったマーケットプレイスと、世界中の開発者やチーム向けの柔軟なAPIを備えたクラウドプラットフォーム。
全リストについては、こちらをご覧ください。 ウェブスクレイパーの代替手段 ガイド。
⚔️ ウェブスクレイパー比較
Web Scraperが各競合製品と比べてどうなのか、以下に比較してみましょう。
- Webスクレイパー vs Octoparse: Web Scraperは無料でブラウザネイティブなツールですが、Octoparseはデスクトップアプリとクラウドツールを備え、より大規模なプロジェクトに対応できる強力な機能を提供します。
- Webスクレイパー vs ParseHub: ParseHubはより詳細なサイトナビゲーションに対応していますが、Web Scraperは価格と手軽さで、1ページ分のデータを素早くスクレイピングするのに適しています。
- Webスクレイパー vs Scrapy: ScrapyはPythonスクリプトを介して開発者に完全な制御機能を提供しますが、Web Scraperは視覚的なアプローチを好む非プログラマーに適しています。
- ウェブスクレイパー vs Apify: Apifyはクラウドベースの オートメーション APIアクセスも利用できます。Web Scraperは、ブラウザにログインしてアクセスするだけのユーザーにとってよりシンプルです。
今すぐWebスクレイパーを使い始めましょう
あなたは、Webスクレイパーの主要な機能をすべて使いこなす方法を習得しました。
- ✅ ポイントアンドクリックインターフェース
- ✅ データ抽出
- ✅ JavaScriptサイトを処理する
- ✅ データのカスタマイズ
- ✅ データのエクスポート
次のステップ: どれか一つの機能を選んで、今すぐ試してみてください。
ほとんどの人は、ポイントアンドクリック方式のインターフェースから始めます。
5分もかかりません。
よくある質問
Web Scraperは無料で利用できますか?
はい。Web Scraperブラウザ拡張機能は無料です。有料のクラウドプランは、スケジュールされたスクレイピングとAPIアクセスが利用でき、月額40ドルからとなっています。
Web ScraperはJavaScriptでレンダリングされたページを処理できますか?
はい、ただしWeb Scraper Cloudのみで可能です。無料のブラウザ拡張機能ではJavaScriptは実行されません。クラウドプランでは完全なJavaScriptレンダリングがサポートされています。
Web Scraperはどのような形式でデータをエクスポートできますか?
Web Scraperを使用すると、データをCSV、XLSX、またはJSON形式でエクスポートできます。クラウドユーザーは、APIまたはWebhookを介してデータにアクセスすることもできます。
Web Scraperを使うにはプログラミングスキルが必要ですか?
いいえ。Web Scraperはポイント&クリック方式のインターフェースを採用しています。要素を視覚的に選択するだけで、Python、Beautiful Soup、その他のコードは一切必要ありません。
ウェブスクレイピングは合法ですか?
一般的には、公開されているデータであれば可能です。ただし、必ずサイトのrobots.txtと利用規約を確認してください。個人情報やプライベートデータのスクレイピングは避けてください。













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
