
Szybki start
W tym przewodniku dotyczącym korzystania ze ScrapingBee omówiono wszystkie funkcje:
- Rozpoczęcie pracy — Załóż konto i uzyskaj klucz API
- Jak korzystać z AI Web Scraping — wyciągaj złożone, ustrukturyzowane informacje ze stron internetowych, używając prostego języka angielskiego
- Jak korzystać z interfejsu API wyszukiwarki Google — zbieraj wyniki wyszukiwania Google bez samodzielnego zarządzania adresami IP serwerów proxy
- Jak korzystać z narzędzia Google Shopping Scraper — zbieraj listy produktów i wyodrębnione ceny dla dowolnego wyszukiwanego terminu
- Jak korzystać z JavaScript Web Scraping — obsługuj renderowanie JavaScript na stronach internetowych zbudowanych w React lub Vue
- Jak korzystać ze skrobaka ChatGPT — przechwytywanie odpowiedzi i źródła stron ze stron czatu dynamicznej sztucznej inteligencji
- Jak korzystać z interfejsu API Google News Scraper — pobieraj nagłówki i pełne artykuły za pomocą prostych żądań API
- Jak korzystać z szybkiego scrapowania danych — uruchom szybkie scrapowanie danych, podczas gdy ScrapingBee będzie obracał serwerami proxy za Ciebie
- Jak korzystać z API programowego zrzutu ekranu — programowo przechwyć zrzut ekranu całej strony dowolnego adresu URL
- Jak korzystać z Scrape Google Jobs — zbieraj oferty pracy jako złożone, ustrukturyzowane informacje
Czas potrzebny: 5 minut na każdy film
Również w tym przewodniku: Profesjonalne porady | Typowe błędy | Rozwiązywanie problemów | Wycena | Alternatywy
Dlaczego warto zaufać temu przewodnikowi
Używam ScrapingBee od ponad roku i przetestowałem każdą jego funkcję. Ten samouczek powstał na podstawie rzeczywistych, praktycznych doświadczeń, a nie zrzutów ekranu od dostawcy.

ScrapingBee to oparta na chmurze aplikacja narzędzie do skrobania który zajmuje się najtrudniejszymi częściami web scrapingu.
Zarządza przeglądarkami bez interfejsu użytkownika i zmienia serwery proxy.
W tym przewodniku dowiesz się krok po kroku, jak korzystać ze wszystkich głównych funkcji.
Zawiera zrzuty ekranu, prosty przykład i profesjonalne porady.
Samouczek ScrapingBee
Ten kompletny samouczek ScrapingBee przeprowadzi Cię przez każdą funkcję, od pierwszego żądania API po zaawansowane sztuczki JavaScript.
ScrapingBee
Scrapinguj dowolną stronę internetową bez zarządzania adresami IP proxy ani przeglądarek bez interfejsu graficznego. ScrapingBee obsługuje renderowanie JavaScript za pomocą jednego prostego interfejsu API REST. Uzyskaj 1000 darmowych wywołań API na początek — bez karty kredytowej.
Wprowadzenie do ScrapingBee
Przed użyciem jakiejkolwiek funkcji należy wykonać jednorazową konfigurację.
Zajmie to około trzech minut.
Oto krótki przegląd przepływu pracy:
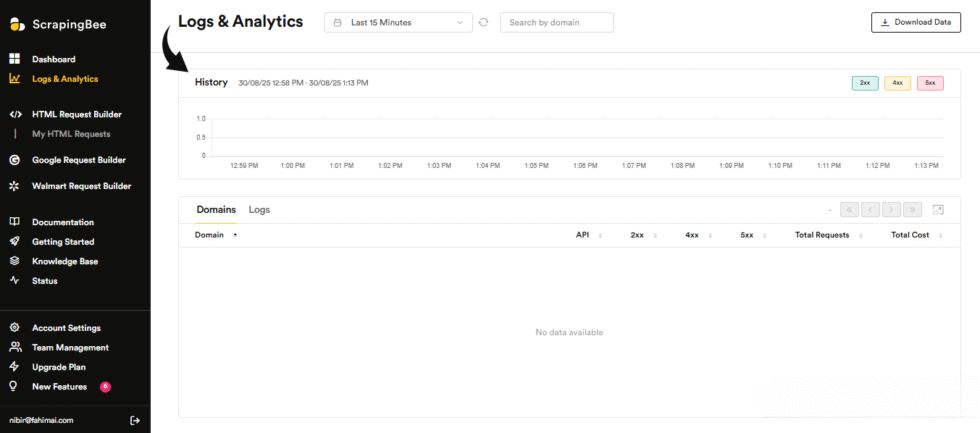
Przyjrzyjmy się teraz każdemu krokowi.
Krok 1: Utwórz swoje konto
Wejdź na stronę ScrapingBee i kliknij „Zarejestruj się”.
Wprowadź kod promocyjny ADNAN w linku polecającym, aby otrzymać dodatkowe środki API.
✓ Punkt kontrolny: Na Twoim pulpicie jest widoczny Twój unikalny klucz API.
Krok 2: Skonfiguruj swój kod
W Pythonie uruchom pip install scrapingbee lub po prostu import requests.
Biblioteka żądań pozwala na wywołanie API z dowolnego języka programowania.
✓ Punkt kontrolny: Twoje środowisko jest gotowe do wysyłania żądań API.
Krok 3: Wykonaj pierwszą rozmowę telefoniczną
Wyślij żądanie do punktu końcowego https://app.scrapingbee.com/api/v1/, podając swój klucz API i adres URL.
Ten prosty przykład pozwala na scrapowanie stron internetowych za pomocą kilku linijek kompletnego kodu.
✅ Zrobione: Możesz już używać dowolnej funkcji poniżej.
Jak korzystać ze ScrapingBee AI Web Scraping
Scraping sieci za pomocą sztucznej inteligencji umożliwia wyciąganie złożonych, ustrukturyzowanych informacji ze stron internetowych przy użyciu prostego języka angielskiego.
Oto jak z niego korzystać krok po kroku.
Krok 1: Uzyskaj klucz API
Zarejestruj się i skopiuj klucz API z pulpitu nawigacyjnego.
Krok 2: Opisz dane
Dodaj adres URL docelowy i napisz zwykłe zapytanie w języku angielskim.
Oto jak to wygląda:
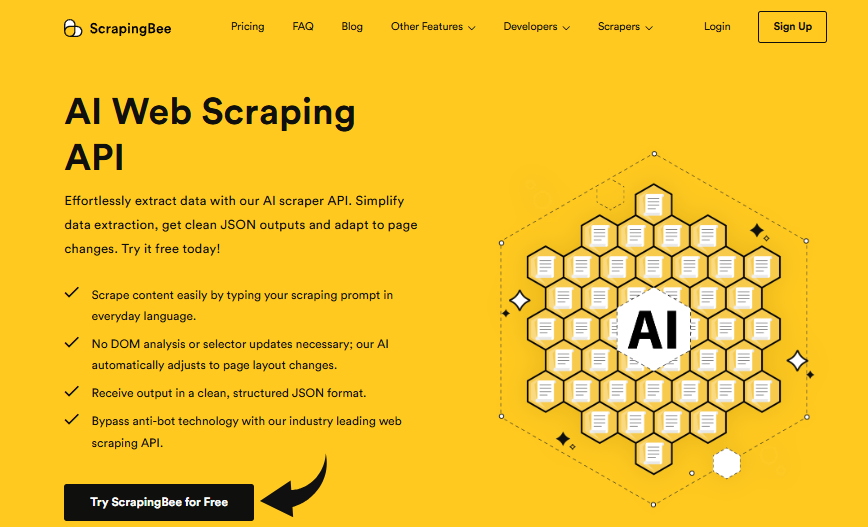
✓ Punkt kontrolny: Pojawi się czysty obiekt JSON z Twoimi polami.
Krok 3: Ustaw reguły ekstrakcji
Dostosuj reguły wyodrębniania, aby dokładnie objąć każde pole.
✅ Wynik: Ustrukturyzowany JSON bez konieczności ręcznego pisania selektorów CSS.
💡 Wskazówka: Połącz ekstrakcję AI z selektorami CSS, gdy potrzebujesz precyzyjnej kontroli.
Jak korzystać z interfejsu API wyszukiwarki Google ScrapingBee
Interfejs API wyszukiwarki Google umożliwia skanowanie wyników wyszukiwania Google bez konieczności samodzielnego zarządzania adresami IP serwerów proxy.
Oto jak z niego korzystać krok po kroku.
Krok 1: Wybierz punkt końcowy
Skieruj swoje zapytanie do interfejsu API wyszukiwarki Google.
Krok 2: Ustaw zapytanie
Dodaj słowo kluczowe i losowy kraj, aby uzyskać wyniki lokalne.
Oto jak to wygląda:
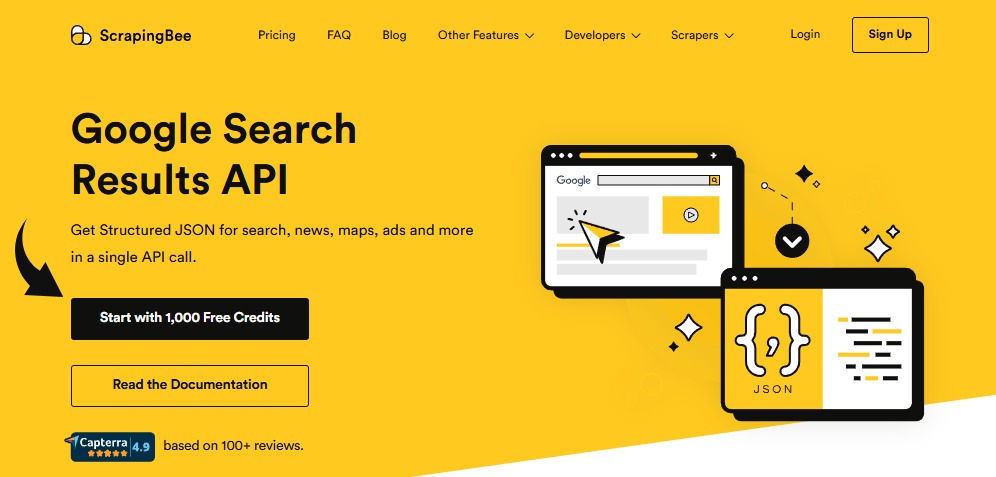
✓ Punkt kontrolny: Wyniki rankingowe są zwracane w postaci danych strukturalnych.
Krok 3: Odczytaj JSON
Przeanalizuj odpowiedź za pomocą biblioteki request w Pythonie.
✅ Wynik: Przeszukaj dane za pomocą jednego prostego wywołania interfejsu API REST.
💡 Wskazówka: Użyj kodu kraju, aby uzyskać dostęp do proxy geolokalizacji premium przy każdym zapytaniu.
Jak korzystać ze ScrapingBee Google Shopping Scraper
Narzędzie do skrobania Google Shopping umożliwia zbieranie list produktów i wyodrębnionych cen dla dowolnego wyszukiwanego terminu.
Oto jak z niego korzystać krok po kroku.
Krok 1: Wyślij prośbę o zakupy
Zadzwoń do punktu końcowego zakupów, aby złożyć zapytanie o produkt.
Krok 2: Analiza odpowiedzi
Przypisz każdą ofertę do tytułu, linku i wyodrębnionej ceny.
Oto jak to wygląda:
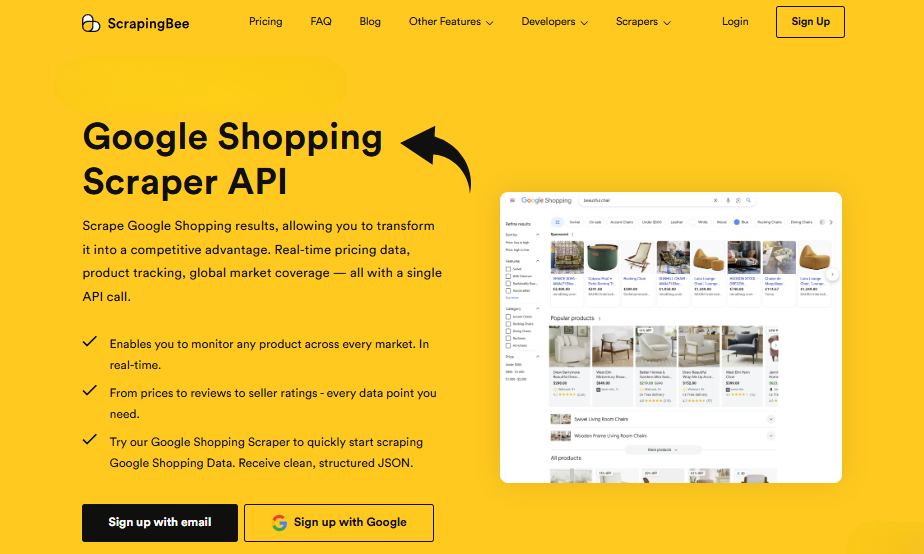
✓ Punkt kontrolny: Wiersze produktów są zwracane jako czysty kod JSON.
Krok 3: Eksportuj wyniki
Zapisz dane w formacie CSV w celu dalszej analizy.
✅ Wynik: Dane o cenach w czasie rzeczywistym dostępne w dowolnym arkuszu kalkulacyjnym.
💡 Wskazówka: Zaplanuj przebiegi, aby śledzić wyodrębnioną cenę w czasie.
Jak korzystać z narzędzia ScrapingBee JavaScript Web Scraping
JavaScript Web Scraping umożliwia obsługę renderowania JavaScript na stronach internetowych zbudowanych przy użyciu React lub Vue.
Oto jak z niego korzystać krok po kroku.
Krok 1: Włącz render_js
Ustaw render_js=true, aby ScrapingBee używał przeglądarek bez interfejsu graficznego.
Krok 2: Poczekaj na element
Poleć mu poczekać, aż konkretny element zostanie załadowany.
Oto jak to wygląda:
✓ Punkt kontrolny: Cała strona jest renderowana przed ekstrakcją.
Krok 3: Przechwyć kod HTML
Zwróć oryginalny kod HTML lub surowy kod źródłowy strony po renderowaniu.
✅ Wynik: W pełni renderowane strony internetowe, bez konieczności zarządzania sterownikami internetowymi.
💡 Wskazówka: Dodaj scenariusz JavaScript umożliwiający klikanie, przewijanie lub wypełnianie formularzy.
Jak korzystać ze skrobaka ChatGPT ScrapingBee
ChatGPT Skrobak umożliwia przechwytywanie odpowiedzi i źródła stron ze stron czatów opartych na dynamicznej sztucznej inteligencji.
Oto jak z niego korzystać krok po kroku.
Krok 1: Wybierz stronę docelową
Wyślij adres URL strony z włączonym render_js.
Krok 2: Renderowanie i ekstrakcja
Pozwól, aby bezgłowe skrobanie załadowało odpowiedź, a następnie przechwyciło tekst.
Oto jak to wygląda:
✓ Punkt kontrolny: Wygenerowana odpowiedź zostanie zwrócona w kodzie źródłowym strony.
Krok 3: Zapisz dane wyjściowe
Zapisz przeanalizowany kod HTML w celu późniejszego przetworzenia.
✅ Wynik: Czysty tekst pobrany ze strony całkowicie dynamicznej.
💡 Wskazówka: Utwórz scenariusz JavaScript, aby przejść przez wieloetapowe monity.
Jak korzystać z interfejsu API ScrapingBee Google News Scraper
Interfejs API skrobaka Google News umożliwia pobieranie nagłówków i całych artykułów poprzez proste żądania API.
Oto jak z niego korzystać krok po kroku.
Krok 1: Ustaw punkt końcowy wiadomości
Skieruj swoje zapytanie do interfejsu API Google News.
Krok 2: Dodaj filtry
Filtruj według tematu, języka lub losowego kraju.
Oto jak to wygląda:
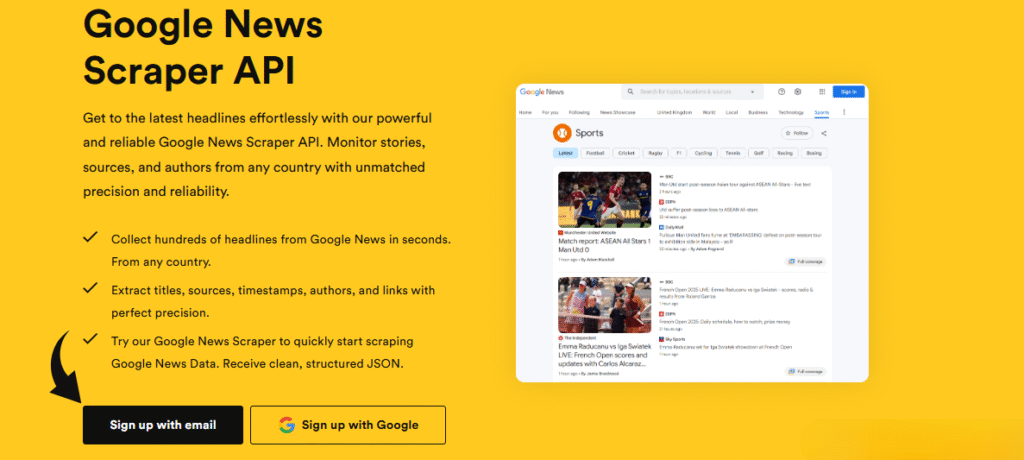
✓ Punkt kontrolny: Dopasowane nagłówki są zwracane jako dane strukturalne.
Krok 3: Zbierz artykuły
Przejrzyj wyniki, aby zebrać każdą historię.
✅ Wynik: Świeże dane informacyjne prosto z interfejsu API scrapingbee.
💡 Wskazówka: Obróć kod kraju, aby porównać zasięg regionalny.
Jak korzystać z szybkiego scrapowania danych ScrapingBee
Szybkie scrapowanie danych umożliwia szybkie scrapowanie danych, podczas gdy ScrapingBee będzie rotował serwerami proxy za Ciebie.
Oto jak z niego korzystać krok po kroku.
Krok 1: Zbuduj swoje żądanie
Złóż raz adres URL, klucz API i parametry.
Krok 2: Uruchom połączenia współbieżne
Wysyłaj wiele żądań API jednocześnie.
Oto jak to wygląda:
✓ Punkt kontrolny: Odpowiedzi napływają równolegle.
Krok 3: Sprawdź kody statusu
Potwierdź kod http 200 dla każdego zwróconego kodu statusu.
✅ Wynik: High-volume scraping handled on remote machines.
💡 Wskazówka: ThreadPoolExecutor znacznie przyspiesza scrapowanie stron internetowych.
Jak korzystać z interfejsu API programistycznego zrzutów ekranu ScrapingBee
Programowy interfejs API zrzutów ekranu umożliwia programowe wykonanie zrzutu ekranu całej strony dowolnego adresu URL.
Oto jak z niego korzystać krok po kroku.
Krok 1: Dodaj flagę zrzutu ekranu
Dodaj screenshot=true do żądania API.
Krok 2: Wybierz opcję Cała strona
Ustaw full_page=true, aby przechwycić cały układ.
Oto jak to wygląda:
✓ Punkt kontrolny: Obraz na całą stronę jest renderowany od krawędzi do krawędzi.
Krok 3: Pobierz obraz
Zapisz zwrócony plik na dysku.
✅ Wynik: Dokładne zdjęcia generowane na żądanie.
💡 Wskazówka: Parametr full_page powoduje, że cała strona zostanie wyrenderowana jako pierwsza.
Jak korzystać ze ScrapingBee i wyszukiwać oferty pracy w Google
Zbierz oferty pracy z Google umożliwia zbieranie ofert pracy w postaci złożonych, ustrukturyzowanych informacji.
Oto jak z niego korzystać krok po kroku.
Krok 1: Wywołanie punktu końcowego zadań
Wyślij swoją rolę i lokalizację do interfejsu API ofert pracy.
Krok 2: Filtruj oferty
Zawęź wyniki według tytułu, firmy lub miasta.
Oto jak to wygląda:
✓ Punkt kontrolny: Wiersze zadań zwracane są jako czyste dane JSON.
Krok 3: Ustrukturyzuj dane
Przekształć pola html w przejrzystą tabelę.
✅ Wynik: Dane zadania gotowe do analizy i zapisania.
💡 Wskazówka: Połącz z selektorami CSS, aby wyodrębnić pola niestandardowe.
Porady i skróty ScrapingBee Pro
Oto moje najlepsze wskazówki dotyczące scrapowania stron internetowych, które testowałem przez ponad rok.
Kluczowe parametry API
| Parametr | Co to robi |
|---|---|
| render_js | Renderuje JavaScript w przeglądarkach bezgłowych |
| premium_proxy | Przełącza na adresy IP proxy mieszkaniowego |
| kod_kraju | Ustawia geolokalizację proxy premium według losowego kraju |
| blokowanie_reklam | Umożliwia blokowanie reklam w celu przyspieszenia żądań |
Ukryte funkcje, których większość ludzi nie dostrzega
- identyfikator sesji: Kieruje żądania API przez ten sam adres IP przez pięć minut, dzięki czemu zachowujesz ten sam kod http i sesję.
- źródło_strony_powrotnej: Zwraca oryginalny kod HTML i cały kod źródłowy strony przed uruchomieniem jakiegokolwiek kodu JavaScript.
- Niestandardowe nagłówki i pliki cookie: Wyślij własne niestandardowe nagłówki i pliki cookie lub powróć do domyślnych nagłówków generowanych przez ScrapingBee.
- Kontrola nagłówka: Zamień istniejący nagłówek na nowy, wyświetl nagłówki wygenerowane automatycznie, a następnie zachowaj tylko wybrane nagłówki i usuń pozostałe.
Typowe błędy, których należy unikać w ScrapingBee
Błąd nr 1: Ignorowanie pliku robots.txt przed zeskrobywaniem
❌ Źle: Wysyłanie żądań do dowolnej witryny, którą chcesz zeskrobać, bez wcześniejszego sprawdzenia reguł.
✅ Po prawej: Przed rozpoczęciem scrapowania stron internetowych sprawdź plik robots.txt i warunki korzystania z usługi.
Błąd nr 2: Zapomnienie o włączeniu renderowania JavaScript
❌ Źle: Oczekujesz dynamicznej zawartości, a za każdym razem otrzymujesz pustą stronę źródłową.
✅ Po prawej: Ustaw render_js=true, aby przeglądarki bez interfejsu graficznego najpierw ładowały całą stronę.
Błąd nr 3: Wysyłanie wyłącznie domyślnych nagłówków
❌ Źle: Poleganie wyłącznie na domyślnych nagłówkach, które niektóre witryny oznaczają i blokują.
✅ Po prawej: Wysyłaj własne, niestandardowe nagłówki i rzeczywiste parametry agenta użytkownika, gdy chcesz zeskrobać dane.
Rozwiązywanie problemów ScrapingBee
Problem: Pusty lub częściowy kod źródłowy strony
Przyczyna: Kod JavaScript na stronie nigdy nie został wyrenderowany, więc kod HTML jest pusty.
Naprawić: Ustaw render_js=true i poczekaj, aż konkretny element załaduje całą stronę.
Problem: Prośby są ciągle blokowane
Przyczyna: Domyślne adresy IP serwera proxy centrum danych zostały oznaczone przez witrynę docelową.
Naprawić: Włącz proxy premium, aby uzyskać nowy adres IP z losowego kraju.
Problem: Widzisz kod http 401 lub 403
Przyczyna: Twój klucz API jest błędny lub nie masz środków na API.
Naprawić: Potwierdź klucz API, sprawdź kod statusu i doładuj konto, jeśli to konieczne.
📌 Notatka: Jeśli żadna z powyższych metod nie pomoże Ci rozwiązać problemu, skontaktuj się z pomocą techniczną ScrapingBee.
Czym jest ScrapingBee?
ScrapingBee jest narzędziem do scrapowania danych w chmurze, które obsługuje przeglądarki bezgłowe i zmienia serwery proxy.
Można to porównać do hostowanej przeglądarki, którą kontrolujesz za pomocą interfejsu API REST.
Obejrzyj ten krótki przegląd:
Zawiera następujące kluczowe funkcje:
- Scraping sieci za pomocą sztucznej inteligencji: Umożliwia wyciąganie złożonych, ustrukturyzowanych informacji ze stron internetowych przy użyciu prostego języka angielskiego.
- Interfejs API wyszukiwarki Google: Umożliwia skanowanie wyników wyszukiwania Google bez konieczności samodzielnego zarządzania adresami IP serwerów proxy.
- Narzędzie do skrobania Google Shopping: Umożliwia zbieranie list produktów i wyodrębnionych cen dla dowolnego wyszukiwanego terminu.
- Scraping stron internetowych za pomocą JavaScript: Umożliwia obsługę renderowania JavaScript na stronach internetowych zbudowanych przy użyciu React lub Vue.
- Scraper ChatGPT: Umożliwia przechwytywanie odpowiedzi i źródła stron ze stron dynamicznych czatów opartych na sztucznej inteligencji.
- API narzędzia Google News Scraper: Umożliwia pobieranie nagłówków i całych artykułów poprzez proste żądania API.
- Szybkie scrapowanie danych: Umożliwia szybkie scrapowanie danych, podczas gdy ScrapingBee będzie rotował serwerami proxy za Ciebie.
- Programowe API zrzutów ekranu: Umożliwia programowe wykonanie zrzutu ekranu całej strony dowolnego adresu URL.
- Zbieraj oferty pracy w Google: Umożliwia zbieranie ofert pracy w postaci złożonych, ustrukturyzowanych informacji.
Aby zapoznać się z pełną recenzją, zobacz naszą Recenzja ScrapingBee.
Cennik ScrapingBee
Oto ile będzie kosztować ScrapingBee w 2026 roku:
| Plan | Cena | Najlepsze dla |
|---|---|---|
| Pracownik nieetatowy | 49 USD/miesiąc | Deweloperzy solo i małe projekty |
| Uruchomienie | 99 USD/miesiąc | Rozwijające się zespoły skalujące żądania API |
| Biznes | 249 USD/miesiąc | Obciążenia związane z dużymi ilościami danych ze stron internetowych |
| Biznes+ | 599 USD/miesiąc | Zespoły przedsiębiorstw na maszynach zdalnych |
Bezpłatny okres próbny: Tak — 1000 darmowych wywołań API, bez konieczności podawania numeru karty kredytowej.
Gwarancja zwrotu pieniędzy: Możesz zrezygnować w każdej chwili. Rozliczenie odbywa się co miesiąc, bez blokady.
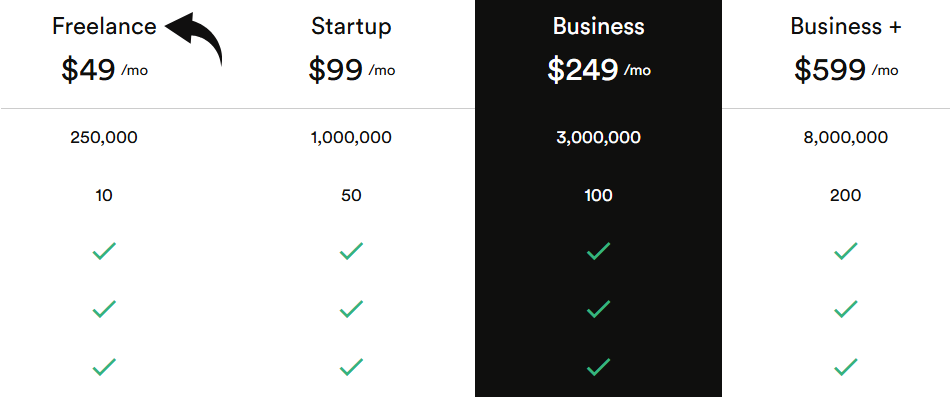
💰 Najlepszy stosunek jakości do ceny: Startup — najlepszy stosunek wartości API do ceny dla większości zespołów.
ScrapingBee kontra alternatywy
Jak wypada ScrapingBee na tle konkurencji? Oto krajobraz konkurencyjny:
Obejrzyj to porównanie:
| Narzędzie | Najlepsze dla | Cena | Ocena |
|---|---|---|---|
| ScrapingBee | Renderowanie JavaScript za pomocą jednego interfejsu API REST | 49 USD/mies. | ⭐ 4,5 |
| Apify | Gotowi aktorzy skrobaków | Różnie | ⭐ — |
| ScrapeGraphAI | Reguły ekstrakcji oparte na sztucznej inteligencji | Różnie | ⭐ — |
| Jasne dane | Adresy IP proxy przedsiębiorstwa | Różnie | ⭐ — |
| Przeglądać Sztuczna inteligencja | Punkt i kliknięcie bez kodu | Różnie | ⭐ — |
| Oxylabs | Premiumowe proxy korporacyjne | Różnie | ⭐ — |
| ThorData | Sieć proxy budżetowa | Różnie | ⭐ — |
| Zyte | Deweloperzy korzystający ze scrapowania API | Różnie | ⭐ — |
| Webscraper.io | Przechwytywanie rozszerzeń przeglądarki | Różnie | ⭐ — |
| Skrobak helowy | Mapowanie witryny na komputery stacjonarne | Różnie | ⭐ — |
| Firecrawl | Obniżka gotowa na LLM | Różnie | ⭐ — |
Szybkie typy:
- Najlepszy ogółem: ScrapingBee — jedno API REST do renderowania, wyszukiwania i zrzutów ekranu.
- Najlepszy budżet: ThorData — tanie adresy IP proxy do prostych celów scrapowania.
- Najlepsze dla początkujących: Przeglądaj sztuczną inteligencję — nie potrzeba kodu ani języka programowania.
- Najlepsze dla przedsiębiorstw: Bright Data — rozwiązanie stworzone z myślą o dużych, zgodnych z przepisami operacjach scrapowania.
🎯 Alternatywy dla ScrapingBee
Szukasz alternatyw dla ScrapingBee? Oto najlepsze opcje:
- 🚀 Apify: Kompleksowa platforma do scrapowania z gotowymi aktorami i hojną bezpłatną warstwą do szybkiego testowania pomysłów.
- 🧠 ScrapeGraphAI: Narzędzie do scrapowania oparte na sztucznej inteligencji, które przekształca proste komunikaty w reguły ekstrakcji złożonych, ustrukturyzowanych informacji.
- 🏢 Jasne dane: Adresy IP proxy klasy korporacyjnej i zestawy danych przeznaczone do bardzo dużych operacji scrapowania i ścisłej zgodności.
- 👶 Przeglądaj AI: Narzędzie niewymagające pisania kodu, które rejestruje kliknięcia w celu tworzenia scraperów bez konieczności pisania kodu.
- 🔒 Oxylabs: Dostawca najwyższej klasy interfejsów API dla serwerów proxy i scraperów, charakteryzujący się wysoką niezawodnością i przeznaczony do wymagających obciążeń korporacyjnych.
- 💰 ThorData: Ekonomiczna sieć proxy obejmująca adresy IP proxy dla domów i centrów danych, przeznaczona do codziennego scrapowania.
- 🔧 Żyta: Interfejs API do scrapowania przeznaczony dla programistów, dawniej Scrapinghub, z inteligentnym zarządzaniem banami i czystym kodem źródłowym strony.
- 🎨 Webscraper.io: Rozszerzenie przeglądarki Chrome umożliwiające wizualne tworzenie map witryn w celu przechwytywania danych metodą „wskaż i kliknij”.
- 💼 Skrobak helowy: Aplikacja do scrapowania danych z komputerów stacjonarnych Windows, która mapuje złożone witryny bez konieczności korzystania z chmury.
- ⚡ Firecrawl: Robot AI, który konwertuje całe witryny do czystego kodu Markdown w celu zasilania dużych modeli językowych.
Aby zobaczyć pełną listę, zobacz naszą Alternatywy dla ScrapingBee przewodnik.
⚔️ Porównanie ScrapingBee
Oto jak ScrapingBee wypada na tle konkurencji:
- ScrapingBee kontra Apify: Apify oferuje rynek scraperów; ScrapingBee wygrywa dzięki prostemu dostępowi do REST API i szybszej konfiguracji.
- ScrapingBee kontra ScrapeGraphAI: ScrapeGraphAI w pełni opiera się na sztucznej inteligencji; ScrapingBee umożliwia zarówno ekstrakcję sztucznej inteligencji, jak i surowe selektory CSS.
- ScrapingBee kontra Bright Data: Bright Data skaluje się do potrzeb przedsiębiorstw; ScrapingBee jest tańszy i prostszy dla małych i średnich zespołów.
- ScrapingBee kontra Browse AI: Przeglądaj AI dla osób niebędących programistami; ScrapingBee jest odpowiednie dla programistów, którzy chcą mieć interfejs API RESTEC i pełną kontrolę.
- ScrapingBee kontra Oxylabs: Oxylabs skierowany jest do dużych przedsiębiorstw; ScrapingBee oferuje niższe ceny początkowe i łatwiejszą naukę.
- ScrapingBee kontra ThorData: ThorData konkuruje ceną proxy; ScrapingBee łączy renderowanie, zrzuty ekranu i sztuczną inteligencję w jednym interfejsie API.
- ScrapingBee kontra Zyte: Zyte ma głębokie korzenie w środowisku programistycznym; ScrapingBee jest bardziej przyjazny dla szybkich projektów i małych zespołów.
- ScrapingBee kontra Webscraper.io: Webscraper.io działa w przeglądarce; ScrapingBee obsługuje renderowanie JavaScript po stronie serwera w rzeczywistej skali.
- ScrapingBee kontra Helium Scraper: Helium Scraper działa wyłącznie na komputerach stacjonarnych; ScrapingBee działa w chmurze, więc całkowicie pomijasz sterowniki internetowe.
- ScrapingBee kontra Firecrawl: Firecrawl koncentruje się na procesach LLM; ScrapingBee obejmuje szerszy zakres scrapowania, obejmujący zrzuty ekranu i interfejsy API wyszukiwania.
Zacznij korzystać ze ScrapingBee już teraz
Nauczyłeś się korzystać ze wszystkich głównych funkcji ScrapingBee:
- ✅ Scraping sieci za pomocą sztucznej inteligencji
- ✅ Interfejs API wyszukiwarki Google
- ✅ Narzędzie do zbierania danych z Google Shopping
- ✅ Scraping stron internetowych JavaScript
- ✅ Scraper ChatGPT
- ✅ Interfejs API Google News Scraper
- ✅ Szybkie scrapowanie danych
- ✅ API programowego zrzutu ekranu
- ✅ Zbieraj oferty pracy z Google
Następny krok: Wybierz jedną funkcję i wypróbuj ją teraz.
Większość osób zaczyna od web scrapingu z wykorzystaniem sztucznej inteligencji.
Popularnym pierwszym projektem jest stworzenie narzędzia OLX do pobierania ofert.
W trakcie rozwoju ScrapingBee uruchamia przeglądarkę na zdalnych maszynach.
Poznaj więcej funkcji, gdy Twój pierwszy scraper OLX zacznie działać.
Zeskrobanie pierwszej strony zajmie Ci mniej niż pięć minut.
Często zadawane pytania
Jak działa ScrapingBee?
ScrapingBee to chmurowe narzędzie do scrapowania. Wysyłasz żądanie zawierające klucz API i adres URL, a aplikacja zwraca stronę za pomocą przeglądarek bez interfejsu graficznego, jednocześnie zmieniając serwery proxy.
Ile kosztuje ScrapingBee?
Plany zaczynają się od 49 USD miesięcznie dla Freelancerów, następnie 99 USD dla Startupów, 249 USD dla Firm i 599 USD dla Firm i powyżej. Bezpłatny okres próbny daje 1000 wywołań API do testowania scrapowania.
Czy scrapowanie stron internetowych jest nielegalne?
Scraping publicznych stron internetowych jest generalnie legalny. Zawsze sprawdzaj najpierw plik robots.txt i regulamin witryny, unikaj podawania danych osobowych i przestrzegaj limitów prędkości, aby zachować bezpieczeństwo.
Czy ScrapingBee obsługuje renderowanie JavaScript?
Tak. Ustaw render_js=true, a ScrapingBee załaduje strony internetowe w przeglądarkach bez interfejsu graficznego. To renderowanie JavaScript działa od razu na stronach zbudowanych w React lub Vue.
Jaki język programowania obsługuje ScrapingBee?
Dowolny. ScrapingBee to API REST, więc można je wywołać z Pythona, Node, PHP lub dowolnego innego języka. W Pythonie wystarczy zaimportować żądania i wysłać swoje żądania API.













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
