
Szybki start
W tym przewodniku omówiono wszystkie funkcje ScrapeGraphAI:
- Rozpoczęcie pracy — Utwórz konto i dodaj swój klucz API
- Jak korzystać ze Smart Scrapera — pobieraj ustrukturyzowane dane z dowolnej strony, korzystając z prostego komunikatu w języku naturalnym
- Jak korzystać z Search Scraper — zbieraj dane internetowe bezpośrednio z wyników wyszukiwania na żywo, bez konieczności otwierania każdego linku samodzielnie
- Jak korzystać z Markdownify — przekształć zawartość internetową w czysty kod Markdown, który modele AI odczytają bez zbędnych zakłóceń
- Jak używać agenta Spidy — przeszukuj wiele stron jako narzędzie do scrapowania wielu stron w przypadku większych projektów scrapowania
- Jak korzystać z Universal Data Extraction — obsługuj wiele zadań związanych z ekstrakcją danych z danych produktów, artykułów informacyjnych i nie tylko
- Jak korzystać z łatwych integracji — połącz wyodrębnione dane z modelami nauki o danych i uczenia maszynowego w ciągu kilku minut
- Jak korzystać ze Smart Agentic Scraper — czytaj dynamiczną treść na stronach z dużą ilością JavaScript, która uniemożliwia korzystanie z tradycyjnych narzędzi do scrapowania
- Jak korzystać z harmonogramu zadań — uruchamiaj operacje scrapowania według harmonogramu, aby ekstrakcja danych powtarzała się automatycznie
- Jak korzystać z prostego interfejsu — korzystaj efektywnie ze ScrapeGraphAI z poziomu pulpitu nawigacyjnego bez konieczności posiadania głębokiej wiedzy technicznej
Czas potrzebny: 5 minut na każdy film
Również w tym przewodniku: Profesjonalne porady | Typowe błędy | Rozwiązywanie problemów | Wycena | Alternatywy
Dlaczego warto zaufać temu przewodnikowi
Korzystałem ze ScrapeGraphAI i osobiście przetestowałem każdą funkcję opisaną w tym samouczku „Jak używać ScrapeGraph AI”.
Ten przewodnik po korzystaniu ze ScrapeGraphAI pochodzi z prawdziwych projektów scrapingowych, a nie ze zrzutów ekranu dostawców.

ScrapeGraphAI to narzędzie oparte na sztucznej inteligencji, które zmienia bałagan w sieci dane szybko przekształcić w dane strukturalne.
Wykorzystuje duże modele językowe, aby czytać strony w sposób, w jaki czytałby je człowiek.
To inteligentne podejście do scrapowania stron internetowych pomaga uprościć proces scrapowania stron internetowych w ramach wielu zadań.
Poniżej omawiam krok po kroku każdą z najważniejszych funkcji, załączając zrzuty ekranu i profesjonalne wskazówki.
Samouczek ScrapeGraphAI
Ten samouczek dotyczący korzystania ze sztucznej inteligencji ScrapeGraph przeprowadzi Cię przez cały proces scrapowania, od konfiguracji po zaawansowaną ekstrakcję danych.
ScrapeGraph AI
Zamień dowolną stronę internetową w przejrzyste, ustrukturyzowane dane dzięki podpowiedziom w języku naturalnym. ScrapeGraphAI łączy rozbudowane modele językowe z bezpośrednią logiką grafów, aby szybko wyodrębnić dane. Zacznij za darmo, karta kredytowa nie jest wymagana.
Wprowadzenie do ScrapeGraphAI
Przed dodaniem jakiejkolwiek funkcji należy zakończyć ten jednorazowy proces konfiguracji.
Obejrzyj najpierw ten krótki przegląd:
Przyjrzyjmy się teraz każdemu krokowi.
Krok 1: Utwórz konto i klucz API
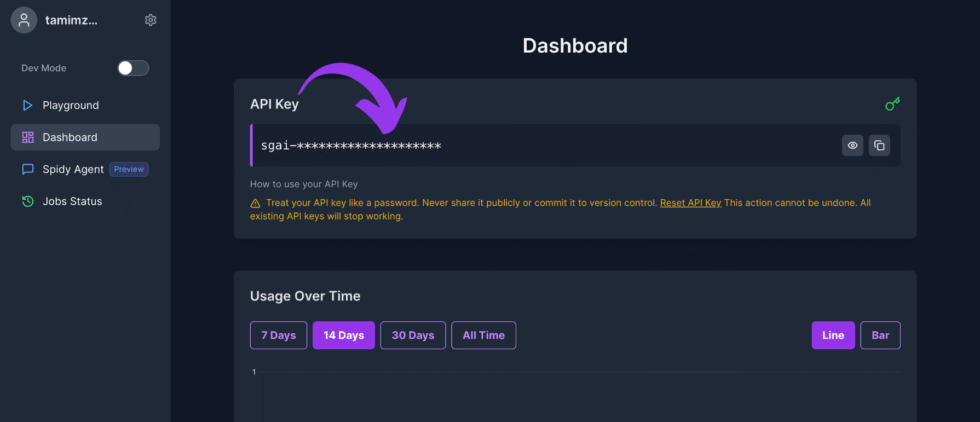
Zarejestruj się w panelu ScrapeGraphAI i otwórz zakładkę kluczy.
Skopiuj swój klucz API ScrapeGraphAI, ponieważ każde żądanie wymaga tego klucza API.
✓ Punkt kontrolny: Na Twoim pulpicie jest widoczny aktywny klucz API.
Krok 2: Zainstaluj ScrapeGraphAI
Utwórz czyste środowisko wirtualne, a następnie zainstaluj ScrapeGraphAI za pomocą pip.
W swoim skrypcie dodaj importuj system operacyjny I importuj klienta aby bezpiecznie załadować klucz API.
Oto jak wygląda pulpit nawigacyjny:
✓ Punkt kontrolny: Biblioteka importuje się bez błędów.
Krok 3: Wybierz swój model językowy
Na potrzeby pierwszego uruchomienia wybierz model językowy, np. GPT 4o.
ScrapeGraphAI obsługuje wielu dostawców LLM, dzięki czemu możesz w każdej chwili wymieniać się modelami AI.
✅ Zrobione: Teraz możesz używać ScrapeGraphAI do dowolnej funkcji poniżej.
Jak korzystać ze ScrapeGraphAI Smart Scraper
Inteligentny skrobak umożliwia pobieranie ustrukturyzowanych danych z dowolnej strony za pomocą prostego monitu w języku naturalnym.
Oto jak z niego korzystać krok po kroku.
Krok 1: Otwórz narzędzie Single Page Scraper
Wybierz narzędzie do scrapowania pojedynczych stron i wklej jeden docelowy adres URL.
Krok 2: Napisz polecenie w języku naturalnym
Opisz pola, które chcesz wyodrębnić ze strony internetowej.
Oto jak to wygląda:
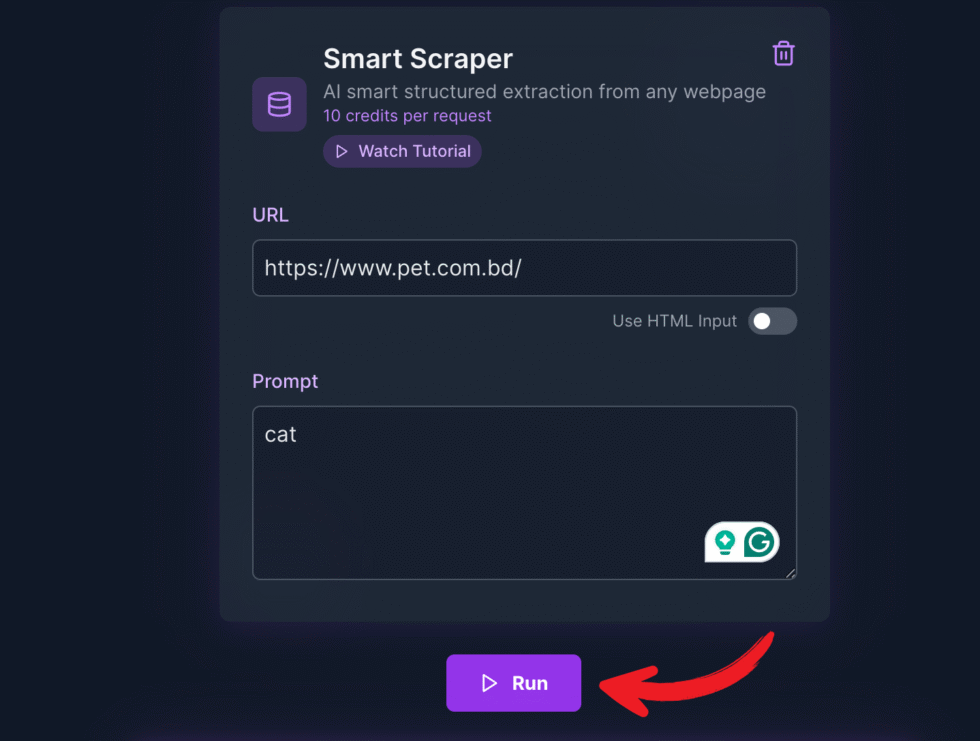
✓ Punkt kontrolny: Wyniki odpowiadają polom, o które pytałeś.
Krok 3: Uruchom i odczytaj JSON
Uruchom go i odczytaj czyste dane JSON w ustrukturyzowanym formacie.
✅ Wynik: W ciągu kilku sekund udało Ci się utworzyć jedną stronę danych strukturalnych.
💡 Wskazówka: Napisz szczegółowy monit, podając dokładne klucze JSON, których potrzebujesz, aby uzyskać dokładniejszy wynik ekstrakcji.
Jak korzystać z narzędzia ScrapeGraphAI Search Scraper
Narzędzie do wyszukiwania umożliwia zbieranie danych internetowych bezpośrednio z wyników wyszukiwania na żywo, bez konieczności otwierania każdego linku.
Oto jak z niego korzystać krok po kroku.
Krok 1: Wprowadź swoje zapytanie
Wpisz zapytanie i poczekaj, aż aplikacja wyświetli wyniki wyszukiwania na żywo.
Krok 2: Ustaw, co chcesz zebrać
Wskaż, jakie dane internetowe ma wyodrębnić z każdego wyniku.
Oto jak to wygląda:
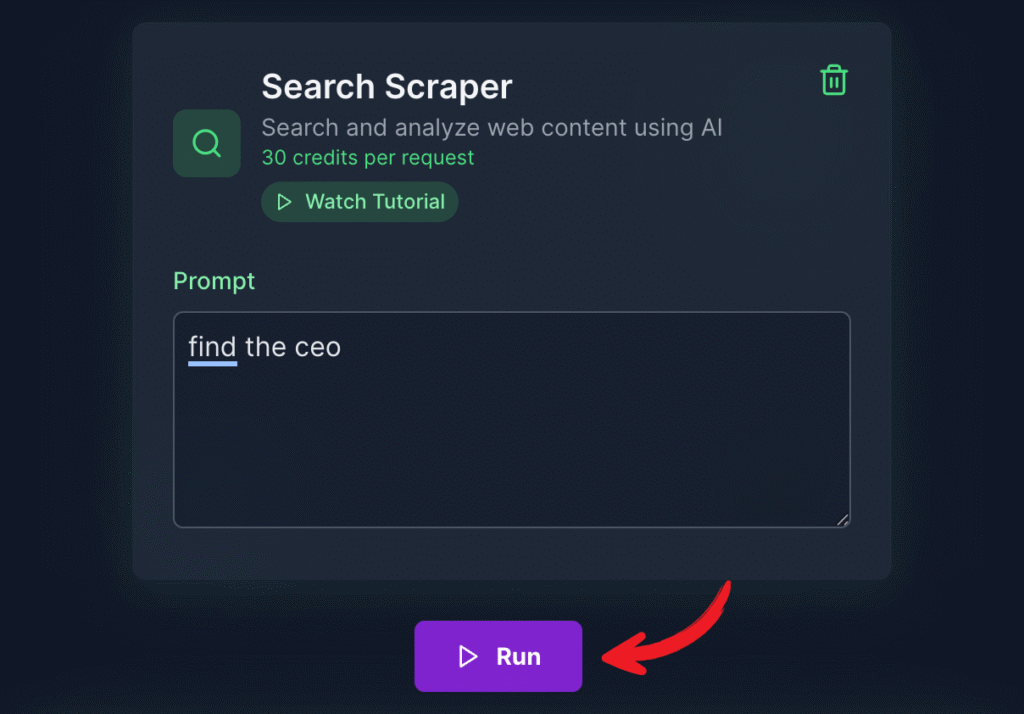
✓ Punkt kontrolny: Wyniki odpowiadają polom, o które pytałeś.
Krok 3: Eksportuj dane wyjściowe
Uzyskaj wartościowe dane w gotowym do użycia formacie JSON.
✅ Wynik: Przekształciłeś wyniki wyszukiwania w użyteczne dane internetowe.
💡 Wskazówka: Najpierw zawęź zapytanie, aby wyniki były konkretne i przejrzyste.
Jak korzystać z ScrapeGraphAI Markdownify
Markdownify umożliwia przekształcenie treści internetowych w czysty kod Markdown, który modele AI odczytują bez zbędnych zakłóceń.
Oto jak z niego korzystać krok po kroku.
Krok 1: Wklej adres URL strony
Wpisz dowolny adres URL zawierający skomplikowaną strukturę HTML.
Krok 2: Konwersja do formatu Markdown
Markdownify przekształci treść internetową w czysty kod Markdown.
Oto jak to wygląda:
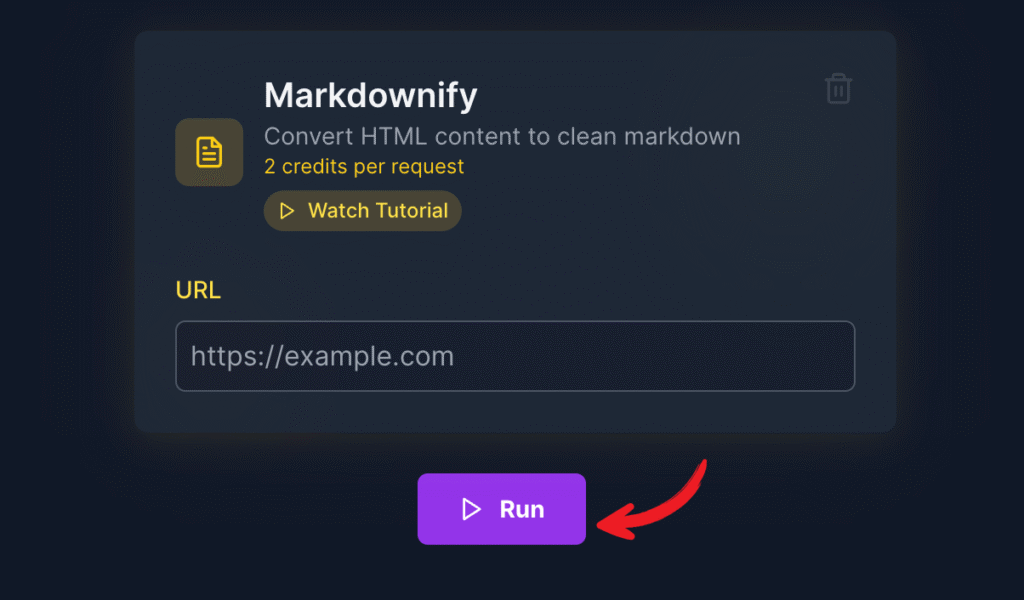
✓ Punkt kontrolny: Wyniki odpowiadają polom, o które pytałeś.
Krok 3: Ponowne wykorzystanie czystych danych
Wprowadź czyste dane do swojego modelu lub notatek.
✅ Wynik: Przekonwertowałeś stronę na czystą, gotową do użycia w modelu tekst.
💡 Wskazówka: Dane wyjściowe w formacie Markdown świetnie nadają się jako dane wejściowe do dowolnych podsumowań obsługiwanych przez sztuczną inteligencję.
Jak korzystać z agenta Spidy w ScrapeGraphAI
Agent Spidy umożliwia indeksowanie wielu stron w ramach większych projektów scrapowania wielostronicowego.
Oto jak z niego korzystać krok po kroku.
Krok 1: Dodaj swoją stronę startową
Podaj agentowi Spidy link początkowy do przeszukiwania.
Krok 2: Ustaw głębokość indeksowania
Wybierz, czy chcesz zeskrobać kilka czy wiele stron.
Oto jak to wygląda:
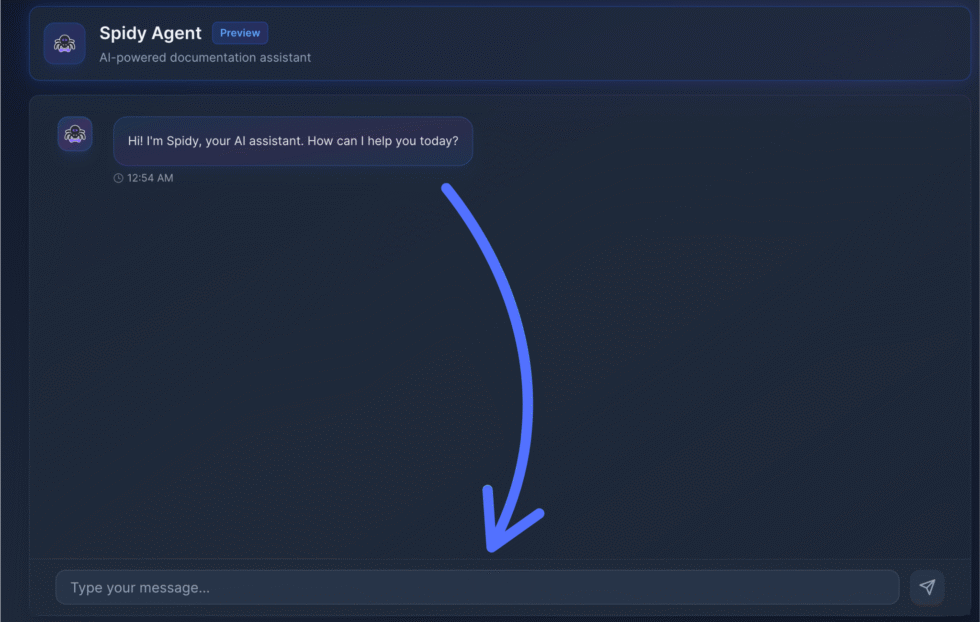
✓ Punkt kontrolny: Wyniki odpowiadają polom, o które pytałeś.
Krok 3: Zbieranie na dużą skalę
Pozwól temu wielostronicowemu scraperowi poradzić sobie z zadaniami scrapowania na dużą skalę.
✅ Wynik: Przeszukałeś wiele stron za jednym razem.
💡 Wskazówka: Zacznij od przetestowania kilku stron przed rozpoczęciem scrapowania na dużą skalę.
Jak korzystać z uniwersalnej ekstrakcji danych ScrapeGraphAI
Uniwersalna ekstrakcja danych umożliwia wykonywanie wielu zadań związanych z ekstrakcją danych z danych produktów, artykułów informacyjnych i innych źródeł.
Oto jak z niego korzystać krok po kroku.
Krok 1: Wybierz źródło
Skieruj go na dane produktu, artykuły informacyjne lub dowolne strony internetowe.
Krok 2: Zdefiniuj schemat
Ustaw format strukturalny, w jakim mają zostać wyodrębnione dane.
Oto jak to wygląda:
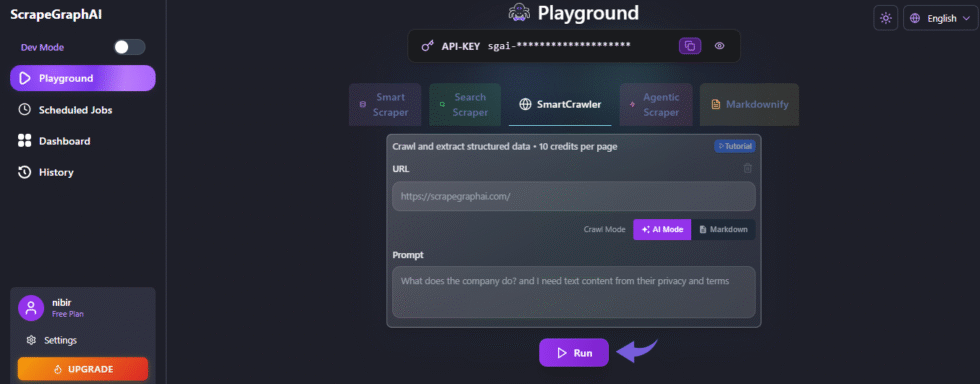
✓ Punkt kontrolny: Wyniki odpowiadają polom, o które pytałeś.
Krok 3: Pobierz dane
Uruchom zadania ekstrakcji danych i przejrzyj wyniki.
✅ Wynik: Zajmowałeś się jednocześnie zadaniami związanymi z ekstrakcją mieszanych danych.
💡 Wskazówka: Zdefiniuj schemat Pydantic, aby zablokować strukturę każdego rekordu.
Jak korzystać z łatwych integracji ScrapeGraphAI
Łatwe integracje umożliwia połączenie wyodrębnionych danych z modelami nauki o danych i uczenia maszynowego w ciągu kilku minut.
Oto jak z niego korzystać krok po kroku.
Krok 1: Otwórz API
Połącz się przez API ze swoimi skryptami i aplikacjami.
Krok 2: Wysyłanie danych w dół
Przekieruj wyodrębnione dane do swoich kanałów danych.
Oto jak to wygląda:
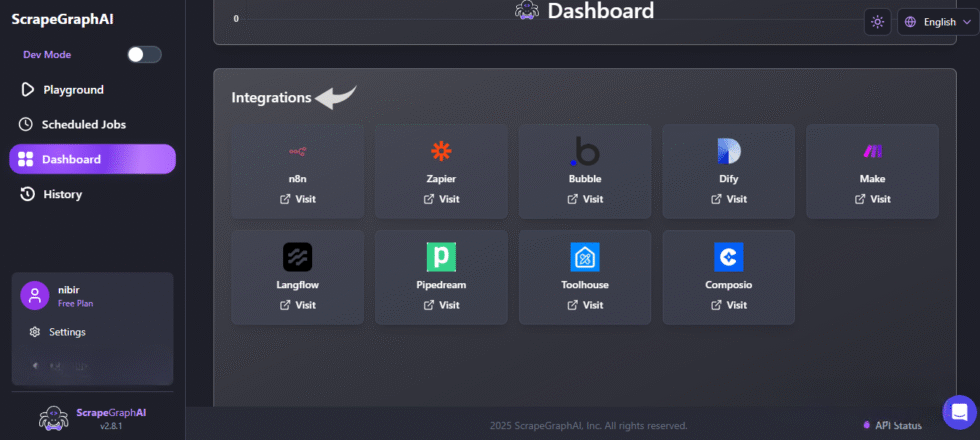
✓ Punkt kontrolny: Wyniki odpowiadają polom, o które pytałeś.
Krok 3: Nakarm swoje modele
Przekaż dane modelom uczenia maszynowego i agentom AI.
✅ Wynik: Wyodrębnione dane trafiają teraz do stosu.
💡 Wskazówka: Połącz z Make.com lub n8n aby rozszerzyć swoje kanały danych.
Jak korzystać ze ScrapeGraphAI Smart Agentic Scraper
Inteligentny skrobak agentowy umożliwia czytanie dynamicznej zawartości w witrynach z dużą ilością JavaScript, które łamią tradycyjne zasady skrobaki.
Oto jak z niego korzystać krok po kroku.
Krok 1: Załaduj trudną witrynę
Wklej witrynę zawierającą dużo kodu JavaScript, która ukrywa swoją zawartość.
Krok 2: Pozwól agentowi renderować
Agent ładuje dynamiczną zawartość przed jej odczytaniem.
Oto jak to wygląda:
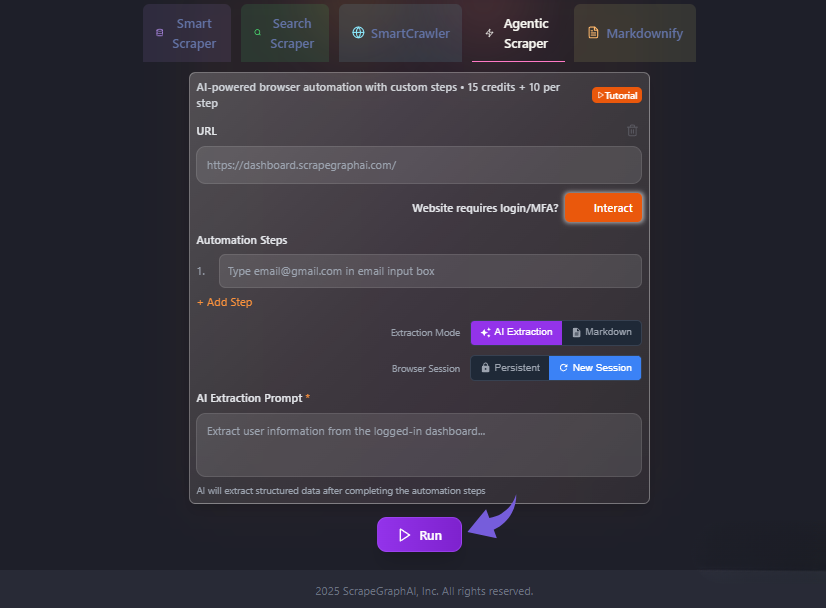
✓ Punkt kontrolny: Wyniki odpowiadają polom, o które pytałeś.
Krok 3: Uzyskaj stabilne wyniki
W przeciwieństwie do tradycyjnych scraperów, dostosowuje się do zmian na stronach internetowych.
✅ Wynik: Czytasz czysto strony zawierające dużo JavaScript.
💡 Wskazówka: Połącz go z rotacyjnymi serwerami proxy na stronach, które blokują boty.
Jak korzystać z harmonogramu zadań ScrapeGraphAI
Stanowisko Harmonogram umożliwia uruchamianie operacji scrapowania według harmonogramu, dzięki czemu ekstrakcja danych powtarza się automatycznie.
Oto jak z niego korzystać krok po kroku.
Krok 1: Utwórz zadanie
Zapisz zeskrobanie jako powtarzalne zadanie.
Krok 2: Ustaw rytm
Wybierz częstotliwość wykonywania operacji scrapowania.
Oto jak to wygląda:
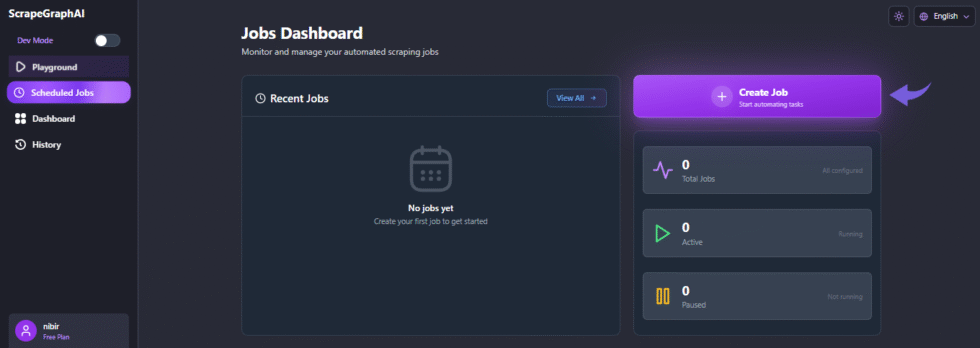
✓ Punkt kontrolny: Wyniki odpowiadają polom, o które pytałeś.
Krok 3: Pozwól mu działać
Proces scrapowania powtarza się i zapisuje nowe dane.
✅ Wynik: Twoje dane ze scrapowania odświeżają się teraz automatycznie.
💡 Wskazówka: Zaplanuj zadania na później, aby nie wysyłać zbyt wielu żądań naraz.
Jak korzystać z prostego interfejsu ScrapeGraphAI
Prosty interfejs umożliwia efektywne korzystanie ze ScrapeGraphAI z poziomu pulpitu nawigacyjnego bez konieczności posiadania głębokiej wiedzy technicznej.
Oto jak z niego korzystać krok po kroku.
Krok 1: Otwórz pulpit nawigacyjny
Skorzystaj z pulpitu nawigacyjnego obsługiwanego przez sztuczną inteligencję, nie potrzebujesz żadnego kodu.
Krok 2: Kompilacja bez kodu
Wykonywanie zadań bez dogłębnej wiedzy technicznej.
Oto jak to wygląda:
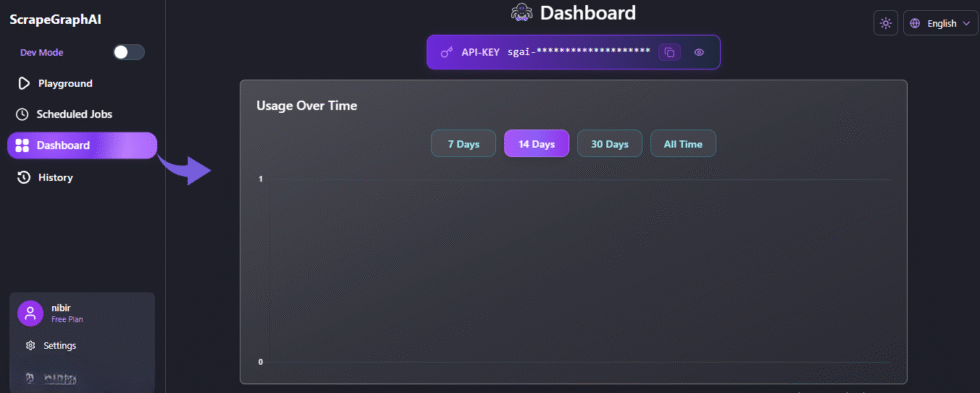
✓ Punkt kontrolny: Wyniki odpowiadają polom, o które pytałeś.
Krok 3: Zarządzaj wszystkim
Śledź każde zeskrobanie i efektywnie wykorzystuj ScrapeGraphAI z jednego ekranu.
✅ Wynik: Przeprowadziłeś pełne skanowanie bez żadnego kodu.
💡 Wskazówka: Dodaj zapisane zadania do zakładek, aby móc je ponownie wykorzystać w różnych projektach scrapowania.
Porady i skróty dotyczące ScrapeGraphAI Pro
Oto moje najlepsze wskazówki po sześciu miesiącach zbierania projektów.
Szybkie skróty klawiaturowe
| Bramka | Skrót |
|---|---|
| Debugowanie przebiegu | Tryb szczegółowy umożliwiający szczegółowe rejestrowanie |
| Zapisz dane wyjściowe | Eksportuj do pliku JSON lub plików CSV |
| Unikaj bloków | Dodaj rotacyjne serwery proxy |
| Struktura zamka | Schemat pydantyczny |
Ukryte funkcje, których większość ludzi nie dostrzega
- Szczegółowe rejestrowanie: Szczegółowa flaga umożliwiająca szczegółowe rejestrowanie danych dla każdego węzła, dzięki czemu obsługa błędów jest o wiele łatwiejsza.
- Rotacja proxy: Rotacyjne serwery proxy chronią Cię przed limitami przepustowości API i omijają blokady IP w chronionych witrynach.
- Modele lokalne: Uruchamiaj otwarte modele za pośrednictwem Ollama w celu wyodrębnienia informacji bez płacenia za token.
Typowe błędy, których należy unikać w ScrapeGraphAI
Błąd: ignorowanie warunków korzystania ze strony internetowej
❌ Źle: Scraping bez wcześniejszego sprawdzenia warunków korzystania ze strony internetowej lub kwestii prawnych.
✅ Po prawej: Przed przystąpieniem do zbierania danych należy zapoznać się z polityką serwisu i przestrzegać warunków korzystania ze strony.
Błąd: Uderzenie w serwer
❌ Źle: Żądania są wysyłane tak szybko, że witryna zwraca zbyt wiele błędów dotyczących żądań.
✅ Po prawej: Dodaj opóźnienia między żądaniami, aby zmieścić się w limitach szybkości interfejsu API.
Błąd: niejasne podpowiedzi
❌ Źle: Pisanie luźnych, naturalnych komunikatów tekstowych, które zwracają chaotyczne dane.
✅ Po prawej: Podaj dokładne pola i schemat, aby za każdym razem otrzymać czyste dane.
Rozwiązywanie problemów ze ScrapeGraphAI
Problem: Błąd zbyt wielu żądań
Przyczyna: Wysyłając żądania zbyt szybko, osiągnąłeś limity szybkości interfejsu API.
Naprawić: Rozłóż połączenia w czasie i dodaj opóźnienie; zaktualizuj swój plan, aby uzyskać wyższe limity.
Problem: puste lub częściowe wyniki
Przyczyna: Celem jest witryna intensywnie korzystająca z języka JavaScript, dlatego dynamiczna zawartość ładuje się późno.
Naprawić: Przejdź na Smart Agentic Scraper, który renderuje stronę przed jej odczytaniem.
Problem: Blokada lub blokady IP
Przyczyna: Witryna sygnalizuje operacje scrapowania i wyświetla stronę blokady.
Naprawić: Dodaj rotacyjne serwery proxy, aby każde żądanie wyglądało jak nowe żądanie użytkownika.
📌 Notatka: Poniżej przedstawiono najczęstsze problemy. W przypadku pozostałych problemów należy skontaktować się z pomocą techniczną ScrapeGraphAI.
Czym jest ScrapeGraphAI?
ScrapeGraphAI jest biblioteką języka Python o otwartym kodzie źródłowym, służącą do inteligentnego scrapowania stron internetowych.
Łączy duże modele językowe LLM z bezpośrednią logiką grafową w celu zbudowania procesu scrapowania.
Każdy węzeł w grafie scrapowania uruchamia jedno zadanie, dzięki czemu wszelkie ekstrakcje danych można łatwo aktualizować.
Pomyśl o tym jako o inteligentnym asystent który odczytuje strony internetowe i zwraca czyste dane JSON.
Obejrzyj ten krótki przegląd:
Zawiera następujące kluczowe funkcje:
- Inteligentny skrobak: pobieraj ustrukturyzowane dane z dowolnej strony, korzystając z prostego komunikatu w języku naturalnym
- Narzędzie do wyszukiwania: zbieraj dane internetowe bezpośrednio z wyników wyszukiwania na żywo, bez konieczności otwierania każdego linku samodzielnie
- Markdownify: przekształć zawartość internetową w czysty kod Markdown, który modele AI odczytają bez zbędnych zakłóceń
- Agent Spidy: przeszukiwanie wielu stron jako narzędzie do scrapowania wielu stron w przypadku większych projektów scrapowania
- Uniwersalna ekstrakcja danych: obsługuj wiele zadań związanych z ekstrakcją danych z danych produktów, artykułów informacyjnych i nie tylko
- Łatwe integracje: połącz wyodrębnione dane z modelami nauki o danych i uczenia maszynowego w ciągu kilku minut
- Inteligentny skrobak agentowy: czytaj dynamiczną treść na stronach z dużą ilością JavaScript, które zakłócają działanie tradycyjnych narzędzi do scrapowania
- Harmonogram zadań: uruchamiaj operacje scrapowania zgodnie z harmonogramem, aby ekstrakcja danych powtarzała się automatycznie
- Prosty interfejs: efektywnie korzystaj ze ScrapeGraphAI z poziomu pulpitu nawigacyjnego bez konieczności posiadania głębokiej wiedzy technicznej
Ponieważ odczytuje kontekst, może wyodrębnić znaczące dane, nawet gdy strona internetowa zmienia swój układ.
Potrafi czytać strony internetowe i dokumenty lokalne, jednak nie transkrybuje plików audio.
Stosując proste instrukcje w języku naturalnym, można wykorzystać dane, takie jak artykuły informacyjne, do analizy nastrojów.
Aby zapoznać się z pełną recenzją, zobacz naszą Recenzja ScrapeGraphAI.
Cennik ScrapeGraphAI
Oto, ile będzie kosztować ScrapeGraphAI w 2026 roku:
| Plan | Cena | Najlepsze dla |
|---|---|---|
| Bezpłatny | $0 | Testowanie na kilku stronach |
| Rozrusznik | 17 USD/miesiąc | Zadania samodzielnej ekstrakcji danych |
| Wzrost | 85 USD/miesiąc | Regularne projekty scrapowania |
| Zawodowiec | 425 USD/miesiąc | Zgarnianie na dużą skalę |
| Przedsiębiorstwo | Zwyczaj | Zespoły o dużej objętości |
Bezpłatny okres próbny: Tak — plan darmowy umożliwia bezpłatne testowanie funkcji scrapowania danych.
Gwarancja zwrotu pieniędzy: Możesz anulować w dowolnym momencie z poziomu pulpitu nawigacyjnego.
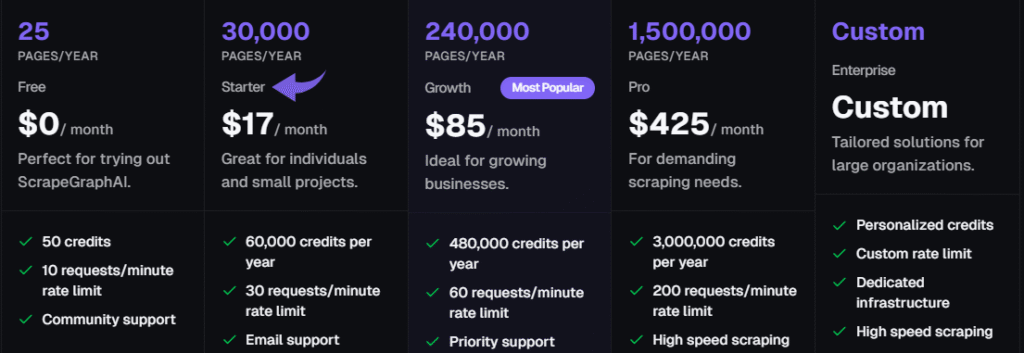
💰 Najlepszy stosunek jakości do ceny: Wzrost — wystarczająca ilość danych do realizacji stałych projektów scrapowania bez przepłacania.
ScrapeGraphAI kontra alternatywy
Jak wypada ScrapeGraphAI w porównaniu z innymi platformami? Oto porównanie:
| Narzędzie | Najlepsze dla | Cena | Ocena |
|---|---|---|---|
| ScrapeGraphAI | Ekstrakcja natywna dla sztucznej inteligencji | 17 USD/mies. | ⭐ 4,5 |
| Scrapy | Przeszukiwanie kodu w pierwszej kolejności | Bezpłatny | ⭐ 4.4 |
| Przeglądaj AI | Monitorowanie bez kodu | 48 USD/mies. | ⭐ 4.3 |
| Jasne dane | Sieć proxy | 0,50 USD/mies. | ⭐ 4,5 |
| Ośmiornica | Skrobanie wizualne | 99 USD/mies. | ⭐ 4.3 |
| ScrapingBee | Witryny intensywnie renderujące | 49 USD/mies. | ⭐ 4.4 |
Szybkie typy:
- Najlepszy ogółem: ScrapeGraphAI — ekstrakcja języka naturalnego lepsza od sztywnych selektorów.
- Najlepszy budżet: Scrapy — darmowy, jeśli potrafisz napisać kod samodzielnie.
- Najlepsze dla początkujących: Przeglądaj sztuczną inteligencję — wskazuj i klikaj, bez skryptów.
- Najlepsze dla serwerów proxy: Bright Data — ogromny, rotacyjny zbiór serwerów proxy.
🎯 Alternatywy dla ScrapeGraphAI
Szukasz alternatyw dla ScrapeGraphAI? Oto najlepsze opcje:
- 🚀 Scrapy: Otwartoźródłowy framework Pythona dla programistów, którzy chcą mieć pełną kontrolę nad każdym przeszukiwaniem.
- 👶 Przeglądaj AI: Narzędzie niewymagające kodu, które rejestruje kliknięcia i zmienia dowolną witrynę w API.
- 🏢 Jasne dane: Sieć proxy dla przedsiębiorstw z masowo zmieniającymi się adresami IP do scrapowania na dużą skalę.
- 🎨 Ośmiornica: Wizualny scraper typu „wskaż i kliknij” przeznaczony dla osób niebędących programistami, które tworzą projekty scrapowania.
- 🔧 ScrapingBee: API renderujące strony z dużą ilością kodu JavaScript, dzięki czemu możesz pominąć konfigurację własnej przeglądarki.
Aby zobaczyć pełną listę, zobacz naszą Alternatywy dla ScrapeGraphAI przewodnik.
⚔️ Porównanie ScrapeGraphAI
Oto jak ScrapeGraphAI wypada na tle poszczególnych konkurentów:
- ScrapeGraphAI kontra Scrapy: ScrapeGraphAI wygrywa pod względem szybkości uzyskiwania pierwszego wyniku; Scrapy wygrywa pod względem kontroli nad koderami.
- ScrapeGraphAI kontra Browse AI: ScrapeGraphAI radzi sobie z chaotycznymi stronami; Browse AI jest prostsze w przypadku stałych, powtarzających się układów.
- ScrapeGraphAI kontra Bright Data: Bright Data jest liderem w dziedzinie serwerów proxy; ScrapeGraphAI jest liderem w dziedzinie przekształcania stron w dane strukturalne.
- ScrapeGraphAI kontra Octoparse: ScrapeGraphAI dostosowuje się do zmian zachodzących na stronach internetowych; Octoparse wymaga od Ciebie przebudowania szablonów.
- ScrapeGraphAI kontra ScrapingBee: Oba narzędzia generują trudne witryny, ale ScrapeGraphAI analizuje zawartość również przy użyciu modeli AI.
Zacznij korzystać ze ScrapeGraphAI już teraz
Nauczyłeś się korzystać ze wszystkich głównych funkcji ScrapeGraphAI:
- ✅ Inteligentny skrobak
- ✅ Narzędzie do wyszukiwania
- ✅ Markdownify
- ✅ Agent Spidy
- ✅ Uniwersalna ekstrakcja danych
- ✅ Łatwe integracje
- ✅ Inteligentny skrobak agentowy
- ✅ Harmonogram zadań
- ✅ Prosty interfejs
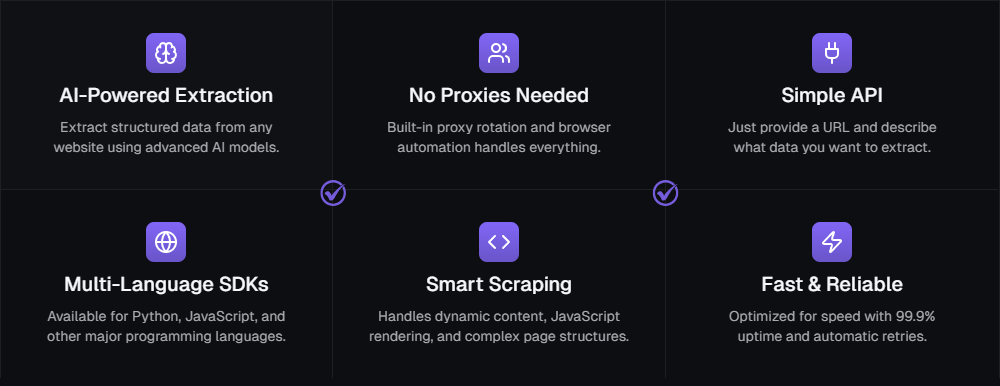
Oto najważniejsze korzyści w skrócie:
Następny krok: Wybierz jedną funkcję i wypróbuj ją teraz.
Większość osób zaczyna od narzędzia do scrapowania pojedynczych stron Smart Scraper.
Wyodrębnienie danych z pierwszej strony zajmuje mniej niż pięć minut.
Często zadawane pytania
Czy korzystanie ze ScrapeGraphAI jest darmowe?
Tak. Plan darmowy obejmuje podstawowe skanowanie stron internetowych bez żadnych kosztów, a plany płatne zaczynają się od 17 USD miesięcznie, jeśli potrzebujesz większej ilości danych lub funkcji.
Czy muszę umieć kodować?
Nie. Możesz używać ScrapeGraphAI z poziomu pulpitu nawigacyjnego bez kodu, z komunikatami w języku naturalnym, choć jeśli chcesz, możesz skorzystać z interfejsu API Pythona.
Jakie duże modele językowe obsługuje?
Współpracuje z wieloma dostawcami LLM, w tym modelami OpenAI, takimi jak GPT 4o, Anthropic, Google Gemini i modelami lokalnymi za pośrednictwem Ollama.
Czy obsługuje strony intensywnie korzystające z JavaScript?
Tak. Smart Agentic Scraper najpierw renderuje dynamiczną zawartość, dzięki czemu odczytuje strony intensywnie korzystające z JavaScript, co uniemożliwia działanie tradycyjnych scraperów.
Jak uniknąć zablokowania?
Przestrzegaj warunków korzystania ze strony internetowej, dodawaj opóźnienia, aby uniknąć zbyt wielu błędów żądań i korzystaj z rotacyjnych serwerów proxy, aby zapobiegać blokowaniu adresów IP podczas scrapowania.













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
