
Avvio rapido
Questa guida illustra tutte le funzionalità di Web Scraper:
- Iniziare — Creazione dell'account e configurazione di base
- Come utilizzare l'interfaccia punta e clicca — Crea scraper in modo visivo senza scrivere codice
- Come utilizzare i dati estratti — Estrai dati strutturati da qualsiasi pagina di un sito
- Come utilizzare i siti JavaScript di Handle — Estrae i dati dalle pagine dinamiche che caricano contenuti con JS
- Come utilizzare i dati personalizzati — Regola e pulisci le righe raschiate prima dell'esportazione
- How to Use Export Data — Salva i risultati come file CSV, XLSX o JSON
Tempo necessario: 5 minuti per ogni servizio
In questa guida troverete anche: Consigli professionali | Errori comuni | Risoluzione dei problemi | Prezzi | Alternative
Perché fidarsi di questa guida
Ho utilizzato Web Scraper per oltre sei mesi e ho testato ogni funzionalità descritta in questo tutorial. Questo articolo si basa su una reale esperienza pratica, non su semplici slogan di marketing.

Web Scraper is one of the most beginner friendly guide tools for browser-based dati estrazione.
Ma la maggior parte degli utenti ne sfrutta solo una minima parte delle potenzialità.
Questa guida ti mostra come utilizzare uno scraper web passo dopo passo.
Ogni funzionalità è illustrata con screenshot e suggerimenti utili.
Tutorial sullo scraping web
Questo tutorial completo su come utilizzare Web Scraper ti guida passo passo attraverso ogni funzionalità, dalla configurazione iniziale ai metodi avanzati che ti trasformeranno in un utente esperto.
Web Scraper
Estrai dati dai siti web direttamente dal tuo browser senza scrivere codice. Web Scraper ti permette di estrarre dati da qualsiasi sito web ed esportarli in formato CSV, XLSX o JSON. Inizia gratuitamente, senza bisogno di carta di credito.
Guida introduttiva a Web Scraper
Prima di utilizzare qualsiasi funzionalità, completa questa configurazione iniziale.
Ci vogliono circa 3 minuti.
Prima di iniziare, guarda questa breve panoramica:
Ora analizziamo passo passo ciascuna fase.
Passaggio 1: crea il tuo account
Accedi al sito web di Web Scraper all'indirizzo https://webscraper.io/ tramite il tuo browser.
Fai clic su "Iscriviti" o "Inizia la prova gratuita".
Inserisci il tuo indirizzo email e crea una password per configurare il tuo account.
✓ Punto di controllo: Controlla il tuo posta in arrivo per ricevere un'e-mail di conferma.
Passaggio 2: Installa l'estensione del browser
Apri il Chrome Web Store e cerca "Web Scraper" per trovare l'estensione.
Fai clic su "Aggiungi a Chrome" e conferma il download.
L'estensione funziona anche su computer desktop Windows, macOS e Linux.
Ecco come si presenta la dashboard:
✓ Punto di controllo: Dovresti visualizzare la scheda Web Scraper negli Strumenti per sviluppatori.
Passaggio 3: Completare la configurazione iniziale
Apri gli Strumenti per sviluppatori (F12) e fai clic sulla scheda Web Scraper per caricare l'interfaccia.
Crea la tua prima sitemap incollando l'URL del sito da cui desideri estrarre i dati.
✅ Fatto: Sei pronto per utilizzare una qualsiasi delle funzioni seguenti.
Come utilizzare l'interfaccia "punta e clicca" di un web scraper
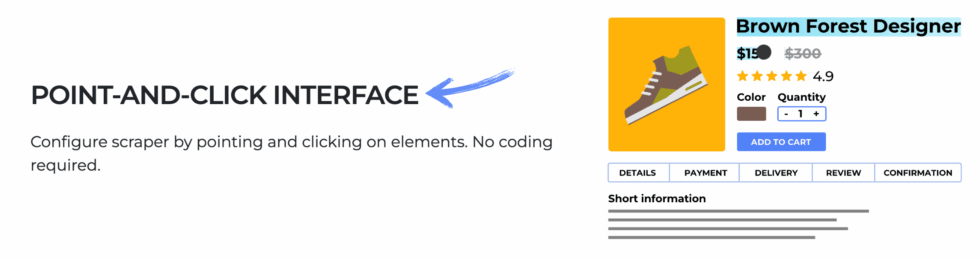
Interfaccia punta e clicca Consente di creare uno scraper in modo visivo selezionando gli elementi corretti sulla pagina.
Ecco come usarlo passo dopo passo.
Passaggio 1: Apri l'editor della mappa del sito
Accedi al sito web da cui desideri estrarre i dati tramite il tuo browser.
Apri DevTools e fai clic sulla scheda Web Scraper per iniziare.
Passaggio 2: Selezionare gli elementi visivamente
Fai clic su "Aggiungi nuovo selettore" e scegli il tipo di selettore.
Fai clic direttamente sugli elementi della pagina che desideri analizzare.
Web Scraper evidenzia gli elementi corretti e suggerisce i selettori CSS più adatti.
Ad esempio, cliccando sul titolo di un prodotto viene generato automaticamente il selettore corrispondente.
Ecco come si presenta:
✓ Punto di controllo: Dovresti vedere degli elementi evidenziati in verde.
Passaggio 3: Salva il tuo selettore
Fai clic su "Selezione completata" e poi premi "Salva selettore" per confermare.
Lo scraper memorizza il modello dei selettori CSS per trovare gli elementi su ogni pagina.
✅ Risultato: Il tuo strumento di scraping visivo è pronto per estrarre dati senza bisogno di scrivere codice.
💡 Consiglio da professionista: Utilizza l'“Anteprima elemento” per verificare che i selettori selezionino i dati corretti prima di eseguire lo scraping completo.
Come utilizzare un web scraper per estrarre dati
Estrarre dati Consente di estrarre automaticamente dati strutturati da qualsiasi pagina web.
Ecco come usarlo passo dopo passo.
Passaggio 1: Configura i selettori
Imposta i selettori per ogni punto dati — testo, link, immagine o intestazione HTML.
Utilizza l'albero dei selettori per navigare tra gli elementi annidati nella struttura della pagina.
Passaggio 2: Eseguire la raschiatura
Fai clic su "Scrape" e imposta l'intervallo di richiesta e il ritardo di caricamento della pagina.
Lo scraper invia richieste a ciascun URL e avvia il processo di estrazione dei dati.
Ecco come si presenta:
✓ Punto di controllo: Nell'anteprima dovrebbero apparire le righe dei dati estratti.
Passaggio 3: Esamina i tuoi risultati
Fai clic suSfoglia” per esaminare i dati estratti in una visualizzazione tabellare.
Verifica che ogni colonna corrisponda ai dati che ti interessano.
✅ Risultato: Hai a disposizione dati puliti e strutturati, pronti per l'esportazione.
💡 Consiglio da professionista: Imposta un ritardo di 2 secondi tra le richieste per evitare di superare i limiti di frequenza sul sito web di destinazione.
Come utilizzare Web Scraper per gestire siti JavaScript
Gestire i siti JavaScript Consente di estrarre dati da pagine dinamiche che caricano contenuti tramite JavaScript.
Ecco come usarlo passo dopo passo.
Passaggio 1: Identificare i contenuti dinamici
Controlla se la pagina carica i dati dopo l'HTML iniziale osservando l'albero dei nodi.
Potrebbe essere necessario navigare manualmente tra gli elementi HTML per verificare quali si caricano in ritardo.
Se il contenuto viene visualizzato solo dopo l'esecuzione di JavaScript, questa funzionalità è necessaria.
Passaggio 2: Abilita il rendering JavaScript
In Web Scraper Cloud, seleziona "Rendering JavaScript completo" nelle impostazioni della sitemap.
Imposta il tempo di attesa per il caricamento della pagina in modo che tutti gli elementi vengano visualizzati completamente prima che inizi lo scraping.
Ecco come si presenta:
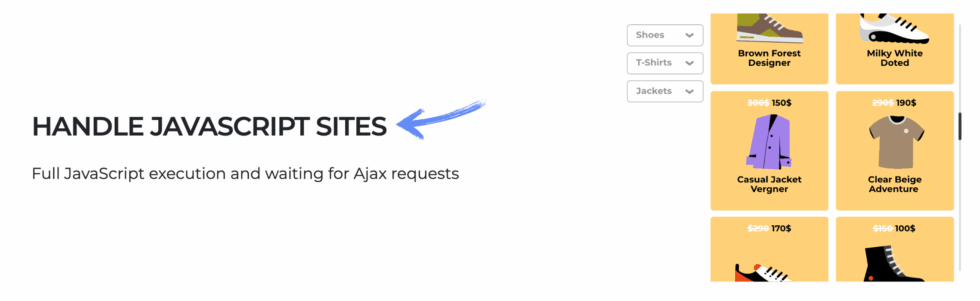
✓ Punto di controllo: L'anteprima dovrebbe mostrare il contenuto caricato dinamicamente.
Passaggio 3: Testare ed eseguire
Esegui una prova di scraping su una singola pagina per confermare che lo script acquisisca tutti gli elementi.
Una volta verificato, esegui lo scraping completo su tutte le pagine target del sito.
✅ Risultato: Ora puoi estrarre dati da siti web che fanno un uso intensivo di JavaScript come un professionista.
💡 Consiglio da professionista: If a site uses infinite scroll, add a “Scroll down” selector to load all content before the scrape begins.
Come utilizzare Web Scraper e personalizzare i dati
Personalizza i dati Consente di regolare, pulire e modificare i dati estratti prima di salvarli.
Ecco come usarlo passo dopo passo.
Passaggio 1: Aprire l'anteprima dei dati
Al termine dell'estrazione dei dati, fai clic su "Esplora" per visualizzare la tabella dei dati grezzi.
Review each column and note any rows that need cleaning.
Passaggio 2: applicare espressioni regolari o filtri di testo
Utilizza l'opzione “Regex” nel tuo selettore per analizzare e rimuovere il testo indesiderato.
Si tratta essenzialmente di un algoritmo di corrispondenza di pattern flessibile che pulisce i dati direttamente sul posto.
Ecco come si presenta:
✓ Punto di controllo: Le colonne dei dati ora dovrebbero mostrare solo i valori corretti.
Step 3: Rename and Reorder Columns
Modifica i nomi dei selettori per assegnare a ciascuna colonna un'etichetta di intestazione chiara e riconoscibile.
Riordina i selettori nella mappa del sito in modo che corrispondano alla struttura di output finale.
✅ Risultato: I tuoi dati sono puliti, etichettati e pronti per l'esportazione o l'analisi.
💡 Consiglio da professionista: Utilizzare la casella di controllo "Multiplo" su un selettore per acquisire tutti gli elementi corrispondenti come righe separate nell'output.
Come utilizzare i dati esportati da un web scraper
Esporta dati lets you save your scraped results as a csv file, XLSX, or JSON file.
Ecco come usarlo passo dopo passo.
Passaggio 1: Completa la raschiatura
Attendi il completamento dell'estrazione dei dati, quindi fai clic su "Esplora" per visualizzare l'anteprima dei dati.
Verifica che tutte le righe e le colonne contengano i valori previsti.
Passaggio 2: scegli il formato di esportazione
Fai clic sul pulsante Esporta e seleziona CSV, XLSX o JSON dall'elenco dei formati.
Per la maggior parte degli utenti, il formato CSV è l'opzione più flessibile e ampiamente supportata.
Ecco come si presenta:
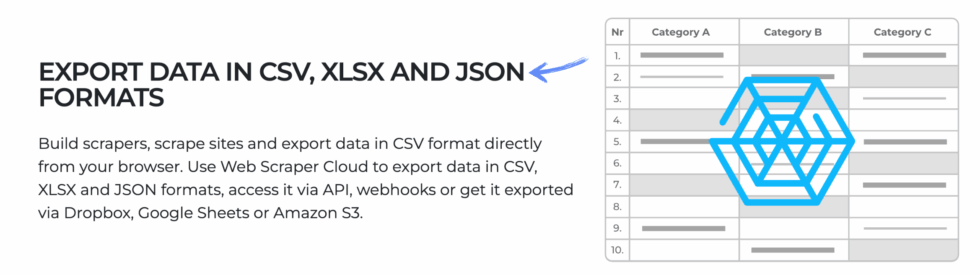
✓ Punto di controllo: Nel tuo browser dovrebbe comparire una finestra di dialogo per il download.
Passaggio 3: Salvare il file
Scegli una cartella sul tuo computer e salva il file esportato.
Apri il file in Excel, Fogli Google o qualsiasi altro programma in grado di leggere file CSV per verificare e stampare i dati.
✅ Risultato: I dati raccolti vengono salvati localmente e sono pronti per l'uso.
💡 Consiglio da professionista: Su Web Scraper Cloud, utilizza l'API o il webhook per inviare automaticamente i dati esportati a Dropbox o Google Drive.
Suggerimenti e scorciatoie professionali per lo scraping web
Dopo aver testato Web Scraper per oltre sei mesi, ecco i miei migliori consigli.
I commenti degli utenti sui forum confermano che queste scorciatoie consentono di risparmiare moltissimo tempo.
Scorciatoie da tastiera
| Azione | Scorciatoia |
|---|---|
| Open DevTools | F12 |
| Ispeziona l'elemento | Ctrl + Maiusc + C |
| Attiva/disattiva console | Esc |
| Ricarica la pagina | Torna alla dashboard |
Funzionalità nascoste che la maggior parte delle persone non nota
- Importazione/Esportazione della mappa del sito: Copia e incolla una sitemap JSON per clonare rapidamente uno scraper o condividila con il tuo team come post nella cartella del progetto.
- Selettore di paginazione: Aggiungi un selettore di link per i pulsanti "Avanti" per navigare automaticamente tra i risultati di ricerca su più pagine ed estrarre dati da ogni pagina.
- Raschiatura programmata: Utilizza Web Scraper Cloud per eseguire scraping a intervalli programmati e ricevere dati sempre aggiornati nella tua casella di posta elettronica o tramite webhook.
Errori comuni da evitare quando si utilizza un web scraper.
Errore n. 1: Raschiare troppo velocemente senza ritardi
❌ Sbagliato: Esecuzione di scraping senza alcun ritardo, il che attiva blocchi IP e risposte di errore da parte del server.
✅ A destra: Imposta un ritardo minimo di 2000 ms tra le richieste per simulare le abitudini di navigazione umana.
Errore n. 2: Utilizzo del tipo di selettore errato
❌ Sbagliato: Utilizzare il selettore “Text” quando è necessario estrarre i valori dei link href o gli URL delle immagini dagli elementi.
✅ A destra: Scegli il tipo di selettore in base ai tuoi dati: usa "Link" per gli URL e "Image" per le immagini.
Errore n. 3: Ignorare le regole di robots.txt
❌ Sbagliato: L'estrazione di dati da pagine bloccate dal file robots.txt può comportare problemi legali per le aziende.
✅ A destra: Prima di effettuare lo scraping, controlla sempre il file robots.txt per rimanere in regola ed evitare problemi.
Risoluzione dei problemi di Web Scraper
Problema: lo scraper restituisce dati vuoti
Causa: I selettori CSS si riferiscono a elementi che non esistono più sulla pagina.
Aggiustare: Riesamina la pagina nel tuo browser, aggiorna i selettori ed esegui una prova di scraping.
Problema: il contenuto JavaScript non viene caricato
Causa: L'estensione gratuita per browser non è in grado di eseguire codice JavaScript sulle pagine che lo richiedono.
Aggiustare: Passa a Web Scraper Cloud, che supporta il rendering JavaScript completo per i siti dinamici.
Problema: l'indirizzo IP viene bloccato durante lo scraping.
Causa: Sending too many requests too quickly triggers the target site’s anti-bot protection.
Aggiustare: Aumenta il ritardo impostato ad almeno 3 secondi e, se disponibile, utilizza la rotazione proxy.
📌 Nota: Se nessuna di queste soluzioni risolve il problema, contatta l'assistenza di Web Scraper per ottenere una risposta specifica al tuo problema.
Cos'è un web scraper?
Web Scraper è un sito web strumento di raschiatura che ti permette di estrarre dati da qualsiasi sito web utilizzando il tuo browser.
Immaginatelo come uno strumento intelligente di copia e incolla per l'intero web, che organizza i dati in righe e colonne.
Guarda questa breve panoramica:
Include le seguenti caratteristiche principali:
- Point-and-Click Interface: Crea scraper in modo visivo senza scrivere codice Python o altro.
- Estrazione dei dati: Estrai automaticamente testo, link e URL di immagini da qualsiasi pagina web.
- Gestione dei siti JavaScript: Scrape dynamic content that loads via JS or Ajax requests
- Personalizza i dati: Pulisci, filtra e modifica l'output estratto prima di salvarlo.
- Esporta i dati: Scarica i tuoi risultati in formato CSV, XLSX o JSON con un solo clic.
Per una recensione completa, consulta la nostra Recensione di Web Scraper.
Prezzi dei servizi di web scraping
Ecco quanto costerà Web Scraper nel 2026:
| Piano | Prezzo | Ideale per |
|---|---|---|
| Gratuito | Gratuito | Utenti occasionali che testano piccoli lavori di scraping |
| Progetto | $40/mese | Liberi professionisti esecuzione di attività di scraping regolari |
| Professionale | $80/mese | Team che necessitano di più scraper simultanei |
| Scala | $ 167/mese | Agencies handling high-volume data extraction |
| Impresa | Costume | Grandi aziende con esigenze di raschiatura personalizzate |
Livello gratuito: Sì, l'estensione per il browser è completamente gratuita e senza limiti di tempo.
Garanzia di rimborso: Contatta l'assistenza entro 14 giorni per richiedere un rimborso per i piani a pagamento.
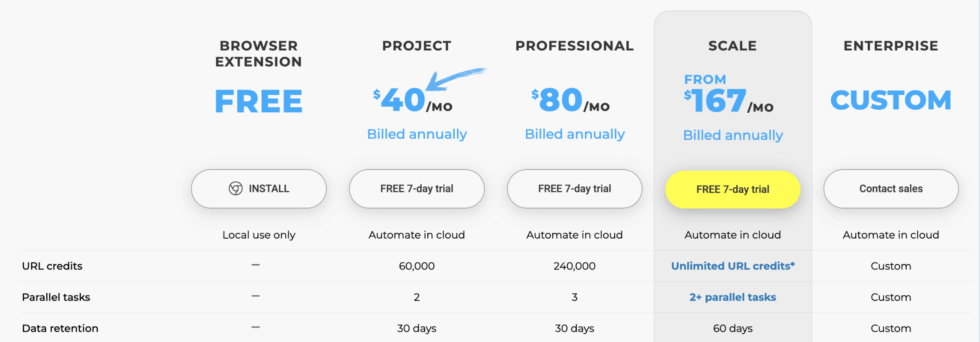
💰 Miglior rapporto qualità-prezzo: Piano di progetto: ti offre scraping in cloud ed esecuzioni programmate al prezzo più basso.
Web scraper vs alternative
Come si posiziona Web Scraper rispetto alla concorrenza? Ecco il panorama competitivo:
| Attrezzo | Ideale per | Prezzo | Valutazione |
|---|---|---|---|
| Web Scraper | Browser-based scraping | Gratis+ | ⭐ 3,5 |
| Octoparse | Estrazione visiva senza codice | $89/mese | ⭐ 4.3 |
| ParseHub | Raschiature complesse multilivello | $ 189/mese | ⭐ 4.2 |
| Scrapy | Sviluppatore Python su larga scala | Gratuito | ⭐ 4,5 |
| Apify | Cloud scraping con attori | $49/mese | ⭐ 4.4 |
Scelte rapide:
- Il migliore in assoluto: Web Scraper: versione gratuita ed estensione per browser facile da usare per la maggior parte degli utenti.
- Miglior budget: Scrapy: completamente gratuito e open-source per gli sviluppatori Python.
- Ideale per principianti: Octoparse: interfaccia drag-and-drop con modelli integrati
- Ideale per il cloud scraping: Apify: attori potenti e accesso alle API nel mondo del web scraping
🎯 Alternative ai web scraper
Cerchi alternative a Web Scraper? Ecco le migliori opzioni:
- 🚀 Octoparse: Uno scraper senza codice con un flusso di lavoro visivo costruttore, modelli predefiniti e servizio cloud per aziende di tutte le dimensioni.
- 💰 ParseHub: Gestisce siti complessi con navigazione multilivello e caricamento AJAX, ideale per gli utenti che necessitano di un'estrazione dati avanzata senza dover scrivere codice.
- 🔧 Scarso: Un framework Python open-source pensato per gli sviluppatori che desiderano il pieno controllo, una perfetta integrazione con Soup e funzionalità di scraping su larga scala.
- ⚡ Apify: Una piattaforma cloud con un marketplace di scraper preconfigurati e un'API flessibile per sviluppatori e team di tutto il mondo.
Per l'elenco completo, consultare il nostro Alternative a Web Scraper guida.
⚔️ Confronto tra web scraper
Ecco come Web Scraper si confronta con ciascun concorrente:
- Web Scraper vs Octoparse: Web Scraper è gratuito e nativo per il browser; Octoparse offre maggiori funzionalità con la sua applicazione desktop e strumenti cloud per progetti più complessi.
- Web Scraper contro ParseHub: ParseHub gestisce meglio la navigazione più complessa del sito; Web Scraper vince in termini di prezzo e semplicità per l'estrazione rapida di dati da una singola pagina.
- Web Scraper contro Scrapy: Scrapy offre agli sviluppatori il pieno controllo tramite script Python; Web Scraper è più adatto a chi non ha competenze di programmazione e preferisce un approccio visivo.
- Web Scraper vs Apify: Apify eccelle nel cloud automazione and API access; Web Scraper is simpler for users who log into their browser and go.
Start Using Web Scraper Now
Hai imparato a utilizzare tutte le principali funzionalità di Web Scraper:
- ✅ Interfaccia punta e clicca
- ✅ Estrai dati
- ✅ Gestisci siti JavaScript
- ✅ Personalizza i dati
- ✅ Esporta i dati
Passo successivo: Scegli una funzionalità e provala subito.
La maggior parte delle persone inizia con un'interfaccia punta e clicca.
Ci vogliono meno di 5 minuti.
Domande frequenti
Web Scraper è gratuito?
Sì. L'estensione per browser Web Scraper è gratuita. I piani cloud a pagamento partono da 40 dollari al mese per lo scraping programmato e l'accesso alle API.
Web Scraper è in grado di gestire pagine renderizzate tramite JavaScript?
Sì, ma solo su Web Scraper Cloud. L'estensione gratuita per browser non esegue JavaScript. I piani Cloud supportano il rendering completo di JavaScript.
In quali formati può esportare i dati Web Scraper?
Web Scraper consente di esportare i dati in formato CSV, XLSX o JSON. Gli utenti cloud possono inoltre accedere ai dati tramite API o webhook.
Per utilizzare Web Scraper sono necessarie competenze di programmazione?
No. Web Scraper utilizza un'interfaccia punta e clicca. Si selezionano gli elementi visivamente, senza bisogno di Python, Beautiful Soup o altro codice.
Il web scraping è legale?
In generale sì, per i dati disponibili pubblicamente. Controlla sempre il file robots.txt e i termini di servizio del sito. Evita di estrarre dati personali o privati.













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
