
Snelstart
This guide covers every Firecrawl feature:
- Aan de slag — Create a firecrawl account and set your api key
- How to Use Scrape — Pull llm ready data from single web pages
- How to Use Crawl — Crawl entire websites and follow every link
- Hoe de zoekfunctie te gebruiken — Search the web for real time web data
- How to Use Map — Run url discovery across individual pages
- How to Use Extract — Extract structured data with natural language prompts
Benodigde tijd: 5 minuten per film
Ook in deze handleiding: Professionele tips | Veelgemaakte fouten | Probleemoplossing | Prijzen | Alternatieven
Waarom zou je deze gids vertrouwen?
I have used Firecrawl for over a year and tested every feature covered here.
This tutorial on how to use Firecrawl comes from real hands-on web scraping work.

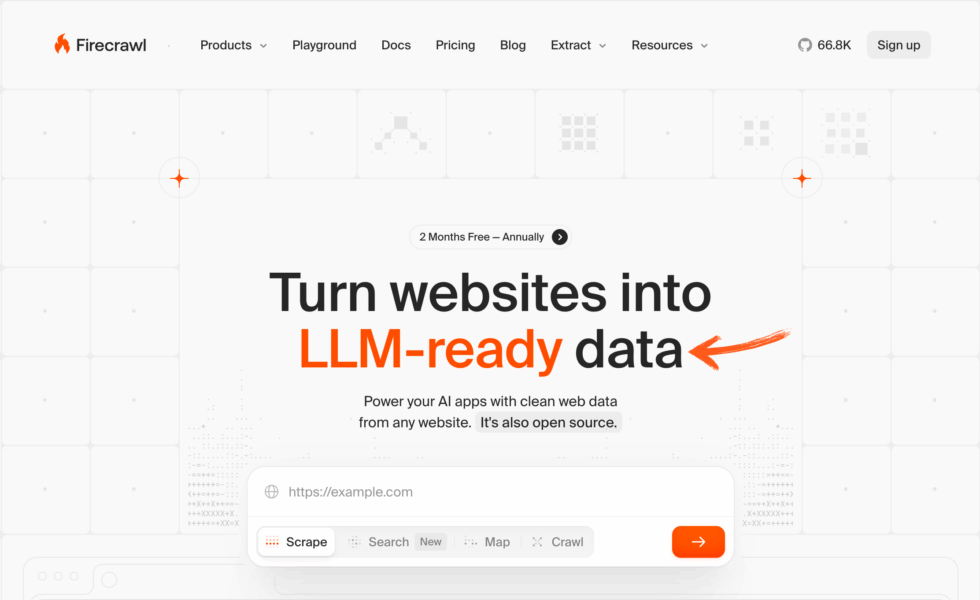
Firecrawl is een door AI aangedreven webcrawler die websites omzet in schone, voor LLM geschikte data.
But most users only scratch the surface of what this versatile tool can do.
This guide shows you how to use every major feature, step by step, with screenshots.
Firecrawl Tutorial
This complete Firecrawl tutorial walks you through every feature, from your first api key to advanced batch operations that make you a power user.
Brandweerkruipen
Turn any website into clean, structured data with a single api. Firecrawl handles javascript rendering, rate limits, and url discovery so you get llm ready data fast. Start on the free plan — no credit card needed.
Getting Started with Firecrawl
Voordat u een functie kunt gebruiken, moet u deze eenmalige installatie voltooien.
Het duurt ongeveer 3 minuten.
Bekijk eerst dit korte overzicht:
Laten we nu elke stap eens doornemen.
Stap 1: Maak uw account aan
Go to the Firecrawl website at https://www.firecrawl.dev.
Click “Sign Up” to open a firecrawl account on the free plan.
Voer uw e-mailadres in en maak een wachtwoord aan.
✓ Controlepunt: Controleer uw inbox voor een bevestigingsmail.
Step 2: Install and Set Your API Key
Run pip install firecrawl-py to add the api service to your project.
Kopieer je API-sleutel en sla deze vervolgens op als een omgevingsvariabele. beveiliging.
Zo ziet het dashboard eruit:
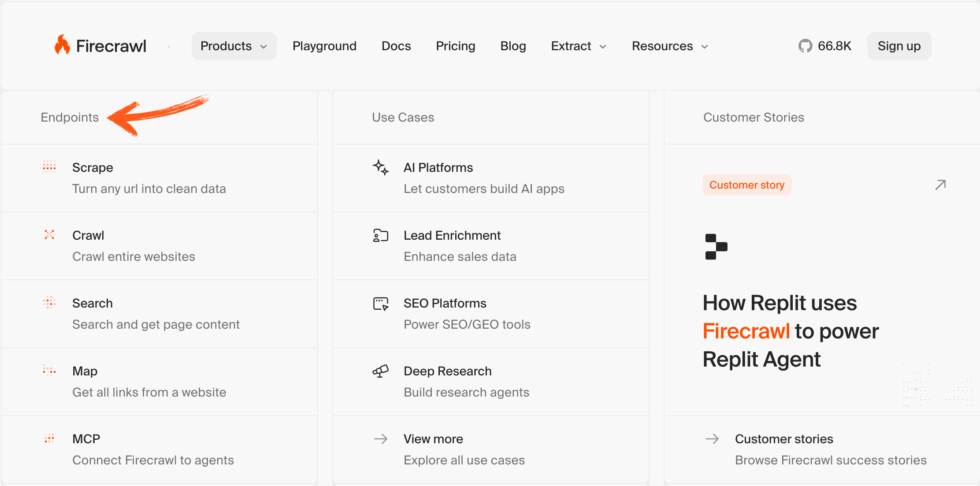
✓ Controlepunt: You should see the main dashboard with your usage and api key.
Stap 3: Maak je eerste telefoongesprek
Import the FirecrawlApp class and create a firecrawl instance with your key.
Every request hits the base endpoint at https://api.firecrawl.dev/v2.
✅ Klaar: You’re ready to scrape, crawl, search, map, and extract data.
Hoe gebruik je de Firecrawl-scraper?
Scrape lets you pull clean, llm ready data from a single page with one single api call.
Scrape mode targets individual pages and is ideal for extracting specific details fast.
Hieronder leggen we stap voor stap uit hoe je het gebruikt.
Laten we nu elke stap eens nader bekijken.
Stap 1: Verkrijg uw API-sleutel
Create a firecrawl account, then copy your api key from the dashboard.
Store it as an environment variable so your api key stays out of your raw code.
Step 2: Call the Scrape Endpoint
Pass a single url to the .scrape_url() method on your firecrawl instance.
You can request markdown format, raw html, or structured json as the output.
Zo ziet het eruit:
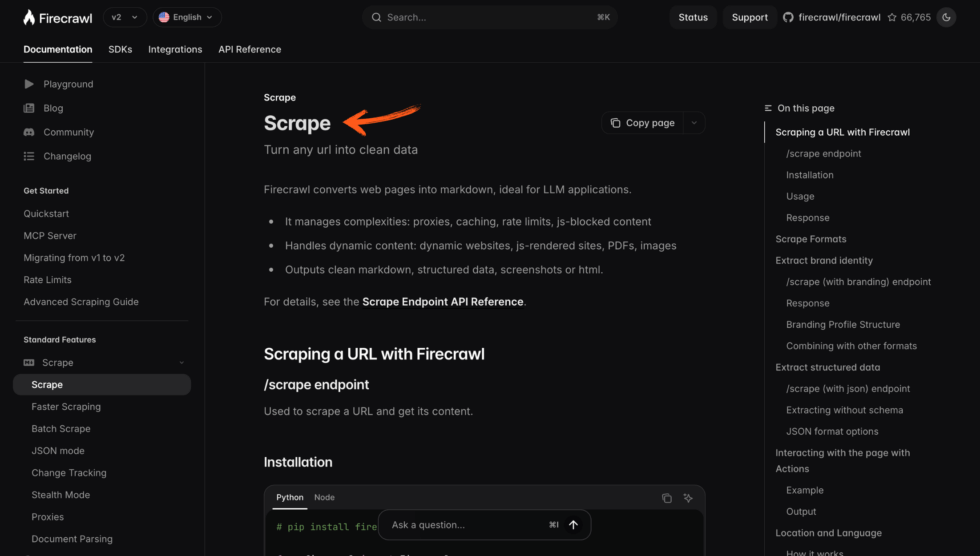
✓ Controlepunt: You should see clean markdown for the current page, ready for ai applications.
Step 3: Read the Clean Output
Firecrawl returns clean data with readable tekst, stripped of junk html tags.
✅ Resultaat: You turned one of the web pages into structured web data with a single api.
💡 Pro-tip: Set the max_age parameter to cache results and skip re-scraping a page that has not changed.
Hoe gebruik je Firecrawl Crawler?
Crawl lets you crawl entire websites and follow links automatically without a sitemap.
Crawl mode lets you crawl websites across multiple pages and collect every reachable page.
Hieronder leggen we stap voor stap uit hoe je het gebruikt.
Laten we nu elke stap eens nader bekijken.
Step 1: Point at a Root URL
Give the crawl endpoint a starting url such as https://example.com.
Firecrawl handles web crawling through links and follows pages on its own.
Step 2: Start the Crawl Job
Launch the crawl job and grab the returned job id to track progress.
Use the job id to poll status and pull crawled data as each page finishes.
Zo ziet het eruit:
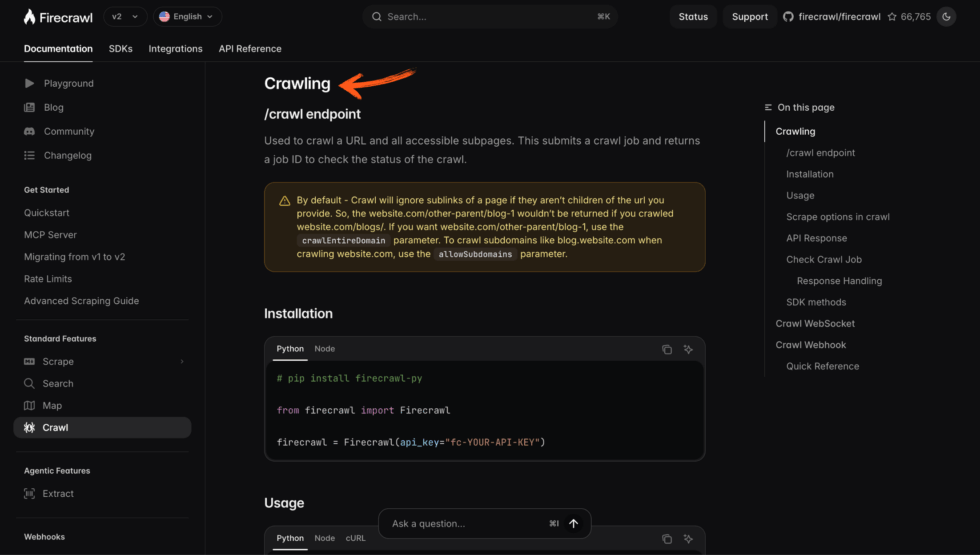
✓ Controlepunt: You should see scraped pages from across the site building into web data.
Stap 3: Exporteer de resultaten
Collect every page as markdown or structured json for your data pipelines.
✅ Resultaat: You captured an entire site, even complex websites with dynamic content.
💡 Pro-tip: Firecrawl uses batch processing and concurrent browsers, so large crawl operations stay fast.
Hoe gebruik je de Firecrawl-zoekmachine?
Zoekopdracht lets you search the web and return clean results you can feed straight into ai agents.
Search lets you query the web and pull back real time web data as readable text.
Hieronder leggen we stap voor stap uit hoe je het gebruikt.
Laten we nu elke stap eens nader bekijken.
Step 1: Send a Query
Call the search endpoint with a plain natural language query.
Firecrawl can search the web across news websites, job boards, and review sites.
Stap 2: Kies het uitvoerformaat
Ask for markdown format or structured json for each result.
Every result arrives as clean data, not noisy raw html.
Zo ziet het eruit:
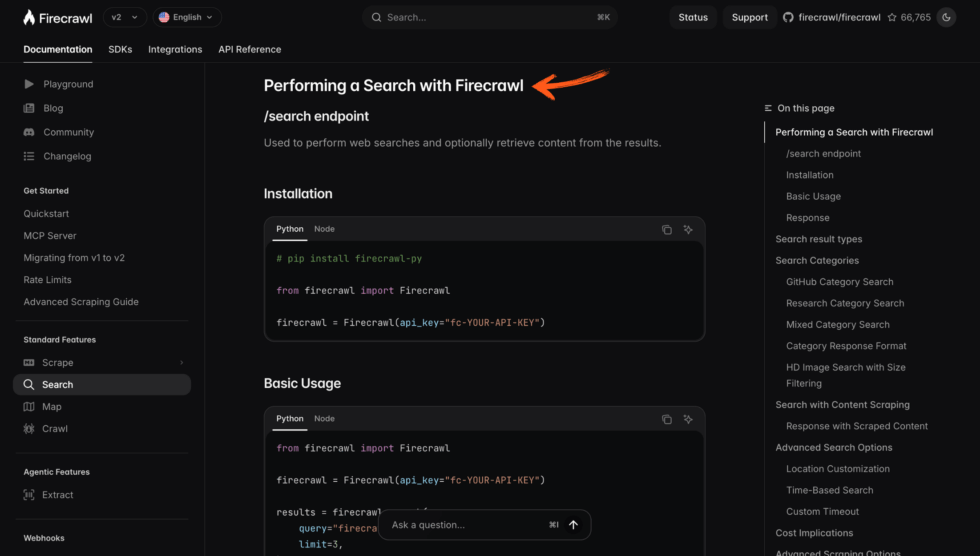
✓ Controlepunt: You should see ranked web pages returned as structured web data.
Step 3: Pipe Into Your App
Feed the structured data into AI-assistenten or ai workflows.
✅ Resultaat: You added live web content to your ai applications in a single api call.
💡 Pro-tip: Pair search with extract to gather news articles for market research or competitive intelligence.
Hoe gebruik je de geavanceerde kaart van Firecrawl?
Map lets you run url discovery and turn one domain into a full map of individual pages.
Map mode retrieves every url on a site quickly for fast url discovery.
Hieronder leggen we stap voor stap uit hoe je het gebruikt.
Laten we nu elke stap eens nader bekijken.
Step 1: Submit the Domain
Pass a single root url to the map endpoint.
Firecrawl returns every link without needing a sitemap.
Step 2: Review the URL List
Scan the returned individual pages before you scrape them.
Save the list to a csv file to plan your data extraction.
Zo ziet het eruit:
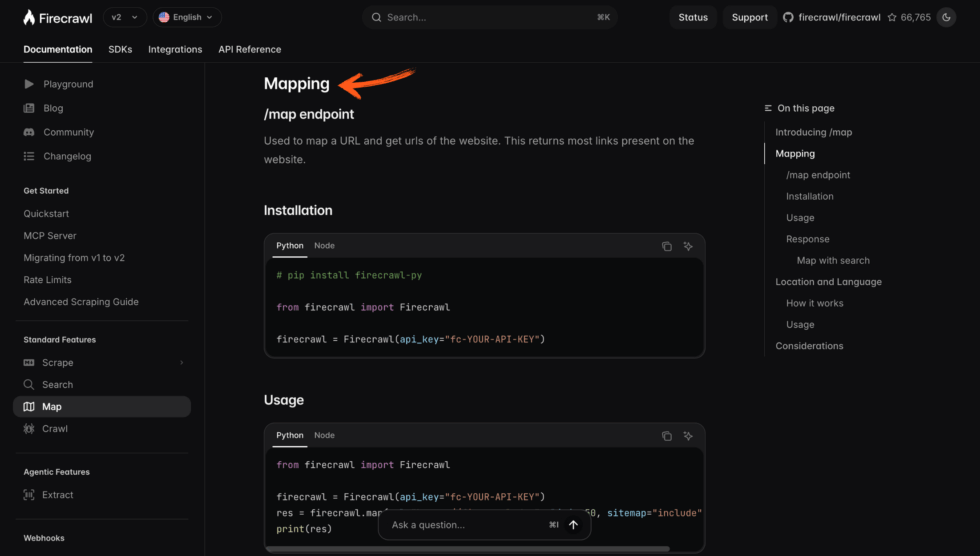
✓ Controlepunt: You should see a full sitemap of web pages from one single url.
Step 3: Select What to Scrape
Pick the pages you want, then send them to scrape or crawl.
✅ Resultaat: You mapped the whole site, ready for targeted web scraping.
💡 Pro-tip: Map first on dynamic websites and web apps to avoid wasting credits on pages you do not need.
Hoe Firecrawl Extractor te gebruiken
Extract lets you extract structured data from any page using natural language prompts.
Extract uses ai powered parsing to pull exactly the fields you describe.
Hieronder leggen we stap voor stap uit hoe je het gebruikt.
Laten we nu elke stap eens nader bekijken.
Step 1: Define a Schema
Write a Pydantic model with: from pydantic import BaseModel.
Schema based extraction tells Firecrawl which fields to return as structured json.
Step 2: Describe the Data
Add natural language prompts for fields a schema cannot capture.
This is how you extract data from web pages without writing parsing rules.
Zo ziet het eruit:
✓ Controlepunt: You should see tidy structured data instead of messy html tags.
Step 3: Receive Structured JSON
Firecrawl returns clean structured json ready for training data.
✅ Resultaat: You replaced fragile scrapers with one extract call and less data cleaning.
💡 Pro-tip: Use only_main_content, include_tags, and exclude_tags to keep the extracted web data focused.
Firecrawl Pro Tips and Shortcuts
After testing Firecrawl for over a year, here are my best tips for cleaner data extraction.
Toetsenbord sneltoetsen
| Actie | Snelkoppeling |
|---|---|
| Run scrape in playground | Ctrl + Enter |
| Copy api key | Ctrl + C |
| Open docs | Ctrl + K |
| Switch output format | Tab |
Verborgen functies die de meeste mensen over het hoofd zien
- max_age caching: Reuse recent crawled data for faster, cheaper repeat scraping.
- Browser actions: Click, scroll, and type to reach content behind javascript rendering.
- Async batching: Process thousands of urls with batch processing without blocking your web apps.
Firecrawl Common Mistakes to Avoid
Mistake #1: Hardcoding your API key
❌ Fout: Pasting your api key directly into shared code or a public repo.
✅ Rechts: Load the key from an environment variable so it stays private.
Mistake #2: Crawling before mapping
❌ Fout: Crawling entire websites blindly and burning credits on junk pages.
✅ Rechts: Run url discovery with map first, then crawl only the pages you need.
Mistake #3: Parsing raw html yourself
❌ Fout: Het handmatig schrijven van strikte regels om ruwe HTML op te schonen en HTML-tags te verwijderen.
✅ Rechts: Gebruik schema-gebaseerde extractie om direct schone, gestructureerde JSON te verkrijgen.
Probleemoplossing voor Firecrawl
Probleem: 401 ongeautoriseerde fouten
Oorzaak: Je API-sleutel ontbreekt of is niet geladen vanuit de omgevingsvariabele.
Repareren: Exporteer de sleutel opnieuw, maak vervolgens uw Firecrawl-instantie opnieuw aan en probeer het nogmaals.
Probleem: Time-outfouten op complexe websites
Oorzaak: Het laden van content die veel JavaScript bevat of dynamisch is, duurt langer.
Repareren: Voeg een wachtactie toe zodat de huidige pagina volledig is geladen voordat de opname plaatsvindt.
Probleem: Limieten voor het aantal aanvragen worden overschreden
Oorzaak: Te veel verzoeken tegelijk op het gratis abonnement of een lager abonnement.
Repareren: Vertraag batchbewerkingen of upgrade voor meer gelijktijdige browsers.
📌 Opmerking: Als geen van deze oplossingen uw probleem verhelpt, neem dan contact op met de Firecrawl-ondersteuning.
Wat is Firecrawl?
Brandweerkruipen is een door AI aangedreven webscrapingtool die websites omzet in schone, gestructureerde data.
Zie het als een webcrawler die AI-agenten leesbare tekst aanlevert in plaats van rommelige, onbewerkte HTML.
Firecrawl is ontwikkeld door Mendable.ai om tokenverspilling bij AI-toepassingen te verminderen.
Bekijk dit korte overzicht:
Het omvat de volgende belangrijke kenmerken:
- Schrapen: Extraheer gegevens van afzonderlijke webpagina's in Markdown-formaat of gestructureerde JSON.
- Kruipen: Doorzoek complete websites en volg links zonder sitemap.
- Zoekopdracht: Zoek op internet naar betrouwbare gegevens van nieuwswebsites en recensiesites.
- Kaart: Snelle URL-detectie waarmee je van één domein een complete sitemap kunt maken.
- Extract: Verzamel gestructureerde webgegevens met behulp van prompts in natuurlijke taal en Pydantic-schema's.
Firecrawl overtreft traditionele webscraping doordat het proxies, snelheidslimieten en JavaScript-rendering voor je afhandelt.
In tegenstelling tot traditionele tools die Selenium vereisen, biedt het datawetenschappers en ontwikkelaars toegang tot één API-service.
Voor een volledige recensie, zie onze Firecrawl recensie.
Prijzen voor Firecrawl
Dit zijn de kosten van Firecrawl in 2026:
| Plan | Prijs | Het beste voor |
|---|---|---|
| Vrij | Vrij | Het scrapen en crawlen testen op een paar pagina's. |
| Hobby | $16/maand | Solo-ontwikkelaars en kleine data-pipelines |
| Standaard | $83/maand | Teams die regelmatig webcrawltaken uitvoeren |
| Groei | $333/maand | Grootschalig marktonderzoek en -monitoring |
Gratis proefperiode: Ja, met het gratis abonnement kun je een beperkt aantal pagina's scrapen.
Geld-terug-garantie: Er is geen officiële garantie, maar u kunt op elk moment downgraden.
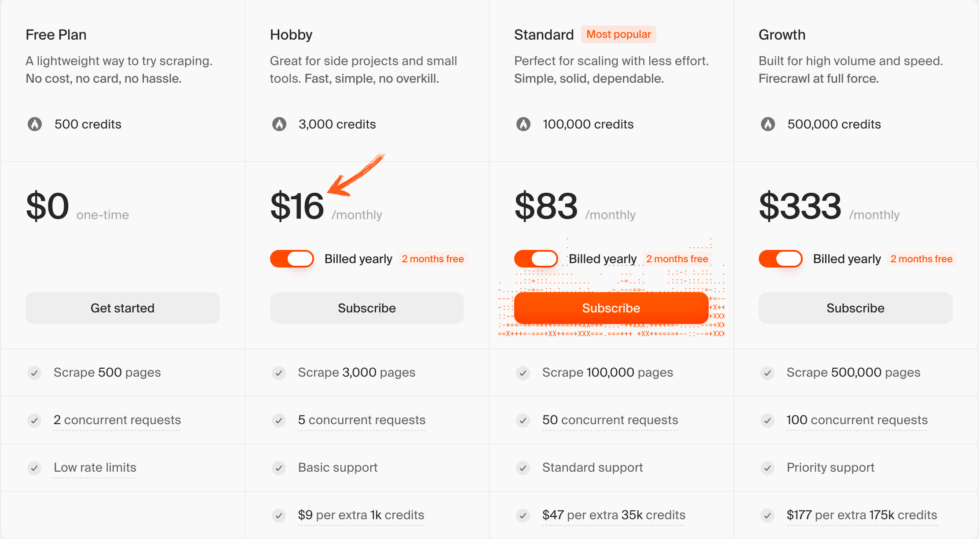
💰 Beste prijs-kwaliteitverhouding: Standaard — de beste balans tussen credits en gelijktijdige browsers voor de meeste teams.
Firecrawl versus alternatieven
Hoe verhoudt Firecrawl zich tot de concurrentie? Hier is een overzicht van de concurrenten:
| Hulpmiddel | Het beste voor | Prijs | Beoordeling |
|---|---|---|---|
| Brandweerkruipen | AI-geschikte, schone data | $16/maand | ⭐ 3,5 |
| Apify | Voorgeprogrammeerde acteurs | $49/maand | ⭐ 4,5 |
| Bright Data | Proxy-schaal | $ Aangepast | ⭐ 4.6 |
| Crawl4AI | Open source | Vrij | ⭐ 4.4 |
| Scrapy | Python-besturing | Vrij | ⭐ 4,5 |
| ScrapeGraphAI | LLM-grafiek scraping | $20/maand | ⭐ 4.3 |
Snelle keuzes:
- Beste overall: Firecrawl — de schoonste LLM-compatibele data van één enkele API.
- Beste budget: Crawl4AI — gratis en open source voor datawetenschappers die graag zelf aan de slag gaan.
- Het meest geschikt voor beginners: Firecrawl — natuurlijke taalprompts verbergen de lastige onderdelen.
- Het meest geschikt voor proxy-schaalvergroting: Bright Data — een enorme proxypool voor complexe websites.
🎯 Alternatieven voor Firecrawl
Op zoek naar alternatieven voor Firecrawl? Dit zijn de beste opties:
- 🚀 Apify: Een marktplaats met vooraf gebouwde actors voor webscraping, handig als je kant-en-klare scrapers via één enkele API wilt gebruiken.
- 🏢 Heldere gegevens: Een bedrijfsnetwerk met proxy's voor grootschalige crawl-taken en contentmonitoring op dynamische websites.
- 💰 Crawl4AI: Gratis, open source crawler die data genereert die geschikt is voor LLM, ideaal voor budgetvriendelijke AI-workflows en lokale tests.
- 🔧 Scrapy: Een beproefd Python-framework dat ontwikkelaars volledige controle geeft over het crawlen, parsen en beheren van datapijplijnen.
- 🧠 ScrapeGraphAI: Grafiekgebaseerde, door AI aangedreven extractie die de paginastructuur in kaart brengt voor schemagebaseerde extractie van gestructureerde data.
Voor de volledige lijst, zie onze Alternatieven voor Firecrawl gids.
⚔️ Firecrawl vergeleken
Hieronder een vergelijking van Firecrawl met de concurrenten:
- Firecrawl versus Apify: Firecrawl wint dankzij de schone, voor LLM geschikte output; Apify wint dankzij de bibliotheek met vooraf gebouwde scrapers.
- Firecrawl versus Bright Data: Bright Data blinkt uit in het extraheren van gegevens op proxyschaal; Firecrawl blinkt uit in het extraheren van eenvoudigere, gestructureerde gegevens.
- Firecrawl versus Crawl4AI: Crawl4AI wint op prijs en zelfhosting; Firecrawl wint op het gebied van beheerde snelheidslimieten en betrouwbaarheid.
- Firecrawl versus Scrapy: Scrapy wint door controle op laag niveau; Firecrawl wint door snelheid en het feit dat er geen proxy's nodig zijn.
- Firecrawl versus ScrapeGraphAI: Beide programma's maken gebruik van AI; Firecrawl blinkt uit in crawl-dekking, ScrapeGraphAI in graflogica.
Begin nu met het gebruik van Firecrawl.
Je hebt geleerd hoe je alle belangrijke functies van Firecrawl kunt gebruiken:
- ✅ Schrapen
- ✅ Kruipen
- ✅ Zoeken
- ✅ Kaart
- ✅ Extract
Volgende stap: Kies één functie en probeer die nu uit.
De meeste mensen beginnen met Scrape.
Het duurt minder dan 5 minuten.
Veelgestelde vragen
Waarvoor wordt Firecrawl gebruikt?
Firecrawl is an ai powered web scraping tool. It turns web pages into clean, llm ready data for ai agents, rag systems, market research, and price monitoring.
Kun je Firecrawl gratis gebruiken?
Yes. The free plan lets you scrape a limited number of pages with your api key, so you can test scrape, crawl, and extract before paying.
How do I install Firecrawl?
Run pip install firecrawl-py, then set your api key as an environment variable and create a firecrawl instance to start your first single api call.
How is Firecrawl different from traditional scraping?
Traditional web scraping needs Selenium and manual proxy setup. Firecrawl handles javascript rendering, rate limits, and clean data automatically through one api service.
Can Firecrawl extract structured data?
Yes. Use natural language prompts or a Pydantic schema for schema based extraction, and Firecrawl returns structured json instead of raw html.













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
