
เริ่มต้นใช้งานอย่างรวดเร็ว
คู่มือนี้ครอบคลุมทุกคุณสมบัติของ Web Scraper:
- เริ่มต้นใช้งาน — สร้างบัญชีและตั้งค่าพื้นฐาน
- วิธีใช้งานอินเทอร์เฟซแบบชี้และคลิก — สร้างโปรแกรมดึงข้อมูลแบบเห็นภาพได้โดยไม่ต้องเขียนโค้ด
- วิธีใช้งานการดึงข้อมูล — ดึงข้อมูลที่มีโครงสร้างจากหน้าใดก็ได้บนเว็บไซต์
- วิธีใช้งาน Handle JavaScript Sites — ดึงข้อมูลจากหน้าเว็บแบบไดนามิกที่โหลดเนื้อหาด้วย JavaScript
- วิธีใช้งานข้อมูลที่ปรับแต่งเอง — ปรับแต่งและทำความสะอาดแถวข้อมูลที่ดึงมา ก่อนส่งออก
- วิธีใช้งานการส่งออกข้อมูล — บันทึกผลลัพธ์เป็นไฟล์ CSV, XLSX หรือ JSON
ระยะเวลาที่ใช้: แต่ละฟีเจอร์ใช้เวลา 5 นาที
นอกจากนี้ในคู่มือนี้ยังมี: เคล็ดลับสำหรับมืออาชีพ | ข้อผิดพลาดที่พบบ่อย | การแก้ไขปัญหา | ความละเอียด | ตัวเลือกต่าง ๆ
เหตุใดจึงควรเชื่อถือคู่มือนี้
ฉันใช้ Web Scraper มานานกว่าหกเดือนแล้ว และได้ทดสอบทุกฟีเจอร์ในบทช่วยสอนนี้ บทความนี้มาจากประสบการณ์จริง ไม่ใช่คำโฆษณาชวนเชื่อ

Web Scraper เป็นหนึ่งในเครื่องมือแนะนำที่ใช้งานง่ายที่สุดสำหรับผู้เริ่มต้นใช้งานบนเว็บเบราว์เซอร์ ข้อมูล การสกัด
แต่ผู้ใช้ส่วนใหญ่รู้จักเพียงแค่ส่วนน้อยของสิ่งที่มันทำได้เท่านั้น
คู่มือนี้จะแสดงวิธีการใช้งาน WebScraper ทีละขั้นตอน
ทุกฟีเจอร์ได้รับการอธิบายพร้อมภาพหน้าจอและเคล็ดลับที่เป็นประโยชน์
บทช่วยสอนการใช้ Web Scraper
บทแนะนำการใช้งาน Web Scraper ฉบับสมบูรณ์นี้จะพาคุณเรียนรู้ทุกฟีเจอร์ทีละขั้นตอน ตั้งแต่การตั้งค่าเริ่มต้นไปจนถึงวิธีการขั้นสูงที่จะทำให้คุณเป็นผู้ใช้งานระดับมืออาชีพ
เว็บสแครปเปอร์
ดึงข้อมูลจากเว็บไซต์โดยตรงจากเบราว์เซอร์ของคุณโดยไม่ต้องเขียนโค้ด Web Scraper ช่วยให้คุณดึงข้อมูลจากเว็บไซต์ใดก็ได้และส่งออกเป็นไฟล์ CSV, XLSX หรือ JSON เริ่มใช้งานฟรี — ไม่ต้องใช้บัตรเครดิต
เริ่มต้นใช้งาน Web Scraper
ก่อนใช้งานฟีเจอร์ใดๆ โปรดทำการตั้งค่าครั้งแรกนี้ให้เสร็จสมบูรณ์
ใช้เวลาประมาณ 3 นาที
โปรดชมภาพรวมโดยย่อนี้ก่อน:
ต่อไปนี้เราจะมาดูแต่ละขั้นตอนกัน
ขั้นตอนที่ 1: สร้างบัญชีของคุณ
เข้าไปที่เว็บไซต์ Web Scraper ที่ https://webscraper.io/ ในเบราว์เซอร์ของคุณ
คลิก "ลงทะเบียน" หรือ "เริ่มทดลองใช้งานฟรี"
กรอกอีเมลและสร้างรหัสผ่านเพื่อตั้งค่าบัญชีของคุณ
✓ ด่าน: ตรวจสอบของคุณ จดหมายเข้า สำหรับอีเมลยืนยัน
ขั้นตอนที่ 2: ติดตั้งส่วนขยายเบราว์เซอร์
เปิด Chrome Web Store แล้วค้นหา "Web Scraper" เพื่อหาโปรแกรมเสริม
คลิก "เพิ่มไปยัง Chrome" และยืนยันการดาวน์โหลด
ส่วนขยายนี้ใช้งานได้บนเดสก์ท็อป Windows, macOS และ Linux ด้วยเช่นกัน
นี่คือหน้าตาของแดชบอร์ด:
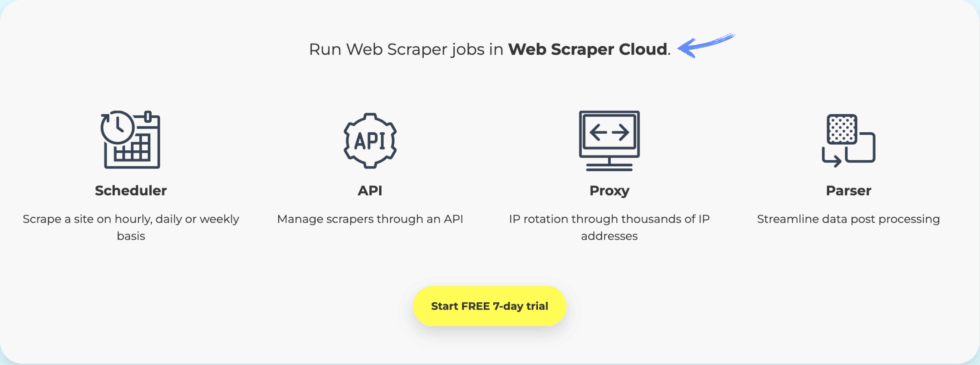
✓ ด่าน: คุณควรจะเห็นแท็บ Web Scraper ใน DevTools
ขั้นตอนที่ 3: ดำเนินการตั้งค่าเริ่มต้นให้เสร็จสมบูรณ์
เปิด DevTools (F12) แล้วคลิกแท็บ Web Scraper เพื่อโหลดอินเทอร์เฟซ
สร้างแผนผังเว็บไซต์ (sitemap) แรกของคุณโดยการวาง URL ของเว็บไซต์ที่คุณต้องการดึงข้อมูลลงไป
✅ เสร็จเรียบร้อยแล้ว: คุณพร้อมที่จะใช้งานฟีเจอร์ต่างๆ ด้านล่างแล้ว
วิธีใช้งาน Web Scraper ด้วยระบบคลิกเมาส์
อินเทอร์เฟซแบบชี้และคลิก ช่วยให้คุณสร้างโปรแกรมดึงข้อมูลหน้าเว็บได้ด้วยวิธีแบบเห็นภาพ โดยการเลือกองค์ประกอบที่ถูกต้องบนหน้าเว็บ
นี่คือวิธีการใช้งานทีละขั้นตอน
ขั้นตอนที่ 1: เปิดโปรแกรมแก้ไขแผนผังเว็บไซต์
เข้าไปที่เว็บไซต์ที่คุณต้องการดึงข้อมูลในเบราว์เซอร์ของคุณ
เปิด DevTools แล้วคลิกแท็บ Web Scraper เพื่อเริ่มต้น
ขั้นตอนที่ 2: เลือกองค์ประกอบด้วยสายตา
คลิก "เพิ่มตัวเลือกใหม่" และเลือกประเภทตัวเลือกของคุณ
คลิกโดยตรงที่องค์ประกอบของหน้าเว็บที่คุณต้องการดึงข้อมูล
Web Scraper จะไฮไลต์องค์ประกอบที่ถูกต้องและแนะนำตัวเลือก CSS ให้คุณ
ตัวอย่างเช่น การคลิกที่ชื่อผลิตภัณฑ์จะสร้างตัวเลือกที่ตรงกันโดยอัตโนมัติ
นี่คือหน้าตาของมัน:
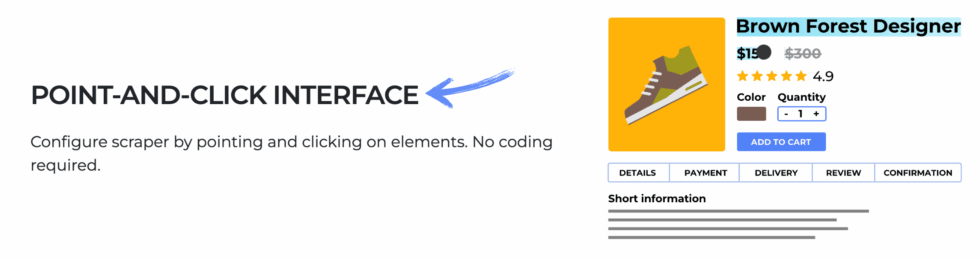
✓ ด่าน: คุณควรเห็นไฮไลต์สีเขียวบนองค์ประกอบที่คุณเลือก
ขั้นตอนที่ 3: บันทึกตัวเลือกของคุณ
คลิก "เลือกเสร็จแล้ว" จากนั้นกด "บันทึกตัวเลือก" เพื่อยืนยัน
โปรแกรมดึงข้อมูลจะจัดเก็บรูปแบบตัวเลือก CSS เพื่อใช้ค้นหาองค์ประกอบในทุกหน้าเว็บ
✅ ผลลัพธ์: โปรแกรมดึงข้อมูลแบบภาพของคุณพร้อมแล้วที่จะดึงข้อมูลโดยไม่ต้องเขียนโค้ด
💡 เคล็ดลับสำหรับมืออาชีพ: ใช้ฟังก์ชัน "แสดงตัวอย่างองค์ประกอบ" เพื่อตรวจสอบว่าตัวเลือกของคุณดึงข้อมูลที่ถูกต้องก่อนที่จะทำการดึงข้อมูลแบบเต็มรูปแบบ
วิธีใช้โปรแกรม Web Scraper เพื่อดึงข้อมูล
ดึงข้อมูล ช่วยให้คุณดึงข้อมูลที่มีโครงสร้างจากหน้าเว็บใดๆ ได้โดยอัตโนมัติ
นี่คือวิธีการใช้งานทีละขั้นตอน
ขั้นตอนที่ 1: กำหนดค่าตัวเลือกของคุณ
ตั้งค่าตัวเลือกสำหรับแต่ละจุดข้อมูล — ข้อความลิงก์ รูปภาพ หรือส่วนหัว HTML
ใช้โครงสร้างตัวเลือกแบบต้นไม้เพื่อนำทางไปยังองค์ประกอบย่อยต่างๆ ในโครงสร้างหน้าเว็บ
ขั้นตอนที่ 2: เรียกใช้การดึงข้อมูล (Scrape)
คลิก "Scrape" แล้วตั้งค่าช่วงเวลาการร้องขอและเวลาหน่วงในการโหลดหน้าเว็บ
โปรแกรมดึงข้อมูลจะส่งคำขอไปยัง URL แต่ละแห่งและเริ่มต้นกระบวนการดึงข้อมูล
นี่คือหน้าตาของมัน:
✓ ด่าน: คุณควรจะเห็นแถวข้อมูลที่ดึงออกมาปรากฏในหน้าตัวอย่าง
ขั้นตอนที่ 3: ตรวจสอบผลลัพธ์ของคุณ
คลิก “เรียกดูเพื่อตรวจสอบข้อมูลที่ดึงมาในมุมมองตาราง
ตรวจสอบให้แน่ใจว่าทุกคอลัมน์ตรงกับข้อมูลที่คุณต้องการรวบรวม
✅ ผลลัพธ์: คุณมีข้อมูลที่สะอาดและเป็นระเบียบพร้อมสำหรับการส่งออกแล้ว
💡 เคล็ดลับสำหรับมืออาชีพ: ตั้งค่าหน่วงเวลา 2 วินาทีระหว่างการส่งคำขอแต่ละครั้ง เพื่อหลีกเลี่ยงการถูกจำกัดอัตราการใช้งานบนเว็บไซต์เป้าหมาย
วิธีใช้งาน Web Scraper เพื่อจัดการกับเว็บไซต์ที่ใช้ JavaScript
จัดการเว็บไซต์ JavaScript ช่วยให้คุณสามารถดึงข้อมูลจากหน้าเว็บแบบไดนามิกที่โหลดเนื้อหาโดยใช้ JavaScript ได้
นี่คือวิธีการใช้งานทีละขั้นตอน
ขั้นตอนที่ 1: ระบุเนื้อหาแบบไดนามิก
ตรวจสอบว่าหน้าเว็บโหลดข้อมูลหลังจาก HTML เริ่มต้นเสร็จสมบูรณ์หรือไม่ โดยดูจากโครงสร้างโหนด
คุณอาจต้องตรวจสอบองค์ประกอบ HTML ด้วยตนเองเพื่อยืนยันว่าองค์ประกอบใดโหลดช้า
หากเนื้อหาปรากฏขึ้นหลังจาก JavaScript ทำงานเสร็จสิ้นเท่านั้น คุณจำเป็นต้องใช้คุณสมบัตินี้
ขั้นตอนที่ 2: เปิดใช้งานการแสดงผล JavaScript
ใน Web Scraper Cloud ให้เลือก “การแสดงผล JavaScript แบบเต็ม” ในการตั้งค่าแผนผังเว็บไซต์ของคุณ
ตั้งค่าเวลาการรอโหลดหน้าเว็บเพื่อให้องค์ประกอบทั้งหมดแสดงผลอย่างสมบูรณ์ก่อนที่การดึงข้อมูลจะเริ่มต้นขึ้น
นี่คือหน้าตาของมัน:
✓ ด่าน: หน้าตัวอย่างควรแสดงเนื้อหาที่โหลดแบบไดนามิก
ขั้นตอนที่ 3: ทดสอบและใช้งาน
ทดสอบการดึงข้อมูลจากหน้าเว็บเพียงหน้าเดียวเพื่อยืนยันว่าสคริปต์สามารถดึงข้อมูลทุกองค์ประกอบได้
เมื่อตรวจสอบเรียบร้อยแล้ว ให้เรียกใช้การดึงข้อมูลแบบเต็มรูปแบบกับทุกหน้าเป้าหมายบนเว็บไซต์
✅ ผลลัพธ์: ตอนนี้คุณสามารถดึงข้อมูลจากเว็บไซต์ที่มี JavaScript จำนวนมากได้อย่างมืออาชีพแล้ว
💡 เคล็ดลับสำหรับมืออาชีพ: หากเว็บไซต์ใช้การเลื่อนแบบไม่สิ้นสุด ให้เพิ่มตัวเลือก "เลื่อนลง" เพื่อโหลดเนื้อหาทั้งหมดก่อนเริ่มการดึงข้อมูล
วิธีใช้งาน Web Scraper และปรับแต่งข้อมูล
ปรับแต่งข้อมูล ช่วยให้คุณสามารถปรับแต่ง ทำความสะอาด และแก้ไขข้อมูลที่ดึงมาได้ก่อนที่จะบันทึก
นี่คือวิธีการใช้งานทีละขั้นตอน
ขั้นตอนที่ 1: เปิดการแสดงตัวอย่างข้อมูล
หลังจากทำการดึงข้อมูลเสร็จแล้ว ให้คลิก "เรียกดู" เพื่อดูตารางข้อมูลดิบ
ตรวจสอบแต่ละคอลัมน์และจดบันทึกแถวที่ต้องแก้ไข
ขั้นตอนที่ 2: ใช้ Regex หรือตัวกรองข้อความ
ใช้ตัวเลือก “Regex” ในตัวเลือกของคุณเพื่อแยกวิเคราะห์และตัดข้อความที่ไม่ต้องการออก
นี่คือการจับคู่รูปแบบที่ยืดหยุ่นซึ่งทำความสะอาดข้อมูลในตำแหน่งเดิม
นี่คือหน้าตาของมัน:
✓ ด่าน: ขณะนี้คอลัมน์ข้อมูลของคุณควรแสดงเฉพาะค่าที่ล้างแล้วเท่านั้น
ขั้นตอนที่ 3: เปลี่ยนชื่อและจัดลำดับคอลัมน์ใหม่
แก้ไขชื่อตัวเลือกเพื่อให้แต่ละคอลัมน์มีป้ายกำกับหัวเรื่องที่ชัดเจนและคุ้นเคย
จัดเรียงลำดับตัวเลือกในแผนผังเว็บไซต์ใหม่ให้ตรงกับโครงสร้างผลลัพธ์สุดท้ายของคุณ
✅ ผลลัพธ์: ข้อมูลของคุณสะอาด มีการติดป้ายกำกับ และพร้อมสำหรับการส่งออกหรือวิเคราะห์แล้ว
💡 เคล็ดลับสำหรับมืออาชีพ: ใช้ช่องทำเครื่องหมาย "หลายรายการ" บนตัวเลือกเพื่อดึงองค์ประกอบที่ตรงกันทั้งหมดมาเป็นแถวแยกกันในผลลัพธ์
วิธีใช้งาน Web Scraper เพื่อส่งออกข้อมูล
ข้อมูลการส่งออก ช่วยให้คุณบันทึกผลลัพธ์ที่ดึงข้อมูลได้เป็นไฟล์ CSV, XLSX หรือ JSON
นี่คือวิธีการใช้งานทีละขั้นตอน
ขั้นตอนที่ 1: ขูดผิวให้เสร็จ
รอจนกว่าการดึงข้อมูลจะเสร็จสมบูรณ์ จากนั้นคลิก "เรียกดู" เพื่อดูตัวอย่างข้อมูล
ตรวจสอบให้แน่ใจว่าทุกแถวและทุกคอลัมน์มีค่าตรงตามที่คุณคาดหวัง
ขั้นตอนที่ 2: เลือกรูปแบบการส่งออกของคุณ
คลิกปุ่มส่งออก แล้วเลือก CSV, XLSX หรือ JSON จากรายการรูปแบบ
สำหรับผู้ใช้ส่วนใหญ่ ไฟล์ CSV เป็นตัวเลือกที่ยืดหยุ่นและได้รับการสนับสนุนอย่างกว้างขวางที่สุด
นี่คือหน้าตาของมัน:
✓ ด่าน: คุณจะเห็นข้อความแจ้งให้ดาวน์โหลดปรากฏในเบราว์เซอร์ของคุณ
ขั้นตอนที่ 3: บันทึกไฟล์
เลือกโฟลเดอร์ในคอมพิวเตอร์ของคุณแล้วบันทึกไฟล์ที่ส่งออก
เปิดไฟล์ด้วย Excel, Google Sheets หรือโปรแกรมใดๆ ที่สามารถอ่านไฟล์ CSV เพื่อตรวจสอบและพิมพ์ข้อมูล
✅ ผลลัพธ์: ข้อมูลที่คุณดึงมาได้ถูกบันทึกไว้ในเครื่องของคุณและพร้อมใช้งานแล้ว
💡 เคล็ดลับสำหรับมืออาชีพ: บน Web Scraper Cloud คุณสามารถใช้ API หรือ webhook เพื่อส่งข้อมูลที่ส่งออกไปยัง Dropbox หรือ Google Drive โดยอัตโนมัติ
เคล็ดลับและทางลัดสำหรับการใช้ Web Scraper ระดับมืออาชีพ
หลังจากทดสอบใช้งาน Web Scraper มานานกว่าหกเดือน นี่คือเคล็ดลับที่ดีที่สุดของผม
ผลตอบรับจากผู้ใช้ในฟอรัมยืนยันว่าทางลัดเหล่านี้ช่วยประหยัดเวลาได้มากที่สุด
แป้นพิมพ์ลัด
| การกระทำ | ทางลัด |
|---|---|
| เปิด DevTools | เอฟ12 |
| ตรวจสอบองค์ประกอบ | Ctrl + Shift + C |
| สลับคอนโซล | เอส |
| โหลดหน้าเว็บใหม่ | Ctrl + R |
คุณสมบัติที่ซ่อนอยู่ซึ่งคนส่วนใหญ่มองข้ามไป
- นำเข้า/ส่งออกแผนผังเว็บไซต์: คัดลอกและวางแผนผังเว็บไซต์ JSON เพื่อโคลนโปรแกรมดึงข้อมูลอย่างรวดเร็ว หรือแชร์กับทีมของคุณในรูปแบบโพสต์ในโฟลเดอร์โครงการของคุณ
- ตัวเลือกการแบ่งหน้า: เพิ่มตัวเลือกการเชื่อมโยงสำหรับปุ่ม "ถัดไป" เพื่อนำทางไปยังผลการค้นหาหลายหน้าโดยอัตโนมัติและดึงข้อมูลจากทุกหน้า
- การดึงข้อมูลตามกำหนดเวลา: ใช้ Web Scraper Cloud เพื่อเรียกใช้การดึงข้อมูลตามกำหนดเวลาที่ตั้งไว้ และรับข้อมูลใหม่ๆ ส่งตรงไปยังกล่องจดหมายหรือเว็บฮุคของบริการของคุณ
ข้อผิดพลาดทั่วไปที่ควรหลีกเลี่ยงในการใช้ Web Scraper
ข้อผิดพลาดที่ 1: การดึงข้อมูลเร็วเกินไปโดยไม่มีการหน่วงเวลา
❌ ผิด: การเรียกใช้คำสั่ง scraping โดยไม่มีความล่าช้าใดๆ จะทำให้เกิดการบล็อก IP และข้อความแสดงข้อผิดพลาดจากเซิร์ฟเวอร์
✅ ด้านขวา: ตั้งค่าความหน่วงขั้นต่ำ 2000 มิลลิวินาทีระหว่างการร้องขอแต่ละครั้ง เพื่อจำลองรูปแบบการท่องเว็บของมนุษย์
ข้อผิดพลาดที่ 2: การใช้ประเภทตัวเลือกที่ไม่ถูกต้อง
❌ ผิด: ใช้ตัวเลือก “Text” เมื่อคุณต้องการแยกค่าลิงก์ href หรือ URL รูปภาพจากองค์ประกอบต่างๆ
✅ ด้านขวา: เลือกประเภทตัวเลือกให้ตรงกับข้อมูลของคุณ — ใช้ 'Link' สำหรับ URL และ 'Image' สำหรับรูปภาพ
ข้อผิดพลาดที่ 3: การไม่ปฏิบัติตามกฎในไฟล์ robots.txt
❌ ผิด: การคัดลอกข้อมูลจากหน้าเว็บที่ถูกบล็อกโดย robots.txt อาจนำไปสู่ปัญหาทางกฎหมายสำหรับธุรกิจได้
✅ ด้านขวา: ตรวจสอบไฟล์ robots.txt ทุกครั้งก่อนทำการดึงข้อมูล เพื่อให้เป็นไปตามข้อกำหนดและหลีกเลี่ยงปัญหา
การแก้ไขปัญหาเว็บสแครปเปอร์
ปัญหา: โปรแกรมดึงข้อมูลส่งคืนข้อมูลว่างเปล่า
สาเหตุ: ตัวเลือก CSS เหล่านั้นกำลังกำหนดเป้าหมายไปยังองค์ประกอบที่ไม่มีอยู่บนหน้าเว็บอีกต่อไปแล้ว
แก้ไข: ตรวจสอบหน้าเว็บในเบราว์เซอร์ของคุณอีกครั้ง อัปเดตตัวเลือก (selectors) และทำการทดสอบการดึงข้อมูล (scrape)
ปัญหา: เนื้อหา JavaScript โหลดไม่ขึ้น
สาเหตุ: ส่วนขยายเบราว์เซอร์ฟรีนี้ไม่สามารถเรียกใช้ JavaScript ในหน้าเว็บที่จำเป็นต้องใช้ได้
แก้ไข: เปลี่ยนมาใช้ Web Scraper Cloud ซึ่งรองรับการแสดงผล JavaScript อย่างเต็มรูปแบบสำหรับเว็บไซต์แบบไดนามิก
ปัญหา: IP ถูกบล็อกระหว่างการเก็บข้อมูล
สาเหตุ: การส่งคำขอจำนวนมากเกินไปและเร็วเกินไปจะทำให้ระบบป้องกันบอทของเว็บไซต์เป้าหมายทำงาน
แก้ไข: เพิ่มการตั้งค่าการหน่วงเวลาเป็นอย่างน้อย 3 วินาที และใช้การหมุนพร็อกซีหากมีให้ใช้งาน
📌 บันทึก: หากวิธีเหล่านี้ไม่สามารถแก้ไขปัญหาของคุณได้ โปรดติดต่อฝ่ายสนับสนุนของ Web Scraper เพื่อขอคำตอบสำหรับปัญหาเฉพาะของคุณ
Web Scraper คืออะไร?
เว็บสแครปเปอร์ เป็นเว็บ เครื่องมือขูด ที่ช่วยให้คุณดึงข้อมูลจากเว็บไซต์ใดก็ได้โดยใช้เบราว์เซอร์ของคุณ
ลองนึกภาพว่ามันเป็นเครื่องมือคัดลอกและวางอัจฉริยะสำหรับเว็บทั้งเว็บ ที่จัดระเบียบข้อมูลเป็นแถวและคอลัมน์
ชมภาพรวมโดยย่อนี้:
ประกอบด้วยคุณสมบัติหลักดังต่อไปนี้:
- อินเทอร์เฟซแบบชี้และคลิก: สร้างโปรแกรมดึงข้อมูลแบบเห็นภาพได้โดยไม่ต้องเขียนโค้ด Python หรือโค้ดใดๆ
- ดึงข้อมูล: ดึงข้อความ ลิงก์ และ URL รูปภาพจากเว็บเพจใดก็ได้โดยอัตโนมัติ
- จัดการเว็บไซต์ที่ใช้ JavaScript: ดึงข้อมูลเนื้อหาแบบไดนามิกที่โหลดผ่านคำขอ JavaScript หรือ Ajax
- ปรับแต่งข้อมูล: ทำความสะอาด กรอง และปรับแต่งข้อมูลที่ดึงมาได้ก่อนบันทึก
- ส่งออกข้อมูล: ดาวน์โหลดผลลัพธ์ของคุณในรูปแบบ CSV, XLSX หรือ JSON ได้ในคลิกเดียว
สำหรับรีวิวฉบับเต็ม โปรดดูที่หน้าของเรา รีวิว Web Scraper.
ราคาโปรแกรมดึงข้อมูลจากเว็บไซต์
นี่คือราคาของ Web Scraper ในปี 2026:
| วางแผน | ราคา | เหมาะสำหรับ |
|---|---|---|
| ฟรี | ฟรี | ผู้ใช้งานทั่วไปทดสอบการดึงข้อมูลขนาดเล็ก |
| โครงการ | 40 ดอลลาร์ต่อเดือน | ฟรีแลนซ์ ดำเนินการสแกนข้อมูลเป็นประจำ |
| มืออาชีพ | 80 ดอลลาร์ต่อเดือน | ทีมที่ต้องการใช้งานโปรแกรมดึงข้อมูลหลายตัวพร้อมกัน |
| มาตราส่วน | 167 ดอลลาร์/เดือน | หน่วยงานที่รับผิดชอบการดึงข้อมูลปริมาณมาก |
| องค์กร | กำหนดเอง | ธุรกิจขนาดใหญ่ที่มีความต้องการการดึงข้อมูลแบบกำหนดเอง |
ระดับฟรี: ใช่แล้ว ส่วนขยายเบราว์เซอร์นี้ใช้งานได้ฟรีโดยสมบูรณ์และไม่มีกำหนดเวลาใช้งาน
รับประกันคืนเงิน: ติดต่อฝ่ายสนับสนุนภายใน 14 วันเพื่อขอรับเงินคืนสำหรับแพ็กเกจที่ชำระเงินแล้ว
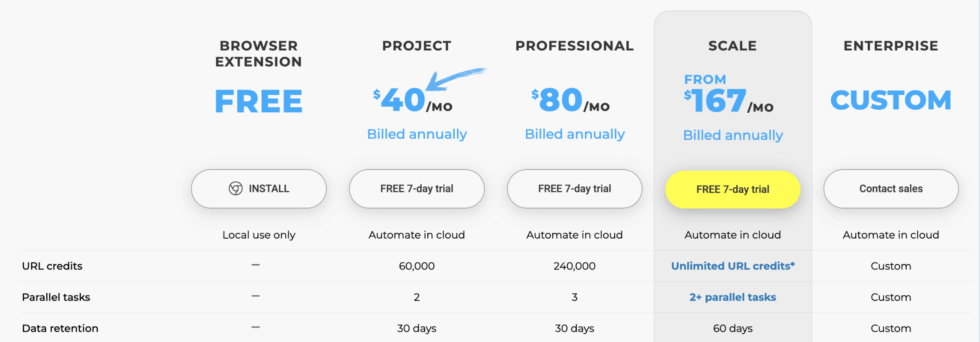
💰 คุ้มค่าที่สุด: แผนโครงการ — ให้คุณได้ใช้บริการดึงข้อมูลจากคลาวด์และการเรียกใช้งานตามกำหนดเวลาในราคาที่ต่ำที่สุด
โปรแกรมดึงข้อมูลจากเว็บไซต์ (Web Scraper) เทียบกับทางเลือกอื่นๆ
Web Scraper เป็นอย่างไรเมื่อเทียบกับตัวอื่น? นี่คือภาพรวมของคู่แข่ง:
| เครื่องมือ | เหมาะสำหรับ | ราคา | การให้คะแนน |
|---|---|---|---|
| เว็บสแครปเปอร์ | การดึงข้อมูลจากเบราว์เซอร์ | ฟรี+ | ⭐ 3.5 |
| อ็อกโทพาร์ส | การดึงข้อมูลภาพโดยไม่ต้องเขียนโค้ด | 89 ดอลลาร์/เดือน | ⭐ 4.3 |
| พาร์สฮับ | การขูดข้อมูลหลายระดับที่ซับซ้อน | 189 ดอลลาร์/เดือน | ⭐ 4.2 |
| สแครปปี้ | นักพัฒนา Python จำนวนมาก | ฟรี | ⭐ 4.5 |
| อะพิฟาย | การดึงข้อมูลจากคลาวด์โดยใช้แอคเตอร์ | 49 ดอลลาร์/เดือน | ⭐ 4.4 |
ตัวเลือกที่น่าสนใจ:
- ดีที่สุดโดยรวม: โปรแกรมดึงข้อมูลจากเว็บไซต์ — มีเวอร์ชันฟรีและใช้งานง่ายในรูปแบบส่วนขยายเบราว์เซอร์สำหรับผู้ใช้ส่วนใหญ่
- งบประมาณที่ดีที่สุด: Scrapy — ซอฟต์แวร์โอเพนซอร์สฟรีสำหรับนักพัฒนา Python
- เหมาะสำหรับผู้เริ่มต้น: Octoparse — อินเทอร์เฟซแบบลากและวาง พร้อมเทมเพลตสำเร็จรูป
- เหมาะที่สุดสำหรับการดึงข้อมูลจากคลาวด์: Apify — ผู้เล่นทรงอิทธิพลและผู้ให้บริการ API ในโลกของการดึงข้อมูลจากเว็บไซต์
🎯 ทางเลือกอื่นนอกเหนือจาก Web Scraper
กำลังมองหาทางเลือกอื่นแทน Web Scraper อยู่ใช่ไหม? นี่คือตัวเลือกที่ดีที่สุด:
- 🚀 อ็อกโทพาร์ส: โปรแกรมดึงข้อมูลแบบไม่ต้องเขียนโค้ด พร้อมขั้นตอนการทำงานแบบเห็นภาพ ผู้สร้างเทมเพลตสำเร็จรูป และบริการคลาวด์สำหรับธุรกิจทุกขนาด
- 💰 ParseHub: จัดการกับเว็บไซต์ที่ซับซ้อนซึ่งมีการนำทางหลายระดับและการโหลดแบบ AJAX ได้อย่างดีเยี่ยม เหมาะสำหรับผู้ใช้ที่ต้องการดึงข้อมูลขั้นสูงโดยไม่ต้องเขียนโค้ด
- 🔧 สแครปปี้: เฟรมเวิร์ก Python แบบโอเพนซอร์สที่สร้างขึ้นสำหรับนักพัฒนาที่ต้องการการควบคุมอย่างเต็มที่ การผสานรวม Soup ที่สวยงาม และการดึงข้อมูลขนาดใหญ่
- ⚡ อะพิฟาย: แพลตฟอร์มบนคลาวด์ที่มีตลาดรวมเครื่องมือดึงข้อมูลสำเร็จรูป และ API ที่ยืดหยุ่นสำหรับนักพัฒนาและทีมงานทั่วโลก
ดูรายชื่อทั้งหมดได้ที่หน้าของเรา ทางเลือกอื่นนอกเหนือจาก Web Scraper แนะนำ.
⚔️ เปรียบเทียบโปรแกรมดึงข้อมูลจากเว็บไซต์
ต่อไปนี้คือวิธีเปรียบเทียบ Web Scraper กับคู่แข่งแต่ละราย:
- Web Scraper กับ Octoparse: Web Scraper เป็นโปรแกรมฟรีและใช้งานได้บนเบราว์เซอร์ ส่วน Octoparse นั้นมีประสิทธิภาพมากกว่าด้วยแอปพลิเคชันบนเดสก์ท็อปและเครื่องมือบนคลาวด์สำหรับโครงการขนาดใหญ่
- Web Scraper กับ ParseHub: ParseHub เหมาะสำหรับการนำทางเว็บไซต์ในระดับลึก ในขณะที่ Web Scraper ชนะเลิศในด้านราคาและความเรียบง่ายสำหรับการดึงข้อมูลเว็บไซต์แบบรวดเร็วเพียงหน้าเดียว
- Web Scraper กับ Scrapy: Scrapy ช่วยให้นักพัฒนาควบคุมได้อย่างเต็มที่ผ่านสคริปต์ Python ในขณะที่ Web Scraper เหมาะสำหรับผู้ที่ไม่ใช่โปรแกรมเมอร์ที่ชอบวิธีการแบบเห็นภาพมากกว่า
- Web Scraper กับ Apify: Apify โดดเด่นในด้านระบบคลาวด์ อัตโนมัติ และการเข้าถึง API; Web Scraper นั้นใช้งานง่ายกว่าสำหรับผู้ใช้ที่ล็อกอินเข้าเบราว์เซอร์และใช้งานได้ทันที
เริ่มใช้งาน Web Scraper ได้เลย
คุณได้เรียนรู้วิธีการใช้งานฟีเจอร์หลัก ๆ ของโปรแกรม Web Scraper แล้ว:
- ✅ อินเทอร์เฟซแบบชี้และคลิก
- ✅ ดึงข้อมูล
- ✅ รองรับเว็บไซต์ที่ใช้ JavaScript
- ✅ ปรับแต่งข้อมูล
- ✅ ส่งออกข้อมูล
ขั้นตอนต่อไป: เลือกฟีเจอร์หนึ่งอย่างแล้วลองใช้ดูเลย
คนส่วนใหญ่เริ่มต้นด้วยอินเทอร์เฟซแบบชี้และคลิก (Point-and-Click Interface)
ใช้เวลาน้อยกว่า 5 นาที
ถาม บ่อย ๆ
โปรแกรม Web Scraper ใช้งานได้ฟรีหรือไม่?
ใช่แล้ว ส่วนขยายเบราว์เซอร์ Web Scraper นั้นใช้งานได้ฟรี ส่วนแผนบริการคลาวด์แบบเสียเงินเริ่มต้นที่ 40 ดอลลาร์ต่อเดือนสำหรับการดึงข้อมูลตามกำหนดเวลาและการเข้าถึง API
โปรแกรม Web Scraper สามารถจัดการกับหน้าเว็บที่แสดงผลด้วย JavaScript ได้หรือไม่?
ใช่ แต่เฉพาะบน Web Scraper Cloud เท่านั้น ส่วนขยายเบราว์เซอร์เวอร์ชันฟรีไม่สามารถประมวลผล JavaScript ได้ ส่วนแพ็กเกจ Cloud รองรับการแสดงผล JavaScript อย่างเต็มรูปแบบ
Web Scraper สามารถส่งออกข้อมูลในรูปแบบใดได้บ้าง?
Web Scraper ช่วยให้คุณส่งออกข้อมูลเป็นไฟล์ CSV, XLSX หรือ JSON ได้ นอกจากนี้ ผู้ใช้ระบบคลาวด์ยังสามารถเข้าถึงข้อมูลผ่าน API หรือ webhook ได้อีกด้วย
ฉันจำเป็นต้องมีทักษะการเขียนโค้ดเพื่อใช้โปรแกรม Web Scraper หรือไม่?
ไม่เลย Web Scraper ใช้ระบบคลิกเมาส์เพื่อเลือกองค์ประกอบต่างๆ คุณเลือกองค์ประกอบเหล่านั้นด้วยสายตา ไม่จำเป็นต้องใช้ Python, Beautiful Soup หรือโค้ดอื่นๆ
การดึงข้อมูลจากเว็บไซต์ (Web scraping) ถูกกฎหมายหรือไม่?
โดยทั่วไปแล้วสามารถทำได้สำหรับข้อมูลที่เปิดเผยต่อสาธารณะ โปรดตรวจสอบ robots.txt และข้อกำหนดในการให้บริการของเว็บไซต์เสมอ หลีกเลี่ยงการดึงข้อมูลส่วนบุคคลหรือข้อมูลส่วนตัว













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
