
เริ่มต้นใช้งานอย่างรวดเร็ว
คู่มือนี้ครอบคลุมทุกฟีเจอร์ของ Firecrawl:
- เริ่มต้นใช้งาน — สร้างบัญชี Firecrawl และตั้งค่าคีย์ API ของคุณ
- วิธีใช้งาน Scrape — ดึงข้อมูลที่พร้อมใช้งาน llm จากหน้าเว็บแต่ละหน้า
- วิธีใช้งาน Crawl — รวบรวมข้อมูลจากเว็บไซต์ทั้งหมดและติดตามทุกลิงก์
- วิธีใช้งานการค้นหา — ค้นหาข้อมูลเว็บแบบเรียลไทม์บนเว็บ
- วิธีใช้แผนที่ — ดำเนินการค้นหา URL ในแต่ละหน้า
- วิธีใช้สารสกัด — ดึงข้อมูลที่มีโครงสร้างโดยใช้ข้อความแจ้งเตือนด้วยภาษาธรรมชาติ
ระยะเวลาที่ใช้: แต่ละฟีเจอร์ใช้เวลา 5 นาที
นอกจากนี้ในคู่มือนี้ยังมี: เคล็ดลับสำหรับมืออาชีพ | ข้อผิดพลาดที่พบบ่อย | การแก้ไขปัญหา | ความละเอียด | ตัวเลือกต่าง ๆ
เหตุใดจึงควรเชื่อถือคู่มือนี้
ฉันใช้ Firecrawl มานานกว่าหนึ่งปีแล้ว และได้ทดสอบฟีเจอร์ทุกอย่างที่กล่าวถึงในที่นี้
บทแนะนำวิธีการใช้ Firecrawl นี้มาจากประสบการณ์การทำงานจริงในการดึงข้อมูลจากเว็บไซต์

Firecrawl เป็นเว็บครอว์เลอร์ที่ขับเคลื่อนด้วย AI ซึ่งแปลงเว็บไซต์ให้เป็นข้อมูลที่สะอาดและพร้อมใช้งานสำหรับ LLM (Low Mail)
แต่ผู้ใช้ส่วนใหญ่รู้จักเพียงผิวเผินถึงความสามารถของเครื่องมืออเนกประสงค์นี้เท่านั้น
คู่มือนี้จะแสดงวิธีการใช้งานฟีเจอร์หลักทั้งหมดทีละขั้นตอน พร้อมภาพหน้าจอประกอบ
บทช่วยสอนการปีนป่ายไฟ
คู่มือการใช้งาน Firecrawl ฉบับสมบูรณ์นี้จะพาคุณเรียนรู้ทุกฟีเจอร์ ตั้งแต่การสร้าง API Key ครั้งแรก ไปจนถึงการดำเนินการแบบกลุ่มขั้นสูงที่จะทำให้คุณเป็นผู้ใช้งานระดับสูง
ไฟร์ครอว์ล
เปลี่ยนเว็บไซต์ใดๆ ให้เป็นข้อมูลที่มีโครงสร้างและสะอาดตาด้วย API เพียงตัวเดียว Firecrawl จัดการการเรนเดอร์ JavaScript การจำกัดอัตราการใช้งาน และการค้นหา URL เพื่อให้คุณได้รับข้อมูลที่พร้อมใช้งานสำหรับ LLM อย่างรวดเร็ว เริ่มต้นด้วยแผนฟรี — ไม่ต้องใช้บัตรเครดิต
เริ่มต้นใช้งาน Firecrawl
ก่อนใช้งานฟีเจอร์ใดๆ โปรดทำการตั้งค่าครั้งแรกนี้ให้เสร็จสมบูรณ์
ใช้เวลาประมาณ 3 นาที
โปรดชมภาพรวมโดยย่อนี้ก่อน:
ต่อไปนี้เราจะมาดูแต่ละขั้นตอนกัน
ขั้นตอนที่ 1: สร้างบัญชีของคุณ
เข้าไปที่เว็บไซต์ Firecrawl ได้ที่ https://www.firecrawl.dev
คลิก "ลงทะเบียน" เพื่อเปิดบัญชี Firecrawl ในแผนฟรี
ป้อนอีเมลของคุณและสร้างรหัสผ่าน
✓ ด่าน: ตรวจสอบของคุณ จดหมายเข้า สำหรับอีเมลยืนยัน
ขั้นตอนที่ 2: ติดตั้งและตั้งค่าคีย์ API ของคุณ
เรียกใช้คำสั่ง `pip install firecrawl-py` เพื่อเพิ่มบริการ API ลงในโปรเจ็กต์ของคุณ
คัดลอกคีย์ API ของคุณ แล้วบันทึกไว้เป็นตัวแปรสภาพแวดล้อมสำหรับ ความปลอดภัย.
นี่คือหน้าตาของแดชบอร์ด:
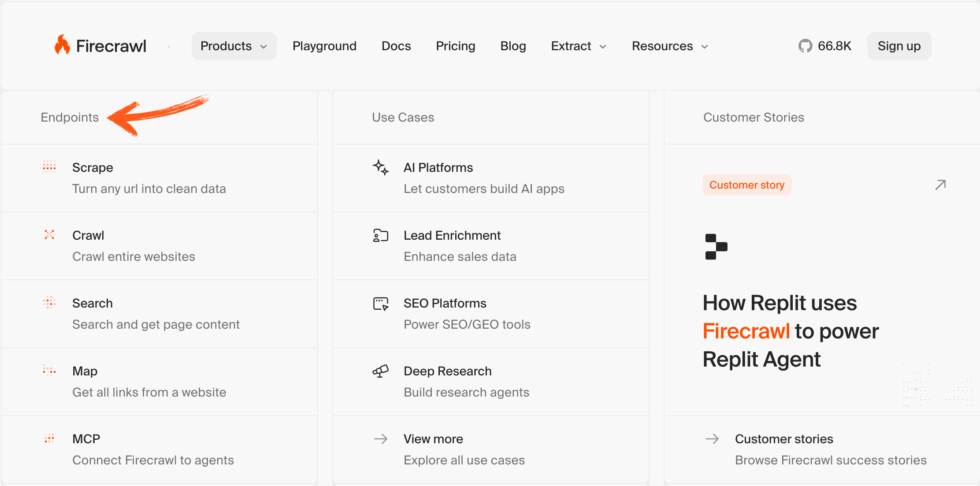
✓ ด่าน: คุณควรจะเห็นแดชบอร์ดหลักที่แสดงรายการการใช้งานและรหัส API ของคุณ
ขั้นตอนที่ 3: โทรออกครั้งแรก
นำเข้าคลาส FirecrawlApp และสร้างอินสแตนซ์ Firecrawl โดยใช้คีย์ของคุณ
ทุกคำขอจะส่งไปยังเอนด์พอยต์หลักที่ https://api.firecrawl.dev/v2
✅ เสร็จเรียบร้อยแล้ว: คุณพร้อมแล้วที่จะดึงข้อมูล ค้นหาข้อมูล สร้างแผนที่ และแยกข้อมูล
วิธีการใช้งานเครื่องขูดดิน Firecrawl
ถู ช่วยให้คุณดึงข้อมูลที่สะอาดและพร้อมใช้งานสำหรับ LLM จากหน้าเว็บเดียวด้วยการเรียก API เพียงครั้งเดียว
โหมดการดึงข้อมูลจะกำหนดเป้าหมายไปที่แต่ละหน้า และเหมาะอย่างยิ่งสำหรับการดึงรายละเอียดเฉพาะอย่างรวดเร็ว
นี่คือวิธีการใช้งานทีละขั้นตอน
ทีนี้เรามาอธิบายแต่ละขั้นตอนกัน
ขั้นตอนที่ 1: รับคีย์ API ของคุณ
สร้างบัญชี Firecrawl จากนั้นคัดลอกคีย์ API ของคุณจากแดชบอร์ด
จัดเก็บคีย์ API ไว้ในตัวแปรสภาพแวดล้อม เพื่อไม่ให้คีย์ API ปรากฏอยู่ในโค้ดโดยตรง
ขั้นตอนที่ 2: เรียกใช้เอนด์พอยต์การดึงข้อมูล (Scrape Endpoint)
ส่ง URL เดียวไปยังเมธอด .scrape_url() ในอินสแตนซ์ firecrawl ของคุณ
คุณสามารถระบุรูปแบบผลลัพธ์ได้ ไม่ว่าจะเป็น Markdown, HTML ดิบ หรือ JSON ที่มีโครงสร้าง
นี่คือหน้าตาของมัน:
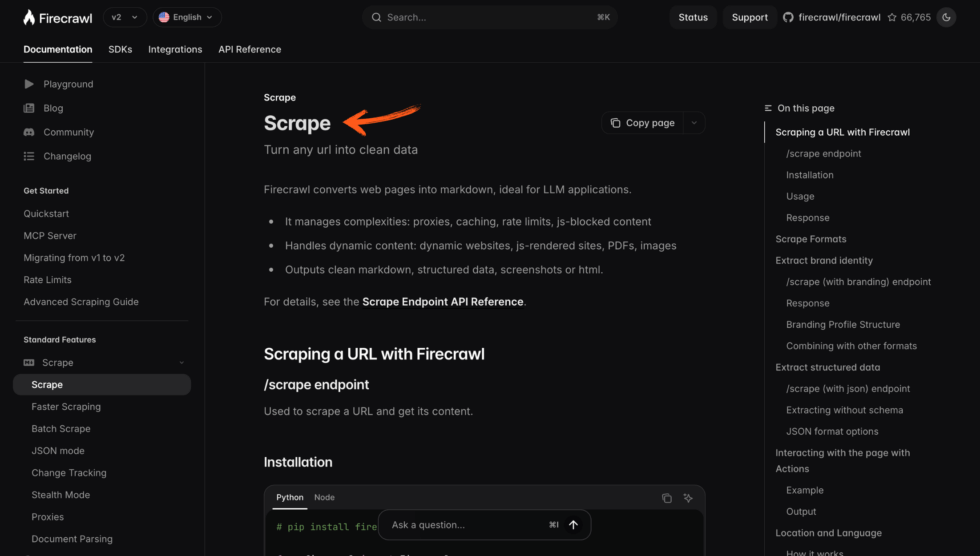
✓ ด่าน: คุณควรเห็นโค้ด Markdown ที่เรียบร้อยสำหรับหน้าปัจจุบัน พร้อมใช้งานสำหรับแอปพลิเคชัน AI แล้ว
ขั้นตอนที่ 3: อ่านผลลัพธ์ที่สะอาดหมดจด
Firecrawl ส่งคืนข้อมูลที่สะอาดและอ่านง่าย ข้อความโดยลบแท็ก HTML ที่ไม่จำเป็นออกแล้ว
✅ ผลลัพธ์: คุณแปลงหน้าเว็บเพจหนึ่งให้เป็นข้อมูลเว็บที่มีโครงสร้างโดยใช้ API เพียงตัวเดียว
💡 เคล็ดลับสำหรับมืออาชีพ: ตั้งค่าพารามิเตอร์ max_age เพื่อแคชผลลัพธ์และข้ามการดึงข้อมูลซ้ำสำหรับหน้าเว็บที่ไม่มีการเปลี่ยนแปลง
วิธีใช้งาน Firecrawl Crawler
คลาน ช่วยให้คุณสามารถรวบรวมข้อมูลเว็บไซต์ทั้งหมดและติดตามลิงก์โดยอัตโนมัติโดยไม่ต้องใช้แผนผังเว็บไซต์
โหมดการรวบรวมข้อมูลช่วยให้คุณสามารถรวบรวมข้อมูลเว็บไซต์จากหลายหน้าและเก็บรวบรวมทุกหน้าที่สามารถเข้าถึงได้
นี่คือวิธีการใช้งานทีละขั้นตอน
ทีนี้เรามาอธิบายแต่ละขั้นตอนกัน
ขั้นตอนที่ 1: ระบุ URL หลัก
กำหนด URL เริ่มต้นให้กับเอนด์พอยต์การรวบรวมข้อมูล เช่น https://example.com
Firecrawl จัดการการรวบรวมข้อมูลจากเว็บไซต์ผ่านลิงก์และติดตามหน้าเว็บโดยอัตโนมัติ
ขั้นตอนที่ 2: เริ่มงานรวบรวมข้อมูล (Crawl Job)
เริ่มกระบวนการรวบรวมข้อมูลและดึงรหัสงานที่ส่งกลับมาเพื่อติดตามความคืบหน้า
ใช้รหัสงานเพื่อตรวจสอบสถานะและดึงข้อมูลที่รวบรวมได้เมื่อแต่ละหน้าเสร็จสิ้น
นี่คือหน้าตาของมัน:
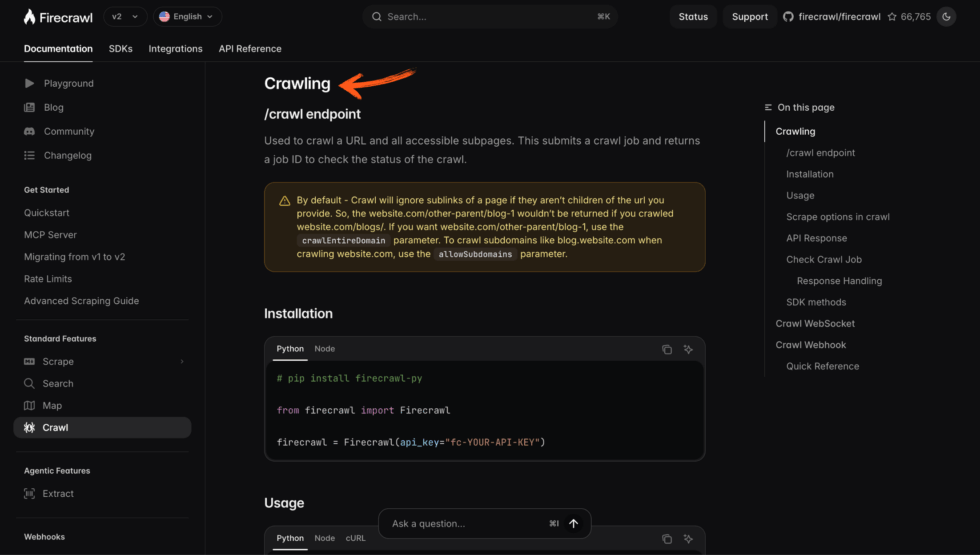
✓ ด่าน: คุณควรจะเห็นหน้าเว็บที่ถูกคัดลอกมาจากทั่วทั้งเว็บไซต์มารวมกันเป็นข้อมูลเว็บ
ขั้นตอนที่ 3: ส่งออกผลลัพธ์
รวบรวมทุกหน้าเป็นรูปแบบ Markdown หรือ JSON ที่มีโครงสร้างสำหรับใช้ใน Data Pipeline ของคุณ
✅ ผลลัพธ์: คุณสามารถบันทึกภาพเว็บไซต์ทั้งหมดได้ แม้แต่เว็บไซต์ที่ซับซ้อนซึ่งมีเนื้อหาแบบไดนามิกก็ตาม
💡 เคล็ดลับสำหรับมืออาชีพ: Firecrawl ใช้การประมวลผลแบบกลุ่มและเบราว์เซอร์พร้อมกัน ทำให้การดำเนินการรวบรวมข้อมูลขนาดใหญ่ยังคงรวดเร็ว
วิธีใช้งานเครื่องมือค้นหา Firecrawl
ค้นหา ช่วยให้คุณค้นหาข้อมูลบนเว็บและได้ผลลัพธ์ที่สะอาดตา ซึ่งคุณสามารถป้อนเข้าสู่เอเจนต์ AI ได้โดยตรง
ฟังก์ชันการค้นหาช่วยให้คุณค้นหาข้อมูลบนเว็บและดึงข้อมูลเว็บแบบเรียลไทม์ออกมาในรูปแบบข้อความที่อ่านได้
นี่คือวิธีการใช้งานทีละขั้นตอน
ทีนี้เรามาอธิบายแต่ละขั้นตอนกัน
ขั้นตอนที่ 1: ส่งคำขอค้นหา
เรียกใช้เอนด์พอยต์การค้นหาด้วยคำค้นหาที่เป็นภาษาธรรมชาติธรรมดา
Firecrawl สามารถค้นหาข้อมูลบนเว็บได้จากเว็บไซต์ข่าว เว็บไซต์หางาน และเว็บไซต์รีวิวต่างๆ
ขั้นตอนที่ 2: เลือกรูปแบบเอาต์พุต
ขอให้ส่งผลลัพธ์ในรูปแบบ Markdown หรือ JSON ที่มีโครงสร้างสำหรับแต่ละรายการ
ผลลัพธ์ทุกอย่างจะได้รับเป็นข้อมูลที่สะอาด ไม่ใช่ HTML ดิบๆ ที่เต็มไปด้วยข้อมูลที่ไม่เกี่ยวข้อง
นี่คือหน้าตาของมัน:
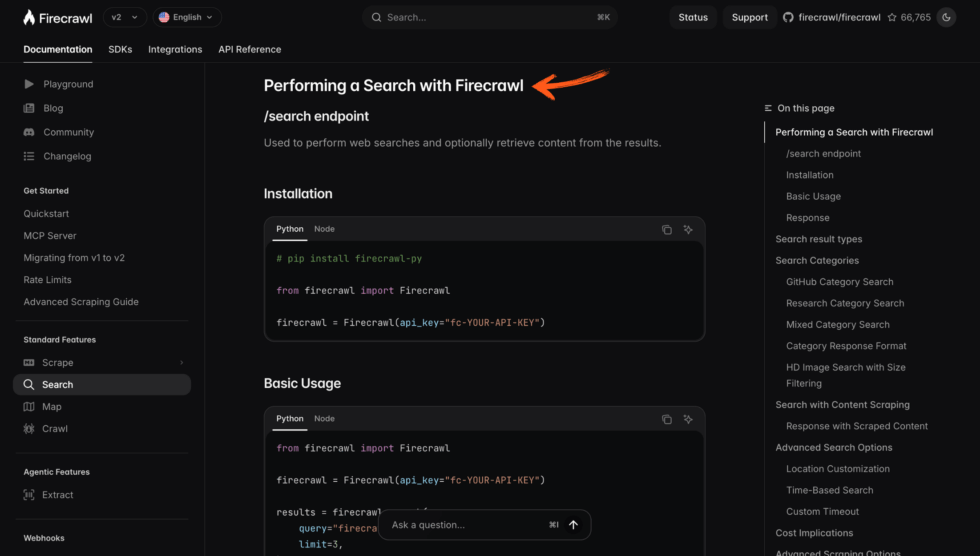
✓ ด่าน: คุณควรจะเห็นหน้าเว็บที่จัดอันดับแล้วแสดงผลออกมาในรูปแบบข้อมูลเว็บที่มีโครงสร้าง
ขั้นตอนที่ 3: ส่งข้อมูลเข้าสู่แอปของคุณ
ป้อนข้อมูลที่มีโครงสร้างเข้าไปใน ผู้ช่วย AI หรือเวิร์กโฟลว์ AI
✅ ผลลัพธ์: คุณได้เพิ่มเนื้อหาเว็บแบบเรียลไทม์ลงในแอปพลิเคชัน AI ของคุณด้วยการเรียกใช้ API เพียงครั้งเดียว
💡 เคล็ดลับสำหรับมืออาชีพ: ใช้การค้นหาควบคู่กับการดึงข้อมูลเพื่อรวบรวมบทความข่าวสำหรับการวิจัยตลาดหรือการวิเคราะห์คู่แข่ง
วิธีใช้งานแผนที่ขั้นสูงของ Firecrawl
แผนที่ ช่วยให้คุณสามารถค้นหา URL และเปลี่ยนโดเมนเดียวให้เป็นแผนที่สมบูรณ์ของหน้าเว็บแต่ละหน้าได้
โหมดแผนที่ดึงข้อมูล URL ทุกรายการบนเว็บไซต์ได้อย่างรวดเร็ว เพื่อการค้นหา URL ที่รวดเร็ว
นี่คือวิธีการใช้งานทีละขั้นตอน
ทีนี้เรามาอธิบายแต่ละขั้นตอนกัน
ขั้นตอนที่ 1: ส่งข้อมูลโดเมน
ส่ง URL รูทเดียวไปยังเอนด์พอยต์แผนที่
Firecrawl จะแสดงลิงก์ทั้งหมดโดยไม่จำเป็นต้องมีแผนผังเว็บไซต์
ขั้นตอนที่ 2: ตรวจสอบรายการ URL
ตรวจสอบหน้าเว็บแต่ละหน้าก่อนที่จะทำการคัดลอกข้อมูล
บันทึกรายการลงในไฟล์ CSV เพื่อวางแผนการดึงข้อมูลของคุณ
นี่คือหน้าตาของมัน:
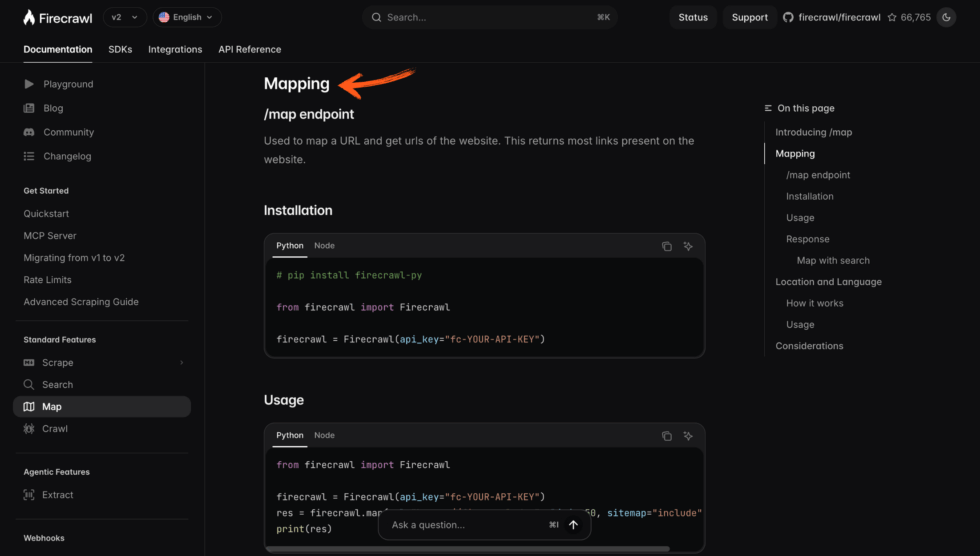
✓ ด่าน: คุณควรจะเห็นแผนผังเว็บไซต์ (sitemap) ของหน้าเว็บทั้งหมดจาก URL เดียว
ขั้นตอนที่ 3: เลือกสิ่งที่จะดึงข้อมูล
เลือกหน้าเว็บที่คุณต้องการ จากนั้นส่งหน้าเหล่านั้นไปทำการดึงข้อมูลหรือรวบรวมข้อมูล
✅ ผลลัพธ์: คุณได้สร้างแผนผังเว็บไซต์ทั้งหมดแล้ว พร้อมสำหรับการดึงข้อมูลจากเว็บไซต์แบบเจาะจงเป้าหมาย
💡 เคล็ดลับสำหรับมืออาชีพ: ควรสร้างแผนที่เว็บไซต์ก่อนบนเว็บไซต์แบบไดนามิกและเว็บแอปพลิเคชัน เพื่อหลีกเลี่ยงการสิ้นเปลืองเครดิตในหน้าเว็บที่ไม่จำเป็น
วิธีใช้งานเครื่องสกัดไฟ Firecrawl
สารสกัด ช่วยให้คุณดึงข้อมูลที่มีโครงสร้างจากหน้าเว็บใดก็ได้โดยใช้ข้อความภาษาธรรมชาติ
Extract ใช้การประมวลผลด้วย AI เพื่อดึงข้อมูลเฉพาะฟิลด์ที่คุณระบุอย่างแม่นยำ
นี่คือวิธีการใช้งานทีละขั้นตอน
ทีนี้เรามาอธิบายแต่ละขั้นตอนกัน
ขั้นตอนที่ 1: กำหนด Schema
เขียนโมเดล Pydantic โดยใช้คำสั่ง: from pydantic import BaseModel.
การดึงข้อมูลตาม Schema จะบอก Firecrawl ว่าควรส่งคืนฟิลด์ใดบ้างในรูปแบบ JSON ที่มีโครงสร้าง
ขั้นตอนที่ 2: อธิบายข้อมูล
เพิ่มข้อความตอบกลับด้วยภาษาธรรมชาติสำหรับฟิลด์ที่ Schema ไม่สามารถบันทึกได้
นี่คือวิธีการดึงข้อมูลจากหน้าเว็บโดยไม่ต้องเขียนกฎการแยกวิเคราะห์
นี่คือหน้าตาของมัน:
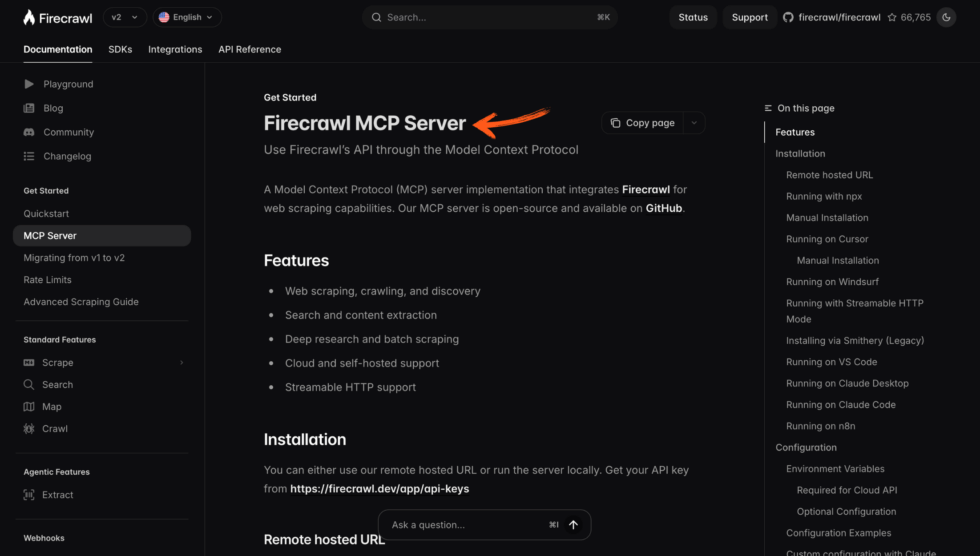
✓ ด่าน: คุณควรเห็นข้อมูลที่มีโครงสร้างเป็นระเบียบ แทนที่จะเป็นแท็ก HTML ที่ยุ่งเหยิง
ขั้นตอนที่ 3: รับข้อมูล JSON ที่มีโครงสร้าง
Firecrawl ส่งคืนข้อมูล JSON ที่มีโครงสร้างสะอาด พร้อมสำหรับใช้เป็นข้อมูลฝึกฝน
✅ ผลลัพธ์: คุณได้แทนที่โปรแกรมดึงข้อมูลที่เปราะบางด้วยการเรียกใช้ฟังก์ชันดึงข้อมูลเพียงครั้งเดียวและลดขั้นตอนการทำความสะอาดข้อมูลลง
💡 เคล็ดลับสำหรับมืออาชีพ: ใช้ only_main_content, include_tags และ exclude_tags เพื่อให้ข้อมูลเว็บที่ดึงมานั้นมีความเฉพาะเจาะจง
เคล็ดลับและทางลัดสำหรับการเล่น Firecrawl ระดับโปร
หลังจากทดสอบ Firecrawl มานานกว่าหนึ่งปี นี่คือเคล็ดลับที่ดีที่สุดของฉันสำหรับการดึงข้อมูลที่สะอาดกว่าเดิม
แป้นพิมพ์ลัด
| การกระทำ | ทางลัด |
|---|---|
| วิ่งเล่นในสนามเด็กเล่น | Ctrl + Enter |
| คัดลอกคีย์ API | Ctrl + C |
| เปิดเอกสาร | Ctrl + K |
| เปลี่ยนรูปแบบเอาต์พุต | แท็บ |
คุณสมบัติที่ซ่อนอยู่ซึ่งคนส่วนใหญ่มองข้ามไป
- การแคช max_age: นำข้อมูลที่รวบรวมได้ล่าสุดมาใช้ซ้ำ เพื่อการดึงข้อมูลซ้ำที่รวดเร็วและประหยัดค่าใช้จ่ายยิ่งขึ้น
- การดำเนินการของเบราว์เซอร์: คลิก เลื่อน และพิมพ์ เพื่อเข้าถึงเนื้อหาที่อยู่เบื้องหลังการแสดงผลด้วย JavaScript
- การประมวลผลแบบกลุ่มอะซิงโครนัส: ประมวลผล URL นับพันรายการด้วยการประมวลผลแบบกลุ่มโดยไม่ทำให้เว็บแอปพลิเคชันของคุณหยุดชะงัก
ข้อผิดพลาดทั่วไปที่ควรหลีกเลี่ยงในการเล่น Firecrawl
ข้อผิดพลาดที่ 1: การเขียนโค้ด API key แบบตายตัว
❌ ผิด: การวางคีย์ API ของคุณลงในโค้ดที่ใช้ร่วมกันหรือใน repository สาธารณะโดยตรง
✅ ด้านขวา: โหลดคีย์จากตัวแปรสภาพแวดล้อมเพื่อให้คีย์นั้นเป็นส่วนตัว
ข้อผิดพลาดที่ 2: การรวบรวมข้อมูลก่อนการสร้างแผนที่
❌ ผิด: การรวบรวมข้อมูลเว็บไซต์ทั้งหมดโดยไม่รู้ทิศทางและสิ้นเปลืองเครดิตไปกับหน้าเว็บไร้สาระ
✅ ด้านขวา: เริ่มจากการค้นหา URL ด้วยแผนที่ก่อน จากนั้นจึงค่อยรวบรวมข้อมูลเฉพาะหน้าเว็บที่คุณต้องการ
ข้อผิดพลาดที่ 3: การแยกวิเคราะห์ HTML ดิบด้วยตนเอง
❌ ผิด: เขียนกฎที่ไม่แข็งแรงเพื่อทำความสะอาด HTML ดิบและลบแท็ก HTML ด้วยตนเอง
✅ ด้านขวา: ใช้การดึงข้อมูลตาม Schema เพื่อให้ได้ JSON ที่มีโครงสร้างชัดเจนและสะอาดตาโดยตรง
การแก้ไขปัญหา Firecrawl
ปัญหา: ข้อผิดพลาด 401 ที่ไม่ได้รับอนุญาต
สาเหตุ: คีย์ API ของคุณหายไปหรือไม่ได้ถูกโหลดจากตัวแปรสภาพแวดล้อม
แก้ไข: ส่งออกคีย์อีกครั้ง จากนั้นสร้างอินสแตนซ์ firecrawl ใหม่และลองอีกครั้ง
ปัญหา: ข้อผิดพลาดหมดเวลา (Timeout errors) บนเว็บไซต์ที่ซับซ้อน
สาเหตุ: การแสดงผลด้วย JavaScript จำนวนมากหรือเนื้อหาแบบไดนามิกจะทำให้การโหลดใช้เวลานานขึ้น
แก้ไข: เพิ่มคำสั่งรอเพื่อให้หน้าเว็บปัจจุบันโหลดเสร็จสมบูรณ์ก่อนที่จะทำการบันทึกภาพ
ปัญหา: การใช้งานเกินขีดจำกัด
สาเหตุ: มีการส่งคำขอมากเกินไปในคราวเดียวในแพ็กเกจฟรีหรือแพ็กเกจระดับล่าง
แก้ไข: การประมวลผลแบบกลุ่มช้าลง หรืออัปเกรดเพื่อรองรับเบราว์เซอร์พร้อมกันจำนวนมากขึ้น
📌 บันทึก: หากวิธีเหล่านี้ไม่สามารถแก้ไขปัญหาของคุณได้ โปรดติดต่อฝ่ายสนับสนุนของ Firecrawl
Firecrawl คืออะไร?
ไฟร์ครอว์ล เป็นเครื่องมือดึงข้อมูลจากเว็บไซต์ที่ขับเคลื่อนด้วย AI ซึ่งแปลงเว็บไซต์ให้เป็นข้อมูลที่มีโครงสร้างและสะอาดตา
ลองนึกภาพว่าเป็นโปรแกรมรวบรวมข้อมูลบนเว็บที่ส่งข้อความที่อ่านง่ายให้กับตัวแทน AI แทนที่จะเป็น HTML ดิบๆ ที่ยุ่งเหยิง
Firecrawl ถูกพัฒนาโดย Mendable.ai เพื่อลดการสิ้นเปลืองโทเค็นสำหรับแอปพลิเคชัน AI
ชมภาพรวมโดยย่อนี้:
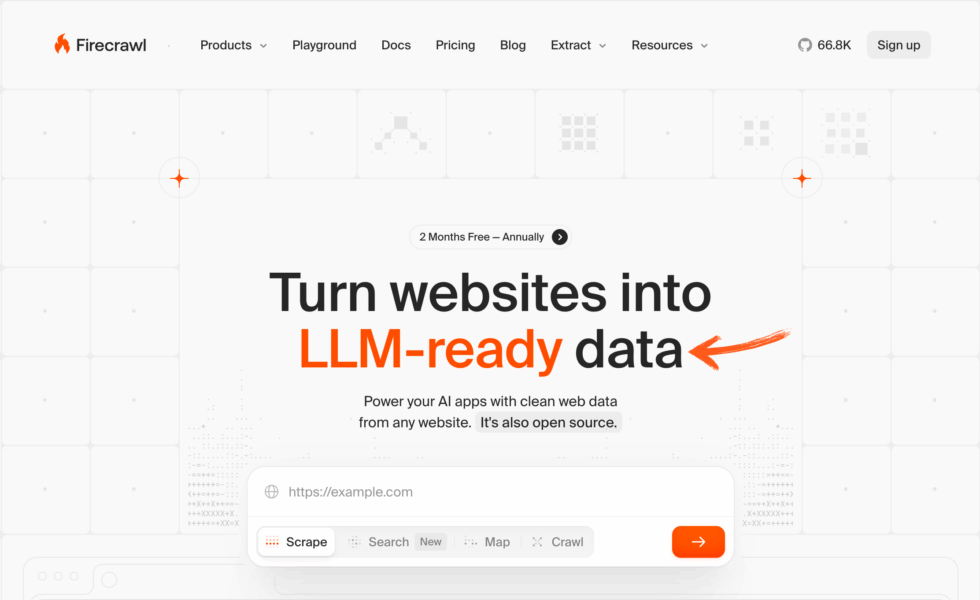
ประกอบด้วยคุณสมบัติหลักดังต่อไปนี้:
- ถู: ดึงข้อมูลจากหน้าเว็บแต่ละหน้าออกมาในรูปแบบ Markdown หรือ JSON ที่มีโครงสร้าง
- คลาน: รวบรวมข้อมูลเว็บไซต์ทั้งหมดและติดตามลิงก์โดยไม่ต้องใช้แผนผังเว็บไซต์
- ค้นหา: ค้นหาข้อมูลบนเว็บและดึงข้อมูลที่ถูกต้องจากเว็บไซต์ข่าวและเว็บไซต์รีวิวต่างๆ
- แผนที่: ค้นหา URL อย่างรวดเร็ว เปลี่ยนโดเมนเดียวให้เป็นแผนผังเว็บไซต์แบบสมบูรณ์
- สารสกัด: ดึงข้อมูลเว็บที่มีโครงสร้างโดยใช้คำสั่งภาษาธรรมชาติและสคีมาของ Pydantic
Firecrawl เหนือกว่าการดึงข้อมูลจากเว็บแบบเดิม ๆ ด้วยการจัดการพร็อกซี การจำกัดอัตราการใช้งาน และการแสดงผล JavaScript ให้คุณโดยอัตโนมัติ
แตกต่างจากเครื่องมือแบบดั้งเดิมที่ต้องใช้ Selenium เครื่องมือนี้ให้บริการนักวิทยาศาสตร์ข้อมูลและนักพัฒนาผ่านบริการ API เดียว
สำหรับรีวิวฉบับเต็ม โปรดดูที่หน้าของเรา รีวิว Firecrawl.
ราคา Firecrawl
นี่คือราคาของ Firecrawl ในปี 2026:
| วางแผน | ราคา | เหมาะสำหรับ |
|---|---|---|
| ฟรี | ฟรี | ทดสอบการดึงข้อมูลและการรวบรวมข้อมูลบนหน้าเว็บไม่กี่หน้า |
| งานอดิเรก | 16 ดอลลาร์/เดือน | นักพัฒนาอิสระและไปป์ไลน์ข้อมูลขนาดเล็ก |
| มาตรฐาน | 83 ดอลลาร์ต่อเดือน | ทีมที่ดำเนินการรวบรวมข้อมูลเว็บเป็นประจำ |
| การเจริญเติบโต | 333 ดอลลาร์ต่อเดือน | การวิจัยและติดตามตลาดปริมาณมาก |
ทดลองใช้งานฟรี: ใช่แล้ว แพ็กเกจฟรีอนุญาตให้คุณดึงข้อมูลจากหน้าเว็บได้จำนวนจำกัด
รับประกันคืนเงิน: ไม่มีการรับประกันอย่างเป็นทางการ แต่คุณสามารถดาวน์เกรดได้ทุกเมื่อ
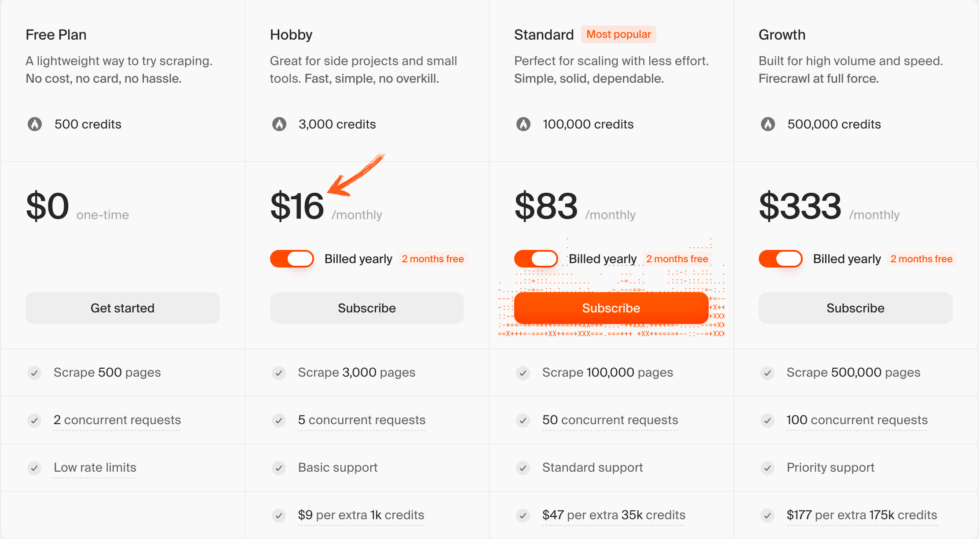
💰 คุ้มค่าที่สุด: มาตรฐาน — ตัวเลือกที่ให้ความสมดุลที่ดีที่สุดระหว่างจำนวนเครดิตและจำนวนเบราว์เซอร์ที่ใช้งานพร้อมกัน เหมาะสำหรับทีมส่วนใหญ่
Firecrawl เทียบกับทางเลือกอื่นๆ
แล้ว Firecrawl ล่ะ เป็นอย่างไรเมื่อเทียบกับคู่แข่ง? นี่คือภาพรวมของคู่แข่ง:
| เครื่องมือ | เหมาะสำหรับ | ราคา | การให้คะแนน |
|---|---|---|---|
| ไฟร์ครอว์ล | ข้อมูลสะอาดที่พร้อมใช้งานสำหรับ AI | 16 ดอลลาร์/เดือน | ⭐ 3.5 |
| อะพิฟาย | นักแสดงที่สร้างไว้ล่วงหน้า | 49 ดอลลาร์/เดือน | ⭐ 4.5 |
| ข้อมูลสดใส | มาตราส่วนตัวแทน | กำหนดเอง | ⭐ 4.6 |
| ครอลล์4AI | โอเพนซอร์ส | ฟรี | ⭐ 4.4 |
| สแครปปี้ | การควบคุม Python | ฟรี | ⭐ 4.5 |
| สแครปกราฟ AI | การดึงข้อมูลกราฟ LLM | 20 ดอลลาร์/เดือน | ⭐ 4.3 |
ตัวเลือกที่น่าสนใจ:
- ดีที่สุดโดยรวม: Firecrawl — ข้อมูลที่สะอาดและพร้อมใช้งานสำหรับ LLM จาก API เดียว
- งบประมาณที่ดีที่สุด: Crawl4AI — ซอฟต์แวร์โอเพนซอร์สฟรีสำหรับนักวิทยาศาสตร์ข้อมูลที่ต้องการใช้งานจริง
- เหมาะสำหรับผู้เริ่มต้น: Firecrawl — ระบบใช้ภาษาธรรมชาติในการให้คำแนะนำ ซึ่งจะซ่อนส่วนที่ยากเอาไว้
- เหมาะที่สุดสำหรับมาตราส่วนตัวแทน: Bright Data — แหล่งรวมพร็อกซีขนาดใหญ่สำหรับเว็บไซต์ที่ซับซ้อน
🎯 ทางเลือกอื่นนอกเหนือจาก Firecrawl
กำลังมองหาทางเลือกอื่นแทน Firecrawl อยู่ใช่ไหม? นี่คือตัวเลือกที่ดีที่สุด:
- 🚀 อะพิฟาย: แหล่งรวมแอคเตอร์สำเร็จรูปสำหรับการดึงข้อมูลจากเว็บไซต์ เหมาะสำหรับกรณีที่ต้องการเครื่องมือดึงข้อมูลแบบพร้อมใช้งานผ่าน API เดียว
- 🏢 ข้อมูลอันสดใส: เครือข่ายพร็อกซีระดับองค์กรสำหรับงานรวบรวมข้อมูลขนาดใหญ่และการตรวจสอบเนื้อหาในวงกว้างบนเว็บไซต์ที่มีการเปลี่ยนแปลงตลอดเวลา
- 💰 Crawl4AI: โปรแกรมรวบรวมข้อมูลแบบโอเพนซอร์สฟรี ที่สร้างข้อมูลพร้อมใช้งานสำหรับ LLM เหมาะอย่างยิ่งสำหรับเวิร์กโฟลว์ AI ด้านงบประมาณและการใช้งานในระดับท้องถิ่น
- 🔧 สแครปปี้: เฟรมเวิร์ก Python ที่ผ่านการทดสอบมาแล้ว ช่วยให้นักพัฒนาสามารถควบคุมการรวบรวมข้อมูล การวิเคราะห์ และกระบวนการจัดการข้อมูลได้อย่างเต็มที่
- 🧠 ScrapeGraphAI: การสกัดข้อมูลโดยใช้กราฟและปัญญาประดิษฐ์ (AI) ที่แมปโครงสร้างหน้าเว็บเพื่อสกัดข้อมูลที่มีโครงสร้างตามแบบแผน (schema-based)
ดูรายชื่อทั้งหมดได้ที่หน้าของเรา ทางเลือกอื่นนอกเหนือจาก Firecrawl แนะนำ.
⚔️ เปรียบเทียบ Firecrawl
ต่อไปนี้คือการเปรียบเทียบ Firecrawl กับคู่แข่งแต่ละราย:
- Firecrawl เทียบกับ Apify: Firecrawl ชนะในเรื่องผลลัพธ์ที่สะอาดและพร้อมใช้งานกับ llm ในขณะที่ Apify ชนะในเรื่องคลังเครื่องมือดึงข้อมูลสำเร็จรูปที่มีให้เลือกมากมาย
- Firecrawl เทียบกับ Bright Data: Bright Data ชนะเลิศในด้านการประมวลผลข้อมูลแบบพร็อกซี ในขณะที่ Firecrawl ชนะเลิศในด้านการดึงข้อมูลที่มีโครงสร้างที่เรียบง่ายกว่า
- Firecrawl ปะทะ Crawl4AI: Crawl4AI ชนะในเรื่องราคาและการโฮสต์ด้วยตนเอง ในขณะที่ Firecrawl ชนะในเรื่องการจำกัดอัตราการใช้งานและความน่าเชื่อถือ
- ไฟร์ครอว์ล ปะทะ สแครปปี้: Scrapy ชนะในเรื่องการควบคุมระดับต่ำ ในขณะที่ Firecrawl ชนะในเรื่องความเร็วและไม่ต้องตั้งค่าพร็อกซี
- Firecrawl เทียบกับ ScrapeGraphAI: ทั้งคู่ใช้ AI ในการขับเคลื่อน โดย Firecrawl ชนะในด้านความครอบคลุมของการรวบรวมข้อมูล ส่วน ScrapeGraphAI ชนะในด้านตรรกะของกราฟ
เริ่มใช้งาน Firecrawl ได้เลย
คุณได้เรียนรู้วิธีการใช้งานฟีเจอร์หลักๆ ของ Firecrawl แล้ว:
- ✅ ขูด
- ✅ คลาน
- ✅ ค้นหา
- ✅ แผนที่
- ✅ สกัด
ขั้นตอนต่อไป: เลือกฟีเจอร์หนึ่งอย่างแล้วลองใช้ดูเลย
คนส่วนใหญ่เริ่มต้นด้วย Scrape
ใช้เวลาน้อยกว่า 5 นาที
ถาม บ่อย ๆ
Firecrawl ใช้ทำอะไร?
Firecrawl เป็นเครื่องมือดึงข้อมูลจากเว็บที่ขับเคลื่อนด้วย AI มันแปลงหน้าเว็บให้เป็นข้อมูลที่สะอาดและพร้อมใช้งานสำหรับ AI, ระบบติดตามข้อมูล, การวิจัยตลาด และการตรวจสอบราคา
คุณสามารถใช้ Firecrawl ได้ฟรีหรือไม่?
ใช่แล้ว แพ็กเกจฟรีอนุญาตให้คุณดึงข้อมูลจากหน้าเว็บจำนวนจำกัดโดยใช้คีย์ API ของคุณ เพื่อให้คุณสามารถทดสอบการดึงข้อมูล การรวบรวม และการดึงข้อมูลก่อนที่จะชำระเงิน
ฉันจะติดตั้ง Firecrawl ได้อย่างไร?
เรียกใช้คำสั่ง `pip install firecrawl-py` จากนั้นตั้งค่าคีย์ API ของคุณเป็นตัวแปรสภาพแวดล้อม และสร้างอินสแตนซ์ firecrawl เพื่อเริ่มต้นการเรียกใช้ API ครั้งแรกของคุณ
Firecrawl แตกต่างจากการขูดดินแบบดั้งเดิมอย่างไร?
การดึงข้อมูลจากเว็บไซต์แบบดั้งเดิมต้องใช้ Selenium และการตั้งค่าพร็อกซีด้วยตนเอง แต่ Firecrawl จัดการการเรนเดอร์ JavaScript การจำกัดอัตราการใช้งาน และการทำความสะอาดข้อมูลโดยอัตโนมัติผ่านบริการ API เดียว
โปรแกรม Firecrawl สามารถดึงข้อมูลที่มีโครงสร้างได้หรือไม่?
ใช่แล้ว ใช้คำสั่งภาษาธรรมชาติหรือสคีมา Pydantic สำหรับการดึงข้อมูลตามสคีมา และ Firecrawl จะส่งคืน JSON ที่มีโครงสร้างแทนที่จะเป็น HTML ดิบๆ













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
