
เริ่มต้นใช้งานอย่างรวดเร็ว
คู่มือนี้ครอบคลุมทุกคุณสมบัติของ ScrapeGraphAI:
- เริ่มต้นใช้งาน — สร้างบัญชีและเพิ่มคีย์ API ของคุณ
- วิธีใช้งาน Smart Scraper — ดึงข้อมูลที่มีโครงสร้างจากหน้าเว็บใดก็ได้โดยใช้ข้อความภาษาธรรมชาติแบบง่ายๆ
- วิธีใช้งาน Search Scraper — รวบรวมข้อมูลเว็บได้โดยตรงจากผลการค้นหาแบบเรียลไทม์โดยไม่ต้องเปิดแต่ละลิงก์ด้วยตนเอง
- วิธีใช้งาน Markdownify — แปลงเนื้อหาบนเว็บให้เป็น Markdown ที่สะอาดตา ซึ่งโมเดล AI สามารถอ่านได้โดยไม่มีสิ่งรบกวนเพิ่มเติม
- วิธีใช้ Spidy Agent — สามารถรวบรวมข้อมูลจากหลายหน้าเว็บได้ในฐานะโปรแกรมรวบรวมข้อมูลหลายหน้า สำหรับโครงการรวบรวมข้อมูลขนาดใหญ่
- วิธีใช้งานการดึงข้อมูลแบบสากล — สามารถจัดการงานดึงข้อมูลจำนวนมากจากข้อมูลผลิตภัณฑ์ บทความข่าว และอื่นๆ ได้
- วิธีใช้งาน Easy Integrations — เชื่อมต่อข้อมูลที่ดึงมาเข้ากับโมเดลวิทยาศาสตร์ข้อมูลและแมชชีนเลิร์นนิงของคุณได้ภายในไม่กี่นาที
- วิธีใช้งาน Smart Agentic Scraper — อ่านเนื้อหาแบบไดนามิกบนเว็บไซต์ที่ใช้ JavaScript จำนวนมาก ซึ่งทำให้โปรแกรมดึงข้อมูลแบบดั้งเดิมใช้งานไม่ได้
- วิธีใช้งานโปรแกรมกำหนดตารางงาน — กำหนดเวลาให้การดึงข้อมูลเกิดขึ้นซ้ำโดยอัตโนมัติ
- วิธีใช้งานอินเทอร์เฟซแบบง่าย — ใช้งาน ScrapeGraphAI ได้อย่างมีประสิทธิภาพจากแดชบอร์ดแบบไม่ต้องเขียนโค้ด โดยไม่จำเป็นต้องมีความเชี่ยวชาญด้านเทคนิคขั้นสูง
ระยะเวลาที่ใช้: แต่ละฟีเจอร์ใช้เวลา 5 นาที
นอกจากนี้ในคู่มือนี้ยังมี: เคล็ดลับสำหรับมืออาชีพ | ข้อผิดพลาดที่พบบ่อย | การแก้ไขปัญหา | ความละเอียด | ตัวเลือกต่าง ๆ
เหตุใดจึงควรเชื่อถือคู่มือนี้
ฉันได้ใช้ ScrapeGraphAI และทดสอบทุกฟีเจอร์ในบทช่วยสอนวิธีการใช้ ScrapeGraph AI นี้ด้วยตัวเองแล้ว
คำแนะนำทีละขั้นตอนเกี่ยวกับการใช้งาน ScrapeGraphAI นี้ มาจากโครงการดึงข้อมูลจริง ไม่ใช่ภาพหน้าจอจากผู้จำหน่าย

ScrapeGraphAI คือเครื่องมือที่ขับเคลื่อนด้วย AI ซึ่งช่วยเปลี่ยนเว็บที่ยุ่งเหยิงให้เป็นระเบียบเรียบร้อย ข้อมูล แปลงเป็นข้อมูลที่มีโครงสร้างได้อย่างรวดเร็ว
โปรแกรมนี้ใช้โมเดลภาษาขนาดใหญ่ในการอ่านหน้าต่างๆ เหมือนกับที่มนุษย์อ่าน
วิธีการดึงข้อมูลจากเว็บไซต์อย่างชาญฉลาดนี้ ช่วยให้คุณลดความซับซ้อนในการดึงข้อมูลจากเว็บไซต์ในงานต่างๆ ได้มากมาย
ด้านล่างนี้ ผมจะอธิบายคุณสมบัติหลักแต่ละอย่างทีละขั้นตอน พร้อมภาพหน้าจอและเคล็ดลับจากผู้เชี่ยวชาญ
บทช่วยสอนการใช้งาน ScrapeGraphAI
บทแนะนำวิธีการใช้ ScrapeGraph AI นี้จะพาคุณไปตลอดกระบวนการดึงข้อมูล ตั้งแต่การตั้งค่าไปจนถึงการดึงข้อมูลขั้นสูง
สแครปกราฟ AI
เปลี่ยนเว็บไซต์ใดๆ ให้เป็นข้อมูลที่มีโครงสร้างและสะอาดตาด้วยคำสั่งภาษาธรรมชาติ ScrapeGraphAI ผสานโมเดลภาษาขนาดใหญ่เข้ากับตรรกะกราฟโดยตรงเพื่อดึงข้อมูลได้อย่างรวดเร็ว เริ่มใช้งานฟรี ไม่ต้องใช้บัตรเครดิต
เริ่มต้นใช้งาน ScrapeGraphAI
ก่อนใช้งานฟีเจอร์ใดๆ โปรดทำการตั้งค่าครั้งแรกนี้ให้เสร็จสิ้นก่อน
โปรดชมภาพรวมโดยย่อนี้ก่อน:
ต่อไปนี้เราจะมาดูแต่ละขั้นตอนกัน
ขั้นตอนที่ 1: สร้างบัญชีและคีย์ API ของคุณ
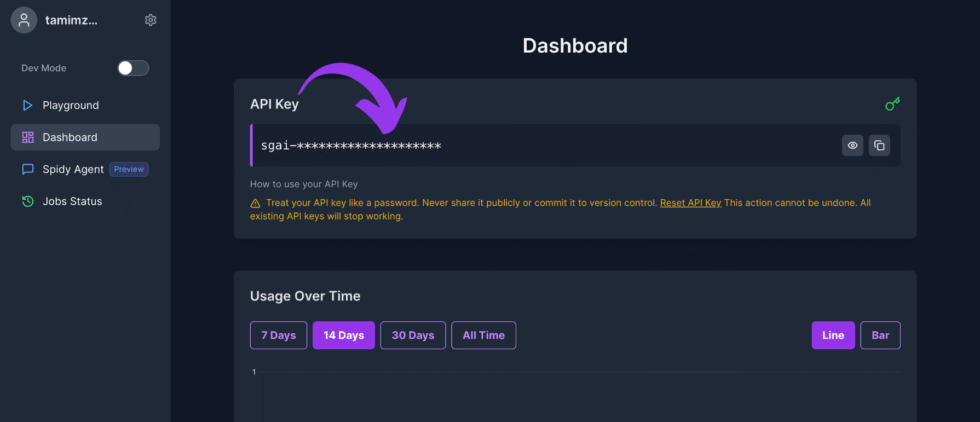
ลงทะเบียนบนแดชบอร์ด ScrapeGraphAI แล้วเปิดแท็บคีย์
คัดลอกคีย์ API ของ ScrapeGraphAI ของคุณ เนื่องจากทุกคำขอจำเป็นต้องใช้คีย์ API นั้น
✓ ด่าน: หน้าแดชบอร์ดของคุณแสดงคีย์ API ที่ใช้งานอยู่
ขั้นตอนที่ 2: ติดตั้ง ScrapeGraphAI
สร้างสภาพแวดล้อมเสมือนที่สะอาด จากนั้นติดตั้ง ScrapeGraphAI ด้วย pip
เพิ่มโค้ดต่อไปนี้ลงในสคริปต์ของคุณ นำเข้าระบบปฏิบัติการ ถึง นำเข้าไคลเอ็นต์ เพื่อโหลดคีย์ API อย่างปลอดภัย
นี่คือหน้าตาของแดชบอร์ด:
✓ ด่าน: การนำเข้าไลบรารีสำเร็จโดยไม่มีข้อผิดพลาด
ขั้นตอนที่ 3: เลือกแบบจำลองภาษาของคุณ
สำหรับการใช้งานครั้งแรก ให้เลือกโมเดลภาษา เช่น GPT 40
ScrapeGraphAI รองรับผู้ให้บริการ LLM หลายราย ดังนั้นคุณสามารถเปลี่ยนโมเดล AI ได้ตลอดเวลา
✅ เสร็จเรียบร้อยแล้ว: ตอนนี้คุณสามารถใช้ ScrapeGraphAI สำหรับฟีเจอร์ใดๆ ต่อไปนี้ได้แล้ว
วิธีใช้งาน ScrapeGraphAI Smart Scraper
สมาร์ทสแครปเปอร์ ช่วยให้คุณดึงข้อมูลที่มีโครงสร้างจากหน้าเว็บใดก็ได้โดยใช้ข้อความภาษาธรรมชาติที่ไม่ซับซ้อน
นี่คือวิธีการใช้งานทีละขั้นตอน
ขั้นตอนที่ 1: เปิดโปรแกรม Single Page Scraper
เลือกโปรแกรมดึงข้อมูลหน้าเดียว แล้ววาง URL เป้าหมายหนึ่งรายการ
ขั้นตอนที่ 2: เขียนข้อความกระตุ้นความคิดด้วยภาษาธรรมชาติ
อธิบายฟิลด์ที่คุณต้องการดึงข้อมูลจากหน้าเว็บ
นี่คือตัวอย่าง:
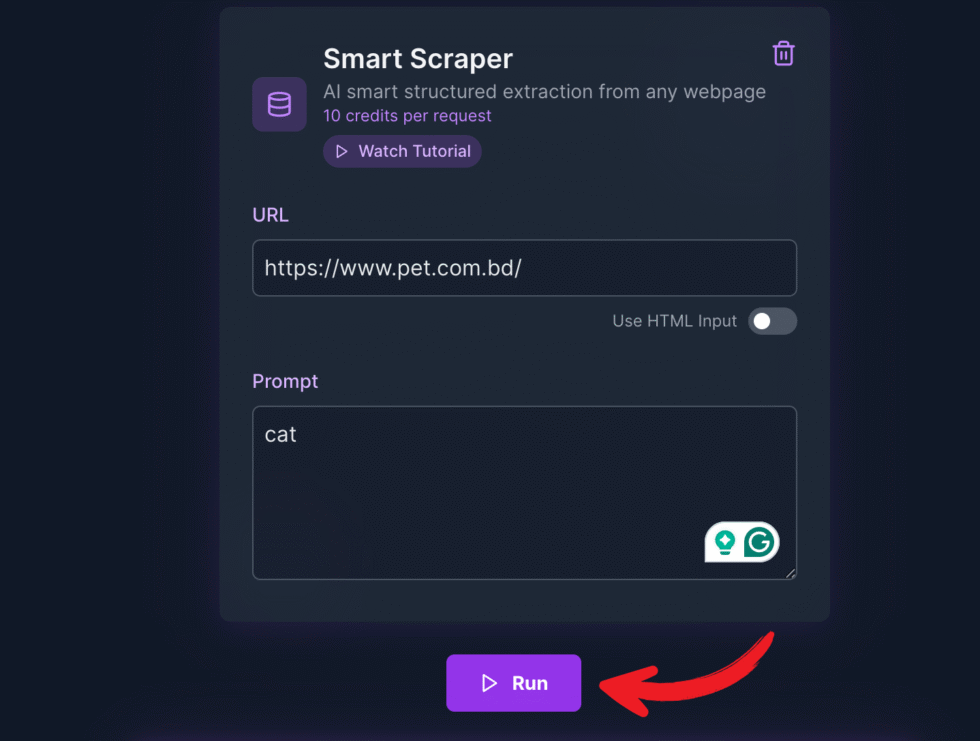
✓ ด่าน: ผลลัพธ์ของคุณตรงกับข้อมูลที่คุณร้องขอ
ขั้นตอนที่ 3: เรียกใช้และอ่านไฟล์ JSON
เรียกใช้งานและอ่านข้อมูล JSON ที่สะอาดในรูปแบบที่มีโครงสร้าง
✅ ผลลัพธ์: คุณแปลงข้อมูลจากหน้าเว็บหนึ่งหน้าให้เป็นข้อมูลที่มีโครงสร้างได้ภายในไม่กี่วินาที
💡 เคล็ดลับสำหรับมืออาชีพ: เขียนข้อความแจ้งเตือนโดยละเอียดพร้อมระบุคีย์ JSON ที่คุณต้องการอย่างแม่นยำ เพื่อให้ได้ผลลัพธ์การแยกข้อมูลที่แม่นยำยิ่งขึ้น
วิธีใช้งาน ScrapeGraphAI Search Scraper
ค้นหา Scraper ช่วยให้คุณรวบรวมข้อมูลเว็บได้โดยตรงจากผลการค้นหาแบบเรียลไทม์ โดยไม่ต้องเปิดแต่ละลิงก์ด้วยตนเอง
นี่คือวิธีการใช้งานทีละขั้นตอน
ขั้นตอนที่ 1: ป้อนคำค้นหาของคุณ
พิมพ์คำค้นหา แล้วระบบจะดึงผลการค้นหาแบบเรียลไทม์มาให้
ขั้นตอนที่ 2: กำหนดสิ่งที่จะเก็บรวบรวม
บอกโปรแกรมว่าต้องการดึงข้อมูลเว็บใดจากแต่ละผลลัพธ์
นี่คือตัวอย่าง:
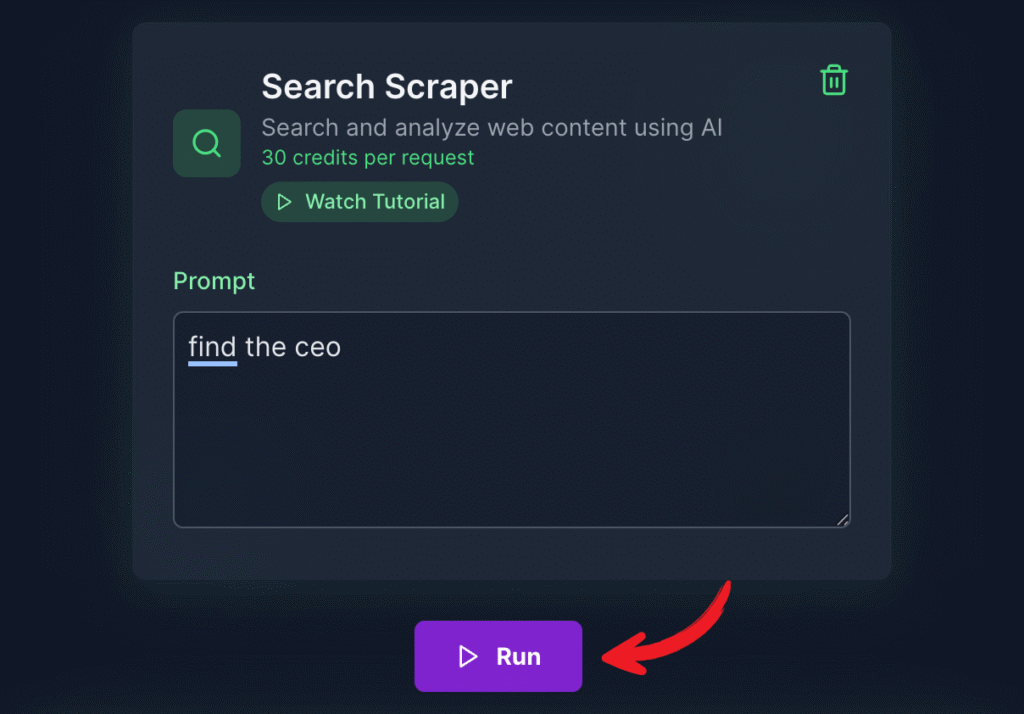
✓ ด่าน: ผลลัพธ์ของคุณตรงกับข้อมูลที่คุณร้องขอ
ขั้นตอนที่ 3: ส่งออกผลลัพธ์
รับข้อมูลที่มีความหมายกลับมาในรูปแบบ JSON ที่พร้อมใช้งาน
✅ ผลลัพธ์: คุณแปลงผลการค้นหาให้เป็นข้อมูลเว็บที่ใช้งานได้
💡 เคล็ดลับสำหรับมืออาชีพ: ควรจำกัดขอบเขตการค้นหาให้แคบลงก่อน เพื่อให้ผลลัพธ์ที่ได้ตรงประเด็นและชัดเจนยิ่งขึ้น
วิธีใช้งาน ScrapeGraphAI Markdownify
มาร์คดาวน์อิฟ ช่วยให้คุณแปลงเนื้อหาบนเว็บให้เป็น Markdown ที่สะอาดตา ซึ่งโมเดล AI สามารถอ่านได้โดยไม่มีสิ่งรบกวนเพิ่มเติม
นี่คือวิธีการใช้งานทีละขั้นตอน
ขั้นตอนที่ 1: วาง URL ของหน้าเว็บ
ใส่ URL ใดก็ได้ที่มีโครงสร้าง HTML ซับซ้อนลงไป
ขั้นตอนที่ 2: แปลงเป็น Markdown
Markdownify จะแปลงเนื้อหาบนเว็บให้เป็น Markdown ที่เรียบร้อย
นี่คือตัวอย่าง:
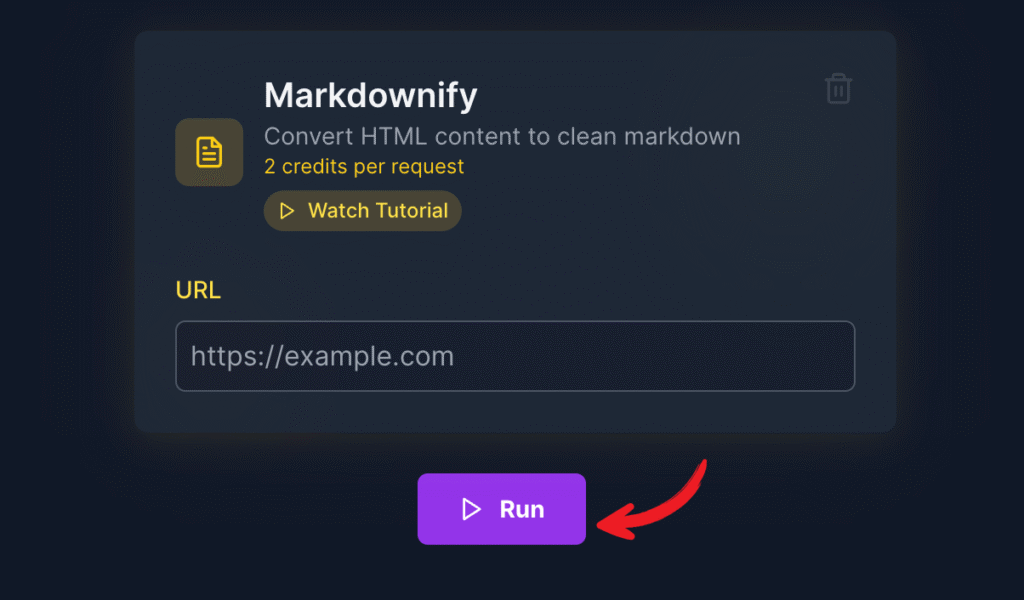
✓ ด่าน: ผลลัพธ์ของคุณตรงกับข้อมูลที่คุณร้องขอ
ขั้นตอนที่ 3: นำข้อมูลที่ทำความสะอาดแล้วกลับมาใช้ใหม่
ป้อนข้อมูลที่สะอาดแล้วลงในแบบจำลองหรือบันทึกของคุณ
✅ ผลลัพธ์: คุณได้แปลงหน้าเว็บให้เป็นหน้าเว็บที่สะอาดและพร้อมใช้งานสำหรับโมเดลแล้ว ข้อความ.
💡 เคล็ดลับสำหรับมืออาชีพ: ผลลัพธ์จาก Markdown เหมาะอย่างยิ่งสำหรับการใช้เป็นข้อมูลป้อนเข้าสำหรับระบบสรุปข้อมูลที่ขับเคลื่อนด้วย AI ทุกประเภท
วิธีใช้งาน ScrapeGraphAI Spidy Agent
สไปดี้ เอเจนท์ ช่วยให้คุณสามารถดึงข้อมูลจากหลายหน้าเว็บได้ในฐานะโปรแกรมดึงข้อมูลหลายหน้าสำหรับโครงการดึงข้อมูลขนาดใหญ่
นี่คือวิธีการใช้งานทีละขั้นตอน
ขั้นตอนที่ 1: เพิ่มหน้าเริ่มต้นของคุณ
ให้ลิงก์เริ่มต้นแก่ Spidy Agent สำหรับการค้นหาข้อมูล
ขั้นตอนที่ 2: ตั้งค่าความลึกในการคลาน
เลือกได้ว่าจะดึงข้อมูลจากไม่กี่หน้าหรือหลายหน้า
นี่คือตัวอย่าง:
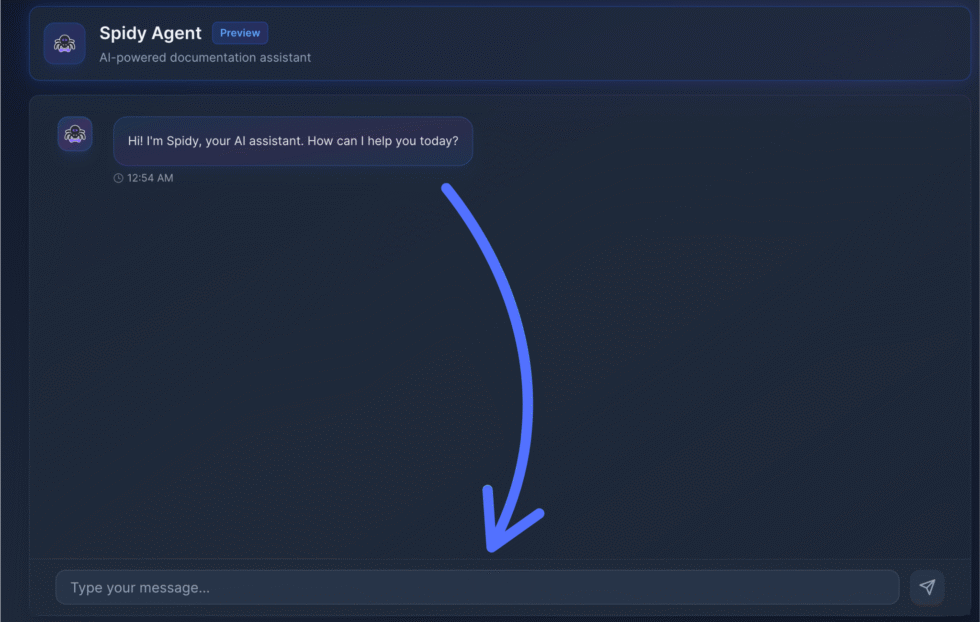
✓ ด่าน: ผลลัพธ์ของคุณตรงกับข้อมูลที่คุณร้องขอ
ขั้นตอนที่ 3: รวบรวมข้อมูลในปริมาณมาก
ให้โปรแกรมดึงข้อมูลหลายหน้านี้จัดการงานดึงข้อมูลขนาดใหญ่ให้คุณ
✅ ผลลัพธ์: คุณได้ทำการรวบรวมข้อมูลจากหลายหน้าเว็บในการดำเนินการครั้งเดียว
💡 เคล็ดลับสำหรับมืออาชีพ: เริ่มต้นด้วยการทดสอบกับหน้าเว็บเพียงไม่กี่หน้าก่อนที่จะทำการดึงข้อมูลในวงกว้าง
วิธีใช้งาน ScrapeGraphAI Universal Data Extraction
การดึงข้อมูลสากล ช่วยให้คุณจัดการงานดึงข้อมูลได้หลากหลาย ไม่ว่าจะเป็นข้อมูลผลิตภัณฑ์ บทความข่าว และอื่นๆ อีกมากมาย
นี่คือวิธีการใช้งานทีละขั้นตอน
ขั้นตอนที่ 1: เลือกแหล่งที่มาของคุณ
ชี้ไปยังข้อมูลผลิตภัณฑ์ บทความข่าว หรือหน้าเว็บใดก็ได้
ขั้นตอนที่ 2: กำหนด Schema
กำหนดรูปแบบโครงสร้างที่คุณต้องการให้ข้อมูลที่ดึงออกมาเป็นไปตามนั้น
นี่คือตัวอย่าง:
✓ ด่าน: ผลลัพธ์ของคุณตรงกับข้อมูลที่คุณร้องขอ
ขั้นตอนที่ 3: ดึงข้อมูล
ดำเนินการดึงข้อมูลและตรวจสอบผลลัพธ์
✅ ผลลัพธ์: คุณจัดการงานดึงข้อมูลที่หลากหลายพร้อมกันได้
💡 เคล็ดลับสำหรับมืออาชีพ: กำหนดสคีมา Pydantic เพื่อล็อกโครงสร้างของทุกระเบียน
วิธีใช้งาน ScrapeGraphAI ด้วยการผสานรวมระบบอย่างง่าย
การผสานรวมที่ง่ายดาย ช่วยให้คุณเชื่อมต่อข้อมูลที่ดึงมาเข้ากับโมเดลวิทยาศาสตร์ข้อมูลและแมชชีนเลิร์นนิงได้ภายในไม่กี่นาที
นี่คือวิธีการใช้งานทีละขั้นตอน
ขั้นตอนที่ 1: เปิดใช้งาน API
เชื่อมต่อผ่าน API สำหรับสคริปต์และแอปของคุณ
ขั้นตอนที่ 2: ส่งข้อมูลไปยังปลายทาง
ส่งข้อมูลที่ดึงมาเข้าสู่ไปป์ไลน์ข้อมูลของคุณ
นี่คือตัวอย่าง:
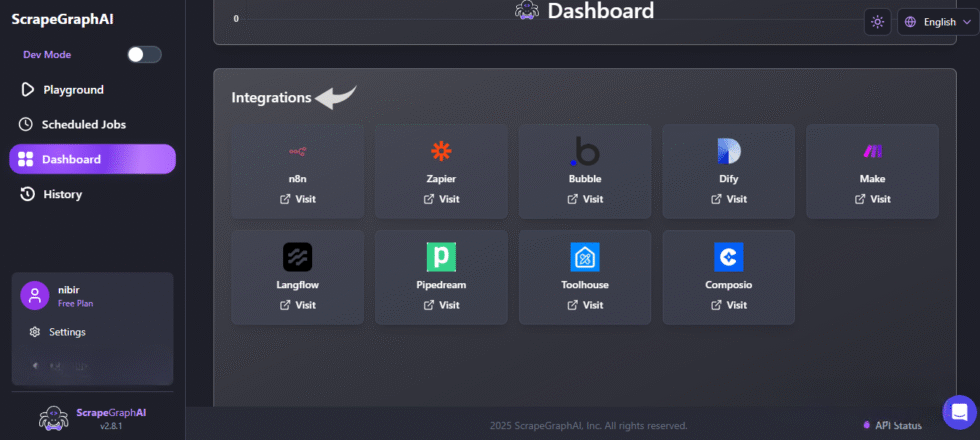
✓ ด่าน: ผลลัพธ์ของคุณตรงกับข้อมูลที่คุณร้องขอ
ขั้นตอนที่ 3: ป้อนข้อมูลให้โมเดลของคุณ
ส่งข้อมูลให้กับโมเดลการเรียนรู้ของเครื่องและเอเจนต์ AI
✅ ผลลัพธ์: ข้อมูลที่คุณดึงออกมาจะไหลเข้าสู่ระบบของคุณแล้ว
💡 เคล็ดลับสำหรับมืออาชีพ: เชื่อมต่อกับ Make.com หรือ n8n เพื่อขยายขีดความสามารถของไปป์ไลน์ข้อมูลของคุณ
วิธีใช้งาน ScrapeGraphAI Smart Agentic Scraper
โปรแกรมสแครปเปอร์อัจฉริยะ ช่วยให้คุณอ่านเนื้อหาแบบไดนามิกบนเว็บไซต์ที่ใช้ JavaScript จำนวนมาก ซึ่งขัดกับรูปแบบดั้งเดิม เครื่องขูด.
นี่คือวิธีการใช้งานทีละขั้นตอน
ขั้นตอนที่ 1: โหลดเว็บไซต์ที่มีความซับซ้อน
วางลิงก์ไปยังเว็บไซต์ที่มี JavaScript จำนวนมาก ซึ่งจะซ่อนเนื้อหาของเว็บไซต์นั้นไว้
ขั้นตอนที่ 2: อนุญาตให้เอเจนต์แสดงผล
เอเจนต์จะโหลดเนื้อหาแบบไดนามิกก่อนที่จะอ่านเนื้อหานั้น
นี่คือตัวอย่าง:
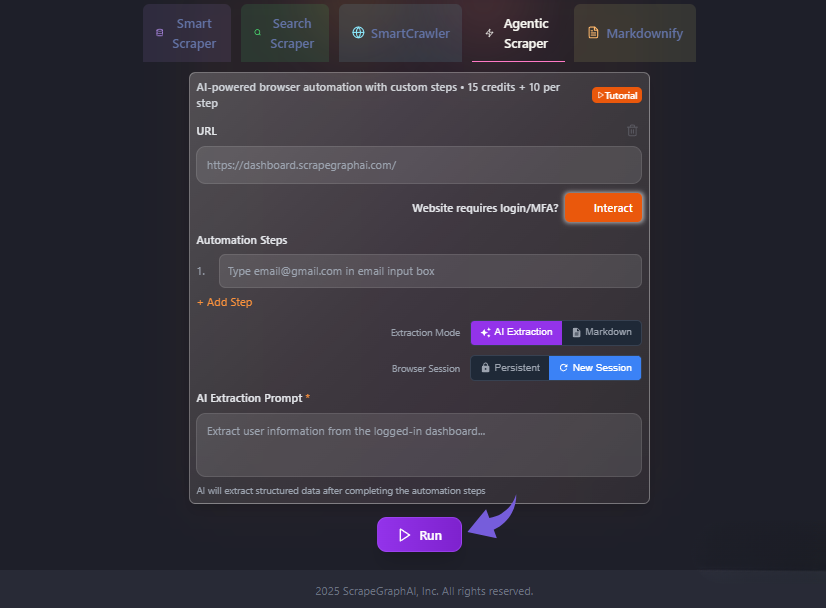
✓ ด่าน: ผลลัพธ์ของคุณตรงกับข้อมูลที่คุณร้องขอ
ขั้นตอนที่ 3: บรรลุผลลัพธ์ที่เสถียร
มันสามารถปรับตัวเมื่อเว็บไซต์มีการเปลี่ยนแปลง ซึ่งแตกต่างจากโปรแกรมดึงข้อมูลแบบดั้งเดิม
✅ ผลลัพธ์: คุณสามารถอ่านเว็บไซต์ที่มี JavaScript จำนวนมากได้อย่างราบรื่น
💡 เคล็ดลับสำหรับมืออาชีพ: ควรใช้ร่วมกับพร็อกซีแบบหมุนเวียนบนเว็บไซต์ที่บล็อกบอทอย่างเข้มงวด
วิธีใช้งาน ScrapeGraphAI Job Scheduler
งาน ผู้กำหนดตารางเวลา ช่วยให้คุณสามารถเรียกใช้การดึงข้อมูลตามกำหนดเวลา เพื่อให้การดึงข้อมูลเกิดขึ้นซ้ำโดยอัตโนมัติ
นี่คือวิธีการใช้งานทีละขั้นตอน
ขั้นตอนที่ 1: สร้างตำแหน่งงาน
บันทึกการขูดผิวเป็นงานที่ทำซ้ำได้
ขั้นตอนที่ 2: ตั้งค่าจังหวะ
เลือกความถี่ในการดำเนินการดึงข้อมูล
นี่คือตัวอย่าง:
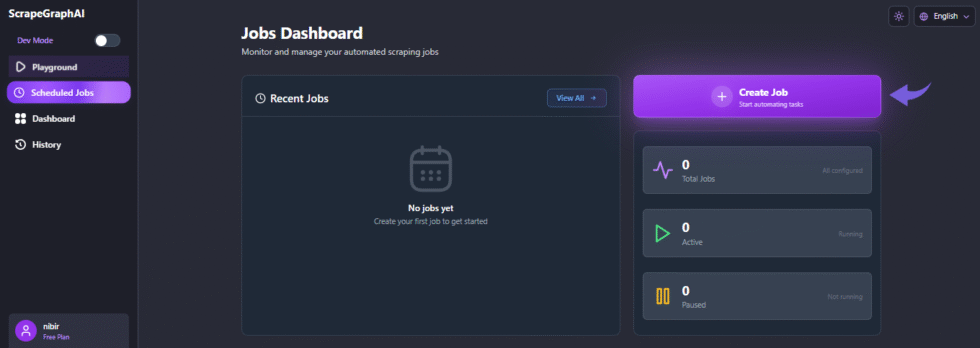
✓ ด่าน: ผลลัพธ์ของคุณตรงกับข้อมูลที่คุณร้องขอ
ขั้นตอนที่ 3: ปล่อยให้มันทำงาน
กระบวนการดึงข้อมูลจะทำซ้ำและจัดเก็บข้อมูลใหม่
✅ ผลลัพธ์: ข้อมูลการดึงข้อมูลของคุณจะอัปเดตโดยอัตโนมัติแล้ว
💡 เคล็ดลับสำหรับมืออาชีพ: จัดลำดับการทำงานให้เหมาะสม เพื่อไม่ให้มีการส่งคำขอมากเกินไปในคราวเดียว
วิธีใช้งาน ScrapeGraphAI ในส่วนติดต่อผู้ใช้แบบง่าย
อินเทอร์เฟซที่เรียบง่าย ช่วยให้คุณใช้งาน ScrapeGraphAI ได้อย่างมีประสิทธิภาพจากแดชบอร์ดแบบไม่ต้องเขียนโค้ด โดยไม่จำเป็นต้องมีความเชี่ยวชาญด้านเทคนิคขั้นสูง
นี่คือวิธีการใช้งานทีละขั้นตอน
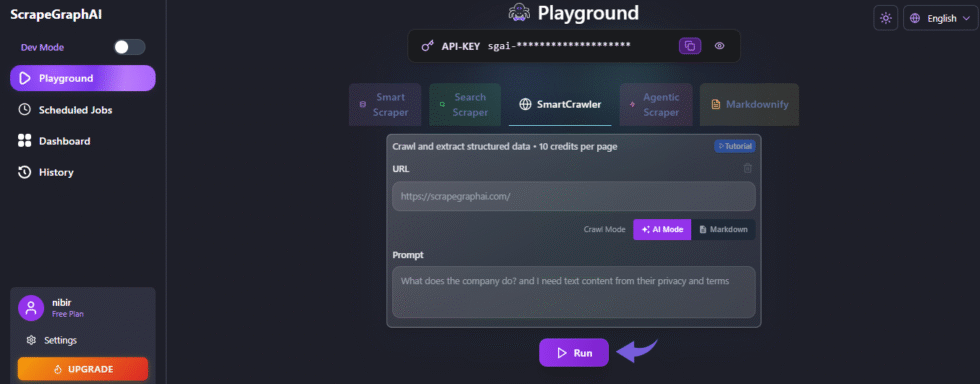
ขั้นตอนที่ 1: เปิดแดชบอร์ด
ใช้แดชบอร์ดที่ขับเคลื่อนด้วย AI ไม่จำเป็นต้องเขียนโค้ด
ขั้นตอนที่ 2: สร้างโดยไม่ต้องเขียนโค้ด
สามารถดำเนินการต่างๆ ได้โดยไม่ต้องมีความเชี่ยวชาญด้านเทคนิคขั้นสูง
นี่คือตัวอย่าง:
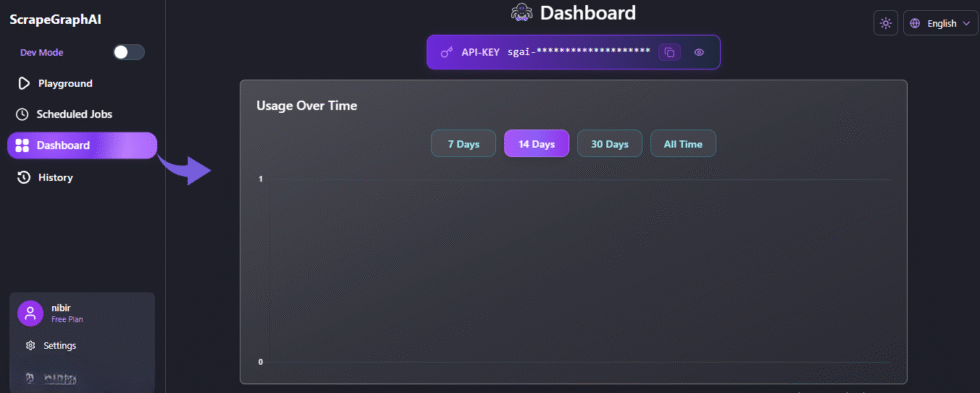
✓ ด่าน: ผลลัพธ์ของคุณตรงกับข้อมูลที่คุณร้องขอ
ขั้นตอนที่ 3: จัดการทุกอย่าง
ติดตามทุกการดึงข้อมูลและใช้งาน ScrapeGraphAI อย่างมีประสิทธิภาพจากหน้าจอเดียว
✅ ผลลัพธ์: คุณทำการดึงข้อมูลทั้งหมดโดยไม่ต้องเขียนโค้ดเลยแม้แต่บรรทัดเดียว
💡 เคล็ดลับสำหรับมืออาชีพ: บันทึกงานที่บันทึกไว้เพื่อนำกลับมาใช้ซ้ำในโครงการดึงข้อมูลต่างๆ
เคล็ดลับและทางลัดสำหรับ ScrapeGraphAI Pro
หลังจากทำโปรเจกต์เกี่ยวกับการดึงข้อมูลจากเว็บไซต์มาหกเดือน นี่คือเคล็ดลับที่ดีที่สุดของผม
ทางลัดการตั้งค่าอย่างรวดเร็ว
| เป้าหมาย | ทางลัด |
|---|---|
| แก้ไขข้อผิดพลาดในการทำงาน | โหมดละเอียดที่ช่วยให้สามารถบันทึกข้อมูลได้อย่างละเอียด |
| บันทึกผลลัพธ์ | ส่งออกเป็นไฟล์ JSON หรือไฟล์ CSV |
| หลีกเลี่ยงการปิดกั้น | เพิ่มพร็อกซีแบบหมุนเวียน |
| โครงสร้างล็อค | แผนผังไพดันติก |
คุณสมบัติที่ซ่อนอยู่ซึ่งคนส่วนใหญ่มองข้ามไป
- การบันทึกข้อมูลโดยละเอียด: ตัวเลือกแสดงรายละเอียดที่จะเปิดใช้งานการบันทึกข้อมูลโดยละเอียดสำหรับทุกโหนด ทำให้การจัดการข้อผิดพลาดง่ายขึ้นมาก
- การหมุนเวียนพร็อกซี: การหมุนเวียนพร็อกซีช่วยให้คุณอยู่ภายใต้ข้อจำกัดอัตราการใช้งาน API และหลีกเลี่ยงการบล็อก IP บนเว็บไซต์ที่มีการรักษาความปลอดภัยสูง
- แบบจำลองท้องถิ่น: เรียกใช้โมเดลแบบเปิดผ่าน Ollama เพื่อดึงข้อมูลโดยไม่ต้องจ่ายค่าโทเค็น
ข้อผิดพลาดทั่วไปที่ควรหลีกเลี่ยงในการใช้งาน ScrapeGraphAI
ข้อผิดพลาด: การไม่ปฏิบัติตามข้อกำหนดของเว็บไซต์
❌ ผิด: การคัดลอกข้อมูลโดยไม่ตรวจสอบข้อกำหนดของเว็บไซต์หรือข้อกฎหมายก่อน
✅ ด้านขวา: โปรดอ่านนโยบายของเว็บไซต์และปฏิบัติตามข้อกำหนดของเว็บไซต์ก่อนดำเนินการดึงข้อมูลใดๆ
ข้อผิดพลาด: การโจมตีเซิร์ฟเวอร์อย่างหนัก
❌ ผิด: การส่งคำขอเร็วเกินไปทำให้เว็บไซต์แสดงข้อผิดพลาด "มีคำขอมากเกินไป"
✅ ด้านขวา: เพิ่มช่วงเวลาหน่วงระหว่างการร้องขอแต่ละครั้ง เพื่อให้คุณไม่เกินขีดจำกัดอัตราการใช้งาน API
ข้อผิดพลาด: คำถามที่ไม่ชัดเจน
❌ ผิด: การเขียนข้อความกระตุ้นความคิดแบบไม่เป็นทางการด้วยภาษาธรรมชาติ ซึ่งส่งผลให้ได้ข้อมูลที่ไม่เป็นระเบียบ
✅ ด้านขวา: ระบุฟิลด์ที่แน่นอนและโครงสร้างข้อมูลเพื่อให้ได้ข้อมูลที่ถูกต้องทุกครั้ง
การแก้ไขปัญหา ScrapeGraphAI
ปัญหา: ข้อผิดพลาด "มีการร้องขอมากเกินไป"
สาเหตุ: คุณส่งคำขอเร็วเกินไปจนเกินขีดจำกัดการใช้งาน API
แก้ไข: ควรเว้นระยะห่างระหว่างการโทรและเพิ่มช่วงเวลาหน่วง; อัปเกรดแพ็กเกจของคุณเพื่อเพิ่มวงเงินการโทรให้สูงขึ้น
ปัญหา: ผลลัพธ์ว่างเปล่าหรือแสดงผลลัพธ์เพียงบางส่วน
สาเหตุ: เว็บไซต์เป้าหมายใช้ JavaScript เป็นจำนวนมาก ดังนั้นเนื้อหาแบบไดนามิกจึงโหลดช้า
แก้ไข: เปลี่ยนไปใช้ Smart Agentic Scraper ซึ่งจะแสดงผลหน้าเว็บก่อนที่จะอ่านข้อมูล
ปัญหา: ถูกบล็อกหรือถูกบล็อก IP
สาเหตุ: เว็บไซต์ตรวจจับการคัดลอกข้อมูลและแสดงหน้าบล็อกขึ้นมา
แก้ไข: เพิ่มพร็อกซีแบบหมุนเวียนเพื่อให้แต่ละคำขอเหมือนมีผู้เยี่ยมชมรายใหม่
📌 บันทึก: นี่คือปัญหาที่พบได้บ่อยที่สุด สำหรับปัญหาอื่นๆ โปรดติดต่อฝ่ายสนับสนุนของ ScrapeGraphAI
ScrapeGraphAI คืออะไร?
สแครปกราฟ AI เป็นไลบรารี Python แบบโอเพนซอร์สสำหรับการดึงข้อมูลจากเว็บอย่างชาญฉลาด
มันจับคู่โมเดลภาษาขนาดใหญ่ (LLM) กับตรรกะกราฟโดยตรงเพื่อสร้างไปป์ไลน์การดึงข้อมูล
แต่ละโหนดในกราฟการดึงข้อมูลจะทำงานเพียงหนึ่งอย่าง ทำให้การอัปเดตการดึงข้อมูลทำได้ง่าย
คิดซะว่ามันเป็นความคิดที่ชาญฉลาด ผู้ช่วย โปรแกรมนี้อ่านหน้าเว็บและส่งคืนข้อมูล JSON ที่สะอาดหมดจด
ชมภาพรวมโดยย่อนี้:
ประกอบด้วยคุณสมบัติหลักดังต่อไปนี้:
- โปรแกรมดึงข้อมูลอัจฉริยะ: ดึงข้อมูลที่มีโครงสร้างจากหน้าเว็บใดก็ได้โดยใช้ข้อความภาษาธรรมชาติที่เข้าใจง่าย
- โปรแกรมดึงข้อมูลจากการค้นหา: รวบรวมข้อมูลเว็บโดยตรงจากผลการค้นหาแบบเรียลไทม์โดยไม่ต้องเปิดแต่ละลิงก์ด้วยตนเอง
- Markdownify: แปลงเนื้อหาเว็บให้เป็น Markdown ที่สะอาดตา ซึ่งโมเดล AI สามารถอ่านได้โดยปราศจากสิ่งรบกวนเพิ่มเติม
- สไปดี้ เอเจนท์: ใช้เครื่องมือสแกนหลายหน้าสำหรับโครงการสแกนข้อมูลขนาดใหญ่
- การดึงข้อมูลแบบสากล: จัดการงานดึงข้อมูลจำนวนมากจากข้อมูลผลิตภัณฑ์ บทความข่าว และอื่นๆ
- การผสานรวมที่ง่ายดาย: เชื่อมต่อข้อมูลที่ดึงมาเข้ากับโมเดลวิทยาศาสตร์ข้อมูลและแมชชีนเลิร์นนิงของคุณได้ภายในไม่กี่นาที
- โปรแกรมดึงข้อมูลตัวแทนอัจฉริยะ: อ่านเนื้อหาแบบไดนามิกบนเว็บไซต์ที่มี JavaScript จำนวนมาก ซึ่งทำให้โปรแกรมดึงข้อมูลแบบดั้งเดิมใช้งานไม่ได้
- โปรแกรมจัดตารางงาน: เรียกใช้การดึงข้อมูลตามกำหนดเวลาเพื่อให้การดึงข้อมูลเกิดขึ้นซ้ำโดยอัตโนมัติ
- อินเทอร์เฟซที่เรียบง่าย: ใช้งาน ScrapeGraphAI ได้อย่างมีประสิทธิภาพจากแดชบอร์ดแบบไม่ต้องเขียนโค้ด โดยไม่จำเป็นต้องมีความเชี่ยวชาญด้านเทคนิคขั้นสูง
เนื่องจากมันอ่านบริบท จึงสามารถดึงข้อมูลที่มีความหมายออกมาได้ แม้ว่าเว็บไซต์จะเปลี่ยนรูปแบบไปก็ตาม
โปรแกรมนี้อ่านหน้าเว็บและเอกสารในเครื่องได้ แต่ไม่สามารถถอดเสียงไฟล์เสียงได้
ด้วยคำแนะนำที่เป็นภาษาธรรมชาติอย่างง่าย คุณสามารถใช้ข้อมูล เช่น บทความข่าว เพื่อวิเคราะห์ความรู้สึกได้
สำหรับรีวิวฉบับเต็ม โปรดดูที่หน้าของเรา รีวิว ScrapeGraphAI.
ราคาของ ScrapeGraphAI
ต่อไปนี้คือราคาของ ScrapeGraphAI ในปี 2026:
| วางแผน | ราคา | เหมาะสำหรับ |
|---|---|---|
| ฟรี | $0 | ทดสอบบนหน้าเว็บไม่กี่หน้า |
| สตาร์ทเตอร์ | 17 ดอลลาร์/เดือน | งานดึงข้อมูลแบบเดี่ยว |
| การเจริญเติบโต | 85 ดอลลาร์ต่อเดือน | โครงการดึงข้อมูลทั่วไป |
| โปร | 425 ดอลลาร์ต่อเดือน | การขูดขนาดใหญ่ |
| องค์กร | กำหนดเอง | ทีมที่มีปริมาณงานสูง |
ทดลองใช้งานฟรี: ใช่แล้ว แพ็กเกจฟรีช่วยให้คุณทดสอบการดึงข้อมูลได้โดยไม่มีค่าใช้จ่าย
รับประกันคืนเงิน: ยกเลิกได้ทุกเมื่อจากแดชบอร์ดของคุณ
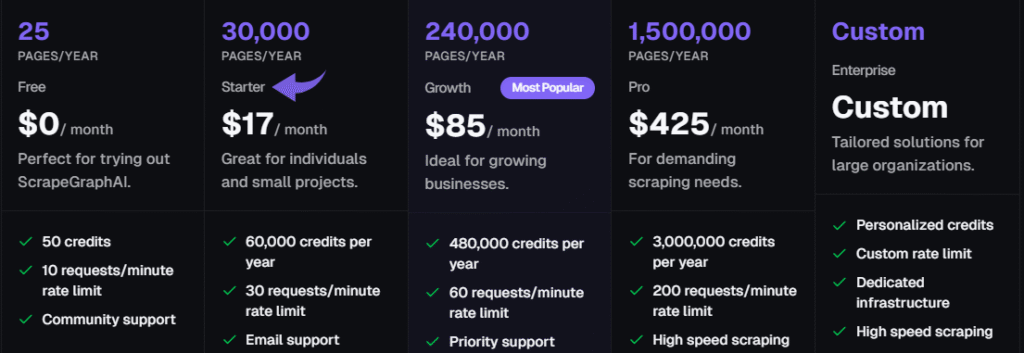
💰 คุ้มค่าที่สุด: การเติบโต — ปริมาณงานที่เพียงพอสำหรับโครงการขูดหินอย่างต่อเนื่องโดยไม่ต้องจ่ายเงินมากเกินไป
ScrapeGraphAI เทียบกับทางเลือกอื่นๆ
ScrapeGraphAI เป็นอย่างไรเมื่อเทียบกับตัวอื่น? นี่คือภาพรวม:
| เครื่องมือ | เหมาะสำหรับ | ราคา | การให้คะแนน |
|---|---|---|---|
| สแครปกราฟ AI | การสกัดข้อมูลโดย AI | 17 ดอลลาร์/เดือน | ⭐ 4.5 |
| สแครปปี้ | การรวบรวมข้อมูลแบบ Code-first | ฟรี | ⭐ 4.4 |
| เรียกดู AI | การตรวจสอบโดยไม่ต้องเขียนโค้ด | 48 ดอลลาร์/เดือน | ⭐ 4.3 |
| ข้อมูลสดใส | เครือข่ายพร็อกซี | 0.50 ดอลลาร์/เดือน | ⭐ 4.5 |
| อ็อกโทพาร์ส | การดึงข้อมูลภาพ | 99 ดอลลาร์/เดือน | ⭐ 4.3 |
| สแครปปิ้งบี | เว็บไซต์ที่ใช้การแสดงผลจำนวนมาก | 49 ดอลลาร์/เดือน | ⭐ 4.4 |
ตัวเลือกที่น่าสนใจ:
- ดีที่สุดโดยรวม: ScrapeGraphAI — การสกัดข้อมูลจากภาษาธรรมชาติ เหนือกว่าตัวเลือกแบบตายตัว
- งบประมาณที่ดีที่สุด: Scrapy — ฟรี หากคุณสามารถเขียนโค้ดเองได้
- เหมาะสำหรับผู้เริ่มต้น: เรียกดูข้อมูลด้วย AI — เพียงแค่ชี้และคลิก ไม่ต้องใช้สคริปต์
- เหมาะสำหรับใช้กับพร็อกซี: Bright Data — กลุ่มพร็อกซีหมุนเวียนขนาดใหญ่
🎯 ทางเลือกอื่นแทน ScrapeGraphAI
กำลังมองหาทางเลือกอื่นแทน ScrapeGraphAI อยู่ใช่ไหม? นี่คือตัวเลือกที่ดีที่สุด:
- 🚀 สแครปปี้: เฟรมเวิร์ก Python แบบโอเพนซอร์สสำหรับนักพัฒนาที่ต้องการควบคุมการรวบรวมข้อมูลทุกขั้นตอนอย่างสมบูรณ์
- 👶 เรียกดู AI: เครื่องมือที่ไม่ต้องเขียนโค้ด บันทึกการคลิกของคุณและเปลี่ยนเว็บไซต์ใดๆ ให้เป็น API
- 🏢 ข้อมูลอันสดใส: เครือข่ายพร็อกซีระดับองค์กรที่มี IP หมุนเวียนจำนวนมากสำหรับการดึงข้อมูลขนาดใหญ่
- 🎨 อ็อกโทพาร์ส: โปรแกรมดึงข้อมูลแบบภาพ ใช้งานง่ายด้วยการคลิกเมาส์ เหมาะสำหรับผู้ที่ไม่เขียนโค้ดที่ต้องการสร้างโปรเจ็กต์ดึงข้อมูล
- 🔧 ScrapingBee: API ที่ช่วยในการแสดงผลเว็บไซต์ที่มี JavaScript จำนวนมาก ทำให้คุณไม่ต้องตั้งค่าเบราว์เซอร์ด้วยตนเอง
ดูรายชื่อทั้งหมดได้ที่หน้าของเรา ทางเลือกอื่นแทน ScrapeGraphAI แนะนำ.
⚔️ เปรียบเทียบ ScrapeGraphAI
ต่อไปนี้คือการเปรียบเทียบ ScrapeGraphAI กับคู่แข่งแต่ละราย:
- ScrapeGraphAI เทียบกับ Scrapy: ScrapeGraphAI ชนะในเรื่องความเร็วในการแสดงผลลัพธ์แรก ในขณะที่ Scrapy ชนะในเรื่องการควบคุมที่สมบูรณ์แบบสำหรับนักเขียนโค้ด
- ScrapeGraphAI เทียบกับ Browse AI: ScrapeGraphAI เหมาะสำหรับหน้าเว็บที่มีโครงสร้างซับซ้อนกว่า ในขณะที่ Browse AI นั้นเรียบง่ายกว่าสำหรับหน้าเว็บที่มีเค้าโครงคงที่และซ้ำกัน
- ScrapeGraphAI เทียบกับ Bright Data: Bright Data เป็นผู้นำด้านพร็อกซี ส่วน ScrapeGraphAI เป็นผู้นำด้านการแปลงหน้าเว็บให้เป็นข้อมูลที่มีโครงสร้าง
- ScrapeGraphAI เทียบกับ Octoparse: ScrapeGraphAI ปรับตัวได้ตามการเปลี่ยนแปลงของเว็บไซต์ ในขณะที่ Octoparse ต้องการให้คุณสร้างเทมเพลตใหม่ทุกครั้ง
- ScrapeGraphAI เทียบกับ ScrapingBee: ทั้งสองโปรแกรมสามารถแสดงผลเว็บไซต์ที่ซับซ้อนได้ แต่ ScrapeGraphAI ยังใช้โมเดล AI ในการวิเคราะห์เนื้อหาอีกด้วย
เริ่มใช้งาน ScrapeGraphAI ได้เลยตอนนี้
คุณได้เรียนรู้วิธีการใช้งานฟีเจอร์หลักทั้งหมดของ ScrapeGraphAI แล้ว:
- ✅ เครื่องมือขูดข้อมูลอัจฉริยะ
- ✅ โปรแกรมดึงข้อมูลจากการค้นหา
- ✅ มาร์คดาวน์ไลค์
- ✅ สไปดี้ เอเจนท์
- ✅ การดึงข้อมูลแบบสากล
- ✅ การเชื่อมต่อที่ง่ายดาย
- ✅ โปรแกรมดึงข้อมูลตัวแทนอัจฉริยะ
- ✅ โปรแกรมจัดตารางงาน
- ✅ อินเทอร์เฟซที่ใช้งานง่าย
นี่คือประโยชน์หลักๆ โดยสรุป:
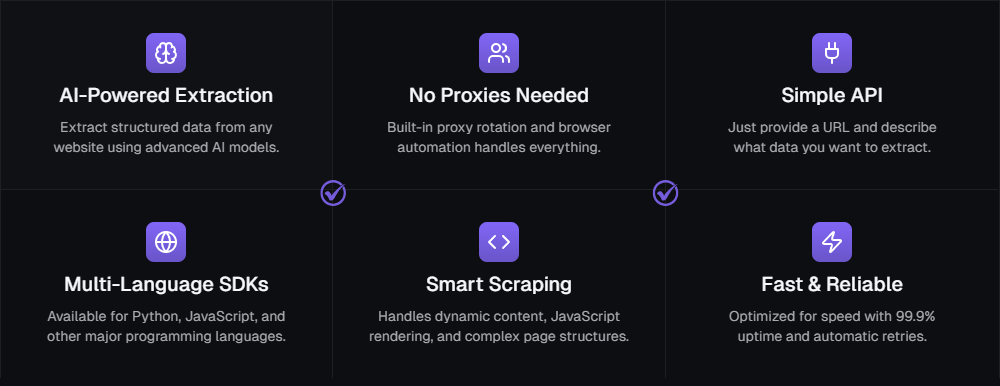
ขั้นตอนต่อไป: เลือกฟีเจอร์หนึ่งอย่างแล้วลองใช้ดูเลย
คนส่วนใหญ่เริ่มต้นด้วยโปรแกรม Smart Scraper ซึ่งเป็นโปรแกรมดึงข้อมูลจากหน้าเว็บเดียว
ใช้เวลาน้อยกว่าห้านาทีในการดึงข้อมูลจากหน้าแรกของคุณ
ถาม บ่อย ๆ
ScrapeGraphAI ใช้งานได้ฟรีหรือไม่?
ใช่แล้ว แพ็กเกจฟรีครอบคลุมการดึงข้อมูลจากเว็บไซต์ขั้นพื้นฐานโดยไม่มีค่าใช้จ่าย และแพ็กเกจแบบชำระเงินเริ่มต้นที่ 17 ดอลลาร์ต่อเดือน เมื่อคุณต้องการใช้งานปริมาณหรือฟีเจอร์ที่มากขึ้น
ฉันจำเป็นต้องรู้วิธีเขียนโค้ดหรือไม่?
ไม่ คุณสามารถใช้ ScrapeGraphAI จากแดชบอร์ดแบบไม่ต้องเขียนโค้ดพร้อมข้อความแจ้งเตือนด้วยภาษาธรรมชาติได้ แม้ว่าจะมี API ที่เขียนด้วย Python ให้ใช้งานหากคุณต้องการก็ตาม
มันรองรับโมเดลภาษาขนาดใหญ่แบบใดบ้าง?
ระบบนี้ทำงานร่วมกับผู้ให้บริการ LLM หลายราย รวมถึงโมเดล OpenAI เช่น GPT 4o, Anthropic, Google Gemini และโมเดลท้องถิ่นผ่าน Ollama
สามารถรองรับเว็บไซต์ที่มี JavaScript จำนวนมากได้หรือไม่?
ใช่แล้ว Smart Agentic Scraper จะแสดงผลเนื้อหาแบบไดนามิกก่อน ดังนั้นจึงสามารถอ่านเว็บไซต์ที่มี JavaScript จำนวนมาก ซึ่งมักทำให้โปรแกรมดึงข้อมูลแบบดั้งเดิมใช้งานไม่ได้
ฉันจะหลีกเลี่ยงการถูกบล็อกได้อย่างไร?
เคารพข้อกำหนดของเว็บไซต์ เพิ่มการหน่วงเวลาเพื่อหลีกเลี่ยงข้อผิดพลาด "มีคำขอมากเกินไป" และใช้พร็อกซีแบบหมุนเวียนเพื่อป้องกันการบล็อก IP ระหว่างการดึงข้อมูล













 English
 Spanish
 Chinese
 German
 French
 Arabic
 Russian
 Portuguese
 Japanese
 Korean
 Italian
 Turkish
 Dutch
 Polish
 Indonesian
 Thai
 Vietnamese
